Lexical Semantic Change through Large Language Models: a Survey
문맥화 임베딩으로 의미 변화를 읽는 세 갈래
Periti와 Montanelli의 survey는 문맥화 의미 변화 탐지를 임베딩·집계·평가 단계와 형태·의미·앙상블 접근으로 정리한다. Table 6의 형태 기반 우세는 논문별 최선값을 모은 비교라 통제 실험의 승리로 읽으면 안 된다.
Paper: Francesco Periti; Stefano Montanelli (2024). "Lexical Semantic Change through Large Language Models: a Survey." PDF · arXiv:2304.01666 · DOI
1. 검토한 판본과 작업 흐름
출판 기록의 제목은 「Lexical Semantic Change through Large Language Models: a Survey」이며 저자 순서는 Periti·Montanelli다. 이 글의 방법·Table 6·그림 설명은 제목이 「A Survey on Contextualised Semantic Shift Detection」이고 저자 순서가 Montanelli·Periti인 arXiv:2304.01666v2를 기준으로 한다. 두 판본의 표와 그림이 모두 같다고 전제하지 않는다.
문맥화 semantic shift detection은 한 단어의 모든 출현을 문장 속에서 벡터화한 뒤, 시기별 사용례를 정리하고 변화량을 평가한다. 저자들은 이를 embedding–aggregation–assessment의 세 단계로 설명한다. BERT 같은 모델 이름보다 사용례 벡터를 어떤 단위로 모으고 어떤 질문에 어떤 점수를 쓰는지가 중요하다.

그림 1. Montanelli & Periti, arXiv:2304.01666v2 PDF p. 3의 Figure 1을 인용했다. 문맥별 occurrence embedding을 만든 뒤 선택적으로 집계하고, semantic measure로 변화를 평가하는 CSSDetection workflow다. 원도판을 인용했다.
2. 형태 기반·의미 기반·앙상블 접근
형태 기반 방법(APD·PRT·cosine distance)은 두 시기의 usage embedding 사이 거리나 평균 prototype 거리를 바로 잰다. 빠르고 변화량 순위에 강하지만 어느 의미가 바뀌었는지는 직접 말하지 않는다. 의미 기반 방법은 군집을 만들어 의미별 빈도와 등장·소멸을 본다. 해석은 좋아지지만 군집 오류와 작은 군집 처리의 영향을 받는다. 앙상블 방법은 두 정보를 결합하려 한다. 시간 인식 여부는 이 세 갈래와 별개의 분석 축이며, 각 갈래 안에서도 시간 정보를 다르게 사용할 수 있다.
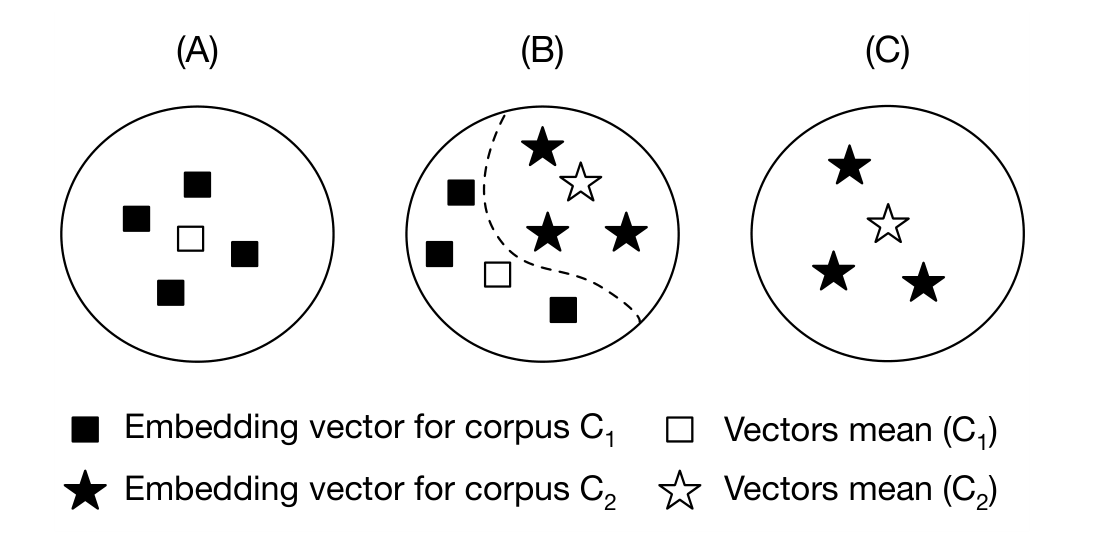
그림 2. Montanelli & Periti, arXiv:2304.01666v2 PDF p. 3의 Figure 2를 인용했다. joint 또는 incremental clustering에서는 앞 시점 전용(A), 공통(B), 뒤 시점 전용(C) cluster가 가능하다. separate clustering은 시점 간 정렬 문제가 추가된다. 원도판을 인용했다.
3. Table 6의 결과를 올바르게 읽기
검토한 arXiv v2의 Table 6(PDF pp. 16–17)은 SemEval, RuShiftEval, NorDiaChange 등 여러 corpus의 Grade Change Detection Spearman을 모은다. APD·CD·PRT 같은 형태 기반 방법이 대체로 높은 칸을 차지하지만, 저자들은 각 논문에서 보고된 최고 Spearman 값을 모았다고 명시한다. 같은 데이터 분할·layer·전처리·hyperparameter를 맞춘 재실험이 아니다.
따라서 ‘형태 기반이 의미 기반보다 본질적으로 낫다’는 결론은 과하다. 단어마다 점수 하나를 맞히는 Grade Change benchmark가 형태 기반 거리 측도에 유리할 수 있고, 작은 의미의 등장·소멸은 하나의 종합 점수에서 오히려 손해가 될 수 있다. GEMS English, COHA English, LSCD Spanish에서는 의미 기반이 앞선 사례도 표에 있다.
4. 평가 질문을 먼저 고른다
단어별 변화량의 순위가 목적이면 형태 기반 baseline부터 두는 것이 합리적이다. 반면 새 의미의 출현, 의미 손실, 시점 탐지가 목적이면 cluster 구성과 time interval을 확인해야 한다. 단일 Spearman은 순위 상관을 나타내며 설명 가능한 의미 분할까지 검증하지는 않는다. APD가 높다는 것은 두 시기의 사용례 구름이 멀어졌다는 뜻일 수 있지만, 새 뜻의 등장과 기존 뜻의 비중 변화는 구별하지 못한다. 군집 기반 분석도 작은 군집을 잡음으로 버리는 규칙 하나에 따라 결론이 달라질 수 있다.
이 survey가 권하는 다음 과제도 같은 맥락이다. 성능, 확장성, 해석성, 강건성을 따로 평가하고 언어·코퍼스·모델 선택을 문서화해야 한다. 특정 표의 최고 점수를 실전 변화 탐지의 보증으로 확대하지 않는 태도가 필요하다.
5. 범위와 한계
이 글은 기존 실험을 분류한 survey다. 새 모델을 동일 조건에서 시험하지 않았다. 2024년 출판본과 arXiv v2는 제목과 저자 순서가 달라 각각 구분해 인용했다. Table 6의 값은 원 연구의 설정과 benchmark에 묶여 있고, 저자도 모든 corpus에서 하나의 방법이 이기지 않는다고 말한다.
References
Periti, F., & Montanelli, S. (2024). Lexical semantic change through large language models: A survey. ACM Computing Surveys, 56(11), Article 282. https://doi.org/10.1145/3672393
Montanelli, S., & Periti, F. (2024). A survey on contextualised semantic shift detection (arXiv:2304.01666v2). arXiv. https://arxiv.org/abs/2304.01666v2