Statistically Significant Detection of Linguistic Change
변화점의 p-value가 의미 변화 자체는 아니다
Kulkarni 등은 빈도·품사·분포 표현의 시계열에 순열 기반 변화점 검정을 붙였다. p-value는 정해진 시계열 평균이 변했을 근거이며 변화가 언어 의미 때문인지까지 판정하지는 않는다.
Paper: Vivek Kulkarni; Rami Al-Rfou; Bryan Perozzi; Steven Skiena (2015). "Statistically Significant Detection of Linguistic Change." PDF · arXiv:1411.3315 · DOI
1. 세 시계열로 변화를 찾는다
이 논문은 단어의 빈도, 품사 분포, 분포 표현(distributional embedding) 변위를 시간축에 놓는다. 그 위에 변화점 탐지를 얹어 관측한 평균 이동이 시간 순서를 섞었을 때보다 얼마나 이례적인지 계산한다. 빈도 급증과 의미 이동은 다르므로 세 표현을 병렬로 둔 것이 핵심이다.
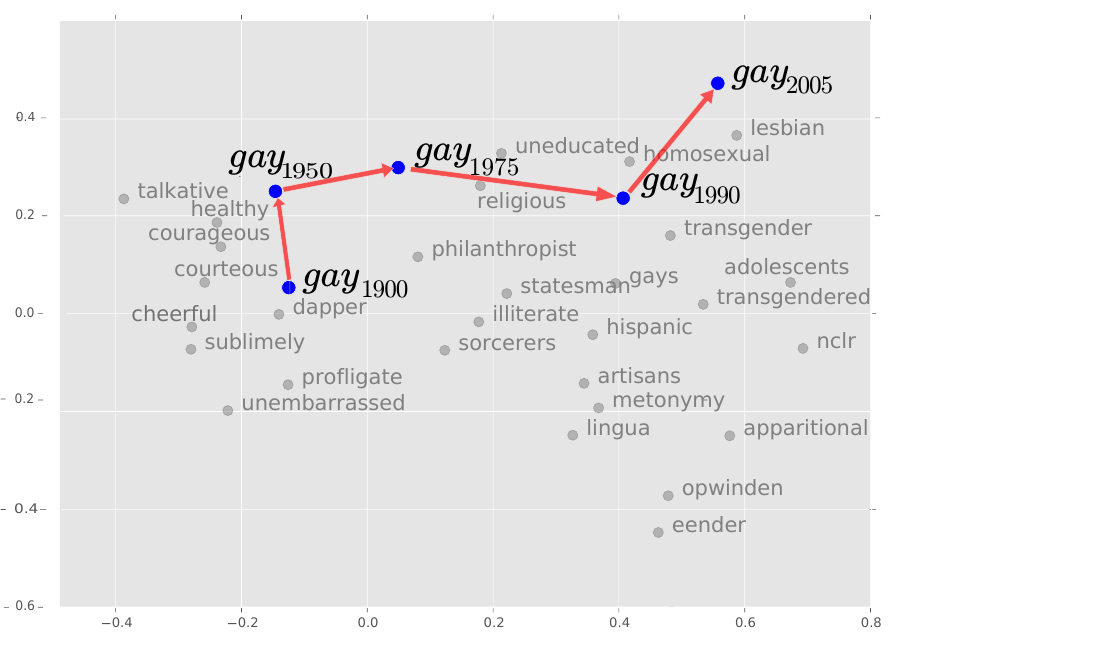
그림 1. Kulkarni et al., arXiv:1411.3315v1 PDF p. 1의 Figure 1을 인용했다. gay의 2차원 잠재 의미 공간 궤적이다. 1900년의 이웃과 2005년의 이웃이 달라지는 예를 보이지만, 2차원 투영 자체가 전체 embedding 거리의 정량 검증은 아니다.
2. 순열 검정이 하는 일
각 단어 시계열을 정규화하고 관심 시점에서의 평균 이동을 계산한다. 시간 순서를 무작위로 섞은 표본을 반복해 ‘변화가 없다면’ 나올 이동의 분포를 만들고, 관측 이동보다 큰 값의 비율을 p-value로 둔다. 논문은 보통 1,000개 순열 표본을 쓴다. 이 설계의 전제는 변화가 없을 때 시간 표지를 바꿔도 비교할 수 있다는 교환 가능성이다. 시계열의 자기상관이나 장기적인 코퍼스 변화가 크면 이 전제가 약해질 수 있다. 이는 순열 설계에서 따라오는 해석 조건이다.
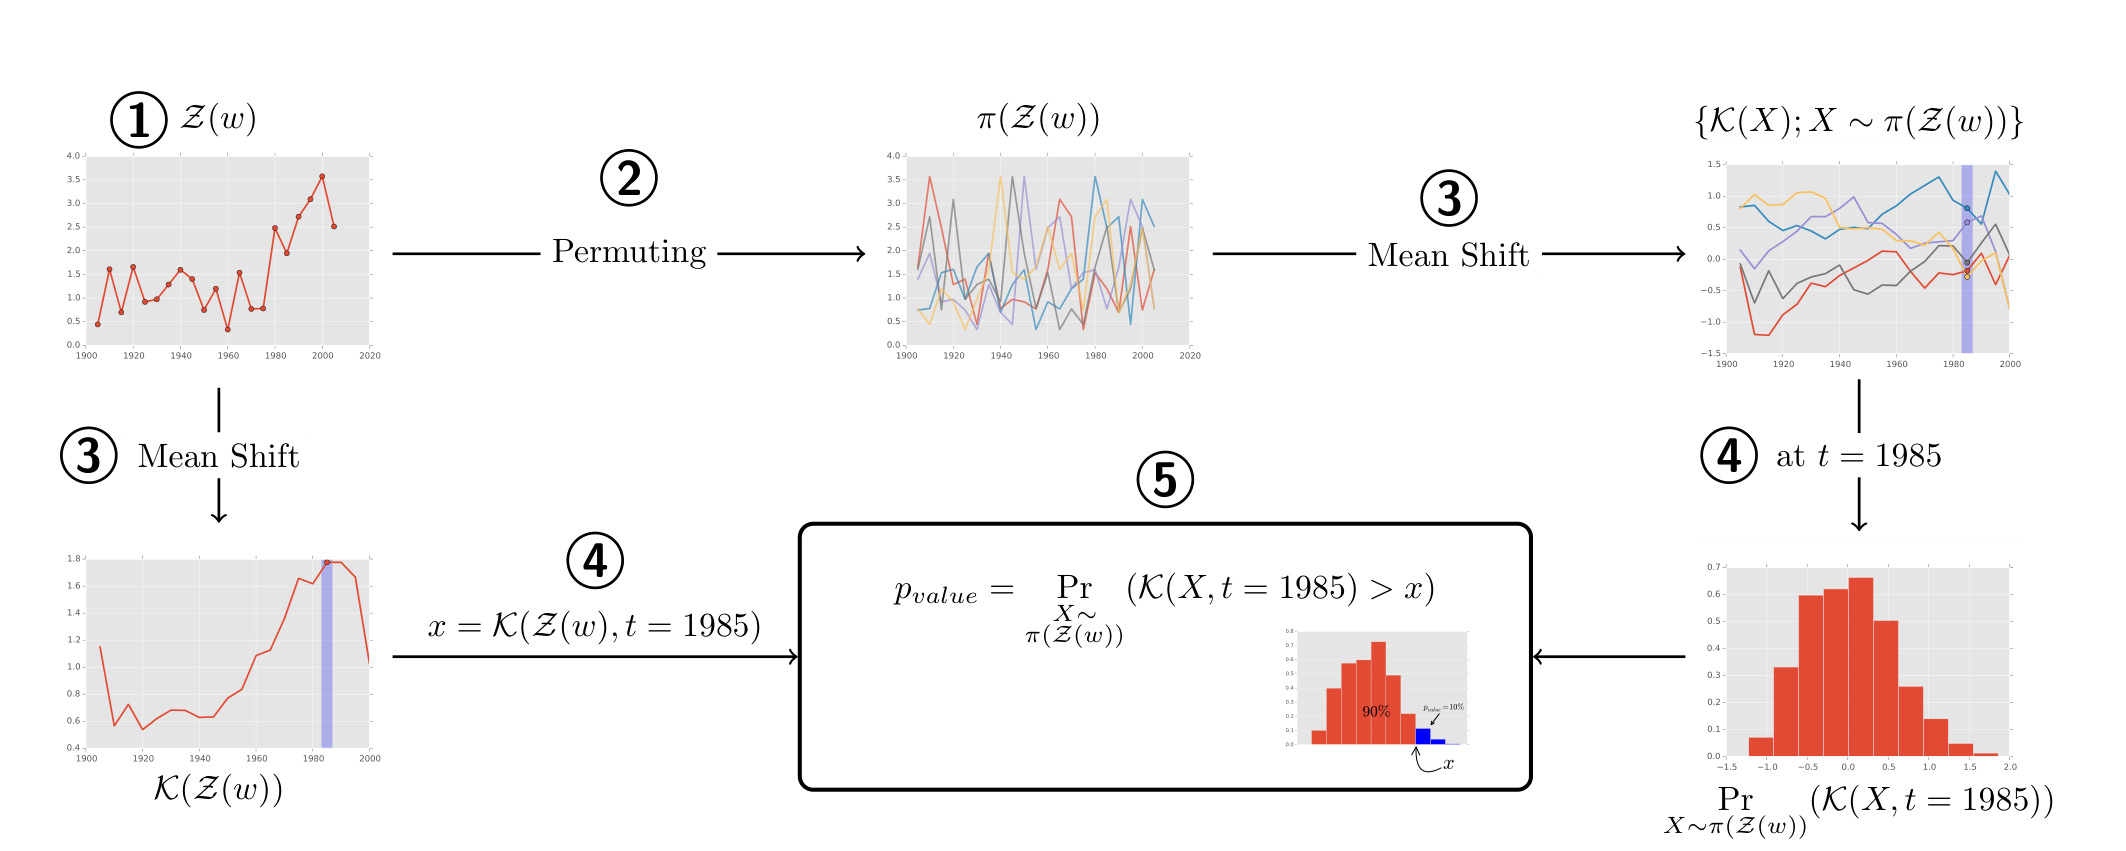
그림 2. Kulkarni et al., arXiv:1411.3315v1 PDF p. 5의 Figure 6을 인용했다. 정규화→순열→평균 이동→null distribution→p-value의 절차다. 유의성의 대상은 이 시계열 통계량의 변화이지, 의미 해석의 참·거짓이 아니다.
3. 결과: 서로 다른 오류를 낸다
Google Books에서 빈도 방법은 her처럼 사회적 관심으로 사용량만 늘어난 단어를 오탐할 수 있다. 품사 방법은 apple, windows, bush처럼 보통명사에서 고유명사로 바뀐 사례를 잡지만 태거에 의존한다. 분포 방법은 gay, tape, sex, bitch 같은 문맥 이동을 잡는 데 강했다(Table 3). 논문은 세 신호가 보완적이라고 결론낸다. 한 신호가 모든 변화 유형에서 항상 낫다는 뜻은 아니다.
합성 치환 실험에서는 같은 품사 쌍 조건에서 분포 방법이 모든 치환 확률에서 빈도보다 높았고, 품사 제약을 풀면 작은 변화에서는 품사 방식이 앞서다가 변화가 커질수록 떨어졌다(Fig. 7). 하지만 이것은 인위적으로 단어를 치환한 MRR 평가다. MRR은 변경한 표적어의 순위 역수(1/순위)를 평균한 값으로, 그런 단어를 후보 목록의 앞쪽에 놓을수록 높다. 자연 언어 의미 변화의 정답 성능으로 바로 옮기면 안 된다. Google Books는 5년, Amazon은 연, Twitter는 월 단위라 변화점의 시간 해상도도 다르다(Table 1). 빠른 Twitter 사례는 단기 사건 반응과 정착한 의미 변화를 따로 용례로 확인해야 한다.
4. 적용할 때 지킬 경계
p-value가 작아도 코퍼스 구성, 사건, OCR, 태거 변화가 시계열을 바꿨을 수 있다. 특히 많은 단어·시점에 검정을 반복하면 다중검정 보정과 선택 절차를 분리해야 한다. 시기별 embedding의 정렬 잔차도 변위에 섞일 수 있으며, 순열 검정은 이 전체 파이프라인의 불확실성을 분해하지 않는다. 논문은 후보를 발견하는 강한 출발점이지만, 의미 변화 확정에는 원문 용례와 외부 역사 근거가 필요하다.
5. 결론
이 연구의 유산은 시간별 단어 표현에 ‘언제’라는 검정 질문을 붙인 데 있다. 빈도·문법·문맥은 서로 다른 변화를 보므로 함께 읽어야 한다. 유의한 변화점은 조사할 후보이지, 자동으로 확정된 의미 변화가 아니다.
실무 점검표로 바꾸면 간단하다. 먼저 빈도 급증인지 문맥 이웃 이동인지 분리하고, 후보 시점 전후의 실제 문장을 읽는다. 다음으로 사건·제품명·인명처럼 외부 세계 변화가 용법 자체를 바꿨는지 확인한다. 마지막으로 여러 단어를 동시에 훑었다면 후보 선정 전의 검정 기준과 보정 방식을 남긴다. 그래야 다른 연구자가 같은 결론을 점검할 수 있다. 이 세 단계를 빼면 통계적으로 드문 패턴을 언어 변화라고 부르는 오류가 남는다.
References
Kulkarni, V., Al-Rfou, R., Perozzi, B., & Skiena, S. (2015). Statistically significant detection of linguistic change. Proceedings of the 24th International Conference on World Wide Web, 625–635. https://doi.org/10.1145/2736277.2741627