ICLR 2026 Agent 연구는 무엇을 검증하나: 장기 실행 시스템의 학습과 평가
ICLR 2026 Agent 선정 논문: 실행 과정도 평가해야 한다
ICLR 2026 본회의에서 고른 AgentFlow와 AgentFold 등을 통해 장기 도구 사용의 학습, 문맥 관리, 실행 평가를 살핀다. 정책·상태·실행 도구를 구분하고 각 그림이 보여 주는 범위와 남는 검증 과제를 짚는다.
Sources: ICLR 2026 공식 본회의 논문 목록과 아래에 링크한 선정 논문. 이 글은 몇 편의 방법과 평가 질문을 연결한 해설이다. 본회의 전체의 논문 수·분야 비중·성능 순위는 조사하지 않았다.
1. 에이전트의 결과를 어디까지 살펴볼까
에이전트가 “예약했습니다”라고 답해도 실제 예약 상태가 바뀌지 않았다면 성공이라 할 수 없다. 반대로 도구를 잘못 선택한 뒤 우연히 정답에 도달했을 수도 있다. 긴 작업에서는 최종 문장과 중간 실행 기록을 함께 봐야 한다. 이때 **정책(policy)**은 다음 행동을 고르는 모델, **상태(state)**는 현재 작업과 환경에 대해 남겨 둔 정보, **실행 틀(harness)**은 모델이 쓸 수 있는 도구·규칙·실행 절차를 뜻한다. 검증기는 실행 결과가 조건을 충족하는지 살피는 부분이다.
선정한 연구는 세 질문을 다룬다. 최종 점수를 여러 행동에 어떻게 학습 신호로 돌릴까? 길어진 관찰 기록에서 무엇을 남길까? 도구 호출과 상태 변경을 어떻게 검사할까? 이는 이 글의 독해 틀이며 선정 논문들이 공통으로 채택한 단일 설계는 아니다.
2. AgentFlow: 작업 흐름 속에서 계획을 학습
검색하고 도구를 호출하고 결과를 확인하고 계획을 고치는 일이 여러 차례 이어진다. AgentFlow는 이 실행 흐름을 계획기, 실행기, 검증기, 생성기와 공유 메모리로 나눈다. 저자 도식에서 학습 대상은 계획기이고 다른 모듈은 고정된다. 따라서 “전체 시스템이 함께 학습된다”라고 읽으면 안 된다.
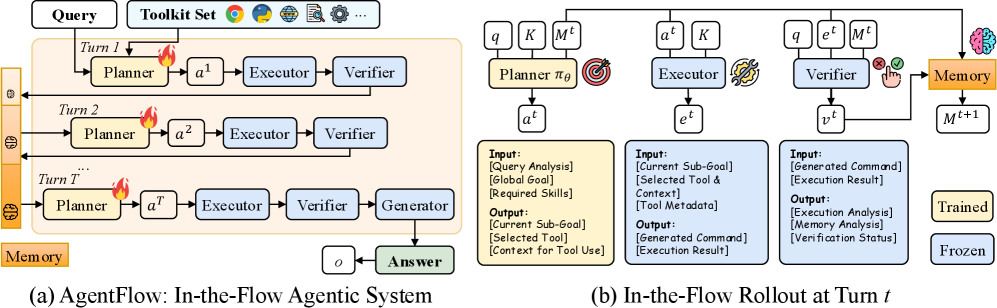
그림 1. Li, Zhang, Han, Liu, Xie, Zhang, Choi, Zou & Lu, 「In-the-Flow Agentic System Optimization for Effective Planning and Tool Use」, arXiv:2510.05592v2 Figure 2의 저자 그림을 그대로 사용했다. 계획기·실행기·검증기·생성기와 공유 메모리의 연결을 보여 준다. ICLR 2026 공식 oral이다.
논문은 완성된 실행 궤적의 최종 보상을 각 차례에 전달한다. 이는 여러 차례의 계획을 강화학습에 연결하는 알고리즘 선택이다. 각 도구 호출이 결과를 얼마나 인과적으로 바꿨는지를 개별 측정한 값은 아니다. 최종 보상이 같아도 중간의 우회나 실수는 다를 수 있으므로, 실행 기록을 읽는 평가가 별도로 필요하다.
ARPO는 불확실성이 큰 도구 사용 차례 뒤에 탐색 분기를 더 두고, HGPO는 서로 다른 이력을 가진 단계를 한 그룹에서 비교할 때 학습 신호가 어긋날 수 있음을 다룬다. 세 방법은 모두 장기 실행의 학습 문제를 다루지만 탐색 예산, 비교 집단, 최종 보상 처리라는 초점이 다르다. 서로 다른 벤치마크의 성적을 한 순위표로 합칠 근거는 여기서 제시하지 않는다.
3. AgentFold: 긴 기록을 언제, 어떻게 접을까
웹 에이전트는 방문한 페이지와 클릭 결과를 계속 받는다. 이를 전부 문맥에 쌓으면 현재 판단에 중요한 정보가 묻힌다. 너무 공격적으로 요약하면 나중에 필요한 제약을 잃는다. AgentFold는 실행 중 기록을 접어 남기는 방법을 다룬다. 한 단계만 세밀하게 접는 방식과 여러 단계를 깊게 묶는 방식이 그림에 나온다.
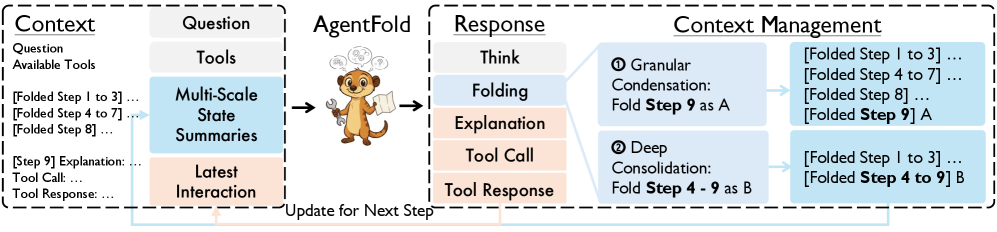
그림 2. Ye et al., arXiv:2510.24699v1 「AgentFold: Long-Horizon Web Agents with Proactive Context Management」 Figure 2의 저자 그림을 그대로 사용했다. 한 단계의 세밀한 정리와 여러 단계의 깊은 정리를 보여 준다. ICLR 2026 채택 제목은 「AgentFold: Long-Horizon Web Agents with Proactive Context Folding」이다.
대화 요약 외에도 보존할 정보가 있다. 이미 시도한 경로, 현재 화면에서 확인한 사실, 다음 행동을 제한하는 조건이 모두 이후 판단에 영향을 준다. 접힌 기록이 잘못됐다면 에이전트의 내부 상태와 실제 웹 상태가 어긋날 수 있다. Agentic Context Engineering은 한 작업의 문맥을 줄이기보다 여러 실행에서 얻은 전략을 playbook으로 유지한다. 두 연구가 저장하는 정보의 시간 범위가 다르다.
4. 도구와 평가 환경을 같이 기록하기
그래픽 화면에서 클릭할 때는 화면의 위치와 순서가 중요하다. API 호출에서는 매개변수의 형식과 실제 서버 상태가 중요하다. WALT는 반복적인 GUI 작업을 결정적인 도구로 바꾸는 접근을, ComputerRL은 GUI와 API 행동을 함께 학습하는 접근을 다룬다. 둘을 “도구 사용”이라는 한 점수로 비교하기 전에는 각각 무엇을 행동으로 허용하고 어떤 환경을 썼는지 확인해야 한다.
평가 연구도 서로 다른 실패를 겨냥한다. MCPMark는 실제 상태를 프로그램으로 검사한다. TRAJECT-Bench는 실행 궤적의 선택과 순서를, ST-WebAgentBench는 웹 작업의 실행 조건과 정책 준수를 보도록 한다. 마지막 답만 확인하면 잘못된 매개변수로 상태를 바꿨는지 놓칠 수 있다. 반대로 과정 검사는 도구와 권한 규칙이 명확해야 해석할 수 있다. 각 벤치마크는 자기 과제와 실행 틀 안에서 읽어야 한다.
5. 이 글이 제안하는 점검표
여기서의 실무 점검표는 다섯 축이다. 완료했는가, 도구 호출 과정이 유효한가, 권한과 지시 정책을 지켰는가, 반복 실행에서도 결과가 안정적인가, 그리고 도구·토큰·시간 비용은 얼마인가. 실패한 경우에는 어느 내부 상태가 실제 환경과 어긋났는지, 되돌릴 수 있는지도 기록하면 좋다. 이 다섯 축은 선정 사례에서 도출한 이 글의 제안이며, 모든 논문이 다섯 축을 함께 시험했다는 보고가 아니다.
선정 자료만으로 에이전트 연구 전체가 한 방향으로 이동했다고 단정할 수 없다. 다만 이 선정 사례들은 최종 답과 실행 경로를 구별해야 한다는 구체적인 질문을 제공한다. 결과를 재현할 때는 모델 이름과 성공률뿐 아니라 남긴 상태, 허용된 도구, 보상을 부여한 방식, 검증한 실제 환경을 같이 적어야 한다.
References
International Conference on Learning Representations. (2026). ICLR 2026 papers [Official main-conference listing]. https://iclr.cc/virtual/2026/papers.html
Li, Z., Zhang, H., Han, S., Liu, S., Xie, J., Zhang, Y., Choi, Y., Zou, J. Y., & Lu, P. (2026). In-the-flow agentic system optimization for effective planning and tool use. The Fourteenth International Conference on Learning Representations. https://iclr.cc/virtual/2026/poster/10009931
Ye, R., Zhang, Z., Li, K., Yin, H., Tao, Z., Zhao, Y., Su, L., Zhang, L., Qiao, Z., Wang, X., Xie, P., Huang, F., Zhou, J., Chen, S., & Jiang, Y. (2026). AgentFold: Long-horizon web agents with proactive context folding. The Fourteenth International Conference on Learning Representations. https://iclr.cc/virtual/2026/poster/10010254
Dong, G., Mao, H., Ma, K., Bao, L., Chen, Y., Wang, Z., Chen, Z., Du, J., Wang, H., Zhang, F., Zhou, G., Zhu, Y., Wen, J.-R., & Dou, Z. (2026). Agentic reinforced policy optimization. The Fourteenth International Conference on Learning Representations. https://iclr.cc/virtual/2026/poster/10009306
He, S., Feng, L., Wei, Q., Cheng, X., Feng, L., & An, B. (2026). Hierarchy-of-groups policy optimization for long-horizon agentic tasks. The Fourteenth International Conference on Learning Representations. https://iclr.cc/virtual/2026/poster/10009347
Zhang, Q., Hu, C., Upasani, S., Ma, B., Hong, F., Kamanuru, V., Rainton, J., Wu, C., Ji, M., Li, H., Thakker, U., Zou, J. Y., & Olukotun, K. (2026). Agentic context engineering: Evolving contexts for self-improving language models. The Fourteenth International Conference on Learning Representations. https://iclr.cc/virtual/2026/poster/10008343
Prabhu, V., Dai, Y., Fernandez, M., Ramakrishnan, K., Gu, J., Luo, Y., Savarese, S., Xiong, C., Li, J., Chen, Z., & Xu, R. (2026). WALT: Web agents that learn tools. The Fourteenth International Conference on Learning Representations. https://iclr.cc/virtual/2026/poster/10008481
Lai, H., Liu, X., Zhao, Y., Xu, H., Zhang, H., Jing, B., Ren, Y., Yao, S., Dong, Y., & Tang, J. (2026). ComputerRL: Scaling end-to-end online reinforcement learning for computer use agents. The Fourteenth International Conference on Learning Representations. https://iclr.cc/virtual/2026/poster/10007435
Wu, Z., Liu, X., Zhang, X., Chen, L., Meng, F., Du, L., Zhao, Y., Zhang, F., Ye, Y., Wang, J., Wang, Z., Ni, J., Yang, Y., Xu, A., & Shieh, M. Q. (2026). MCPMark: A benchmark for stress-testing realistic and comprehensive MCP use. The Fourteenth International Conference on Learning Representations. https://iclr.cc/virtual/2026/poster/10006866
He, P., Dai, Z., He, B., Liu, H., Tang, X., Lu, H., Li, J., Ding, J., Mukherjee, S., Wang, S., Xing, Y., Tang, J., & Dumoulin, B. (2026). TRAJECT-Bench: A trajectory-aware benchmark for evaluating agentic tool use. The Fourteenth International Conference on Learning Representations. https://iclr.cc/virtual/2026/poster/10009304
Levy, I., Wiesel, B., Marreed, S., Oved, A., Yaeli, A., & Shlomov, S. (2026). ST-WebAgentBench: A benchmark for evaluating safety and trustworthiness in web agents. The Fourteenth International Conference on Learning Representations. https://iclr.cc/virtual/2026/poster/10009904