ICLR 2026 GNN 연구 트렌드: 메시지 패싱 이후 확장된 연구 의제
ICLR 2026 GNN 선정 논문: 먼저 과제의 조건을 묻다
ICLR 2026 본회의에서 고른 그래프 학습 논문은 이웃의 라벨, 멀리 있는 정보, 모델 표현력, 그래프 입력 방식을 서로 다른 문제로 다룬다. 반례와 실험 도표를 통해 성능 주장이 성립하는 조건을 읽는다.
Sources: ICLR 2026 공식 본회의 논문 목록과 아래에 링크한 선정 논문. 여기서 다루는 여섯 편은 편집상 선택이다. 프로그램 전체의 그래프 연구 비중이나 연도별 증감을 뜻하지 않는다.
1. 그래프 문제를 한 이름으로 묶기 어려운 이유
그래프 신경망(GNN)은 노드가 주변 노드의 정보를 받아 자기 표현을 고치는 식으로 작동한다. 친구 관계라면 사람 하나가 노드, 관계가 간선이다. 몇 차례 이웃 정보를 주고받을지는 과제에 달려 있다. 가까운 이웃의 정보만으로 충분한지, 멀리 있는 노드의 신호가 필요한지부터 정해야 한다.
선정 논문들은 서로 다른 문제를 다룬다. 통념을 검토한 연구는 이웃 관계와 과제 요구를 분리한다. 표현력 연구는 더 많은 구조를 구별할 수 있어도 테스트 성능이 떨어질 수 있음을 보인다. 나머지 논문은 장거리 평가, 도메인 맞춤, Transformer에 그래프를 넣는 방법을 각각 다룬다. 이 순서는 이 글의 설명을 위한 배열이다. 해당 연구들이 합의한 개발 절차는 아니다.
2. 이웃이 다른 라벨이라도 항상 실패하지 않는다
Heterophily는 연결된 노드들의 라벨이 자주 다르다는 뜻이다. 예를 들어 서로 다른 역할의 사람이 주로 연결되는 네트워크다. Oversquashing은 멀리 있는 여러 노드의 정보가 작은 노드 표현 하나로 눌려 들어가면서 필요한 신호가 사라지는 현상이다. 두 현상은 별개다. 라벨이 다른 이웃이 많다고 해서 먼 정보가 꼭 필요한 것은 아니고, 비슷한 이웃이 많다고 해서 가까운 정보만으로 과제를 풀 수 있는 것도 아니다.
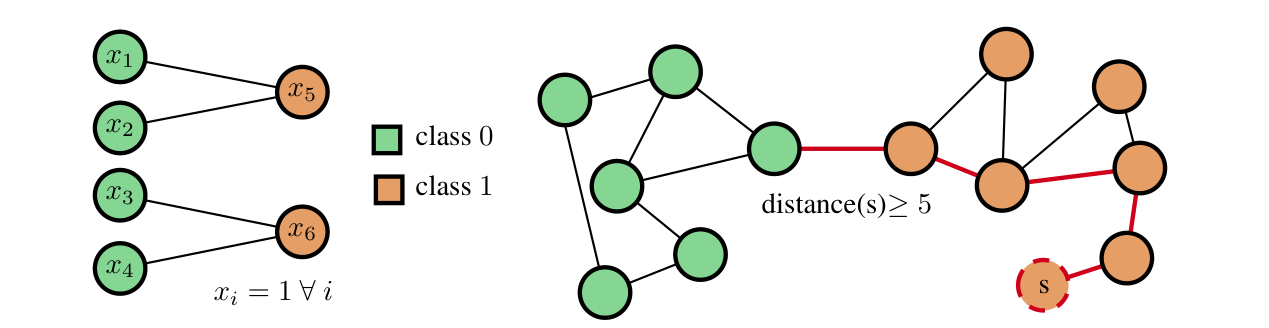
그림 1. Arnaiz-Rodríguez & Errica, 「Oversmoothing, “Oversquashing”, Heterophily, Long-Range, and more: Demystifying Common Beliefs in Graph Machine Learning」, ICLR 2026 게재 논문 Figure 2, PDF·인쇄 5쪽의 저자 그림을 그대로 사용했다. 왼쪽은 특징이 같은 이종 라벨 노드도 차수로 구별할 수 있음을, 오른쪽은 동종 연결이 높은 그래프도 지정한 노드에서 거리 5 초과의 정보가 필요함을 보이는 구성된 반례다.
왼쪽에서는 노드 특징이 같아도 연결 수, 즉 차수가 다르므로 구분이 가능하다. 오른쪽에서는 연결된 노드끼리 라벨이 비슷해도 정답이 멀리 떨어진 지정 노드와의 관계에 달려 있다. 그림은 “heterophily면 GNN이 실패한다” 또는 “homophily면 근처만 보면 된다”라는 단순 규칙을 깨뜨린다. 다만 반례 하나가 모든 데이터셋에서 어느 모델이 우수한지 정하지는 않는다.
LRIM 연구 역시 장거리 의존을 평가 과제에 분명히 넣으려 한다. 원문은 10개 Ising 데이터셋과 노드 수 256–65,000 범위를 다룬다. 여기서 중요한 질문은 메시지를 몇 층 전달했는가보다 정답을 내려면 정말 멀리 있는 정보가 필요한가다. 기존 벤치마크가 쉬운 가까운 단서로 풀린다면, 장거리 모델의 효과를 평가하기 어렵다.
3. 더 많은 구조를 구별하면 더 잘 일반화할까
표현력은 모델이 서로 다른 그래프 구조를 얼마나 잘 구분하는지를 뜻한다. 높은 표현력은 필요할 수 있지만 데이터가 적거나 학습과 시험 그래프가 다르면 잡음까지 기억할 수 있다. Maskey 등은 이 차이를 합성 과제와 실제 데이터의 여러 패널로 나누어 보여 준다.
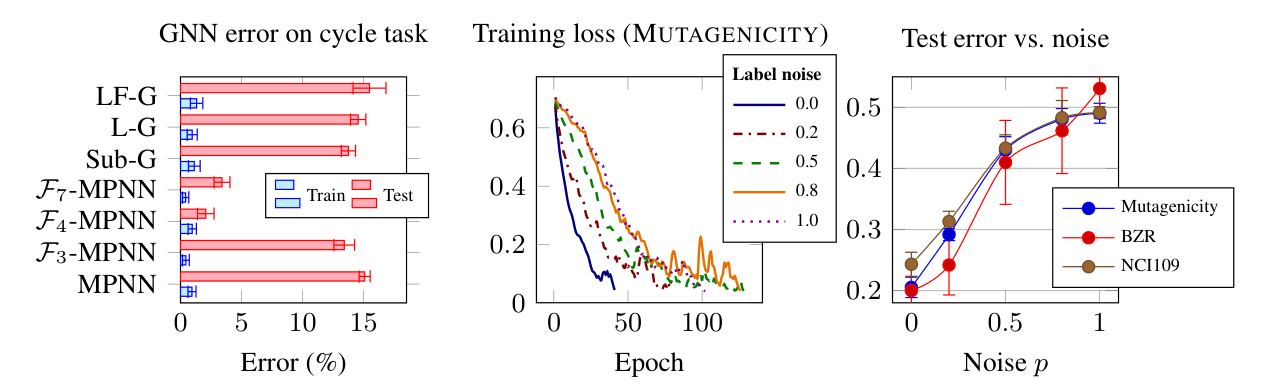
그림 2. Maskey, Paolino, Jogl, Kutyniok & Lutzeyer, 「Graph Representational Learning: When Does More Expressivity Hurt Generalization?」, ICLR 2026 게재 논문 Figure 1, PDF·인쇄 2쪽의 저자 그림을 그대로 사용했다. 왼쪽은 합성 순환 개수 과제의 학습·시험 오류, 가운데는 Mutagenicity의 학습 손실, 오른쪽은 라벨 잡음 조건의 BZR·Mutagenicity·NCI109 시험 오류다. 패널들의 데이터와 조건은 서로 다르다.
왼쪽 합성 순환 개수 과제에서는 훈련 오류가 낮아져도 시험 오류가 같은 방향으로 움직이지 않는다. 가운데와 오른쪽은 별도 실제 데이터와 라벨 잡음 조건을 보여 준다. 따라서 그림 전체를 “표현력이 높을수록 언제나 성능이 나쁘다”라는 한 줄 법칙으로 만들면 안 된다. 모델이 구별해야 할 구조, 표본 수, 라벨 품질을 함께 보고 성능을 판단해야 한다.
4. 다른 그래프와 Transformer에 연결하기
Modality-free Graph In-context Alignment는 서로 다른 그래프 도메인 사이의 정렬을 다룬다. 같은 ‘노드’라도 특징의 뜻과 차원, 라벨 체계가 달라 그대로 옮기기 어렵다. GraphGlue가 제안된 논문의 정식 제목은 Multi-Domain Riemannian Graph Gluing for Building Graph Foundation Models이다. 여기서 GraphGlue는 논문 제목이 아니라 여러 도메인의 그래프를 잇기 위한 방법의 이름이다. 두 연구는 도메인 사이에 무엇을 공통으로 둘지 묻지만 방법과 평가 조건은 각각 다르다.
Graph Tokenization for Bridging Graphs and Transformers는 그래프를 Transformer가 읽는 토큰 열로 바꾸는 문제를 다룬다. 그래프 토큰화는 노드·간선·작은 부분구조를 순서 있는 기호로 기록하는 과정이다. 공식 초록의 방법은 되돌릴 수 있는 직렬화와 BPE 방식의 토큰 묶기를 결합하고 14개 데이터셋에서 결과를 보고한다. 그래프를 단어처럼 입력하면 기존 언어 모델 구조를 쓸 수 있지만, 어떤 순서와 묶음을 택했는지가 모델에 보이는 구조를 정한다.
5. 선정 사례에서 얻는 평가 질문
이 글의 실무 점검표는 네 가지다. 첫째, 정답에 필요한 정보가 몇 홉 떨어져 있는가. 둘째, 노드 특징·라벨·간선의 관계를 분리해 설명할 수 있는가. 셋째, 표현력 증가가 어떤 데이터 양과 잡음에서 평가됐는가. 넷째, 다른 그래프나 토큰 열로 옮길 때 무엇이 보존되는가. 이 질문들은 선정 사례를 나란히 읽고 정리한 것이지 모든 연구가 같은 순서를 제안했다는 주장이 아니다.
References
International Conference on Learning Representations. (2026). ICLR 2026 papers [Official main-conference listing]. https://iclr.cc/virtual/2026/papers.html
Arnaiz-Rodríguez, A., & Errica, F. (2026). Oversmoothing, “Oversquashing”, Heterophily, Long-Range, and more: Demystifying Common Beliefs in Graph Machine Learning. The Fourteenth International Conference on Learning Representations. https://proceedings.iclr.cc/paper_files/paper/2026/hash/6697bb267dc517379bc8aa326e844f8d-Abstract-Conference.html
Maskey, S., Paolino, R., Jogl, F., Kutyniok, G., & Lutzeyer, J. (2026). Graph Representational Learning: When Does More Expressivity Hurt Generalization? The Fourteenth International Conference on Learning Representations. https://proceedings.iclr.cc/paper_files/paper/2026/hash/ac29036313fcd6fb84fd48787fe103d0-Abstract-Conference.html
Mathys, J., Christiansen, H., Errica, F., Maruyama, T., & Alesiani, F. (2026). LRIM: A physics-based benchmark for provably evaluating long-range capabilities in graph learning. The Fourteenth International Conference on Learning Representations. https://proceedings.iclr.cc/paper_files/paper/2026/hash/47a2d4257a8cdd04d17ecbafdbb187b9-Abstract-Conference.html
Zhuo, W., & Luo, S. (2026). Modality-free graph in-context alignment. The Fourteenth International Conference on Learning Representations. https://iclr.cc/virtual/2026/poster/10008531
Sun, L., Huang, Z., Chen, S., Yang, L., Ye, J., Su, S., & Yu, P. (2026). Multi-domain Riemannian graph gluing for building graph foundation models. The Fourteenth International Conference on Learning Representations. https://proceedings.iclr.cc/paper_files/paper/2026/hash/3e9dfea4bb53006684177ba49ac11ec7-Abstract-Conference.html
Guo, Z., Diao, E., Yang, C., & Shi, C. (2026). Graph tokenization for bridging graphs and transformers. The Fourteenth International Conference on Learning Representations. https://proceedings.iclr.cc/paper_files/paper/2026/hash/2c0781f2ed2d8054d4f27a19bd8c380b-Abstract-Conference.html