CoEvoT: Co-Evolving Chain-of-Thought Prompting for Graph–LLM Reasoning
생각이 그래프 증거를 다시 쓰게 하는 방법: CoEvoT
CoEvoT는 LLM의 중간 사고를 이용해 그래프 토큰을 단계마다 갱신하고, 새 토큰으로 다음 추론을 이끄는 Graph–LLM 방식이다. 교차 데이터셋 성능은 강하지만, 링크 예측의 작은 마진과 긴 추론 시간은 함께 고려해야 한다.
Paper: Haohua Niu; Xingtong Yu; Yang Liu; Junfeng Fang; Xuanting Xie; Jie Tan; Zhongjian Zhang; Hong Cheng; Yuan Fang (2026). "CoEvoT: Co-Evolving Chain-of-Thought Prompting for Graph–LLM Reasoning." arXiv:2607.14114v1. PDF
1. 정적 그래프 토큰의 한계
그래프–LLM 방법은 그래프 임베딩을 토큰으로 바꿔 LLM 프롬프트에 넣는다. 일반 CoT는 중간 생각을 여러 번 만들지만, 그래프 토큰은 처음 넣은 채로 남는다. CoEvoT는 중간 생각이 새 단서를 드러냈다면 그래프 표현도 다음 단계에서 바뀌어야 한다고 본다.
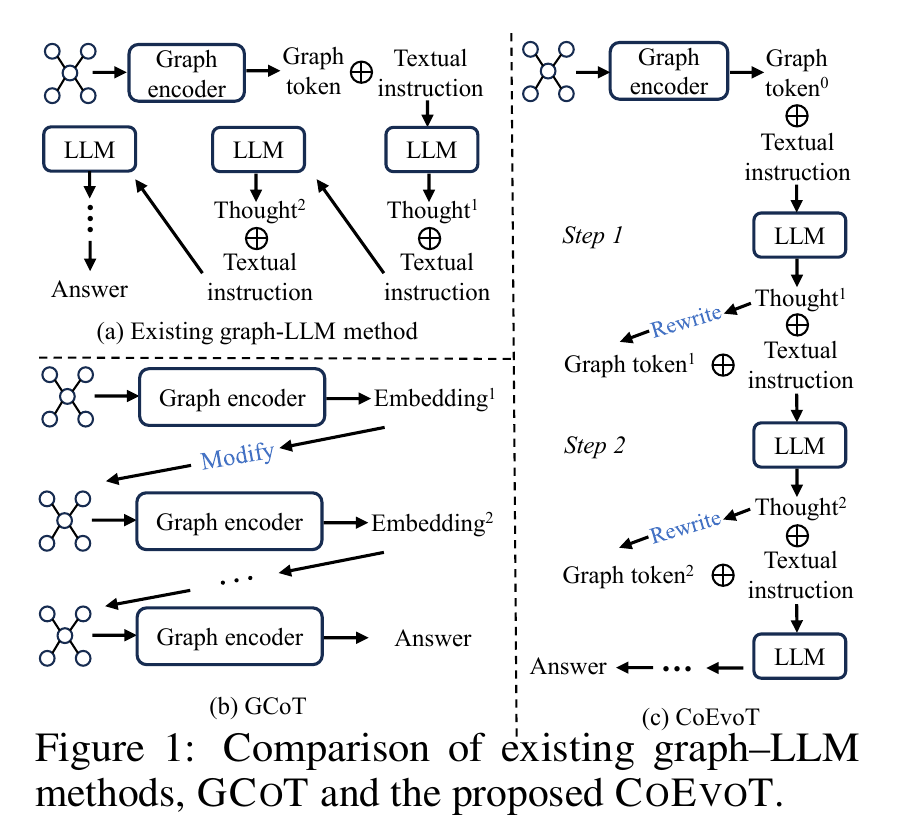
그림 1. 원논문 arXiv v1 PDF p. 2의 Figure 1을 인용했다. 기존 graph–LLM은 고정된 graph token 위에서 생각만 진행하고, CoEvoT는 각 thought 뒤 graph token을 rewrite한다. 화살표는 데이터 구조 자체를 수정한다기보다, LLM에 다시 주입할 잠재 표현을 갱신한다는 뜻이다.
2. 방법: text-to-graph와 graph-to-text의 폐루프
동결된 graph encoder와 LLM 위에 작은 linear projector와 condition network만 학습한다. LLM이 한 단계 thought를 생성하면, condition network가 지금까지의 thought를 읽어 노드 임베딩에 더할 조건 신호를 만든다. 갱신된 임베딩은 다시 graph token이 되어 다음 thought의 프롬프트에 들어간다. 마지막 단계에 쌓인 thought와 토큰으로 답을 낸다.
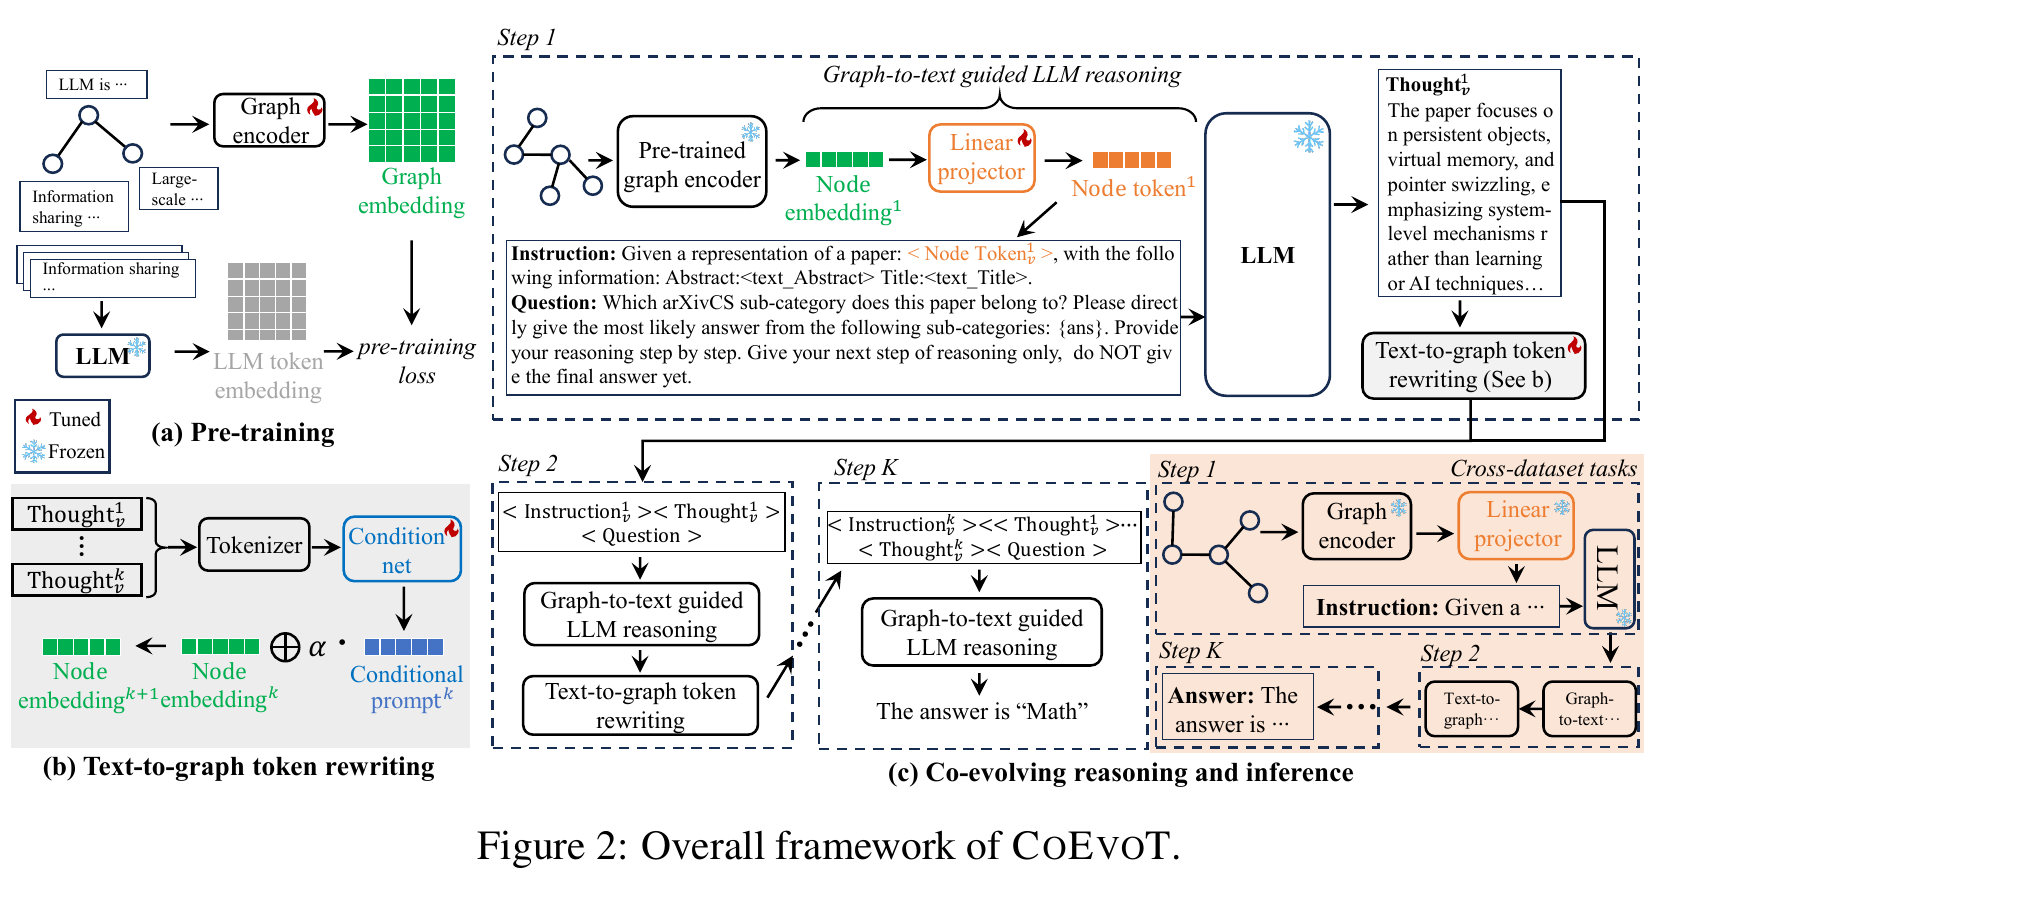
그림 2. 원논문 arXiv v1 PDF p. 4의 Figure 2를 인용했다. 사전학습된 graph encoder에서 node token을 만들고, LLM thought가 text-to-graph rewriting을 거쳐 다음 step의 graph-to-text reasoning을 안내하는 순서를 보여 준다. snowflake와 빨간 아이콘은 각각 동결·학습 부품을 구분한다.
3. 결과: 전이 과제에서의 우위
저자들은 Arxiv와 Computer를 source로 두고 다른 인용·전자상거래 그래프로 옮긴다. 노드 분류에서 CoEvoT는 PubMed 0.902, Cora 0.265, History 0.641 등 여섯 target에서 표 최고 정확도의 점추정치를 보고했다. 링크 예측 AUC도 여덟 데이터셋에서 최고라고 보고한다. 해당 전이 프로토콜에서 시스템 전체가 낸 순위다. 재작성 자체의 기여는 다음 구성요소 실험을 통해 더 좁게 살펴봐야 한다.
절제는 한 단계만 쓰는 Variant 1, 다단계 CoT는 쓰되 그래프 재작성을 하지 않는 Variant 2와 비교한다. CoEvoT가 모든 표 열에서 가장 높았고, Variant 2가 일부 데이터셋에서 Variant 1보다 낮은 값도 보여 준다. 이 결과로는 생각 단계를 늘리는 것보다, 그 생각으로 구조 토큰을 갱신하는 조합이 중요하다고 해석할 수 있다.
4. 지연과 작은 마진
링크 예측 Photo에서 CoEvoT 0.549와 TEA-GLM 0.545의 차이는 0.004다. 링크 예측과 절제 표에는 표준편차가 없어 이 정도의 작은 차이가 반복해도 유지되는지 알 수 없다. 또한 graph backbone과 LLM을 각각 하나만 사용했으므로, 다른 인코더나 LLM에서도 재작성 이득이 같은지는 미확인이다.
반복 추론에는 시간도 더 든다. Table 6은 zero-shot 노드 분류의 데이터셋별 추론 시간으로 PubMed의 CoEvoT 6732.9초, TEA-GLM 1749.4초, GOFA 946.1초를 적는다. 그러나 전체 테스트 분할·배치·단일 질의 중 무엇을 잰 값인지 밝히지 않아, 6732.9초를 요청 한 건의 지연으로 해석할 수 없다. 실험 환경은 48GB NVIDIA vGPU 한 장이지만 GPU 모델과 추론 배치 크기는 명시하지 않는다. 논문은 K=2 단계로 제어할 수 있다고 보지만, 정확도 이득이 작을 때는 LLM을 단계별로 호출하고 token을 다시 쓰는 비용이 정당화되지 않을 수 있다.
5. 적용 조건
그래프가 새 도메인으로 옮겨가고, 중간 추론이 어떤 구조 단서를 다시 강조해야 하며, offline batch inference 지연을 감당할 수 있을 때 CoEvoT의 폐루프가 맞는다. 즉시 응답이 필요한 서비스나 작은 전이 마진의 데이터셋에서는 정적 graph token 방식과 같은 예산에서 비교해야 한다. CoT 문장을 사람에게 설명으로 제공할 때도, token 재작성의 내부 상태가 실제 그래프 사실을 증명하지는 않는다는 점을 구분해야 한다.
References
Niu, H., Yu, X., Liu, Y., Fang, J., Xie, X., Tan, J., Zhang, Z., Cheng, H., & Fang, Y. (2026). CoEvoT: Co-evolving chain-of-thought prompting for graph–LLM reasoning (arXiv:2607.14114v1). arXiv. https://arxiv.org/abs/2607.14114