Deep GraphRAG: A Balanced Approach to Hierarchical Retrieval and Adaptive Integration
넓게 보고 좁혀 찾는 GraphRAG: Deep GraphRAG
Deep GraphRAG는 커뮤니티 계층을 global에서 local로 내려오며 탐색하고, 작은 지식 통합 모델을 보상 재가중으로 학습한다. NQ·HotpotQA의 EM과 DRIFT 대비 지연 감소는 강점이지만, 1.5B 근접 성능은 증류된 통합 단계에 한정된다.
Paper: Yuejie Li; Ke Yang; Tao Wang; Bolin Chen; Bowen Li; Chengjun Mao (2026). "Deep GraphRAG: A Balanced Approach to Hierarchical Retrieval and Adaptive Integration." arXiv:2601.11144v3. PDF
1. 문제: global 검색과 local 검색의 갈림길
local search는 특정 엔티티를 빨리 찾지만 여러 커뮤니티에 흩어진 질문을 놓칠 수 있다. global search는 넓은 요약을 보지만 정작 세부 사실을 뭉개기 쉽다. Deep GraphRAG는 지식 그래프의 커뮤니티 계층을 위에서 아래로 내려오며 두 장점을 함께 쓰려 한다.
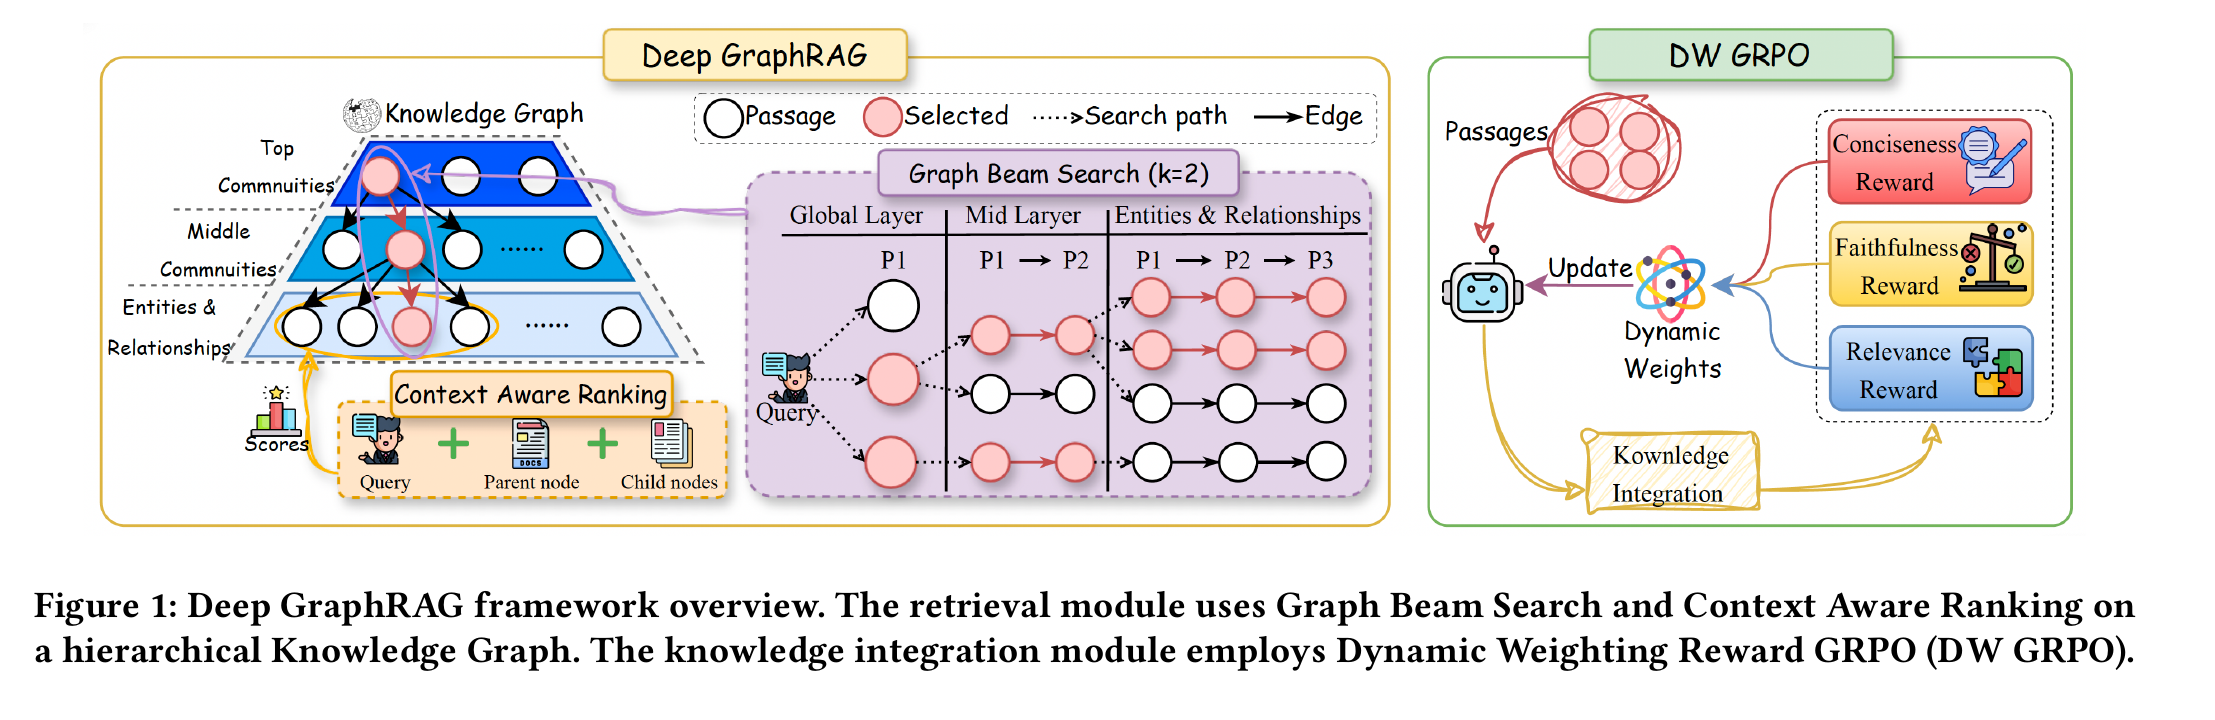
그림 1. 원논문 arXiv v3 PDF p. 2의 Figure 1을 인용했다. 왼쪽은 커뮤니티 계층에서 Graph Beam Search와 context-aware ranking을 하는 retrieval, 오른쪽은 relevance·faithfulness·conciseness 보상을 조정하는 knowledge integration이다. 그림은 각 모듈의 독립 성능을 보여 주는 절제 표가 아니다.
2. 방법: 세 번 좁혀 찾고, 작은 모델로 통합한다
검색은 먼저 상위 커뮤니티에서 관련 없는 가지를 자르고 남은 커뮤니티 안의 하위 그래프를 정제하며 마지막으로 엔티티 수준에서 문맥을 재순위화한다. 각 단계는 beam width 3으로 후보를 제한한다. global search의 넓은 범위에서 출발해 local search 수준의 세부 근거로 좁혀 가는 coarse-to-fine 경로 탐색이다.
검색된 근거는 별도 지식 통합 모델이 요약한다. 저자들은 1.5B 모델을 큰 교사 모델로 지도 미세조정한 뒤, relevance·faithfulness·conciseness 중 개선이 느린 보상에 더 무게를 주는 DW-GRPO로 다듬는다. 큰 모델의 지식 통합 방식을 작은 모델로 옮기려는 훈련 절차다. ‘작은 모델만으로 충분하다’는 뜻은 아니다.
3. 결과: 균형의 증거와 그 분모
논문은 LQ를 직접 연결된 1–2개 엔티티에 관한 지역 질문, GQ를 보통 여러 커뮤니티의 2개 초과 엔티티를 다루는 전역 질문, CQ를 지역 사실과 전역 문맥이 함께 필요한 질문으로 나눈다. EM은 정답과 정확히 일치한 비율이며, EM-Total은 전체 질문의 결과다.
Natural Questions에서 Deep GraphRAG(72B 통합)는 EM-Total 44.69으로 DRIFT 42.78을, HotpotQA에서는 44.67으로 DRIFT 33.89를 보고한다. Local Search는 지역 질문에, Global Search는 전역 질문에 상대적으로 강하지만 특정 종합 질문에서 무너지는 패턴이 표에 보인다. Deep GraphRAG의 ‘균형’은 모든 질문 유형에서 최고라는 뜻이 아니라, 세 유형의 손실을 줄여 total에서 앞선다는 뜻이다.
1.5B-DW-GRPO 통합 모델은 NQ 42.36으로 72B 통합 모델 44.69에 가깝다. HotpotQA에서는 38.44 대 44.67로 더 큰 차이가 남는다. 또한 최종 답변 모델은 큰 모델로 고정되어 있고 바뀌는 것은 지식 통합 단계다. 따라서 1.5B가 end-to-end 72B를 대체한다는 결론은 원 논문이 보여 준 범위를 넘는다.
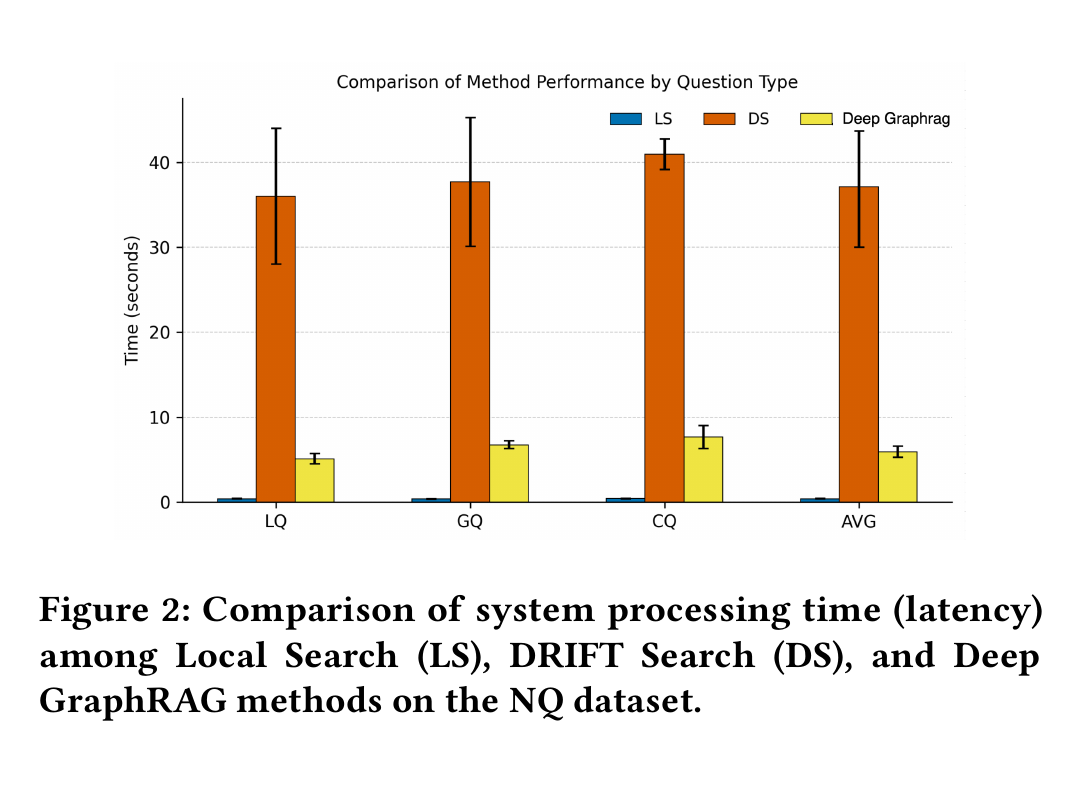
그림 2. 원논문 arXiv v3 PDF p. 3의 Figure 2를 인용했다. NQ의 local search, DRIFT search, Deep GraphRAG 처리시간을 질문 유형별로 비교한다. Deep GraphRAG의 DRIFT 대비 지연 감소는 이 데이터셋·이 baseline의 상대 비교이며, 측정의 시작·종료 기준과 그래프 구축시간 포함 여부는 설명하지 않는다.
4. 무엇을 할인해서 읽어야 하나
논문은 Figure 2의 NQ 질문 유형별 처리시간 비교에서 DRIFT 대비 LQ 86%, GQ 81.6% 감소를 보고한다. 하드웨어·유형별 표본 수·측정 구간은 공개하지 않는다. 그림은 시스템 처리시간의 조건부 비교이며, 계층 깊이·그래프 크기·beam width를 바꾼 절제가 없어 어떤 장치가 절약을 만들었는지는 분리되지 않는다.
또한 CQ에서는 항상 이기지 않는다. 저자들은 DeepSeek-R1 조건의 NQ에서 Local Search가 Deep GraphRAG보다 높은 CQ EM을 낸 사례를 인정한다. 커뮤니티 요약이 필요한 세부 사실을 가릴 수 있다는 한계도 있다. LQ/GQ/CQ 유형의 표본 수와 분류 기준도 자세히 공개되지 않아 total 점수의 가중 구조는 복원하기 어렵다.
5. 적용 조건
여러 문서 커뮤니티를 가로지르는 질문과 지역 사실을 모두 다뤄야 하고, 그래프 계층을 구축할 비용을 감당할 수 있다면 이 설계는 후보가 된다. 적용 전에는 질문 유형 정의, 커뮤니티 규모, 계층 깊이, 검색과 통합 모델의 비용을 따로 측정해야 한다. 특히 요약이 사실을 숨기지 않는지 문장 수준 근거로 검사해야 한다.
적용 판단의 근거 경계
이 방법은 global 질문과 local 사실을 함께 다루면서 계층 그래프를 위에서 아래로 좁힐 필요가 있을 때 검토할 수 있다. 근거는 NQ와 HotpotQA의 유형별 EM, 그리고 NQ에서 DRIFT Search와 비교한 지연시간이다(원문 §3–4). 그래프 구축, 재랭킹, 증류·DW-GRPO 학습을 모두 포함한 총비용 비교는 보고되지 않았으므로, 낮은 지연 수치를 시스템 전체의 낮은 운영비로 확대하면 안 된다.
References
Li, Y., Yang, K., Wang, T., Chen, B., Li, B., & Mao, C. (2026). Deep GraphRAG: A balanced approach to hierarchical retrieval and adaptive integration (arXiv:2601.11144v3). arXiv. https://arxiv.org/abs/2601.11144