LeanRAG: Knowledge-Graph-Based Generation with Semantic Aggregation and Hierarchical Retrieval
요약을 섬으로 남기지 않는 계층 검색: LeanRAG
LeanRAG는 비슷한 엔티티를 상위 개념으로 집약하고 집약 개념 사이 관계까지 만들어 질문의 세부 근거에서 공통 상위 구조로 올라간다. 긴 답에 중복 문맥이 쌓이는 문제를 줄이려는 계층형 GraphRAG 설계다.
Paper: Yaoze Zhang; Rong Wu; Pinlong Cai; Xiaoman Wang; Guohang Yan; Song Mao; Ding Wang; Botian Shi (2026). "LeanRAG: Knowledge-Graph-Based Generation with Semantic Aggregation and Hierarchical Retrieval." AAAI 2026, 40(41), 34862–34869. PDF
1. 문제: 요약이 많아도 서로 연결되지 않을 수 있다
GraphRAG는 긴 문서에서 엔티티와 관계를 뽑고, 비슷한 항목을 묶어 상위 요약을 만든다. 그런데 상위 요약이 각각 독립된 ‘semantic island’가 되면, 두 요약 사이의 관계가 답에 필요해도 검색기는 각 요약을 평면적으로 훑기 쉽다. 관련 원문과 요약을 많이 가져오면 이번에는 같은 정보를 여러 번 읽는 중복 문맥이 커진다.
LeanRAG는 요약 노드를 단순한 메모가 아니라 그래프의 새 층으로 만든다. 먼저 기본 지식 그래프의 엔티티 설명을 임베딩하고, 의미적으로 가까운 엔티티를 Gaussian Mixture Model(GMM)으로 군집화한다. 각 군집에는 LLM이 새 집약 엔티티와 설명을 만든다. 또한 집약 엔티티 사이에도 관계를 만든다. 상위 개념 사이에도 그래프 경로가 생긴다.
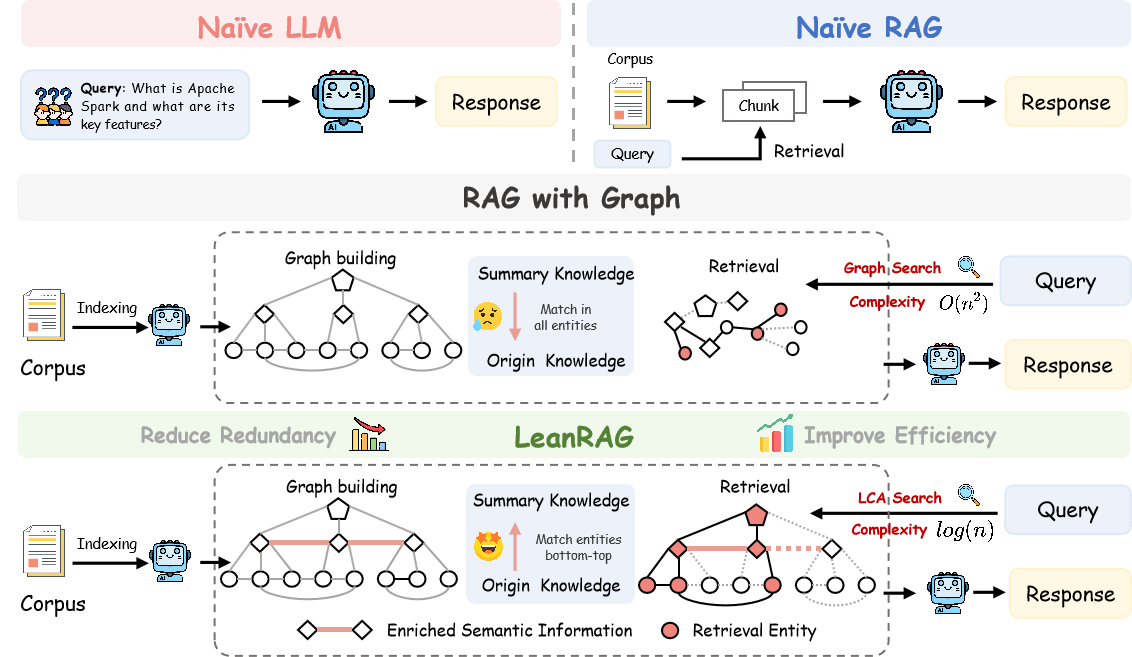
그림 1. Zhang et al., Figure 1, arXiv:2508.10391v4 PDF p. 2의 원도판 추출물. 평면 RAG·기존 GraphRAG·LeanRAG의 인덱스와 검색 단위를 비교한다. 그림의 복잡도 표기는 설계 직관이며, 본문은 모든 자료구조와 계층 조건에 대한 독립적 복잡도 증명을 제공하지 않는다. CC BY 4.0.
2. 질문에서 상위 개념으로 올라가는 검색
질문 “Apache Spark는 무엇이며 핵심 기능은 무엇인가?”가 들어오면 LeanRAG는 먼저 기본층의 Spark처럼 구체적인 엔티티를 찾는다. 다음으로 여러 출발 엔티티가 만나는 가장 낮은 공통 조상(LCA)을 향해 위로 올라간다. LCA는 트리에서 둘 이상의 노드를 함께 포함하는 가장 가까운 상위 노드다. 여기서는 Spark의 기능, 생태계, 배포 같은 하위 단서를 하나의 상위 개념으로 모으는 역할을 한다.
각 경로에서 원문 엔티티·관계·상위 집약 노드를 모으므로, 최종 답변은 상세 사실과 넓은 설명을 함께 받을 수 있다. 그러나 이 구조가 논리적 정답을 보장하지는 않는다. 군집은 엔티티 설명의 임베딩 유사도로 만들기 때문에, 같은 원인을 공유하지 않는 항목도 주제상 가깝다는 이유로 한 상위 개념에 들어갈 수 있다.
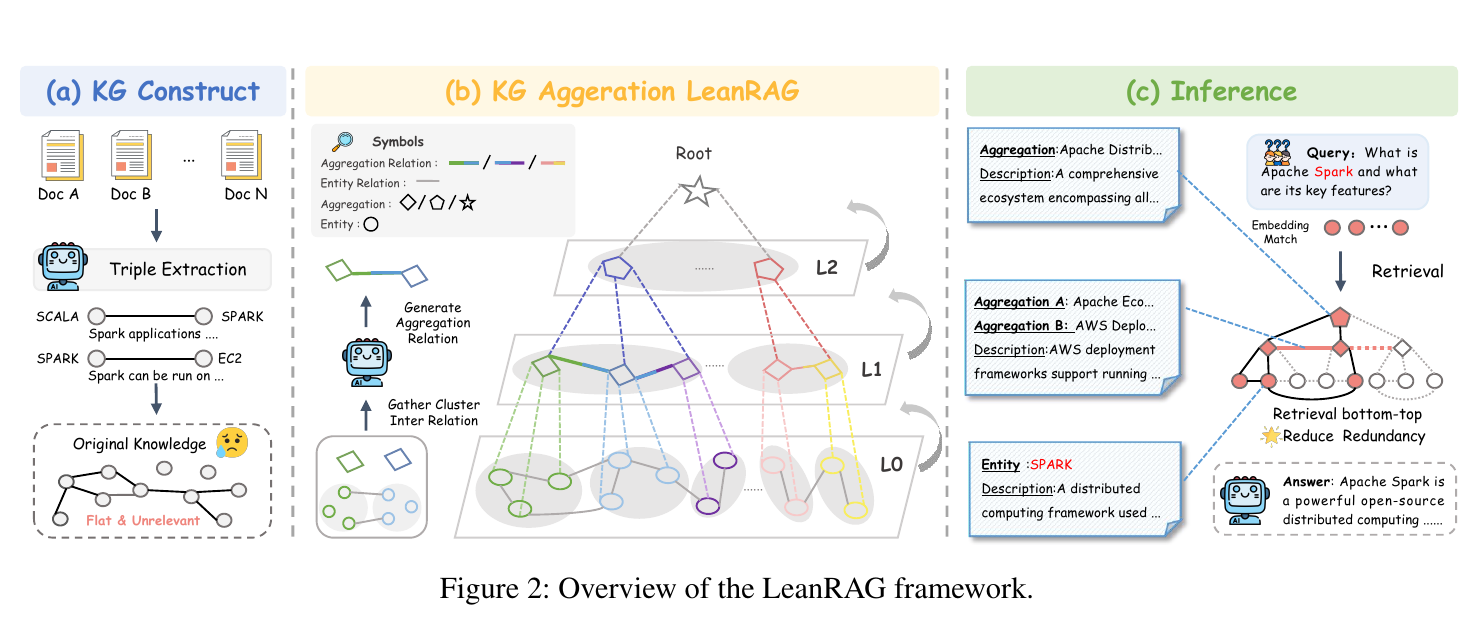
그림 2. Zhang et al., Figure 2, arXiv:2508.10391v4 PDF p. 4의 원도판 크롭. 왼쪽 기본 KG에서 가운데 다층 집약 그래프를 만들고, 오른쪽에서 세부 엔티티에서 상위 집약 노드로 검색하는 흐름을 보라. 집약 관계는 LLM이 생성하므로 별칭·모순·시간 변화 해결을 자동으로 뜻하지 않는다. CC BY 4.0.
3. 성능과 비용은 같은 실험이 아니다
저자들은 Agriculture, CS, Legal, Mix의 네 UltraDomain 데이터셋에서 HiRAG, NaiveRAG, GraphRAG local search, LightRAG, FastGraphRAG, KAG를 비교했다. Table 1의 답변 품질은 DeepSeek-V3가 1–10점으로 판정한 절대 점수다. LeanRAG가 많은 셀에서 앞서지만, 모든 데이터셋·평가 차원에서 가장 높지는 않다. 예를 들어 GraphRAG는 global search가 아니라 local search만 사용했다. 그러므로 이 결과를 GraphRAG 전체 방식에 대한 승패로 확대하면 안 된다.
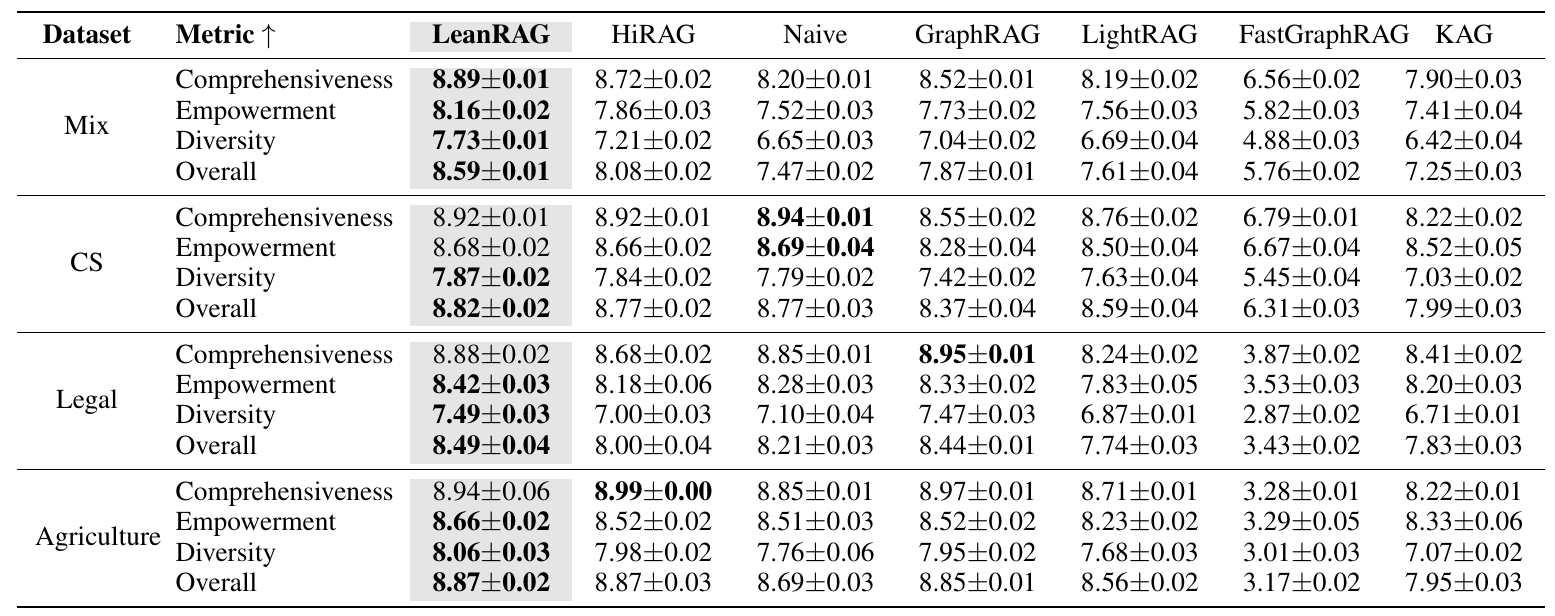
그림 3. Zhang et al., Table 1, arXiv:2508.10391v4 PDF p. 7의 원도판 크롭. 네 UltraDomain 데이터셋에서 DeepSeek-V3가 낸 1–10점 답변 품질을 비교한다. 자동 judge 점수이며 정답률·retrieval recall·사람 평가와 같은 지표가 아니다. 비교한 GraphRAG는 local search 설정이다. CC BY 4.0.
논문은 평균 retrieval redundancy를 46% 줄였다고 보고한다. 다만 token은 모델이 텍스트를 처리하는 단위다. 이 token 중복 비교(Figure 3)는 비용을 줄이기 위해 Qwen3-14B-Instruct로 다시 구현한 조건이고, Table 1은 DeepSeek-V3 조건이다. 따라서 46%는 같은 품질에서 절감한 전체 운영비가 아니라, 그 재현 설정에서 검색 문맥 토큰이 더 작았다는 결과로 읽어야 한다. 색인 단계에는 triple 추출, 임베딩, GMM 군집, 집약 엔티티·관계 생성이 모두 든다.
4. 원문과 관계를 빼면 무엇이 달라지나
구성요소 실험은 상위 관계와 원문 passage가 보조 장치가 아니라는 점을 시사한다. 집약 관계를 뺀 변형은 전체 모델보다 낮은 선호 경향을 보이고, 원문을 빼면 고수준 집약 노드만으로는 충분하지 않다. 이 결과는 요약이 좋은 답을 만드는 일과 답을 원문 근거에 충실하게 만드는 일이 다름을 보여준다.
그렇다고 이 결과만으로 LCA 경로가 사실 검증을 해결한다고 말할 수는 없다. 논문의 평가는 답변 품질과 token 수에 집중하며, 문장별 인용 정확도·엔티티 병합 오류·상충 관계의 처리율은 별도로 보고하지 않는다. 특히 계약 조항이나 임상 지침처럼 예외와 시간성이 중요하면 원문 passage와 출처를 끝까지 보존해야 한다.
5. 어떤 경우에 맞는가
한 질문이 여러 세부 엔티티를 포괄하는 큰 개념을 요구하고, 답변 문맥의 중복이 실제 비용을 키우는 지식베이스가 자연스러운 대상이다. 도입할 때는 군집의 사람이 읽는 일관성, LCA 경로가 놓치는 관련 항목, 쿼리당 prompt token과 별도의 색인 LLM 비용을 함께 측정해야 한다. ‘계층 검색’이라는 표현만 보고 query latency와 total cost가 자동으로 낮다고 가정하면 안 된다.
6. 정리
LeanRAG는 요약을 끝점으로 두지 않는다. 집약 엔티티와 집약 관계를 새 그래프 층으로 만들어 세부 근거에서 공통 상위 구조까지 올라가게 한다. 이 구조는 복합 질문에서 덜 중복된 문맥을 만들 가능성을 보인다. 성능과 46% token 결과는 서로 다른 모델 조건이며, 자동 judge와 local GraphRAG 비교라는 범위도 남는다. 적용 판단은 계층의 설명력뿐 아니라 원문 출처 보존과 실제 색인·질의 예산을 함께 확인해야 한다.
References
Zhang, Y., Wu, R., Cai, P., Wang, X., Yan, G., Mao, S., Wang, D., & Shi, B. (2026). LeanRAG: Knowledge-graph-based generation with semantic aggregation and hierarchical retrieval. Proceedings of the AAAI Conference on Artificial Intelligence, 40(41), 34862–34869. https://doi.org/10.1609/aaai.v40i41.40789