Knowledge Graph Prompting for Multi-Document Question Answering
다음 근거를 생성하는 검색: KGP
KGP는 문서 passage·page·table을 graph로 연결하고, LLM이 다음 근거의 설명을 생성해 이웃 node를 고른다. passage QA와 PDFTriage 구조 검색은 별도 평가 트랙이며, 12문서·30-passage 실험 범위를 대규모 전역 색인 성능으로 확대하면 안 된다.
Paper: Yu Wang; Nedim Lipka; Ryan A. Rossi; Alexa F. Siu; Ruiyi Zhang; Tyler Derr (2024). "Knowledge Graph Prompting for Multi-Document Question Answering." Proceedings of the AAAI Conference on Artificial Intelligence, 38(17), 19206–19214. https://doi.org/10.1609/aaai.v38i17.29889. PDF
1. 문제: 질문과 답 사이에 근거의 순서가 있다
여러 문서를 묻는 QA에서는 질문과 답이 담긴 passage가 직접 닮지 않을 수 있다. 예컨대 “한 작곡가와 협업한 영화감독의 출생지는?”이라는 질문은 작곡가→협업 영화→감독→출생지처럼 두세 passage를 잇는다. 단일 vector retrieval은 질문과 가장 비슷한 passage를 고르는 데 강하지만, 첫 passage에서 무엇을 다음에 찾아야 하는지 정하지는 않는다.
KGP(Knowledge Graph Prompting)는 문서의 passage를 node로 두고 lexical·semantic similarity 또는 공통 entity로 edge를 만든다. page와 table도 node가 될 수 있어 “Table 2의 값”처럼 구조를 묻는 질문을 따로 다룬다(§3, Fig. 3). 이름에 knowledge graph가 있지만, 이 구조는 사실 관계 triple의 정답성을 저장한 전통적 KG보다 문서 조각 사이를 이동하기 위한 graph에 가깝다. edge는 ‘사실이다’가 아니라 ‘다음 근거 후보일 수 있다’를 뜻한다.
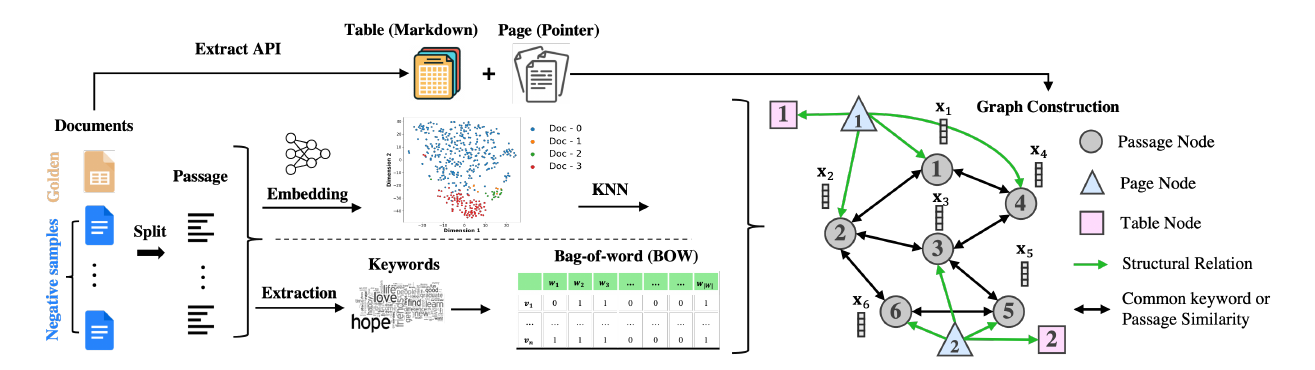
그림 1. Wang et al., Figure 3, AAAI-24 PDF p. 3의 원도판이다. 문서를 passage로 나누고 content edge와 page/table 구조 edge를 추가하는 방식을 보라. similarity edge는 두 passage의 논리적 함의나 원인 관계를 보증하지 않는다.
2. 방법: LLM을 답변기가 아니라 navigator로 쓴다
content question에서는 먼저 TF-IDF로 seed passage를 찾고 graph traversal을 시작한다. 현재까지 모은 근거와 질문을 받은 traversal LLM은 최종 답을 쓰지 않고, 다음에 필요한 evidence가 어떤 문장일지를 자연어로 생성한다. 시스템은 이 생성문을 현재 node의 실제 neighbor들과 비교해 가장 가까운 node를 고른다(§3.2, Algorithm 1). 자유 생성이 틀려도 생성문 자체를 답으로 쓰지 않고 corpus에 실제로 있는 passage만 다음 context에 넣으려는 장치다.
그 뒤 별도 downstream reader가 retrieval된 context를 받아 최종 답을 생성한다. 즉 navigator의 Table 2 결과는 생성된 next-evidence 문장의 독립 정확도도, 최종 reader의 단독 성능도 아니다. structure question은 Page 1, Table 2 같은 표현을 추출해 해당 node의 내용을 가져온다.
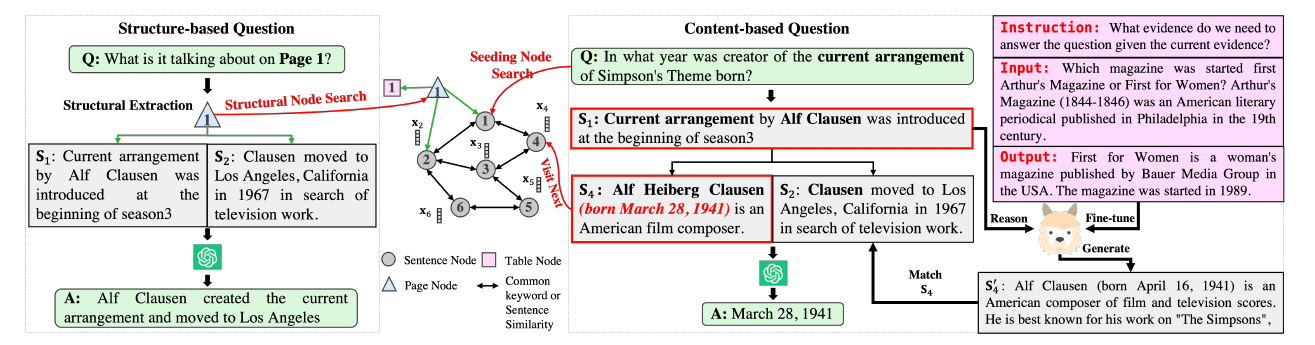
그림 2. Wang et al., Figure 4, AAAI-24 PDF p. 4의 원도판이다. 왼쪽 구조 node retrieval과 오른쪽 content traversal의 분기를 보라. LLM이 만든 다음-evidence 문장은 후보 ranking 신호이고, 최종 답은 retrieval된 context를 읽는 downstream reader가 생성한다.
3. graph를 어떻게 만들었는가가 검색의 절반이다
논문은 네 edge construction을 비교한다. TF-IDF는 keyword 공유, KNN-ST는 sentence-transformer 유사도, KNN-MDR은 다음 supporting fact 순서로 학습한 임베딩, TAGME는 공통 Wikipedia entity를 쓴다(§3.1). 주 passage-QA 실험의 강한 graph는 TAGME 기반이며, Wikipedia entity가 잘 잡히는 문서에 특히 자연스럽다. 저자들은 부록에서 12개 Wikipedia 문서의 entity 추출에 8시간 이상, 병렬 처리 후에도 2시간 이상이 걸릴 수 있다고 보고한다.
Graph를 조밀하게 하면 정답 supporting fact가 이웃에 있을 가능성은 높아지지만, 관련 없는 이웃도 함께 늘어난다. Figure 5는 HotpotQA에서 이 trade-off를 직접 보여 준다.
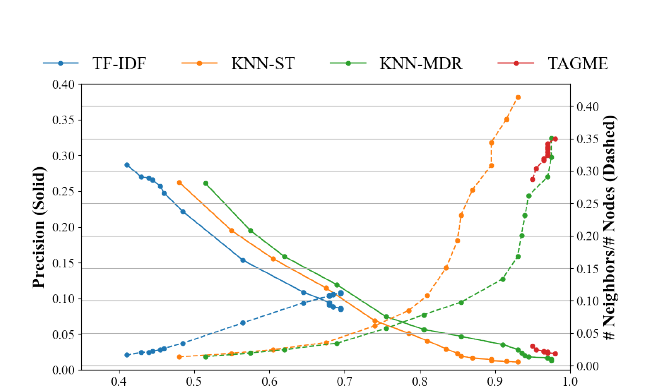
그림 3. Wang et al., Figure 5, AAAI-24 PDF p. 4의 원도판이다. graph가 조밀할수록 supporting-fact coverage는 오르지만 precision은 낮아지는 방향을 보라. 이 실험은 HotpotQA passage graph construction의 trade-off이며 다른 domain의 최적 density를 정해 주지는 않는다.
4. 결과: passage QA 평균은 강했고, 구조 QA는 별도 트랙이다
passage QA 평가는 HotpotQA 500개, IIRC 477개, 2WikiMQA 500개, MuSiQue 500개 development question에서 이뤄졌다. 각 질문은 supporting document와 negative document를 합친 12개 문서 collection이고, 모든 retrieval 방법의 final context는 30 passages로 맞췄다(§4.1). 질문마다 별도 graph를 구성한 작은 collection setting이다.
Table 1의 KGP-T5 F1은 HotpotQA 66.77, IIRC 41.54, 2WikiMQA 53.50, MuSiQue 41.19이며, PDFTriage를 제외한 평균 순위는 2.75로 가장 낮다. 하지만 IIRC에서는 MDR 43.47이 KGP-T5보다 높고, HotpotQA accuracy도 TF-IDF 76.64가 KGP-T5 76.53보다 0.11 point 높다. 정확한 요약은 여러 다중 홉 passage-QA 벤치마크에서 가장 좋은 평균 순위이지, 모든 데이터셋·측정값에서 일관되게 이겼다는 말이 아니다.
page/table structural retrieval은 내부 PDFTriage에서 별도로 평가됐다. KGP-T5의 Struct-EM은 67.00이지만 Table 1에는 경쟁 structural retrieval baseline이 없고, no-context·gold-context 참조 행만 있다. 그러므로 이 값은 구조 node 검색이 가능함을 보여 주는 절대 성능이지, passage-QA F1이나 2.75 평균 순위에 섞어 우위를 주장할 비교 결과는 아니다.
Traversal agent 비교(Table 2)에서 fine-tuned T5-Large는 HotpotQA 66.8, 2WikiMQA 53.5, MuSiQue 41.2 F1로 ChatGPT·LLaMA-7B보다 평균적으로 높다. 이 비교는 다음 supporting fact 생성에 맞춘 supervision이 이 설정에서 중요했음을 시사한다.
5. 확장성과 공정성의 경계
KGP는 corpus 전체의 한 번 만든 graph를 전역 질의하는 시스템으로 평가되지 않았다. 본문 실험 단위는 12문서, Figure 7(c)의 규모 실험도 최대 100문서다. passage 수가 커지면 candidate matching과 graph 구축 비용이 커지고, TAGME 같은 entity extractor의 domain·시간 비용도 고려해야 한다.
KGP-T5는 supporting-fact 순서로 fine-tuned된 navigator를 쓴다. graph 없는 동일 T5 sequential retriever와의 직접 절제가 주표에 없어, 성능 차이를 graph 구조 하나에만 돌릴 수 없다.
6. 정리
KGP는 LLM의 생성문을 답으로 믿지 않는다. 생성문을 “다음에 찾아야 할 근거”의 설명으로 제한하고 실제 문서 이웃에서 근거를 회수한다. 고정 context budget 안에서 다중 홉 근거를 순차적으로 모아야 하고 문서 구조도 검색해야 할 때 적합하다. 다만 저자 보고 성능은 질문별 12문서 collection, 30 passages, Wikipedia 중심 TAGME graph, fine-tuned navigation, 별도 downstream reader의 결합 결과다. 실제 대규모 문서 시스템에서는 edge construction 비용·domain transfer·graph recall을 별도로 측정해야 한다.
References
Wang, Y., Lipka, N., Rossi, R. A., Siu, A. F., Zhang, R., & Derr, T. (2024). Knowledge graph prompting for multi-document question answering. Proceedings of the AAAI Conference on Artificial Intelligence, 38(17), 19206–19214. https://doi.org/10.1609/aaai.v38i17.29889