From Local to Global: A Graph RAG Approach to Query-Focused Summarization
문서 전체를 묻는 질문에 답하는 사전 요약 인덱스: Microsoft GraphRAG
Microsoft GraphRAG는 문서 집합을 엔티티 그래프와 계층형 커뮤니티 보고서로 미리 요약한 뒤, 질의마다 부분 답변을 합쳐 전체 주제를 설명한다. 특정 사실 검색보다 corpus 전체의 흐름을 묻는 질문을 겨냥한다.
Paper: Darren Edge; Ha Trinh; Newman Cheng; Joshua Bradley; Alex Chao; Apurva Mody; Steven Truitt; Dasha Metropolitansky; Robert Osazuwa Ness; Jonathan Larson (2024). "From Local to Global: A Graph RAG Approach to Query-Focused Summarization." arXiv:2404.16130v2. PDF
1. 이 방법이 겨냥한 질문
일반 RAG는 “A 회사는 언제 설립됐나?”처럼 답이 몇 문단에 있는 질문에 잘 맞는다. 질문과 비슷한 청크를 몇 개 찾아 답변 모델에 주면 된다. 하지만 “이 인터뷰 모음에서 기술 규제에 대해 반복되는 쟁점은 무엇인가?”는 다르다. 어느 한 문단이 정답이 아니며, 문서 전체의 주제와 서로 다른 관점을 질문에 맞게 요약해야 한다.
이 논문은 이를 global sensemaking, 더 구체적으로는 query-focused summarization(QFS) 문제로 본다. Microsoft GraphRAG는 질의 때마다 원문 전체를 읽지 않는다. 대신 색인 시점에 문서를 지식 그래프와 여러 단계의 커뮤니티 보고서로 미리 압축하고 질의 때는 보고서를 읽는다. 이 논문에서 GraphRAG는 global search를 위한 사전 계산형 요약 경로를 가리킨다. 오늘날 넓은 의미의 모든 graph-based RAG와는 범위가 다르다.
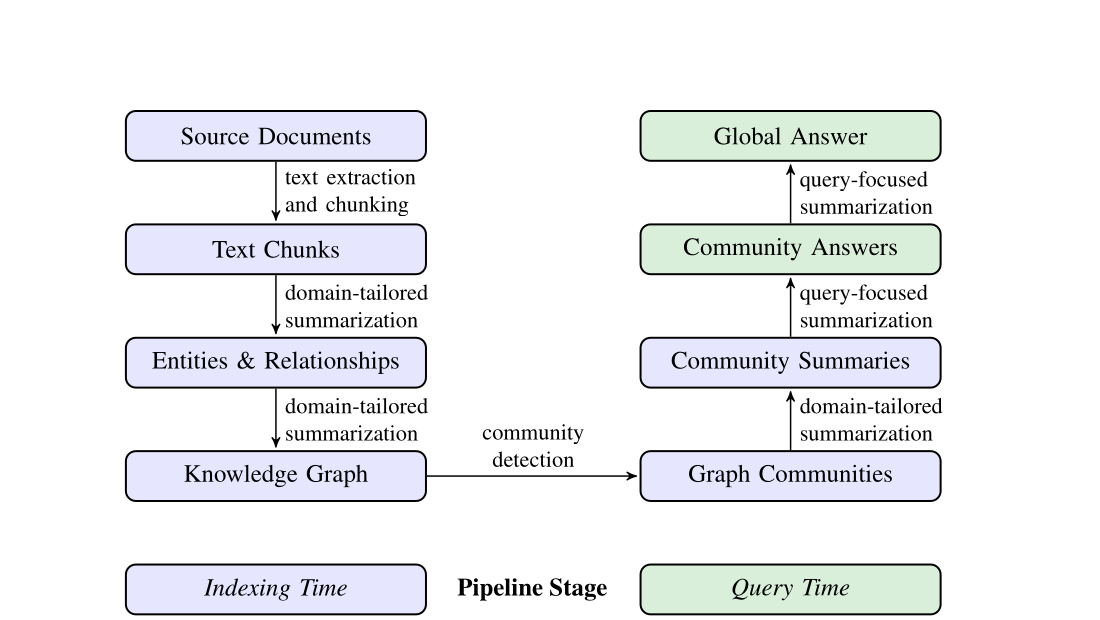
그림 1. Edge et al., Figure 1, arXiv:2404.16130v2 PDF p. 4의 원도판 크롭. 왼쪽 색인 단계에서 graph community와 보고서를 만들고, 오른쪽 질의 단계에서 community answer를 global answer로 합치는 흐름을 보라. 보고서 생성 비용과 원문에서 빠진 사실은 이 도식만으로 알 수 없다. CC BY 4.0.
2. 색인: 문장을 커뮤니티 보고서로 바꾼다
첫째, 문서를 청크로 나누고 LLM이 엔티티, 관계, claim을 뽑는다. 같은 이름의 요소를 합쳐 지식 그래프를 만든다. 둘째, 서로 촘촘히 연결된 노드 묶음을 Leiden community detection으로 찾는다. 이는 그래프를 작은 주제 구역으로 나누는 알고리즘이다. 셋째, leaf community부터 보고서를 쓰고 아래 보고서를 재료로 상위 community 보고서를 다시 쓴다.
계층 구조는 책의 장·절 목차와 비슷하다. 세부 인물과 사건은 하위 보고서에, 반복되는 큰 주제는 상위 보고서에 남는다. 다만 “요약이 있다”는 말은 원문을 잃지 않는다는 보장이 아니다. entity 표기가 달라 합쳐지지 않거나, 추출이 틀리거나, 하위 요약이 빠지면 그 오차는 상위 보고서까지 이어질 수 있다.
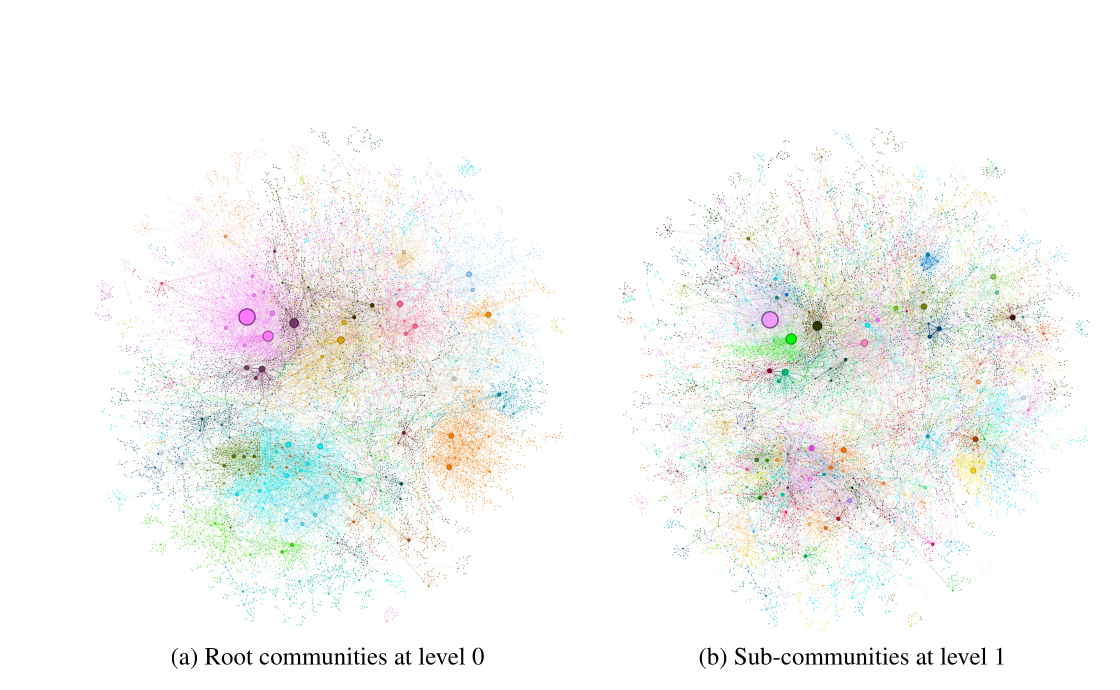
그림 2. Edge et al., Figure 4, arXiv:2404.16130v2 PDF p. 19의 원도판 크롭. MultiHop-RAG 그래프의 root와 level-1 Leiden community를 보라. 색은 community, 노드 크기는 degree다. 예시는 한 데이터셋의 분할이며 community 경계의 사실성이나 최적성을 증명하지 않는다. CC BY 4.0.
3. 질의: map-reduce로 전역 답을 만든다
질문이 들어오면 global search는 community report를 섞어 여러 batch로 나눈다. 각 batch에서 LLM은 질문에 대한 부분 답변과 helpfulness score를 만든다(map). 점수가 높은 부분 답변을 모아 다시 최종 답을 쓴다(reduce). 예를 들어 “공중보건 우선순위가 뉴스에서 어떻게 드러나는가?”라면, 예방·의료 접근성·정책 논쟁처럼 각 community가 낸 관점을 먼저 만들고 마지막에 하나의 답으로 통합한다.
이 방식은 특정 문장 인용을 찾는 local QA와 목적이 다르다. report가 충분히 대표적이면 넓은 관점을 얻지만, 구체적 날짜·예외 조항·인용문을 확인해야 하는 질문에는 원문 청크 검색과 출처 검증을 함께 둬야 한다. 질의 비용도 완전히 사라지지 않는다. 보고서를 미리 만드는 색인 비용을 앞당기고 질의에서는 보고서별 부분 답변과 최종 통합을 위한 LLM 호출을 수행한다.
4. 결과는 무엇을 측정했나
저자들은 약 100만 token의 Podcast transcript와 약 170만 token의 News article corpus에서 LLM이 만든 global 질문을 사용했다. 정답 문장이 없는 질문이므로 GPT-4 계열 판정자가 두 답변을 비교해 포괄성, 다양성, empowerment를 평가했다. GraphRAG 조건은 vector RAG보다 포괄성과 다양성에서 높은 선호 점수를 보였다. 논문의 Figure 2는 125개 질문을 질문당 다섯 번 비교해 평균한 행렬이다.
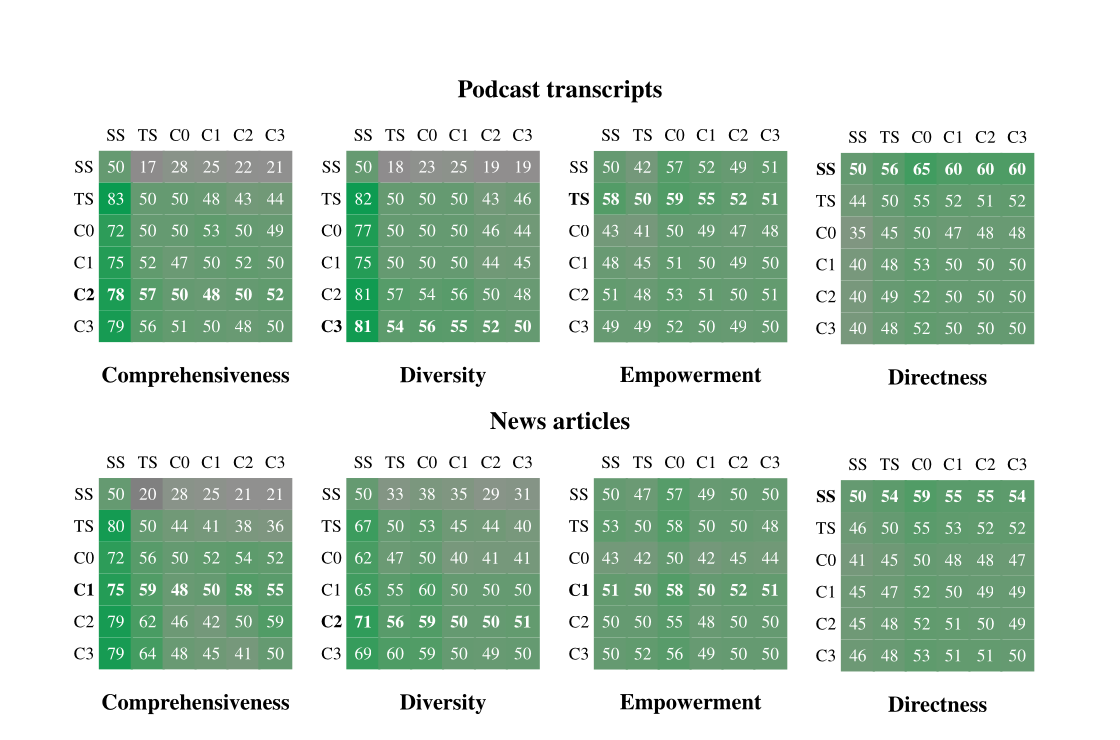
그림 3. Edge et al., Figure 2, arXiv:2404.16130v2 PDF p. 10의 원도판 크롭. 행 조건이 열 조건을 이긴 정도를 읽는 pairwise matrix다. 포괄성·다양성뿐 아니라 empowerment·directness도 함께 봐야 한다. LLM judge의 선호도이므로 검색 recall, 사실 정확도, 사람 사용성의 직접 측정값은 아니다. CC BY 4.0.
논문은 claim 기반 보조 지표도 사용했지만, LLM 판정과 완전히 같은 결론을 내지 않았다. non-tie 비교에서 포괄성은 78%, 다양성은 69–70% 정도만 일치했다. 또한 저자 스스로 두 corpus에 한정됐고 fabrication rate 비교가 추가되면 분석이 강해질 것이라고 적었다. 따라서 “더 다양하고 포괄적인 답”을 “더 사실적인 답”으로 바꾸어 말하면 안 된다.
5. 언제 유용한가
GraphRAG global search는 기업 보고서, 회의록, 연구 노트처럼 “전체 자료에서 반복되는 테마·관계·갈등은 무엇인가?”를 묻는 코퍼스에 맞는다. 수시로 바뀌는 문서라면 커뮤니티 재구성과 보고서 재생성의 쓰기 비용을 먼저 계산해야 한다. 질문이 사실 확인 중심이라면 원문 청크 기반 local retrieval과 문장별 출처가 더 중요한 안전장치가 된다.
선택 기준: 반복되는 전역 질문인가
Microsoft GraphRAG를 고를 핵심 조건은 한 문서의 사실 검색보다 코퍼스 전체의 주제를 반복해서 묻는가다. 원문은 약 100만 토큰 규모의 두 코퍼스에서 global sensemaking 질문을 평가했고, 사전 생성한 커뮤니티 요약을 여러 전역 질의에 재사용하는 상황을 비용 논의의 전제로 삼았다(원문 §6.1 및 결론). 따라서 자주 바뀌는 코퍼스의 단발성 사실 조회라면 요약 인덱스 구축비를 먼저 따져야 하고, 안정된 코퍼스에 넓은 질문이 반복될 때 이 설계의 장점이 가장 분명하다.
6. 정리
Microsoft GraphRAG의 새로움은 그래프를 만들었다는 데만 있지 않다. 그래프의 모듈성을 이용해 질의 이전에 계층 요약을 만들고 질의 때 map-reduce로 전체 코퍼스의 질문에 답하는 방식을 묶었다. 저자 결과는 global QFS에서 답변의 폭을 넓힐 가능성을 보여준다. 그 결과는 약 100만·170만 token의 두 corpus, LLM 생성 질문, LLM judge라는 조건에 묶여 있으며, 사실 정확도와 총비용을 증명하는 결과로 읽어서는 안 된다.
References
Edge, D., Trinh, H., Cheng, N., Bradley, J., Chao, A., Mody, A., Truitt, S., Metropolitansky, D., Ness, R. O., & Larson, J. (2024). From local to global: A Graph RAG approach to query-focused summarization (arXiv:2404.16130v2). arXiv. https://doi.org/10.48550/arXiv.2404.16130