HippoRAG: Neurobiologically Inspired Long-Term Memory for Large Language Models
문서 사이의 단서를 한 번에 잇는 검색: HippoRAG
HippoRAG는 문서에서 뽑은 개방형 지식 그래프에 Personalized PageRank를 적용해 다중 홉 근거를 찾는다. 2WikiMultiHopQA의 큰 검색 이득은 entity 중심 과제·추출 품질·색인 비용이라는 조건과 함께 읽어야 한다.
Paper: Bernal Jiménez Gutiérrez; Yiheng Shu; Yu Gu; Michihiro Yasunaga; Yu Su (2024). "HippoRAG: Neurobiologically Inspired Long-Term Memory for Large Language Models." Advances in Neural Information Processing Systems, 37. arXiv:2405.14831. PDF
1. 문제: 답은 한 문서에 없을 수 있다
보통 RAG는 질문과 가장 비슷한 문단을 먼저 고른다. 한 문단에 답이 있으면 충분하지만, 두 문서의 사실을 함께 찾아야 할 때는 약하다. 예를 들어 어떤 인물이 어느 대학 교수라는 문단과 특정 질환을 연구한다는 문단이 따로 있다면, 질문의 답은 두 단서를 연결해야 나온다.
HippoRAG의 제안은 검색 전에 말뭉치 전체의 연결을 만들어 두는 것이다. 개방형 지식 그래프란 고정된 사전의 항목만 쓰지 않고, 문장에서 뽑은 개체와 관계를 노드와 연결로 저장한 그래프다. 질문을 받으면 답을 즉시 생성하지 않고, 질문 속 개체에서 연결을 따라 관련 문단을 다시 순위화한다. 논문 제목의 ‘장기 기억’은 사람 기억의 구현을 증명한다는 뜻보다, 새 문서를 파라미터 재학습 없이 색인해 두고 나중에 연상 검색한다는 비유로 읽는 편이 정확하다.
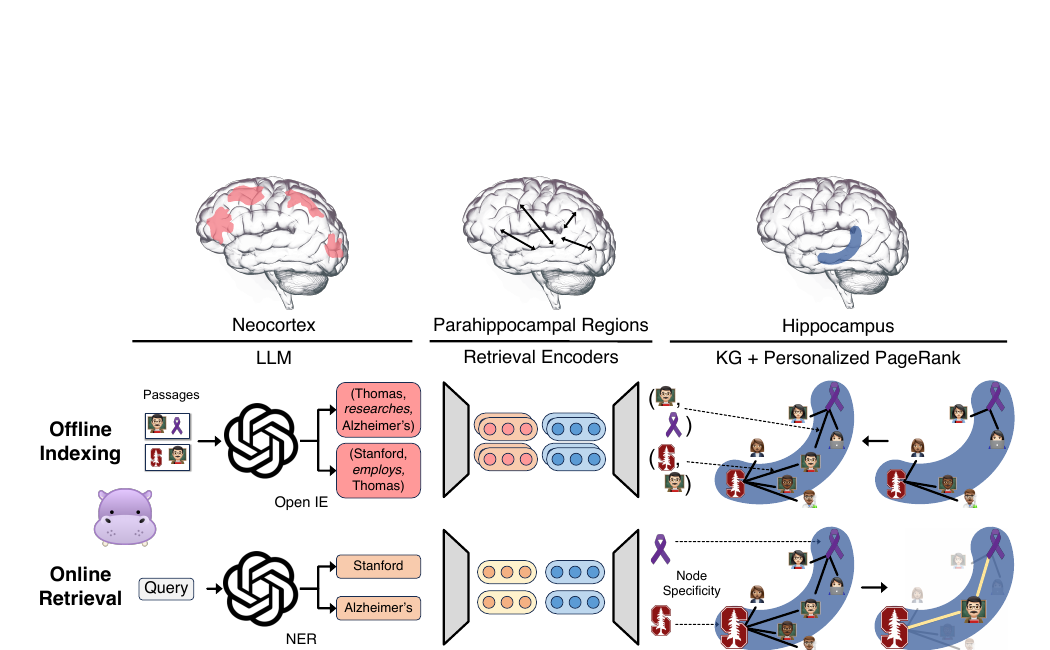
그림 1. NeurIPS 2024 원논문 PDF p. 4의 Figure 2를 인용한 공개 자산이다. 위는 문단에서 OpenIE 관계를 뽑아 그래프를 만드는 오프라인 단계, 아래는 질문의 개체를 찾아 그래프 순위를 계산하는 온라인 단계다. 뇌 부위 그림은 설계 비유이며 생물학적 기억의 검증 결과가 아니다.
2. 방법: 개체를 닻으로 삼아 문단을 되찾는다
색인 단계에서 LLM 기반 OpenIE가 문단을 ‘개체–관계–개체’ 형태로 읽는다. 같은 인물이나 지명이 다른 문단에 나타나면 그래프에서 만나게 된다. 표현이 조금 다른 같은 개체를 연결하고 질문의 개체를 그래프 노드에 붙일 때는 dense retrieval encoder도 쓴다. HippoRAG는 벡터 검색을 유지하되, 벡터를 최종 문단 순위기보다 개체 연결 장치에 가깝게 쓴다.
검색 단계의 Personalized PageRank(PPR)는 질문과 직접 닿은 노드에서 높은 점수를 시작해, 연결을 따라 점수를 퍼뜨린다. 유명해서 어디에나 붙은 노드가 결과를 독점하지 않도록 노드의 특수성도 탐색 출발점의 점수에 반영한다. 마지막에는 노드 점수를 원문 문단으로 돌려준다. 이 순위를 따라 고른 근거 문단을 답변 모델에 넘길 수 있다.
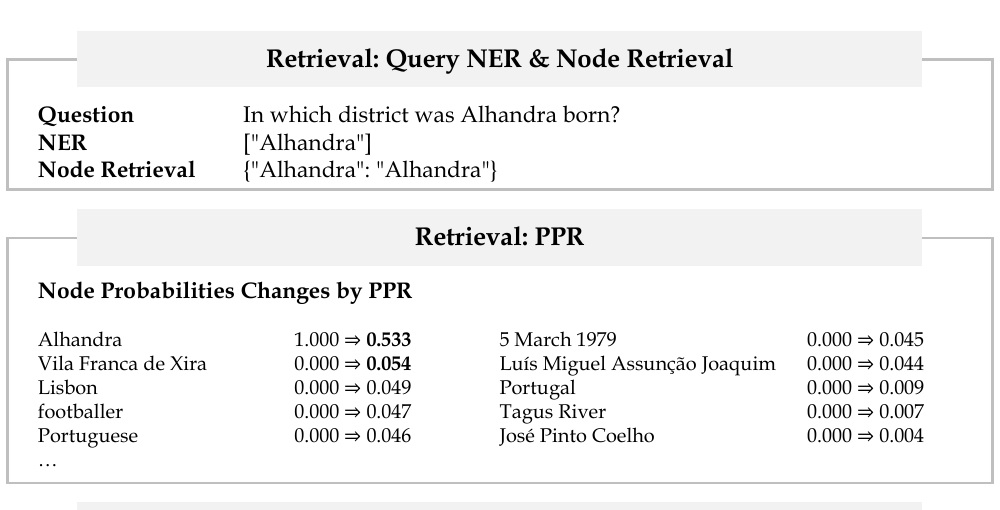
그림 2. NeurIPS 2024 원논문 PDF p. 22의 Figure 5를 인용한 공개 자산이다. Alhandra에서 시작한 점수가 Vila Franca de Xira와 Lisbon 같은 연결 노드로 퍼지는 예를 보인다. 표의 숫자는 이 사례의 노드 확률 변화이며 모든 질문의 정확도 지표가 아니다.
3. 근거: 다중 홉 retrieval에서의 조건부 이득
저자들은 multi-hop QA에서 단일 검색 단계의 Recall@5와 supporting passage를 함께 찾는 비율을 비교했다. 2WikiMultiHopQA에서 HippoRAG의 R@5는 89.1, ColBERTv2는 68.2로 보고되어 20.9 percentage points 차이가 난다. 여러 근거를 한꺼번에 찾는 AR@5의 차이도 38.6 points로 보고된다. 이는 entity를 매개로 문서 경계를 넘는 구조가 이 과제의 근거 묶음과 잘 맞았다는 증거다.
하지만 모든 데이터셋에서 같은 순서는 아니다. HotpotQA의 R@5에서 HippoRAG는 77.7, ColBERTv2는 79.3이었다. 따라서 ‘그래프를 쓰면 dense retrieval보다 낫다’는 일반 법칙으로 바꾸면 안 된다. 이름·장소처럼 개체 고리가 선명한 2Wiki와, 문단 문맥 및 질문 형식이 다른 HotpotQA의 차이가 결과 해석의 조건이다.
4. 비용과 오류: 온라인 이득에는 오프라인 대가가 있다
논문은 1,000개 질의 기준으로 HippoRAG의 온라인 검색을 약 USD 0.1, 약 3분으로 보고하고 비교한 IRCoT는 USD 1–3, 20–40분으로 제시한다. 반복 질의마다 LLM으로 다음 검색을 만들지 않는 구조이므로, 이미 색인된 corpus에 많은 질문을 할 때 이 장점은 이해하기 쉽다. NeurIPS 초록도 단일 단계 검색이 iterative retrieval보다 10–20배 저렴하고 6–13배 빠르다고 요약한다.
반대편에는 그래프 제작 비용이 있다. 부록의 10,000 passage 예에서 OpenIE 색인은 약 USD 15와 약 60분으로 보고된다. 오류 분석 100건에서는 NER 48%, OpenIE 28%, PPR 24%가 원인으로 분류됐다. 즉 검색 단계만 개선해도 상류 추출이 인물 이름을 놓치거나 관계를 잘못 쓰면 연결 자체가 틀어진다. 대규모 open-world corpus에서의 확장성도 최대 11,656 passages 수준의 본 평가만으로 확정할 수 없다.
5. 언제 써 볼 만한가
같은 개체가 여러 원문을 연결하고, 질문이 ‘A이면서 B인 것은?’처럼 근거 조합을 요구하며, 문서 묶음이 자주 완전히 교체되지 않는다면 HippoRAG의 색인 비용을 지불할 이유가 있다. 적용 전에는 개체 추출이 도메인 용어를 얼마나 보존하는지, 고빈도 노드가 결과를 흐리지 않는지, 원문 passage가 충분히 남는지부터 점검해야 한다.
반대로 표·수식·긴 담화 맥락이 답의 핵심이거나 문서가 매우 자주 바뀌면 entity 중심 그래프가 중요한 정보를 버릴 수 있다. 이 논문은 그래프 기반 비파라미터 연상 검색의 강한 사례를 보여 줬다. 기억 관리·삭제·시간에 따른 사실 충돌·개인 정보 접근 제어까지 해결한 장기 기억 시스템은 제시하지 않았다.
더 긴 비교·절제·오류 분석은 심층 보기에서 확인할 수 있다.
References
Gutiérrez, B. J., Shu, Y., Gu, Y., Yasunaga, M., & Su, Y. (2024). HippoRAG: Neurobiologically inspired long-term memory for large language models. Advances in Neural Information Processing Systems, 37. https://proceedings.neurips.cc/paper_files/paper/2024/hash/6ddc001d07ca4f319af96a3024f6dbd1-Abstract-Conference.html
Gutiérrez, B. J., Shu, Y., Gu, Y., Yasunaga, M., & Su, Y. (2025). HippoRAG: Neurobiologically inspired long-term memory for large language models (arXiv:2405.14831v3). arXiv. https://arxiv.org/abs/2405.14831