CausalRAG: Integrating Causal Graphs into Retrieval-Augmented Generation
인과를 찾는 검색인가, 인과적으로 읽히는 문맥 정리인가: CausalRAG
CausalRAG는 질문 근처의 텍스트 그래프를 넓힌 뒤 LLM이 인과 경로를 골라 요약하는 RAG다. OpenAlex 자동평가의 높은 점수는 유망하지만 정식 인과 식별·사람 평가·비용 비교의 근거와는 구분해야 한다.
Paper: Nengbo Wang; Xiaotian Han; Jagdip Singh; Jing Ma; Vipin Chaudhary (2025). "CausalRAG: Integrating Causal Graphs into Retrieval-Augmented Generation." Findings of the Association for Computational Linguistics: ACL 2025, 22680–22693. arXiv:2503.19878. PDF · https://doi.org/10.18653/v1/2025.findings-acl.1165
1. 질문: 관련 문장과 설명 경로는 다르다
‘수면 부족이 심장에 어떤 영향을 주는가’라는 질문에는 sleep과 heart가 함께 있는 문장만으로 부족할 수 있다. 수면 부족, 호르몬 변화, 혈압 또는 염증, 혈관 손상처럼 질문에 필요한 설명 경로가 흩어져 있기 때문이다. CausalRAG는 이런 경우에 단순 의미 유사도 순위 대신 관계 그래프를 넓히고, 그 안에서 질문에 맞는 인과 경로를 골라 문맥을 만들겠다고 제안한다.
먼저 ‘인과’의 뜻을 좁혀야 한다. 구조적 인과모형은 어떤 변수가 다른 변수를 바꾸는지, 교란변수는 무엇인지, 개입했을 때 무엇이 달라지는지를 명시한다. CausalRAG가 만드는 것은 문서에서 LLM이 추출한 엔티티–관계 그래프다. 모든 간선이 검증된 원인–결과라는 보장은 없고, 논문은 개입 효과나 정답 인과 그래프에 대한 평가도 제시하지 않는다. 따라서 이 방법은 LLM이 인과적으로 보이는 경로를 선별하는 retrieval로 이해하는 편이 정확하다.
2. 방법: 의미 검색에서 출발해 그래프와 LLM을 잇는다
색인 때 문서를 그래프로 만들고 노드와 텍스트를 임베딩해 FAISS에 저장한다. 질문이 오면 먼저 의미가 가까운 노드 k개를 시작점으로 고른다. 그 주변을 s단계까지 확장한 뒤, LLM에게 주요 인과 경로·근거 강도·요약을 쓰게 한다. 기본 설정은 k=3, s=3이다. 즉 첫 관문은 여전히 dense similarity이고, 그래프 탐색은 후보 문맥을 넓히며, 마지막 LLM이 ‘이 질문의 인과적 관련성’을 판별한다.
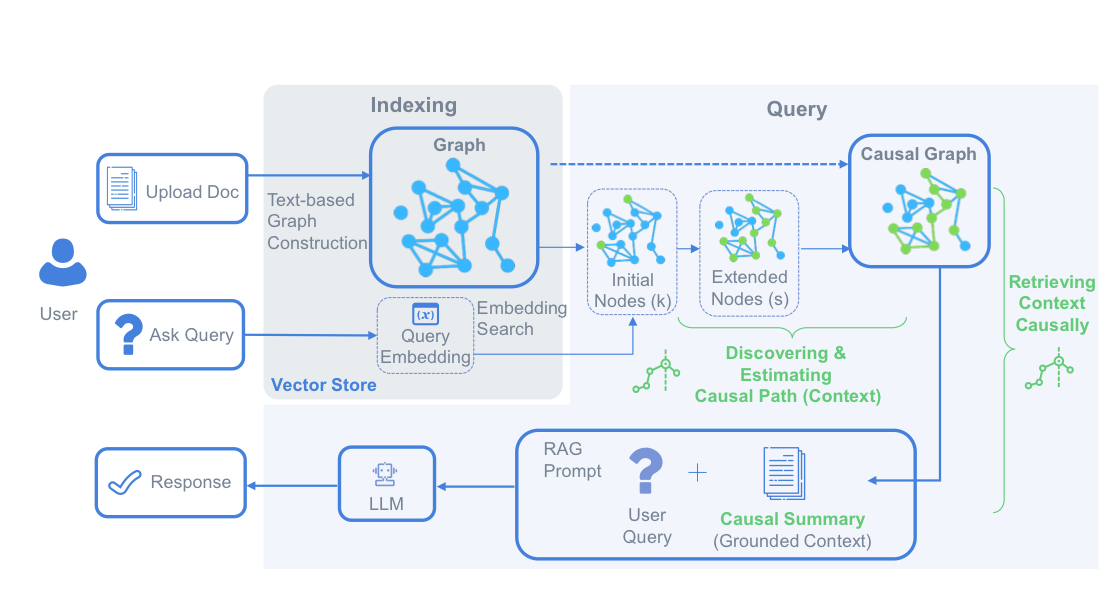
그림 1. Findings of ACL 2025 원논문 PDF p. 22684의 Figure 2를 인용한 공개 자산이다. 문서 업로드→텍스트 그래프→query embedding→초기 노드와 확장 노드→causal summary→RAG prompt의 순서를 보여 준다. 녹색 노드가 인과적으로 타당한 현실 세계의 원인을 표시한다는 의미는 아니다.
구체적인 예로, ‘영업 전술이 계약 수주에 어떻게 영향을 주는가’라는 질문에서 Influence Tactics → Buyer Attention → Contract Award처럼 중간 기제를 가진 경로가 남을 수 있다. 일반 RAG가 주변의 관련 문장을 많이 섞는다면, 이 구조는 더 짧고 설명적인 문맥을 주려는 선택이다. 반대로 상관관계·시간적 선행·인과가 혼재한 문서에서는 LLM의 경로 설명이 그럴듯해도 실제 인과가 아닐 수 있다.
3. 결과: 높은 세 자동평가 점수의 의미
OpenAlex에서 표집한 학술 문서로 만든 평가에서 CausalRAG는 answer faithfulness 78.00, context recall 49.46, context precision 92.86을 보고했다. 같은 그림의 HippoRAG2는 67.36, 47.22, 73.72다. 특히 precision 차이 19.14 points는 그래프의 모든 주변 정보를 넘기기보다 경로를 선별하는 설계가 저자 설정에서 효과적이었다는 근거다.
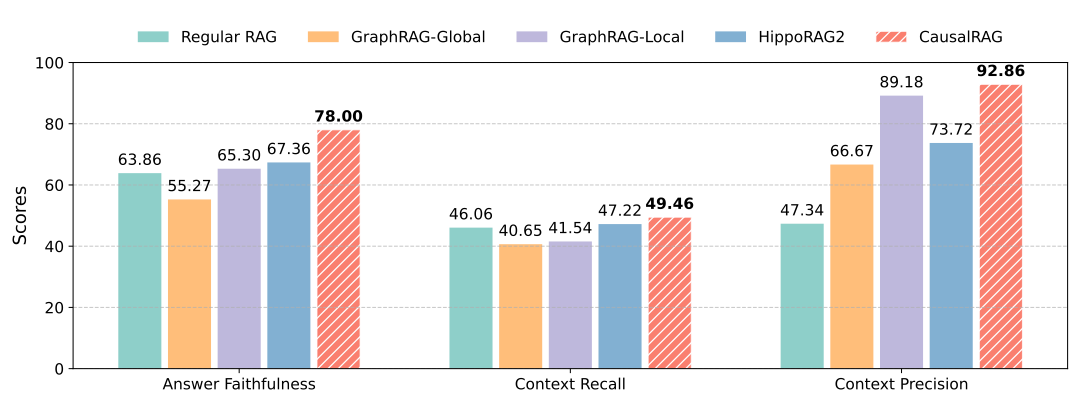
그림 2. Findings of ACL 2025 원논문 PDF p. 22686의 Figure 3을 인용한 공개 자산이다. Regular RAG, GraphRAG-Global·Local, HippoRAG2, CausalRAG의 세 점수를 같은 축에 놓는다. 막대는 사람의 인과 판단이나 실제 환각률이 아니라 Ragas 자동평가 결과다.
다만 세 수치는 서로 다른 대상을 잰다. faithfulness는 답이 제공 문맥과 맞는지, recall은 필요한 문맥을 얼마나 찾는지, precision은 찾은 문맥 중 질문에 관련된 것이 얼마나 되는지를 본다. 논문은 문서 수와 전체 질문 수, 신뢰구간과 반복 실행을 보고하지 않는다. 질문도 문서당 다섯 개를 LLM으로 만들고 답이 본문에 존재하도록 제한했다. 그러므로 이 그림은 공개형 사람 질문에서의 인과 추론 정확도나 일반적 환각 감소를 직접 증명하지 않는다.
4. 그래프 깊이와 비용의 빈칸
시작 노드 수와 확장 깊이를 키우면 더 많은 경로를 볼 수 있지만 LLM에 넣을 하위 그래프도 커진다. Figure 6에서 종합 점수는 k=s=1의 0.534에서 기본값 k=s=3의 0.759로 높아진다. 그림의 최댓값은 k=5, s=3에서 0.842로 읽히지만, 본문은 k=s=5가 최선이라고 서술해 서로 맞지 않는다. 여기서는 그림의 표시값을 우선하며 이 불일치를 남긴다.
비용 비교도 빠져 있다. 색인 그래프 품질, 질의 시 LLM 두 단계, 확장한 그래프 크기, 토큰·지연시간을 구성요소별로 비교한 표가 없다. 따라서 이 논문은 “정확도와 비용을 동시에 개선한 시스템”의 증거보다, 경로 선별이 자동 retrieval 지표에서 유망했다는 초기 증거다.
5. 적용 조건과 읽는 법
설명형 질문이 많고 각 경로가 원문 인용으로 다시 검토될 수 있는 연구 노트나 기술 문서에서는 CausalRAG의 후보 축소가 유용할 수 있다. 도입할 때는 간선마다 원문 근거와 ‘관찰된 연관’인지 ‘저자가 주장한 기제’인지의 표지를 남기고, 반대 방향·교란 후보를 함께 제시하는 것이 좋다. 정답 인과 그래프 또는 전문가 검토, 사람 질문으로 평가도 따로 필요하다.
의학·법률·정책처럼 틀린 인과 주장의 비용이 큰 영역에서는 이 논문의 결과만으로 자동 인과 결론을 내리면 안 된다. CausalRAG는 검색 문맥을 더 정돈할 수 있는 방법이지, 관찰 텍스트만으로 원인 효과를 식별하는 도구가 아니다.
더 긴 사례·지표 정의·매개변수 분석은 심층 보기에서 확인할 수 있다.
References
Wang, N., Han, X., Singh, J., Ma, J., & Chaudhary, V. (2025). CausalRAG: Integrating causal graphs into retrieval-augmented generation. Findings of the Association for Computational Linguistics: ACL 2025, 22680–22693. https://doi.org/10.18653/v1/2025.findings-acl.1165