Paper Review11편 · 약 55분

GraphRAG 논문 리뷰 시리즈

LLM 검색증강생성에 그래프를 결합하는 GraphRAG 계열의 핵심 논문 11편을 기초 연구부터 최초 공개 순서로 읽습니다.

여기서 시작하세요 · 6분

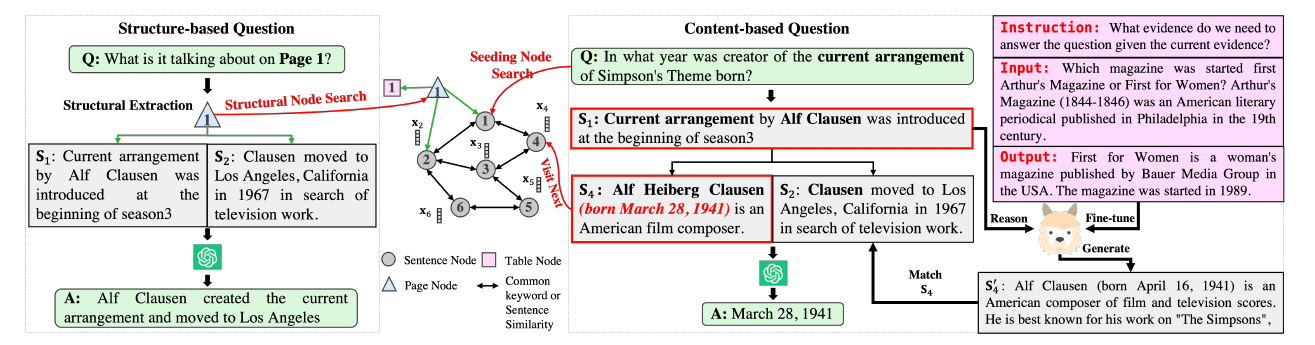
Knowledge Graph Prompting for Multi-Document Question Answering

KGP는 문서 passage·page·table을 graph로 연결하고, LLM이 다음 근거의 설명을 생성해 이웃 node를 고른다.

첫 글 읽기
추천 읽기 순서

1–3 · 문서 탐색에서 전역 요약과 기억으로

3편 · 16분

KGP → MS GraphRAG → HippoRAG 순서로 문서 간 연결을 탐색하고, 커뮤니티 보고서로 전체를 요약하며, 그래프를 연상 기억으로 쓰는 관점을 구분합니다. 커뮤니티는 연결이 조밀한 엔티티 묶음이고, map-reduce는 부분 답변을 만든 뒤 하나로 합치는 처리입니다.

  1. Knowledge Graph Prompting for Multi-Document Question Answering

    KGP는 문서 passage·page·table을 graph로 연결하고, LLM이 다음 근거의 설명을 생성해 이웃 node를 고른다.

    6분
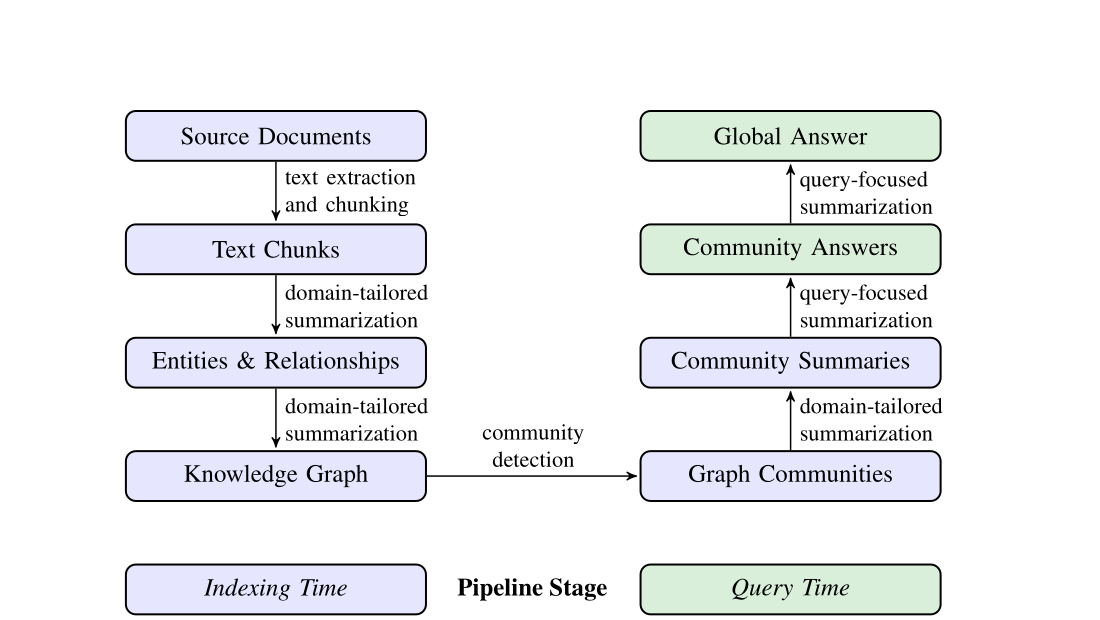
  2. From Local to Global: A Graph RAG Approach to Query-Focused Summarization

    Microsoft GraphRAG는 문서 집합을 엔티티 그래프와 계층형 커뮤니티 보고서로 미리 요약한 뒤, 질의마다 부분 답변을 합쳐 전체 주제를 설명한다.

    5분
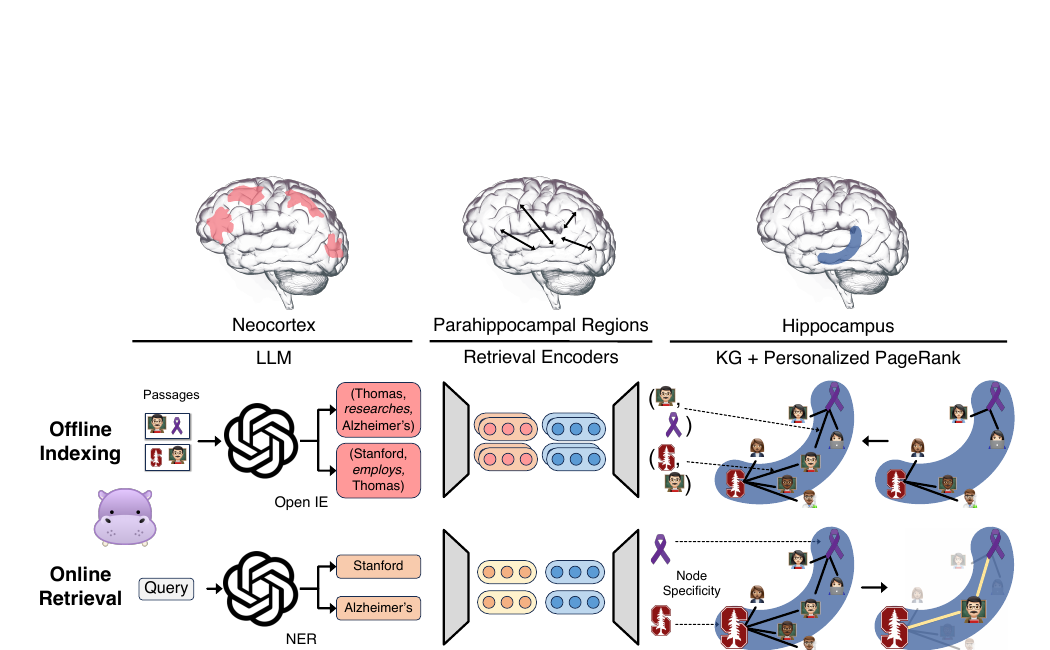
  3. HippoRAG: Neurobiologically Inspired Long-Term Memory for Large Language Models

    HippoRAG는 문서에서 뽑은 개방형 지식 그래프에 Personalized PageRank를 적용해 다중 홉 근거를 찾는다.

    5분
4–6 · 검색 단위와 기억·경로의 차이

3편 · 16분

LightRAG → HippoRAG 2 → CausalRAG로 엔티티·관계 이중 검색, 장기 기억, 인과 경로 검색을 읽습니다. 무엇을 색인하고 어떤 연결을 검색하는지 먼저 비교합니다.

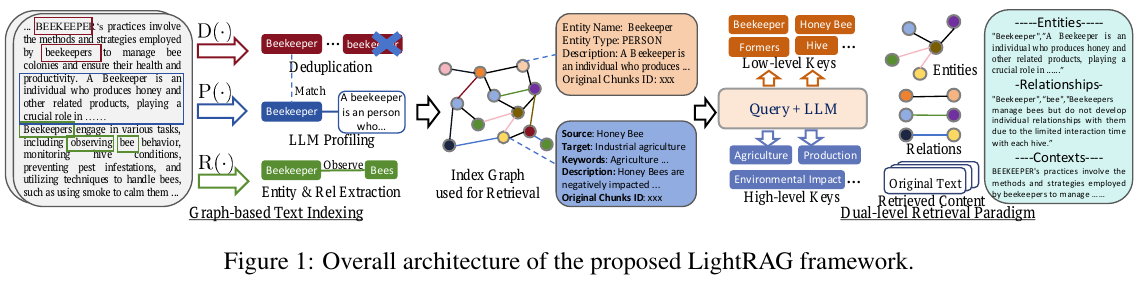
  1. LightRAG: Simple and Fast Retrieval-Augmented Generation

    LightRAG는 문서를 엔티티·관계 그래프로 색인한 뒤, 질문의 구체 단서는 엔티티에서, 넓은 주제는 관계에서 찾는다.

    5분
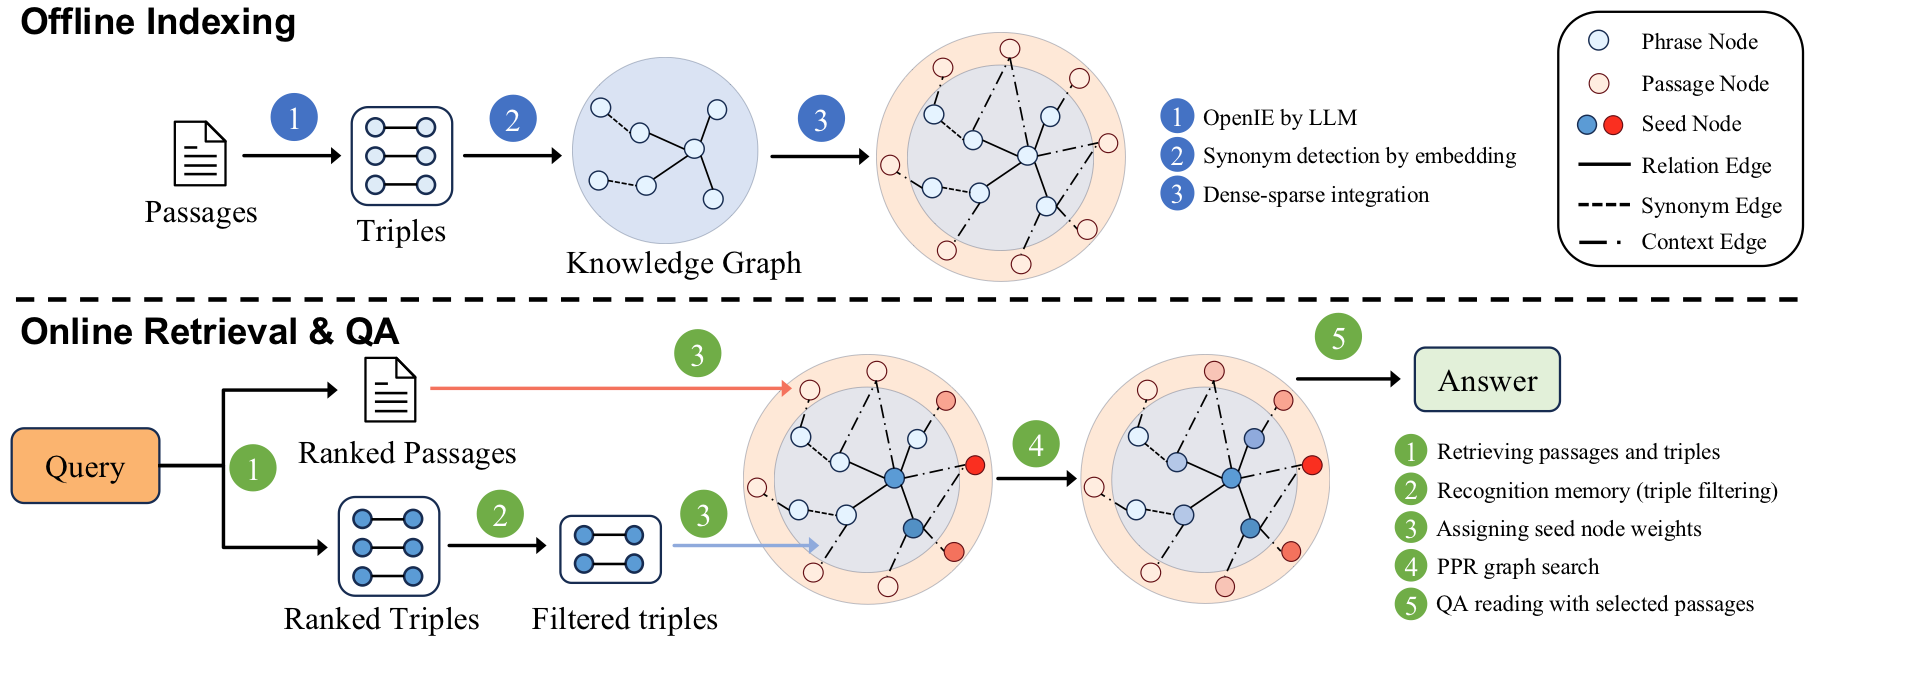
  2. From RAG to Memory: Non-Parametric Continual Learning for Large Language Models

    HippoRAG 2는 원문 passage와 개념 그래프를 한 검색 공간에 넣고 질문마다 관련 관계를 다시 골라 PPR로 근거를 찾는다.

    6분
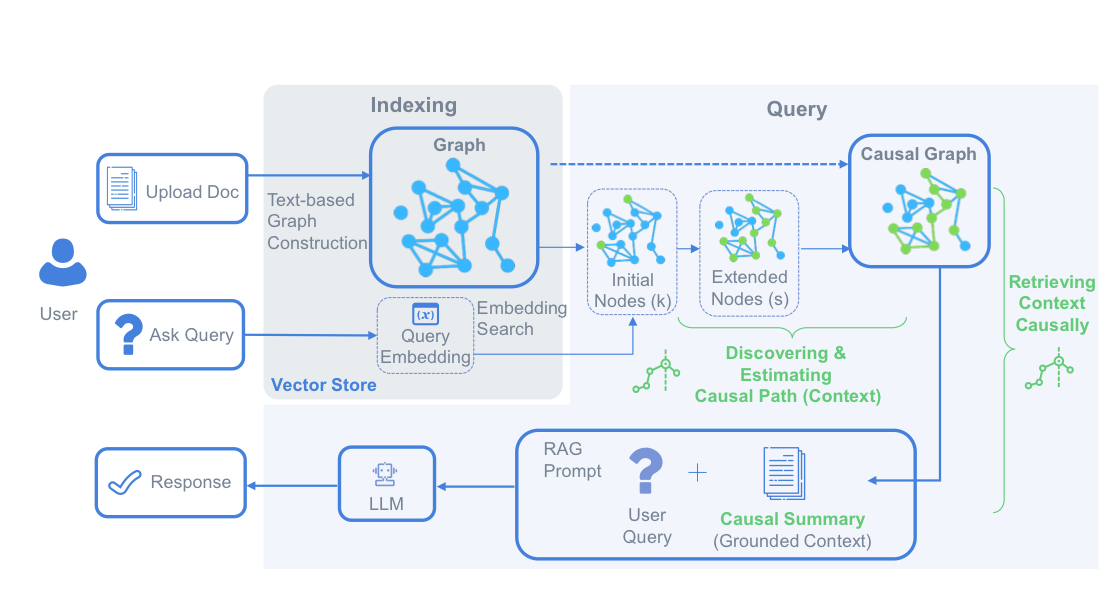
  3. CausalRAG: Integrating Causal Graphs into Retrieval-Augmented Generation

    CausalRAG는 질문 근처의 텍스트 그래프를 넓힌 뒤 LLM이 인과 경로를 골라 요약하는 RAG다.

    5분
7–9 · 집약·선형화·계층 검색

3편 · 14분

LeanRAG → LinearRAG → Deep GraphRAG로 그래프를 집약하거나 단순화하고, 계층을 따라 검색하는 설계를 살펴봅니다. 검색 결과를 통합하는 단계와 최종 답변을 생성하는 단계를 분리해 읽습니다.

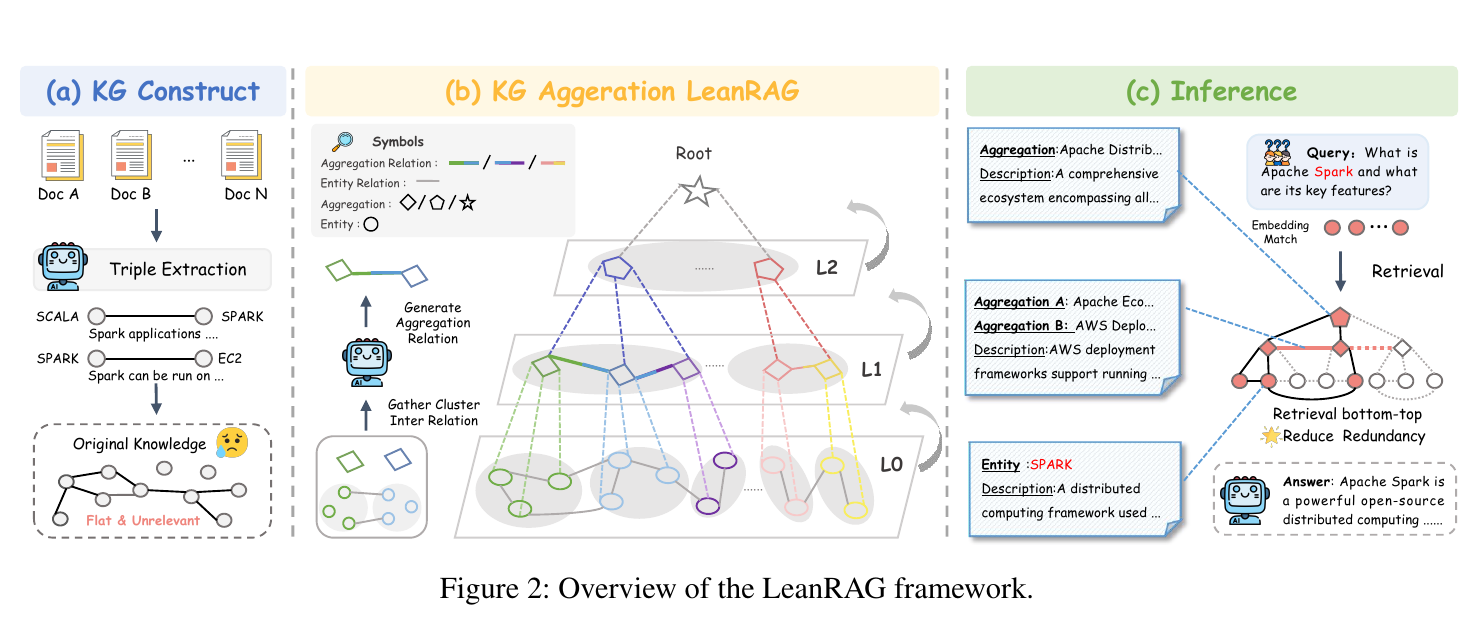
  1. LeanRAG: Knowledge-Graph-Based Generation with Semantic Aggregation and Hierarchical Retrieval

    LeanRAG는 비슷한 엔티티를 상위 개념으로 집약하고 집약 개념 사이 관계까지 만들어 질문의 세부 근거에서 공통 상위 구조로 올라간다.

    5분
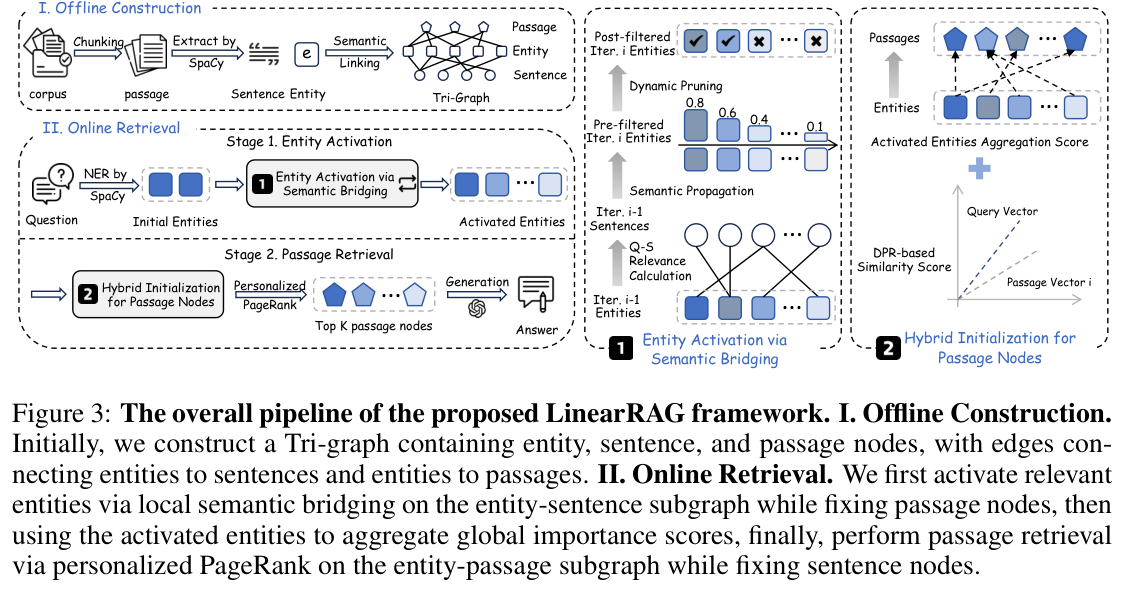
  2. LinearRAG: Linear Graph Retrieval Augmented Generation on Large-scale Corpora

    LinearRAG는 엔티티·문장·문단만 잇는 Tri-Graph로 관계 추출을 없애고, 의미 브리징과 PageRank로 문단을 찾는다.

    5분
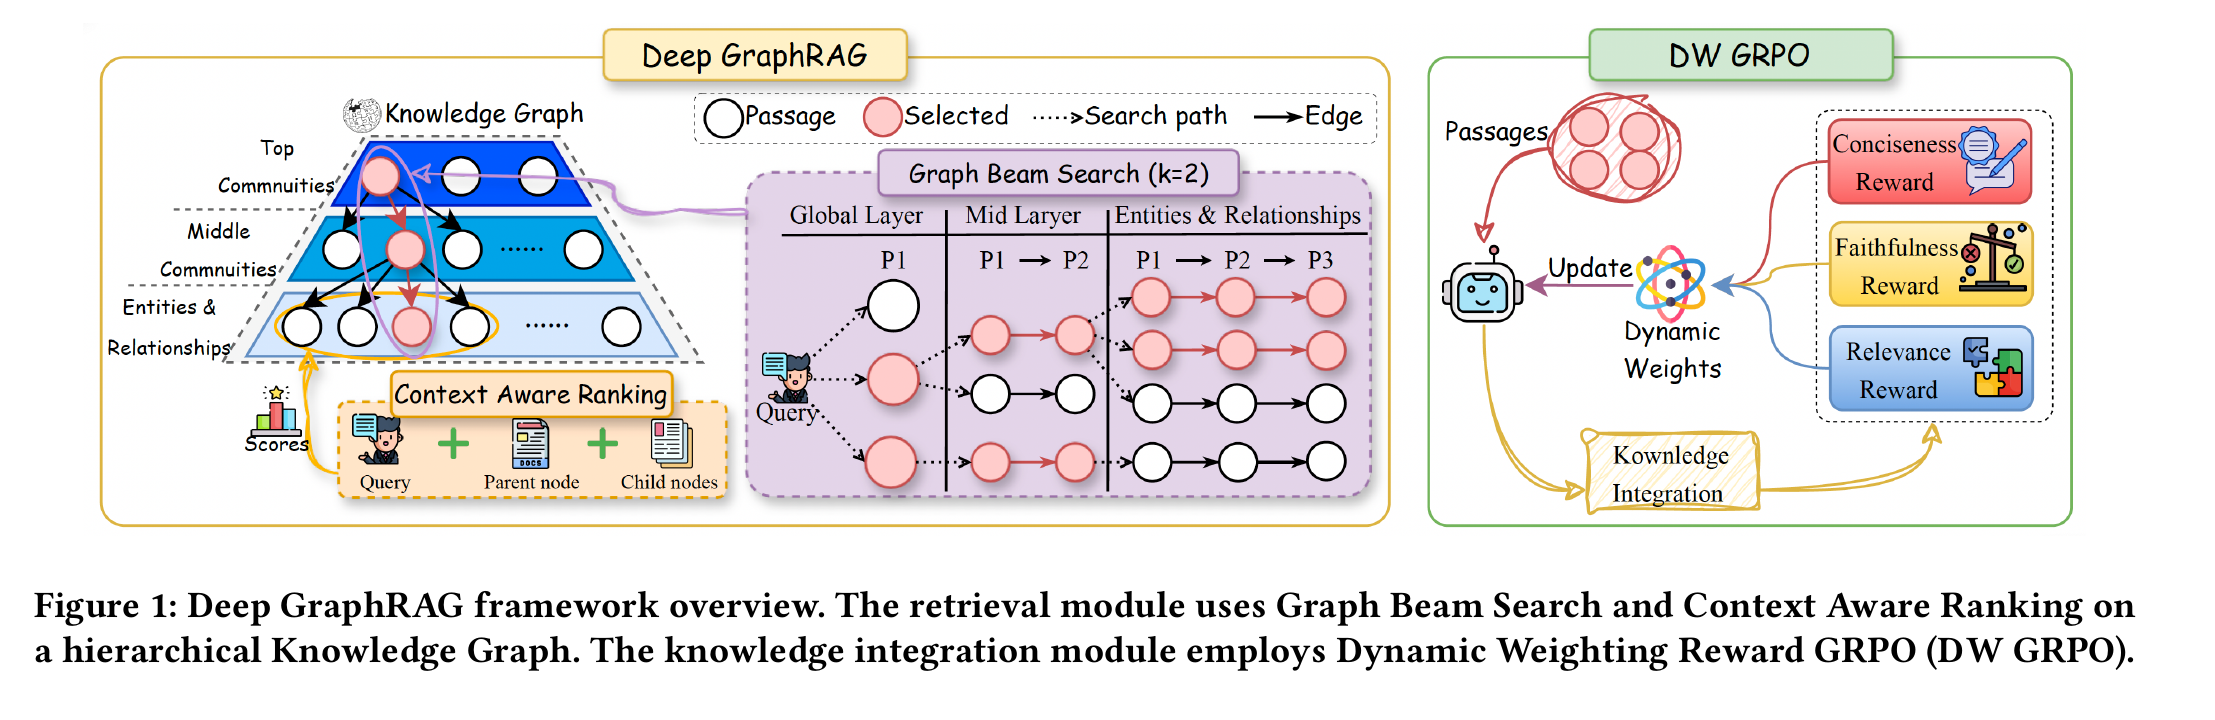
  3. Deep GraphRAG: A Balanced Approach to Hierarchical Retrieval and Adaptive Integration

    Deep GraphRAG는 커뮤니티 계층을 global에서 local로 내려오며 탐색하고, 작은 지식 통합 모델을 보상 재가중으로 학습한다.

    4분
10–11 · 게이트와 전체 파이프라인 점검

2편 · 9분

CausalRAG2 → RAGU로 계층형 인과 게이트와 다단계 파이프라인을 읽고 추출·색인·검색·생성의 비용과 오류 경로를 돌아봅니다. LLM 판정과 정답 문자열 일치(Exact Match)는 같은 평가 지표가 아닙니다.

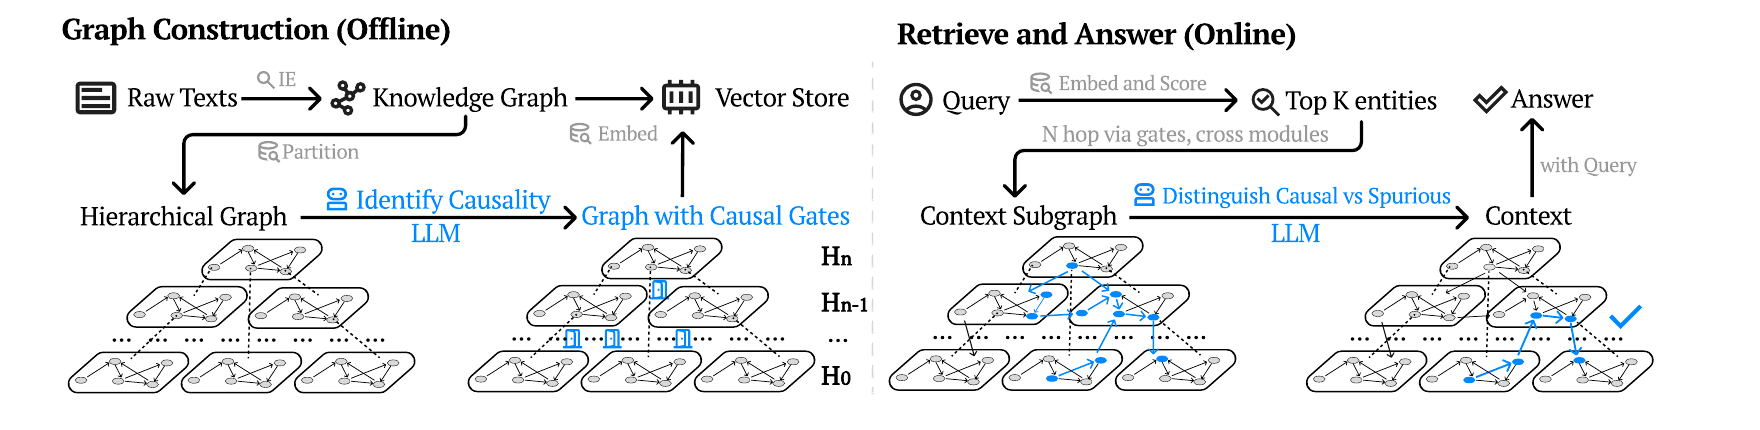
  1. CausalRAG2: Hierarchical Causal Knowledge Graph Design for RAG

    CausalRAG2는 계층형 지식 그래프의 멀어진 모듈을 LLM 기반 causal gate로 잇고, 질의 뒤에는 관련 경로만 다시 고르는 RAG다.

    5분
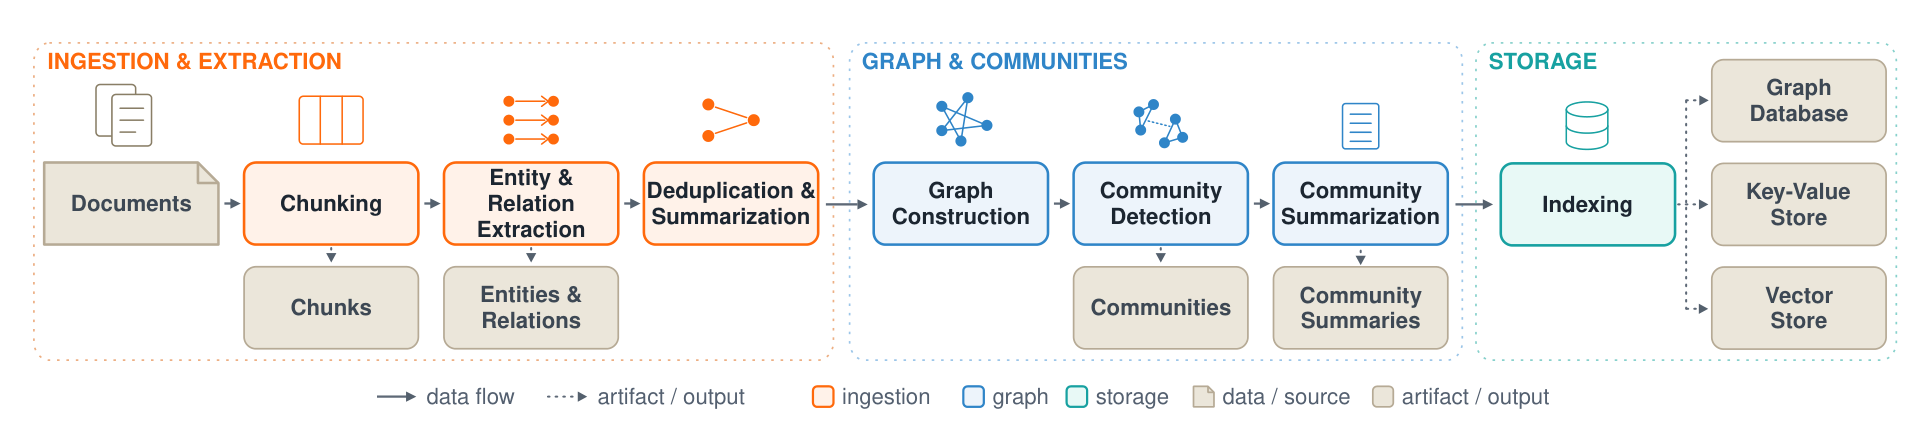
  2. RAGU: A Multi-Step GraphRAG Engine with a Compact Domain-Adapted LLM

    RAGU는 엔티티·관계 추출과 중복 통합을 나누고, 7B Meno-Lite로 그래프를 만든다.

    4분

논문 선택 비교

11편 가운데 전역 요약, 엔티티·관계 이중 검색, 계층 검색을 보여 주는 세 설계를 비교합니다. 질문 범위와 갱신 방식, 원문 근거 확인 경로를 먼저 구분하고, 서로 다른 평가 조건의 결과는 순위로 합치지 않습니다.

성능 순위가 아닌 역할 비교입니다. 평가 조건과 한계는 상세 근거에서 확인하세요.

MS GraphRAG

역할
문서 집합 전체를 요약하는 검색 설계
이럴 때
여러 문서에 흩어진 공통 주제와 흐름을 묻는 경우
주의점
색인·요약 비용이 들며 국소 사실 조회의 우위를 뜻하지 않습니다.
MS GraphRAG 상세 근거

LightRAG

역할
엔티티와 관계를 함께 찾는 이중 검색
이럴 때
구체적 대상과 넓은 관계를 함께 찾고 문서를 증분 갱신하는 경우
주의점
추출 오류가 검색에 영향을 주며 총비용은 사용 조건에 따라 다릅니다.
LightRAG 상세 근거

Deep GraphRAG

역할
계층 검색과 지식 통합을 결합하는 파이프라인
이럴 때
넓은 문맥에서 세부 근거로 내려가는 검색을 검토하는 경우
주의점
작은 통합 모델과 별도의 최종 생성 모델을 구분해야 합니다.
Deep GraphRAG 상세 근거

상세 근거와 출처

해석 한계: 세 논문은 질문 유형, 코퍼스, 평가 지표와 생성 모델이 다르다. 표의 목적은 승자를 정하는 것이 아니라 반복 전역 요약, 증분 갱신, 계층적 global-to-local 검색 중 어떤 조건이 필요한지 구분하는 데 있다.

각 셀은 해당 방법의 원논문 PDF에 근거한다. 검색·지식 통합·최종 생성 단계와 색인·학습·질의 비용을 구분해 읽어야 한다. 비용은 논문이 공개한 조건 안에서만 정성적으로 서술했으며, 보고되지 않은 총비용과 사용자용 인용 기능은 추정하지 않았다.

MS GraphRAG

전 항목 출처출처 1
다루는 정보·표현 단위
계층별 커뮤니티 보고서를 질의와 대조해 부분 답변을 만들고, 이를 map-reduce로 합쳐 코퍼스 전체의 주제를 요약한다.
입력 그래프와 구성
LLM이 청크에서 엔티티·관계·주장을 추출하고, Leiden 커뮤니티 계층을 만든 뒤 하위에서 상위로 커뮤니티 보고서를 사전 생성한다.
평가 조건
약 100만 토큰 Podcast와 약 170만 토큰 News 코퍼스의 global sensemaking 질문에서, LLM 판정으로 포괄성·다양성·empowerment·directness를 비교했다.
설명·근거 확인
커뮤니티 보고서와 부분 답변은 추출 그래프와 원문 청크에서 이어지지만, 최종 생성 답변 자체가 문장별 원문 근거를 보증하지는 않는다.
비용
색인 때 엔티티 추출과 계층 보고서 생성 비용을 먼저 지불한다. 같은 코퍼스에 전역 질문이 반복되면 사전 생성 보고서를 재사용할 수 있지만, 질의 때도 보고서별 부분 답변과 통합 호출이 필요하다.
실패 조건
국소 사실 조회에는 과한 경로가 될 수 있고, 추출·엔티티 병합·다단계 요약 오류가 상위 보고서로 전파될 수 있다. 원문 평가는 두 영어 코퍼스와 LLM 판정에 한정되며 fabrication rate는 직접 비교하지 않았다.
논문 선택 비교로 돌아가기

LightRAG

전 항목 출처출처 1
다루는 정보·표현 단위
질문에서 만든 low-level key로 엔티티를, high-level key로 관계를 찾고, 관련 그래프 프로파일과 원문 청크를 함께 조합한다.
입력 그래프와 구성
LLM이 문서에서 엔티티와 관계 프로파일을 추출하고 중복을 합쳐 그래프를 만든다. 새 문서는 같은 추출 절차를 거쳐 기존 노드·엣지 집합에 증분 병합한다.
평가 조건
UltraDomain의 Agriculture·CS·Legal·Mix 네 코퍼스(약 60만~500만 토큰)에서 LLM 기반 포괄성·다양성·empowerment·overall 비교와 ablation을 수행했다.
설명·근거 확인
색인된 엔티티와 관계 프로파일은 원문 chunk ID를 보존하고 검색 결과에 원문을 포함할 수 있다. 이 연결은 확인 경로를 제공하지만 생성 답변의 사실성을 자동 보증하지 않는다.
비용
Legal 데이터 조건에서 키워드 생성·검색 토큰과 API 호출, 증분 갱신 비용을 GraphRAG와 비교했다. 전체 그래프 재구축을 피하는 장점은 있지만 절대 비용은 추출 모델과 코퍼스에 따라 다시 측정해야 한다.
실패 조건
low-level만 쓰면 넓은 관계를 놓치고 high-level만 쓰면 정밀한 답이 약해지는 ablation 결과가 있다. 보고된 비용·품질 비교는 선택한 네 코퍼스와 LLM 평가 설정 밖으로 그대로 일반화할 수 없다.
논문 선택 비교로 돌아가기

Deep GraphRAG

전 항목 출처출처 1
다루는 정보·표현 단위
상위 커뮤니티에서 시작해 관련 하위 그래프와 엔티티로 좁혀 가는 3단계 global-to-local 검색이며, 고정 폭 beam search와 문맥 재랭킹을 쓴다.
입력 그래프와 구성
600토큰 청크와 100토큰 겹침을 사용하며, Qwen2.5-72B-Instruct로 엔티티와 방향성 관계를 추출한다. 설명 임베딩으로 병합 후보를 찾고 LLM으로 동일 개체인지 확인한 뒤, 재귀 Louvain으로 커뮤니티 계층을 구성한다.
평가 조건
Natural Questions와 HotpotQA를 local·global·comprehensive 질문으로 나눠 Exact Match를 비교했고, NQ에서 Local Search·DRIFT와 지연시간을 비교했다. Table 1의 1.5B-DW-GRPO 모델은 지식 통합 단계에 쓰이며, 최종 답변 생성에는 별도의 Qwen2.5-72B 또는 DeepSeek-R1을 사용한다.
설명·근거 확인
미확인논문은 검색된 엔티티·하위 그래프를 최종 답변의 원문 구절이나 사용자용 인용으로 연결하는 규약을 보고하지 않는다.
비용
NQ에서 DRIFT 대비 local/global 질문 지연 감소를 보고한다. 작은 통합 모델도 별도의 최종 생성 모델을 사용하며, 그래프 추출·재랭킹·증류와 DW-GRPO 학습을 포함한 전체 비용 비교는 제공하지 않는다.
실패 조건
계층 요약이 comprehensive 질문의 세부 사실을 가릴 수 있으며, 원문도 일부 CQ에서 local search가 앞선 사례를 인정한다. 근거는 두 QA 데이터셋과 단일 계층·beam 설정에 묶인다.
논문 선택 비교로 돌아가기