From RAG to Memory: Non-Parametric Continual Learning for Large Language Models
RAG를 ‘기억’으로 넓히는 방법: HippoRAG 2
HippoRAG 2는 원문 passage와 개념 그래프를 한 검색 공간에 넣고 질문마다 관련 관계를 다시 골라 PPR로 근거를 찾는다. 단순 사실 검색을 지키면서 여러 문서의 연결을 찾으려는 비모수 기억 설계다.
Paper: Bernal Jiménez Gutiérrez; Yiheng Shu; Weijian Qi; Sizhe Zhou; Yu Su (2025). "From RAG to Memory: Non-Parametric Continual Learning for Large Language Models." ICML 2025, PMLR 267, 21497–21515. PDF
1. 무엇을 ‘기억’이라고 부르는가
일반 RAG는 질문과 가까운 문단을 임베딩으로 찾아 답변 모델에 넣는다. 새 문서를 벡터 데이터베이스에 추가할 수 있다는 점에서, 파라미터를 다시 학습하지 않고도 지식을 늘린다. HippoRAG 2는 이 특성을 비모수 continual learning이라 부른다. 여기서 비모수란 모델 가중치에 사실을 새겨 넣지 않고, 외부 색인을 고쳐 쓴다는 뜻이다.
저자들은 기억을 세 가지 대리 과제로 측정한다. 한 사실을 찾는 factual memory, 여러 문서의 단서를 잇는 associativity, 긴 서사를 통합하는 sense-making이다. 예를 들어 “한 인물의 출생지와 그 도시가 속한 행정구역”을 물으면 첫 문서의 인물과 두 번째 문서의 장소를 연결해야 한다. 다만 이것은 사람의 기억 전체가 아니라 QA 과제로 만든 측정 틀이다. 시간에 따라 서로 충돌하는 사실을 정리하거나, 삭제 요청을 반영하거나, 모델의 망각을 측정한 것은 아니다.
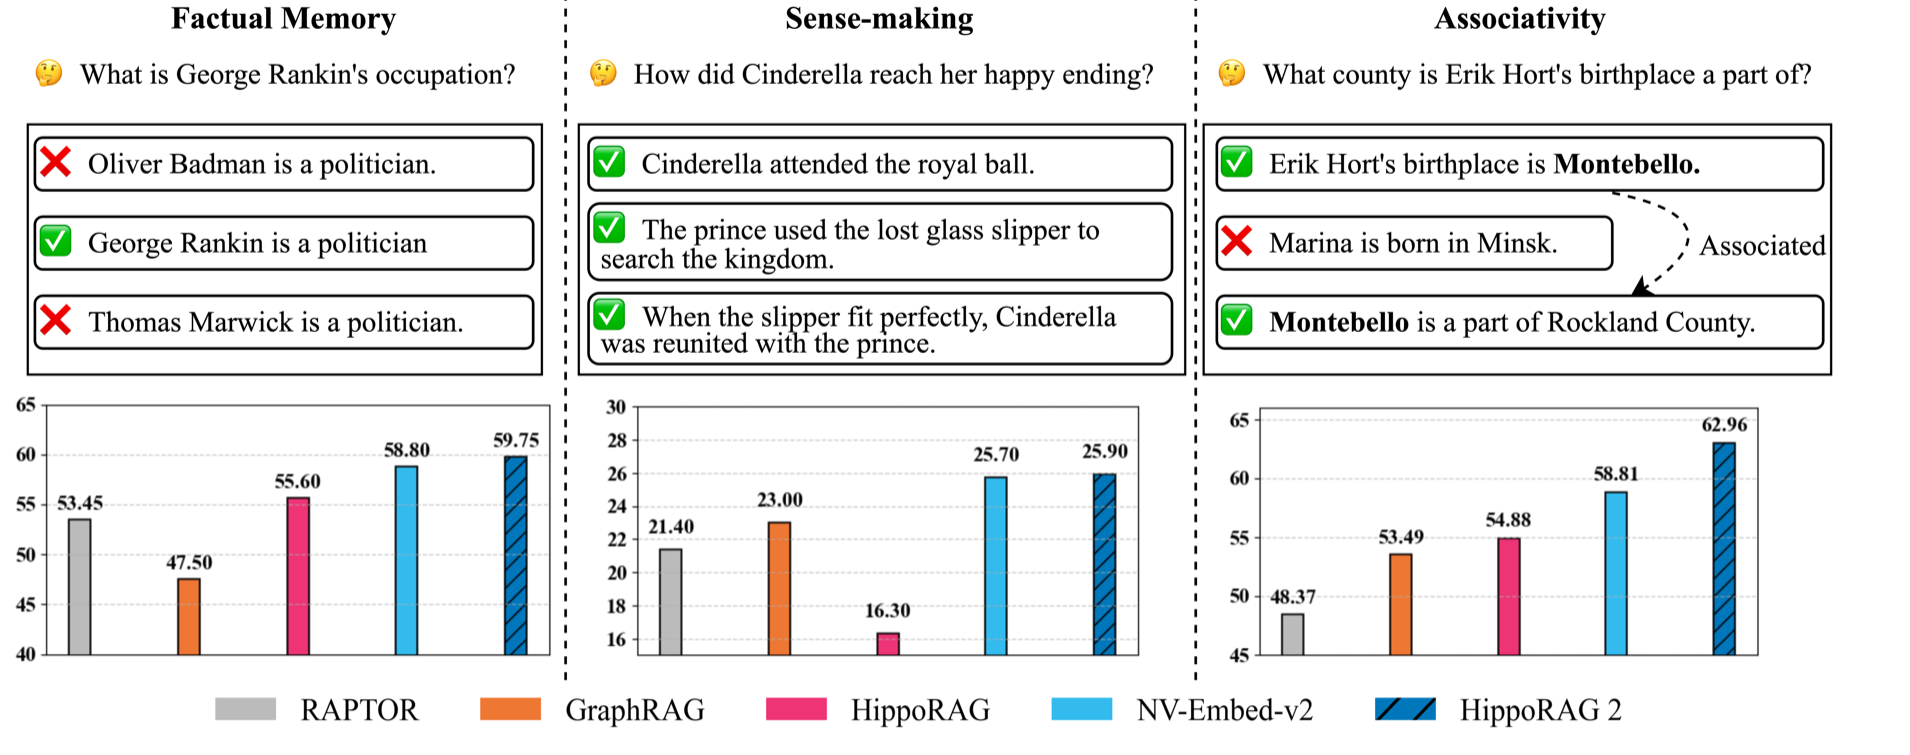
그림 1. Gutiérrez et al., Figure 1, ICML 2025/PMLR PDF p. 2의 원도판 크롭. factual memory·sense-making·associativity로 나눈 비교를 보라. 이 그림은 과제별 평균을 압축한 것이므로 개별 데이터셋의 차이와 비용은 보여주지 않는다. CC BY 4.0.
2. 핵심 아이디어: 원문과 연결망을 한 그래프에 둔다
기존 HippoRAG는 문장에서 뽑은 (주체, 관계, 객체) 형태의 OpenIE triple과 개념어를 그래프로 만들었다. 여러 홉을 따라가기 좋지만, 짧은 개념 노드만 남으면 “어떤 문단이 이 관계를 말했는가”라는 원문 문맥이 약해진다.
HippoRAG 2는 각 원문 문단(passage)도 노드로 추가하고, passage 안의 phrase와 연결한다. 질문이 오면 두 출발점을 함께 만든다. 하나는 질문과 닮은 passage, 다른 하나는 질문과 닮은 triple이다. 상위 triple은 LLM이 다시 읽어 관련된 것만 고른다. 그 뒤 Personalized PageRank(PPR), 즉 질문과 가까운 출발점에서 그래프를 따라 중요도를 퍼뜨리는 순위화가 passage를 정렬한다. 그래프는 답을 직접 쓰지 않는다. 어떤 원문을 답변 모델(reader)에게 줄지 정하는 연결 장치다.
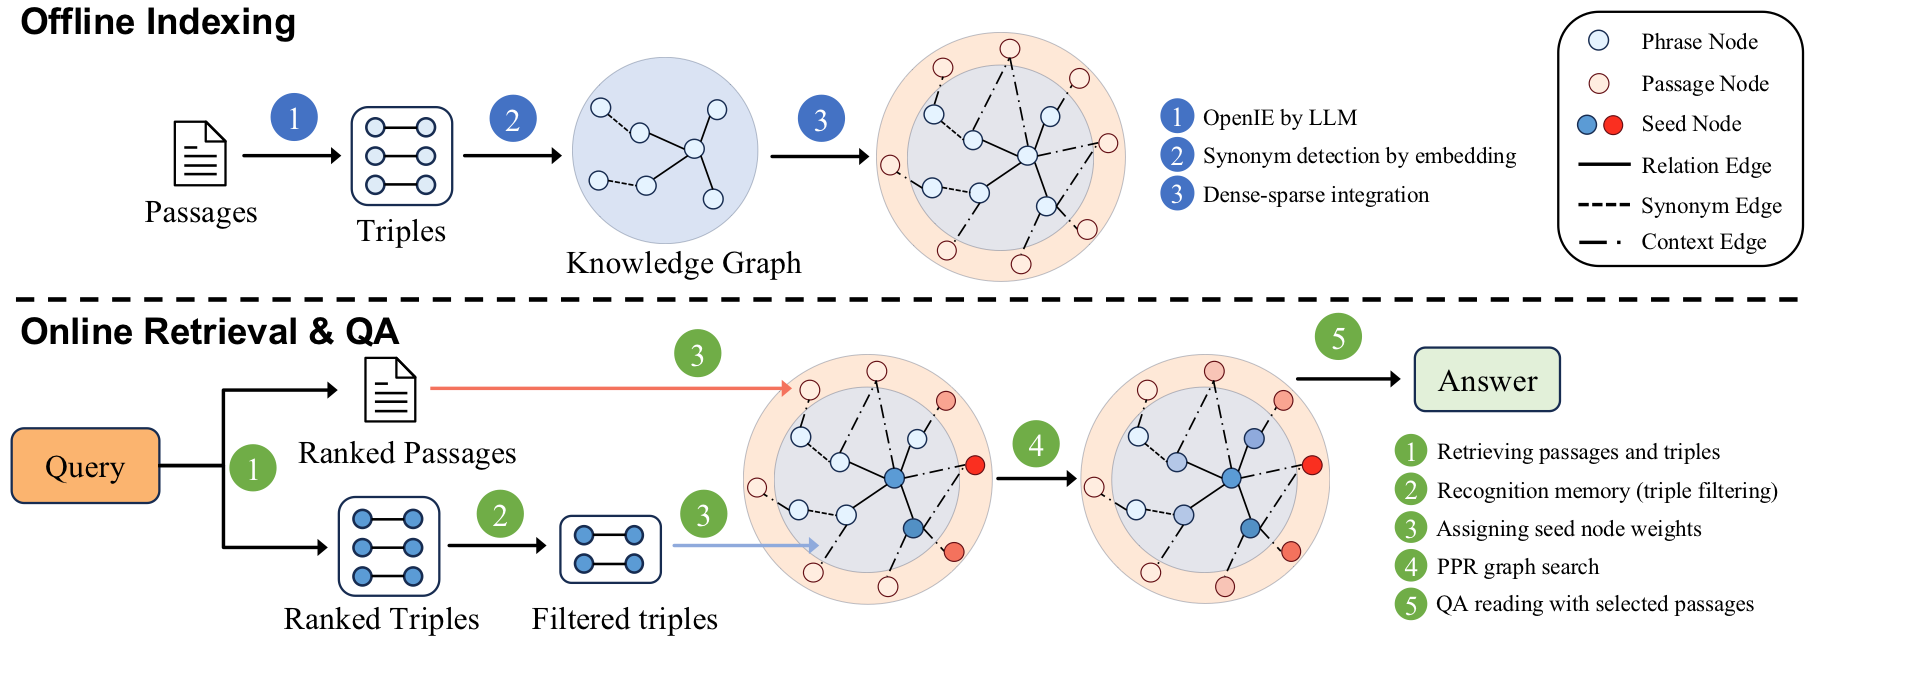
그림 2. Gutiérrez et al., Figure 2, ICML 2025/PMLR PDF p. 4의 원도판 크롭. 위는 OpenIE·동의어·passage 노드를 만드는 색인, 아래는 triple filtering과 PPR 검색이다. ‘그래프만’으로 검색하지 않고 passage 임베딩을 함께 seed로 쓴다는 점을 보라. 온라인 LLM filtering 호출과 색인 비용은 이 도식에 수치로 드러나지 않는다. CC BY 4.0.
3. 질문 하나를 따라가 보면
질문이 “Erik Hort의 출생지가 속한 county는 어디인가?”라고 하자. 단어 일치 검색은 Erik Hort를 언급한 문단만 잡을 수 있다. HippoRAG 2는 Erik Hort—born in—Montebello 같은 관계를 triple 후보로 찾고, 질문과 실제로 관련 있는지 LLM에게 확인한다. 동시에 Montebello를 설명하는 원문 passage에도 점수를 준다. PPR은 이 두 출발점에서 퍼진 점수로 Montebello, New York처럼 답에 필요한 문단을 상위에 올린다.
이 과정의 안전장치도 있다. 필터를 통과한 triple이 없으면 PPR을 억지로 돌리지 않고, 강한 dense retriever가 고른 passage로 돌아간다. 구조가 불확실할 때 단순 검색의 장점을 남겨 두는 선택이다. 반대로 query마다 triple 후보를 LLM으로 거르는 만큼, 이전 HippoRAG보다 지연 시간과 모델 의존성이 늘어난다.
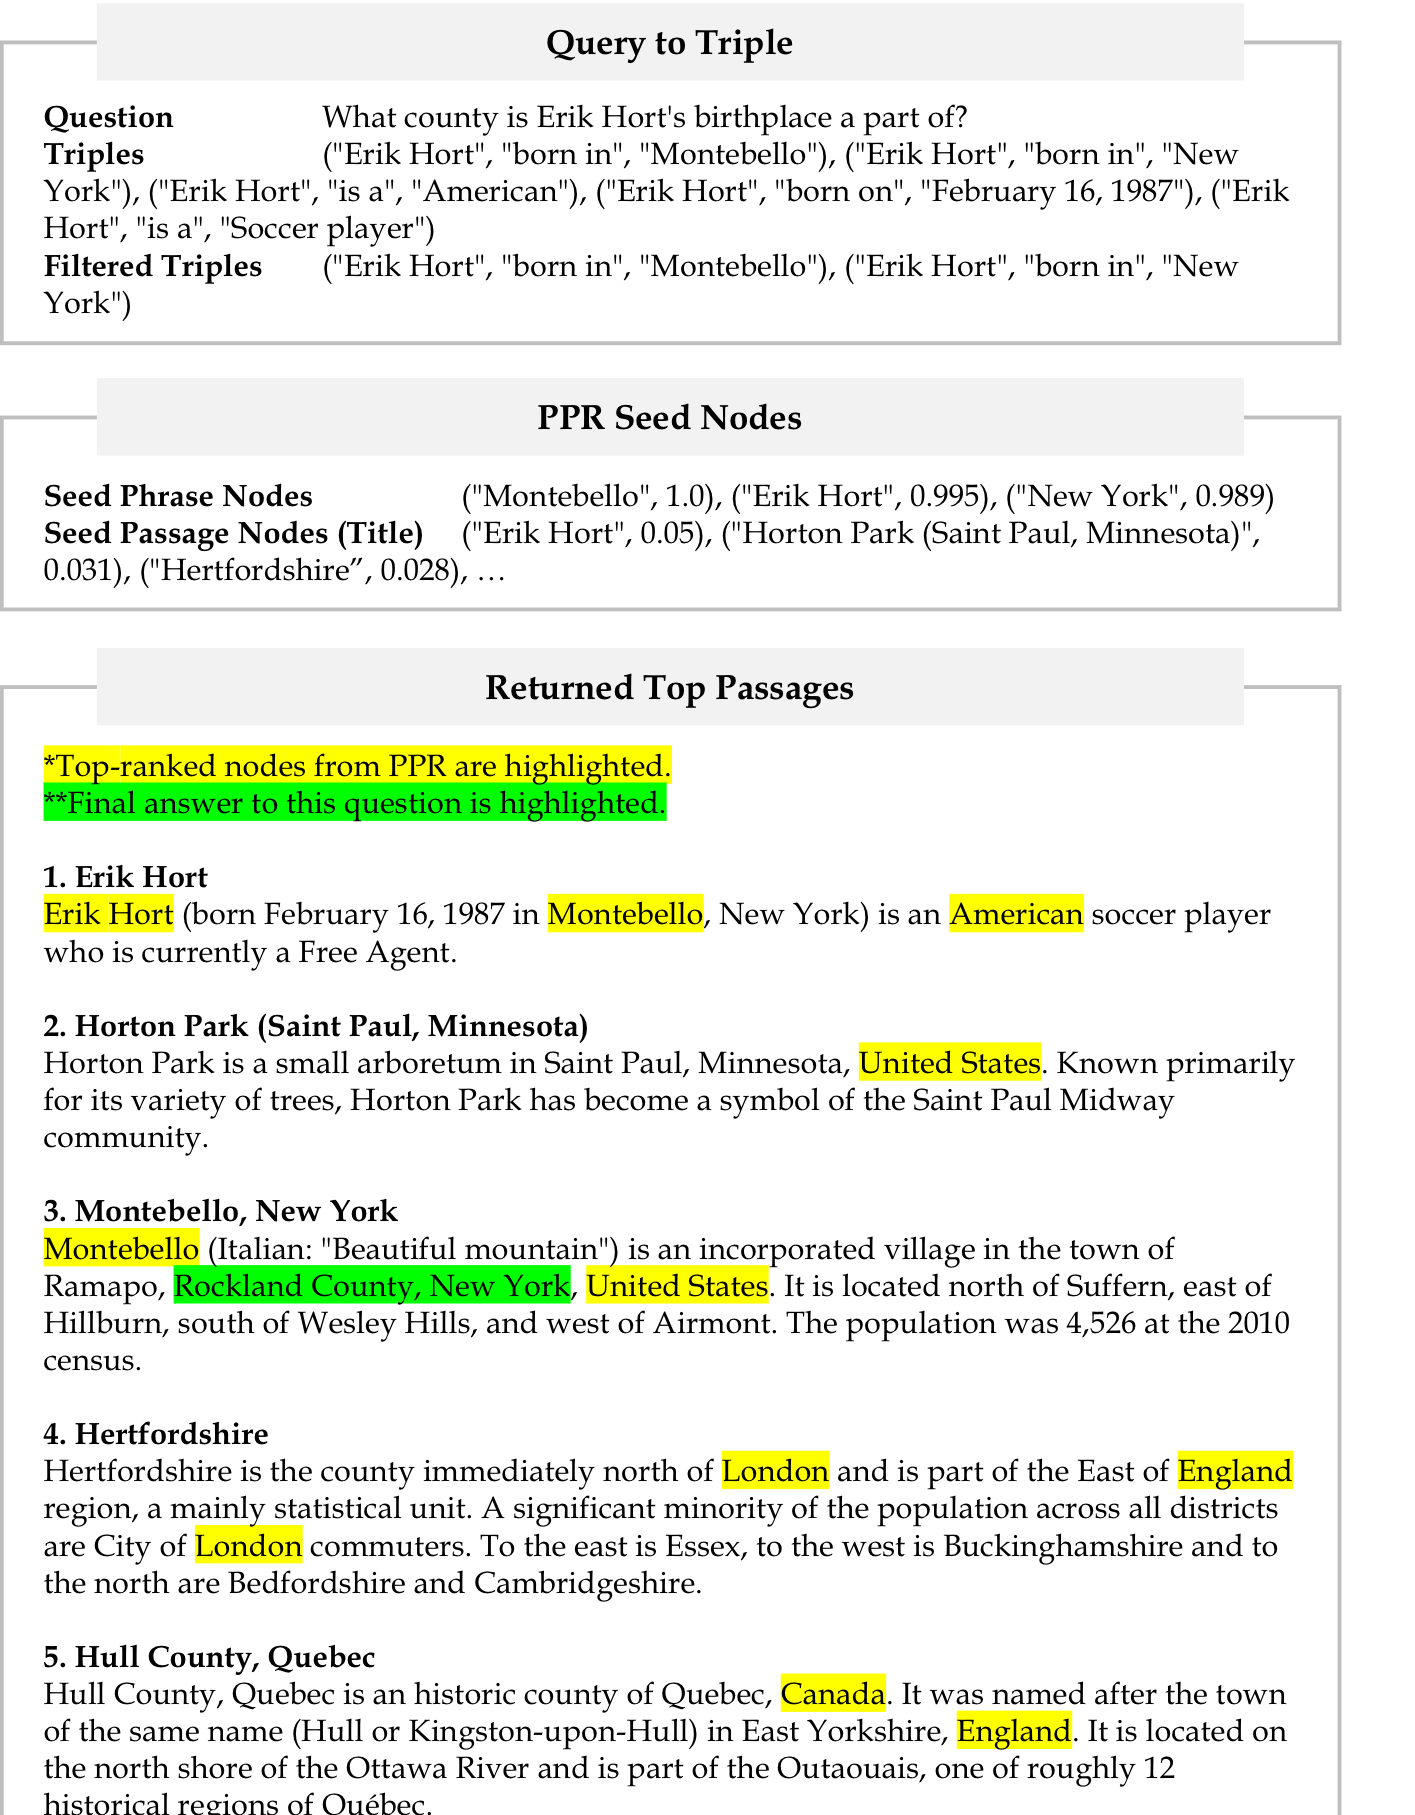
그림 3. Gutiérrez et al., Figure 5, ICML 2025/PMLR PDF p. 15의 원도판 크롭. triple 선택, phrase·passage seed, PPR 결과가 이어지는 한 성공 사례를 보라. 예시는 작동 설명용이며 전체 벤치마크 성능이나 인과적 설명 능력의 증거는 아니다. CC BY 4.0.
4. 저자가 보고한 결과와 조건
주 실험은 NaturalQuestions·PopQA, MuSiQue·2Wiki·HotpotQA·LV-Eval, NarrativeQA를 합친 7개 과제를 사용했고, 기본 dense retriever는 NV-Embed-v2, reader와 구조 생성에는 Llama-3.3-70B-Instruct를 썼다. Table 2에서 HippoRAG 2의 평균 QA F1은 59.8, NV-Embed-v2는 57.0이었다. 정답 근거 문단이 표시된 NQ·PopQA·MuSiQue·2Wiki·HotpotQA의 5개 과제만 묶은 Table 3에서는 retrieval recall@5 평균이 각각 78.2와 73.4다. 앞의 F1 평균과 평가 대상 수가 다르다.
이 숫자는 “그래프가 항상 좋다”가 아니라 저자 재현 조건에서의 평균이다. 큰 QA 차이는 2Wiki에서 보였고, PopQA·HotpotQA·NarrativeQA의 차이는 작았다. GraphRAG와 LightRAG는 passage recall 표에 넣지 않았다. 이들 방법이 passage 순위를 직접 반환하는 설정이 아니기 때문이다. 서로 다른 검색 단위를 같은 retrieval 지표로 단정 비교할 수 없는 이유다.
또한 문서를 네 구간으로 늘린 corpus-expansion 실험은 새 자료를 색인에 더할 수 있음을 보이지만, 시간이 지난 뒤 틀린 지식을 교정하는 실험은 아니다. MuSiQue에서 corpus가 커질수록 성능이 내려간 점도 함께 읽어야 한다.
5. 도입 전에 볼 조건
HippoRAG 2는 여러 문서에 흩어진 관계를 찾아야 하고, 그래프가 놓친 경우에는 dense retrieval로 물러설 수 있는 지식베이스에 맞는다. 반면 OpenIE 품질, 동의어 연결, LLM filtering이 모두 틀릴 수 있으므로 법률의 예외 조항이나 시간에 따라 바뀌는 정책처럼 정확한 방향·시점이 핵심인 자료는 passage 출처와 충돌 처리를 따로 점검해야 한다.
가장 중요한 비용 구분도 있다. 색인 단계는 passage마다 OpenIE와 그래프 구성이 필요하고, 질의 단계도 filtering LLM을 호출한다. 따라서 “새 문서를 추가할 수 있다”는 장점은 재학습을 피한다는 뜻이지, 색인과 질의가 무료라는 뜻은 아니다. 논문은 MuSiQue 비용 측정에 70B LLM과 4×H100 환경을 사용했다.
6. 정리
HippoRAG 2는 원문 passage와 관계 그래프를 같은 PPR 출발 분포에서 결합해 단순 검색의 손실을 줄인 설계를 제시한다. 인간 기억을 완성했다는 주장보다 이 설계가 설득력 있다. 복합 질의에서는 graph association을 쓰고, 구조가 불확실하면 dense retrieval로 돌아간다. 다만 continual learning이라는 이름을 시간적 충돌 해결이나 모델 기억의 증명으로 확대하지 말고, 고정된 QA 말뭉치가 커지는 조건에서 검증한 외부 색인 갱신 방식으로 읽는 편이 정확하다.
References
Gutiérrez, B. J., Shu, Y., Qi, W., Zhou, S., & Su, Y. (2025). From RAG to memory: Non-parametric continual learning for large language models. In Proceedings of the 42nd International Conference on Machine Learning (PMLR 267, pp. 21497–21515). https://proceedings.mlr.press/v267/gutierrez25a.html