LightRAG: Simple and Fast Retrieval-Augmented Generation
커뮤니티 보고서 대신 엔티티와 관계를 찾는 GraphRAG: LightRAG
LightRAG는 문서를 엔티티·관계 그래프로 색인한 뒤, 질문의 구체 단서는 엔티티에서, 넓은 주제는 관계에서 찾는다. 커뮤니티 보고서를 크게 읽는 global GraphRAG와 달리 작은 그래프 프로파일과 원문을 조합하는 설계다.
Paper: Zirui Guo; Lianghao Xia; Yanhua Yu; Tu Ao; Chao Huang (2025). "LightRAG: Simple and Fast Retrieval-Augmented Generation." Findings of EMNLP 2025, 10746–10761. PDF
1. 그래프의 검색 단위를 바꾸다
평범한 RAG는 문서를 청크로 나누고 질문과 가까운 청크를 찾는다. “누가 이 소설을 썼나?”처럼 구체적 사실에는 효율적이지만, 여러 문서에 흩어진 개체와 관계를 한 답에서 엮기 어렵다. Microsoft GraphRAG의 global search는 이 문제를 community report로 풀지만, 질의마다 여러 긴 보고서를 읽고 결과를 통합해야 한다.
LightRAG는 graph를 버리지 않는다. 대신 커뮤니티 보고서가 아니라 엔티티와 관계의 키–값 프로파일을 검색한다. Beekeeper 같은 엔티티에는 이름을 key로 두고 설명·원문 청크 ID를 value로 둔다. 관계에는 연결된 개체뿐 아니라 넓은 주제를 나타내는 여러 key를 붙인다. 질문과 가까운 작은 그래프 요소를 먼저 찾고 관련 원문도 함께 가져오는 방식이다.
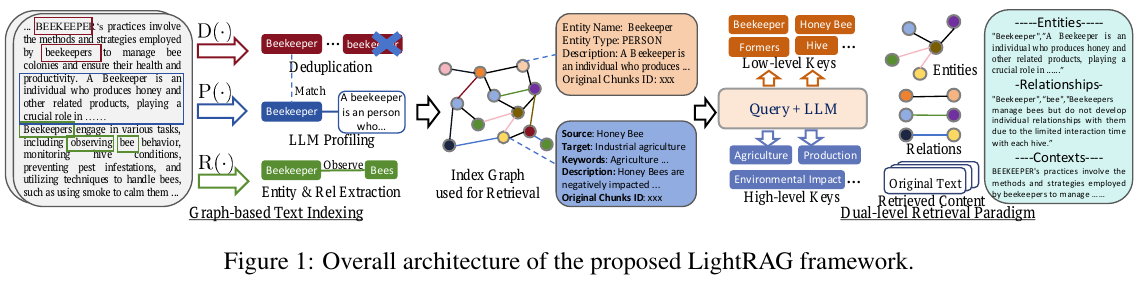
그림 1. Guo et al., Figure 1, EMNLP 2025 PDF p. 10749의 원도판 크롭. LLM이 엔티티·관계를 추출하고 프로파일·중복 제거를 거친 뒤, low-level·high-level key로 검색하는 구조를 보라. 색인 단계의 LLM 호출, 추출 오류, 중복 병합의 정확도는 그림만으로 판단할 수 없다. CC BY 4.0.
2. 구체적 질문과 넓은 질문을 나눈다
LightRAG는 질문에서 두 종류의 키워드를 만든다. low-level 키워드는 특정 개체·속성·사실을 찾는 단서다. 예를 들어 Pride and Prejudice, author가 여기에 속한다. high-level 키워드는 주제나 관계의 틀을 찾는다. 교육에 미친 AI의 영향처럼 개별 이름이 아닌 넓은 관점을 묻는 표현이다.
low-level key는 엔티티 후보와, high-level key는 주제 key가 붙은 관계 후보와 벡터 검색으로 맞춘다. 그 뒤 선택된 노드·간선의 1-hop 이웃, 엔티티·관계 설명, 원문 일부를 모아 생성 모델에 준다. LightRAG는 그래프 탐색에만 의존하지 않는다. 벡터 검색은 계속 핵심이고, 그래프는 청크 대신 무엇을 검색하고 어떤 주변 문맥을 붙일지를 조직한다.
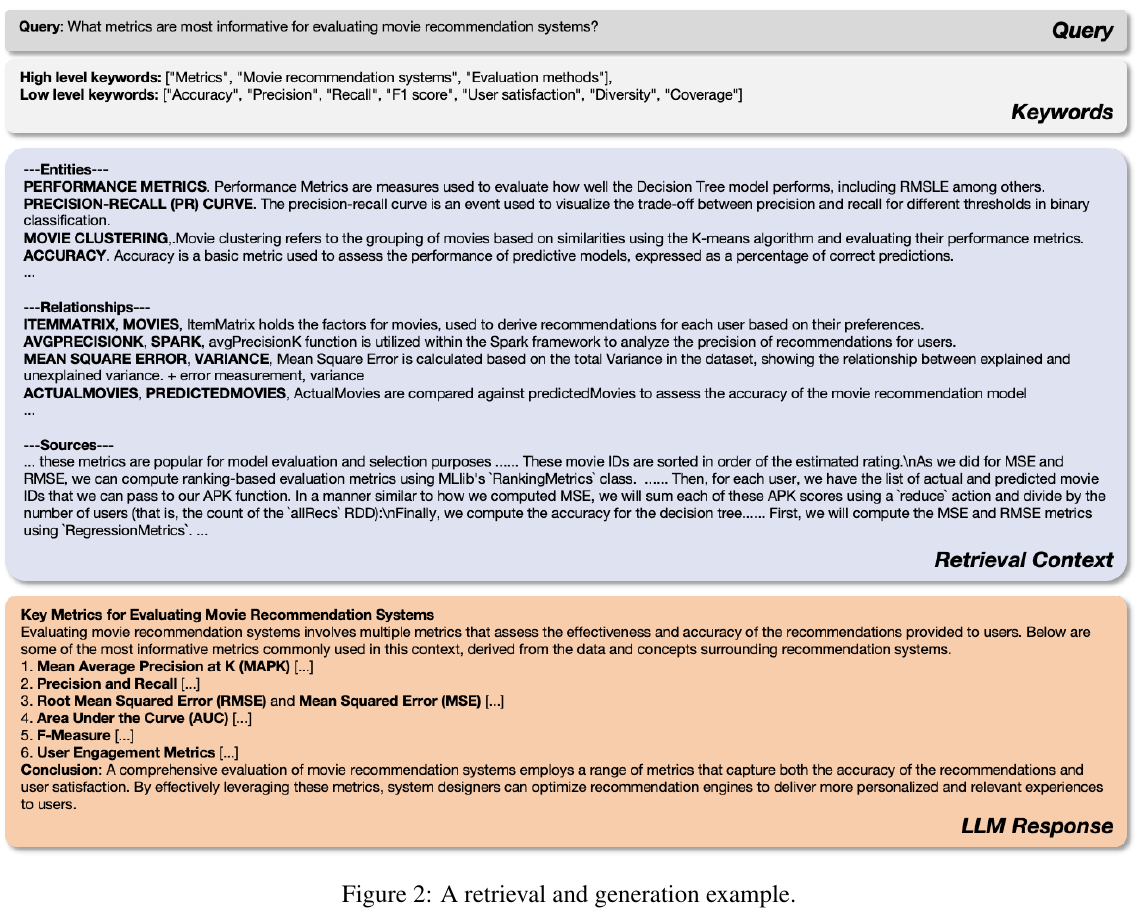
그림 2. Guo et al., Figure 2, EMNLP 2025 PDF p. 10757의 원도판 크롭. 영화 추천 지표 질문에서 high-level과 low-level 키워드, 관계·엔티티·원문이 합쳐지는 예시를 보라. 이는 한 예시 흐름이며 1-hop 이웃이 모든 다중 홉 근거를 회수한다는 정량 증거는 아니다. CC BY 4.0.
새 문서가 오면 전체 색인을 다시 만들지 않고, 새 문서에서 같은 추출·프로파일 절차를 수행해 기존 node·edge 집합에 합친다고 설명한다. 이 방식은 증분 갱신이다. 같은 이름의 다른 사람, 상충하는 최신 사실, 삭제 요청을 자동으로 해결한다는 뜻은 아니다. 그런 데이터 품질 정책은 별도 설계가 필요하다.
3. 저자 결과를 정확히 읽기
주 평가는 UltraDomain의 Agriculture, CS, Legal, Mix에서 데이터셋별 125개 LLM 생성 질문을 사용했다. GPT-4o-mini가 두 답변을 포괄성·다양성·empowerment·종합으로 일대일 판정한다. NaiveRAG 대비 LightRAG의 종합 승률은 Agriculture 67.6%, CS 61.2%, Legal 84.8%, Mix 60.0%였다.
GraphRAG와 비교하면 결론은 더 좁다. 종합 승률은 각각 54.8%, 52.0%, 52.8%, 49.6%로 Mix에서는 LightRAG가 뒤졌다. 네 데이터셋 모두 더 높았던 것은 diversity 지표다. 답변의 관점이 넓어졌을 수는 있지만, 판정자 선호도와 diversity는 검색 정확도·근거 충실도·사실성의 측정값이 아니다.
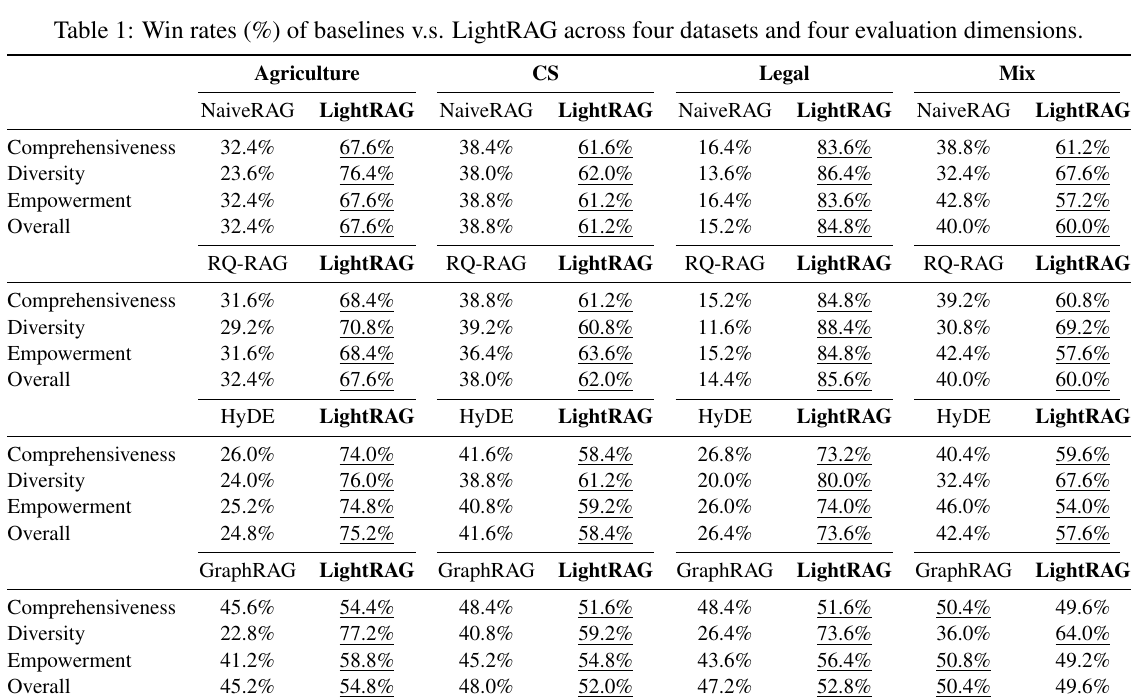
그림 3. Guo et al., Table 1, EMNLP 2025 PDF p. 10751의 원도판 크롭. 네 데이터셋과 네 평가 차원의 pairwise LLM-judge 승률이다. GraphRAG 대비 종합 행에서 Mix 49.6%도 함께 보라. 이 표는 사람 평가나 gold-answer 정확도 표가 아니다. CC BY 4.0.
4. ‘가볍다’는 말의 예산 범위
논문의 Legal 데이터셋 비용 계산은 GraphRAG의 level-2 community report 610개를 각 1,000 token으로 읽는다면 610,000 token이라고 놓고, LightRAG는 keyword 생성과 검색에 100 token 미만·API 1회라고 제시한다. 이 수치는 검색 단계의 키워드 생성 비용이며, 최종 답변 모델이 읽는 검색 문맥과 답변 생성 토큰은 포함하지 않는다. 출판본 부록은 평균 질의 시간 11.2초 대 23.6초, 저장공간 39.5MB 대 286.7MB를 보고했다.
이 결과는 해당 corpus, 보고서 길이, 구현 구성에서의 비교다. LightRAG가 쓰기 비용이 없다는 뜻은 아니다. 청크별 LLM entity·relation extraction, 프로파일 생성, deduplication을 먼저 수행하며, 질의 시에도 keyword 생성 LLM을 사용한다. index 비용과 query 비용을 같은 숫자로 합치거나, 특정 GraphRAG 설정의 610,000 token을 모든 배포 환경의 상수처럼 쓰면 안 된다.
5. 어디에 맞는가
구체적 사실과 넓은 주제 질문이 섞이고, community report의 큰 질의 문맥이 부담스러운 문서 집합에 맞는 선택이다. 적용 전에는 엔티티 분해·동명이인·관계 추출의 오류율, 새 문서의 충돌 병합 규칙, 문장별 원문 출처, 그리고 색인 비용과 p95 질의 지연을 함께 측정해야 한다. 빠른 graph retrieval이 필요하다는 요구만으로 실제 근거 정확도까지 보장되지는 않는다.
도입 판단을 좁히는 두 질문
LightRAG는 구체 엔티티와 넓은 관계를 한 질의에서 함께 찾고 싶은가, 그리고 새 문서를 전체 재색인 없이 자주 합쳐야 하는가라는 두 조건이 맞을 때 후보가 된다. 다만 비용 우위는 논문의 Legal 데이터 설정에서 토큰과 API 호출을 GraphRAG와 비교한 결과다(원문 §4.4). 다른 추출 모델, 그래프 밀도, 캐시 정책에서도 같은 절대 비용이 나온다는 근거는 아니므로 실제 코퍼스에서는 색인·갱신·질의 비용을 따로 측정해야 한다.
6. 정리
LightRAG는 graph를 검색 가능한 엔티티·관계 프로파일로 다룬다. 커뮤니티 요약의 묶음으로 보지 않는다. 두 수준의 키워드와 원문 문맥을 함께 쓰는 설계는 LLM-judge 기준 답변의 폭을 넓히고 특정 설정에서 비용을 줄일 가능성을 보였다. 다만 GraphRAG와의 종합 우위는 작고 Mix에서는 역전됐으며, 주요 평가는 자동 생성 질문과 자동 judge다. 따라서 이를 ‘더 빠르고 더 정확한 GraphRAG의 일반 해법’보다, 검색 단위와 예산을 바꾼 한 설계로 이해하는 편이 안전하다.
References
Guo, Z., Xia, L., Yu, Y., Ao, T., & Huang, C. (2025). LightRAG: Simple and fast retrieval-augmented generation. In Findings of the Association for Computational Linguistics: EMNLP 2025 (pp. 10746–10761). Association for Computational Linguistics. https://doi.org/10.18653/v1/2025.findings-emnlp.568