RAGU: A Multi-Step GraphRAG Engine with a Compact Domain-Adapted LLM
작은 추출기와 다단계 통합으로 만드는 GraphRAG: RAGU
RAGU는 엔티티·관계 추출과 중복 통합을 나누고, 7B Meno-Lite로 그래프를 만든다. 의료 GraphRAG-Bench에서 합성형 질문의 이점은 보이지만, 추출기 성능 우위가 최종 QA 우위로 그대로 이어지지는 않는다.
Paper: Mikhail Komarov; Ivan Bondarenko; Stanislav Shtuka; Oleg Sedukhin; Roman Shuvalov; Yana Dementyeva; Matvey Solovyov; Nikolay O. Nikitin (2026). "RAGU: A Multi-Step GraphRAG Engine with a Compact Domain-Adapted LLM." arXiv:2607.11683v1. PDF
1. 질문: 큰 모델이 그래프 추출에 꼭 필요한가
RAGU는 GraphRAG의 실패를 한 번의 자유형 추출에서 찾는다. 같은 대상을 여러 이름으로 만들고, 관계의 양 끝이 존재하지 않거나, 중복이 쌓이면 이후 검색도 흔들린다. 저자들은 문장에서 엔티티를 먼저 유형화해 뽑고 그 검증된 이름 사이에서 관계를 뽑은 뒤, 중복을 통합하고 커뮤니티를 만든다.
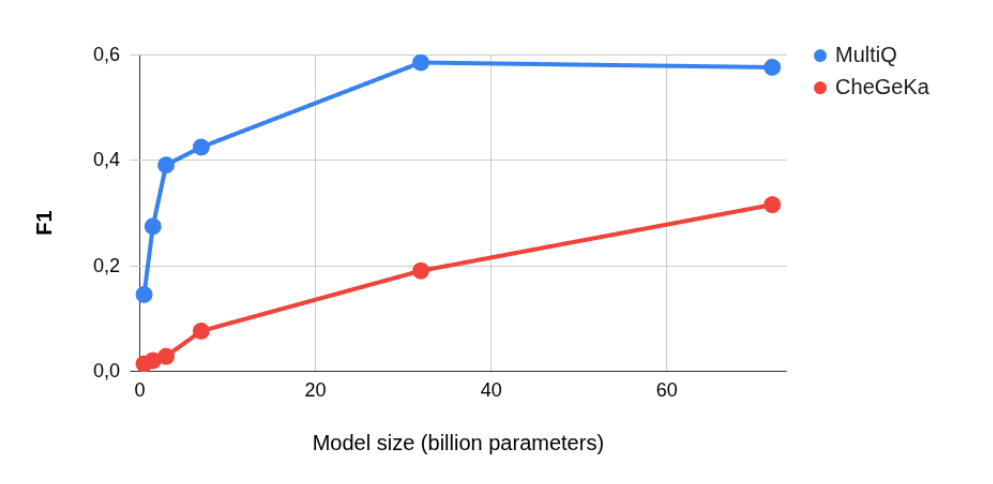
그림 1. 원논문 arXiv v1 PDF p. 2의 Figure 1을 인용했다. Qwen2.5 계열에서 문맥 이해·추출 과제(MultiQ)와 폐쇄형 세계지식 회상(CheGeKa)의 F1 변화가 다르게 나타난다. 이 그림은 ‘작은 모델이 모든 GraphRAG 업무에 충분하다’는 보편 법칙이 아니라, RAGU의 compact extractor 가설을 위한 한 모델 계열의 관찰이다.
2. 방법: 추출 다음에 통합한다
RAGU의 색인은 청킹, 2단계 유형 추출, DBSCAN 기반 중복 제거, LLM 요약, Leiden 커뮤니티 탐지 순서다. 마지막 산물은 그래프 DB·키값 저장소·벡터 저장소에 나뉘어 보관된다. Local·Global·Naive·Mix·QueryPlan 등 검색 엔진은 이 자료를 다르게 탐색할 수 있다.
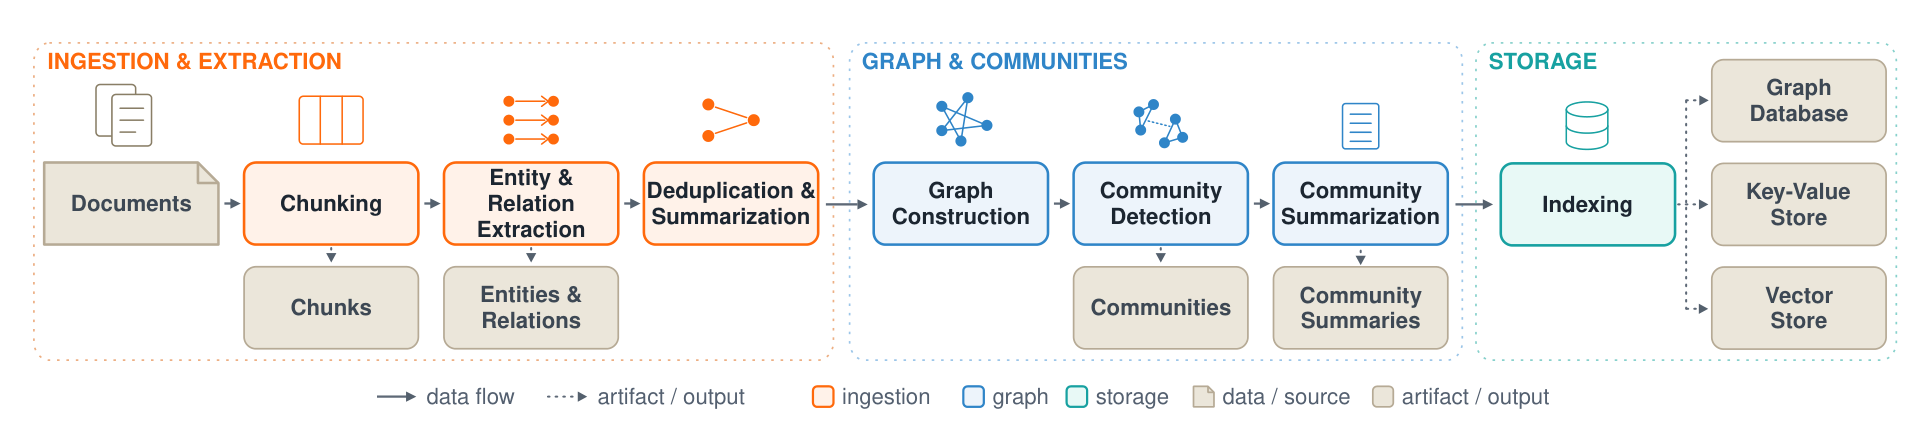
그림 2. 원논문 arXiv v1 PDF p. 3의 Figure 2를 인용했다. 문서→청크→엔티티·관계 추출→중복 제거·요약→그래프와 커뮤니티→세 저장 계층의 흐름을 보인다. 이 파이프라인은 통합 유무만을 바꾼 직접 절제 결과가 아니므로 각 단계의 독립 효과를 보여 주지는 않는다.
이 단계에는 7B 모델인 Meno-Lite-0.1을 쓴다. 저자들은 지식 그래프 구축에 필요한 이해·추출·문맥 추론이 거대한 세계지식 회상보다 모델 크기에 약하게 의존한다고 가정한다. NEREL 정보 추출의 네 항목, 즉 엔티티 인식 F1·엔티티 정의 chrF++·관계 추출 F1·관계 정의 chrF++를 조화평균한 HM은 Meno 0.468, Qwen2.5-32B 0.416이다. 12.5%는 이 두 값의 상대 개선이며 %포인트 차이가 아니다. F1은 추출의 정밀도와 재현율을, chrF++는 생성한 정의와 정답 정의의 겹침을 평가한다. 그러나 Meno는 NEREL 스키마로 미세조정됐고 비교 모델은 그렇지 않아, 이 수치는 작은 모델의 일반적 능력보다 도메인 적응의 유용한 증거로 읽어야 한다.
3. 결과: 질문 유형마다 다른 강점
의료 GraphRAG-Bench의 Answer Correctness는 google/gemini-3-flash-preview가 판정한 지표다. Figure 3의 비교는 색인 모델을 Meno-Lite-0.1로, 최종 답변 모델을 gpt-4o-mini로 맞췄다. 이 조건에서 HippoRAG2는 fact retrieval의 Answer Correctness 72.4로 RAGU 54.2보다 높다. 반면 질문이 넓은 통합을 요구할수록 차이는 줄고, creative generation에서 RAGU는 59.0으로 HippoRAG2 56.9를 앞선다. 다만 저자 본문은 Medical factoid의 Evidence Recall을 최대 0.84로 적고, Figure 3b의 Fact Retrieval 막대는 82.4%로 표시한다. 본문과 그림이 어긋나므로 0.84를 그 막대의 정확한 수치라고 읽을 수는 없다.
다중홉 QA에서는 답변 형식이 중요했다. 장황한 답을 허용하면 짧은 정답과의 비교가 불리해지지만, 직답 형식으로 통제한 BioASQ에서 RAGU는 72.9, HippoRAG2는 72.4였다. BioASQ의 0.5점과 creative generation의 2.1점 차이에 대한 불확실성 구간은 보고하지 않는다. MuSiQue와 2Wiki에서는 HippoRAG2 우위가 남는다. RAGU는 더 넓은 문맥과 통합형 질문에서 상보적인 검색기를 제시한다. 단일 사실을 정확히 찌르는 엔진을 대체했다는 뜻은 아니다.
4. 이득과 비용을 분리해 읽기
Meno의 정보 추출 우위가 end-to-end QA에서는 시험한 설정에서 1 point 이내로 압축된다고 저자들도 보고한다. 추출 모델이 좋아도 최종 답 품질이 자동으로 크게 달라지지는 않는다. API 기반 MS-GraphRAG와 비교한 비용은 문서당 약 USD 0.10 대 0.001로 매우 크지만, 이는 일회성 그래프 구축의 추정치다. 로컬 비용은 GPU 대여료 시간당 약 USD 1, 처리량 초당 2k tokens, 문서당 8k tokens를 가정한다. 공통 답변 모델의 질의 비용은 제외하며, API 추정치와 로컬 GPU 가정을 비교한 값이므로 총소유비용의 실측 비교가 아니다. 로컬 대안 모두에 대한 100배 우위로 읽어서는 안 된다.
5. 언제 유용한가
문서가 중복되고 그래프 품질을 계속 점검해야 하며, 자체 GPU에서 설치 가능한 시스템이 필요한 경우 RAGU의 검증·통합·저장소 설계는 실용적이다. 반대로 정답이 하나인 factoid 질문이 대부분이면 HippoRAG2 같은 정밀한 경로 검색과 같은 corpus에서 비교해야 한다. 도입 판단에는 스키마별 추출 F1, 중복 통합 전후의 근거 recall, 짧은 답과 긴 답을 분리한 평가가 함께 필요하다.
References
Komarov, M., Bondarenko, I., Shtuka, S., Sedukhin, O., Shuvalov, R., Dementyeva, Y., Solovyov, M., & Nikitin, N. O. (2026). RAGU: A multi-step GraphRAG engine with a compact domain-adapted LLM (arXiv:2607.11683v1). arXiv. https://arxiv.org/abs/2607.11683