Graph-of-Agents: A Graph-based Framework for Multi-Agent LLM Collaboration
필요한 전문가만 연결하는 다중 에이전트: Graph-of-Agents
Graph-of-Agents는 질문에 맞는 LLM 일부를 고르고, 응답의 관련도에 따라 메시지를 주고받게 한 뒤 답을 통합한다. MMLU-Pro의 근소한 점수 차이와 비용 절감은 유망하지만, 모든 과제에서 소수 에이전트가 더 낫다는 결론은 아니다.
Paper: Sukwon Yun; Jie Peng; Pingzhi Li; Wendong Fan; Jie Chen; James Zou; Guohao Li; Tianlong Chen (2026). "Graph-of-Agents: A Graph-based Framework for Multi-Agent LLM Collaboration." arXiv:2604.17148. PDF
1. 문제: 모델을 많이 부르면 답이 좋아질까
수학, 코드, 의학에 강한 모델을 모두 질문에 부르면 다양한 답을 얻을 수 있다. 하지만 관련 없는 답까지 다음 모델의 문맥에 넣으면 비용과 잡음이 함께 늘어난다. Graph-of-Agents(GoA)는 질문마다 필요한 에이전트와 대화 경로를 고른다. 여러 LLM을 무조건 한 덩어리로 합치지 않는다.
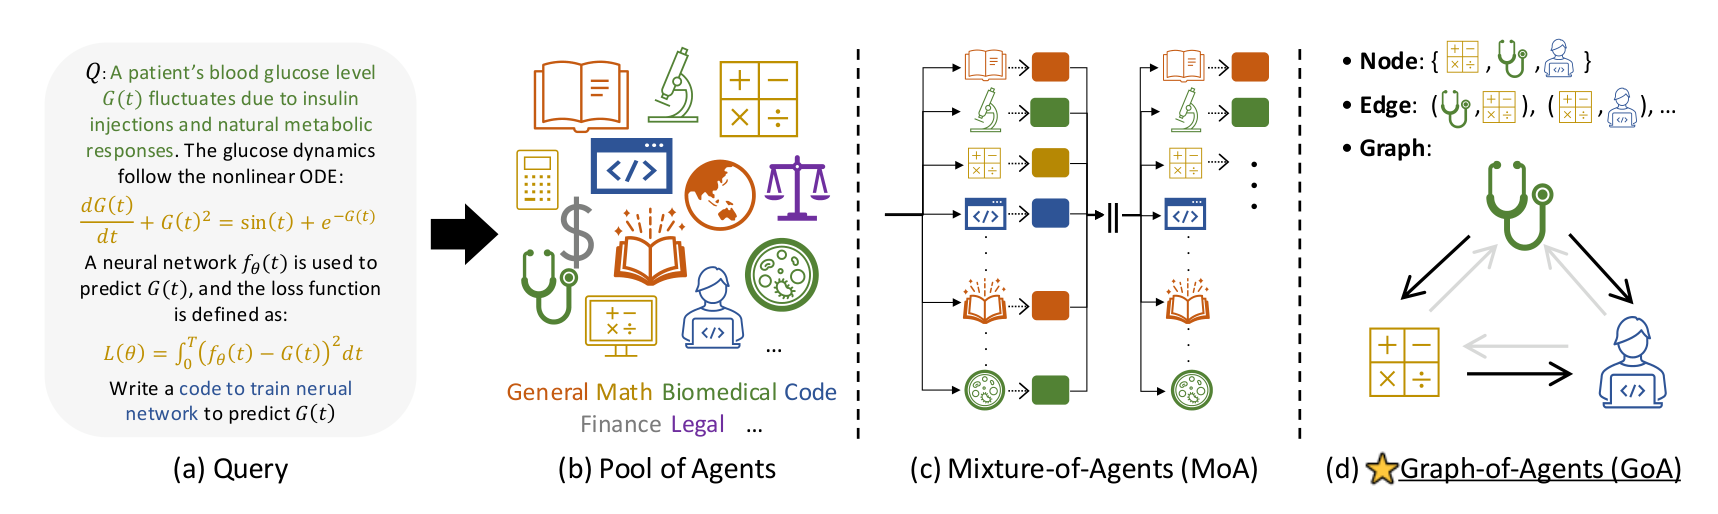
그림 1. 원논문 arXiv v1 PDF p. 2의 Figure 1을 인용했다. MoA는 에이전트 풀의 출력을 층별로 통합하고, GoA는 질문에 맞는 일부 노드와 그 사이의 방향 관계를 선택한다. 그림의 도메인 아이콘은 실제 전문성 보증이 아니라 모델 카드에 기록한 역할 정보다.
2. 방법: 고르고, 평가하고, 두 방향으로 고친다
GoA는 먼저 모델 카드와 질문을 읽은 meta-LLM이 상위 k개 에이전트를 고른다. 각 선택된 에이전트가 초안을 내면, 다른 에이전트가 그 초안이 질문에 얼마나 도움이 되는지 평가해 방향 간선을 만든다. 높은 관련도 응답이 낮은 관련도 응답을 돕는 순방향과, 반대로 낮은 쪽의 관점을 되돌리는 역방향 메시지 전달을 모두 한 뒤 max 또는 mean pooling으로 최종 답을 만든다. pooling은 에이전트 응답 중 하나를 선택하거나 여러 응답을 통합하는 마지막 단계다.
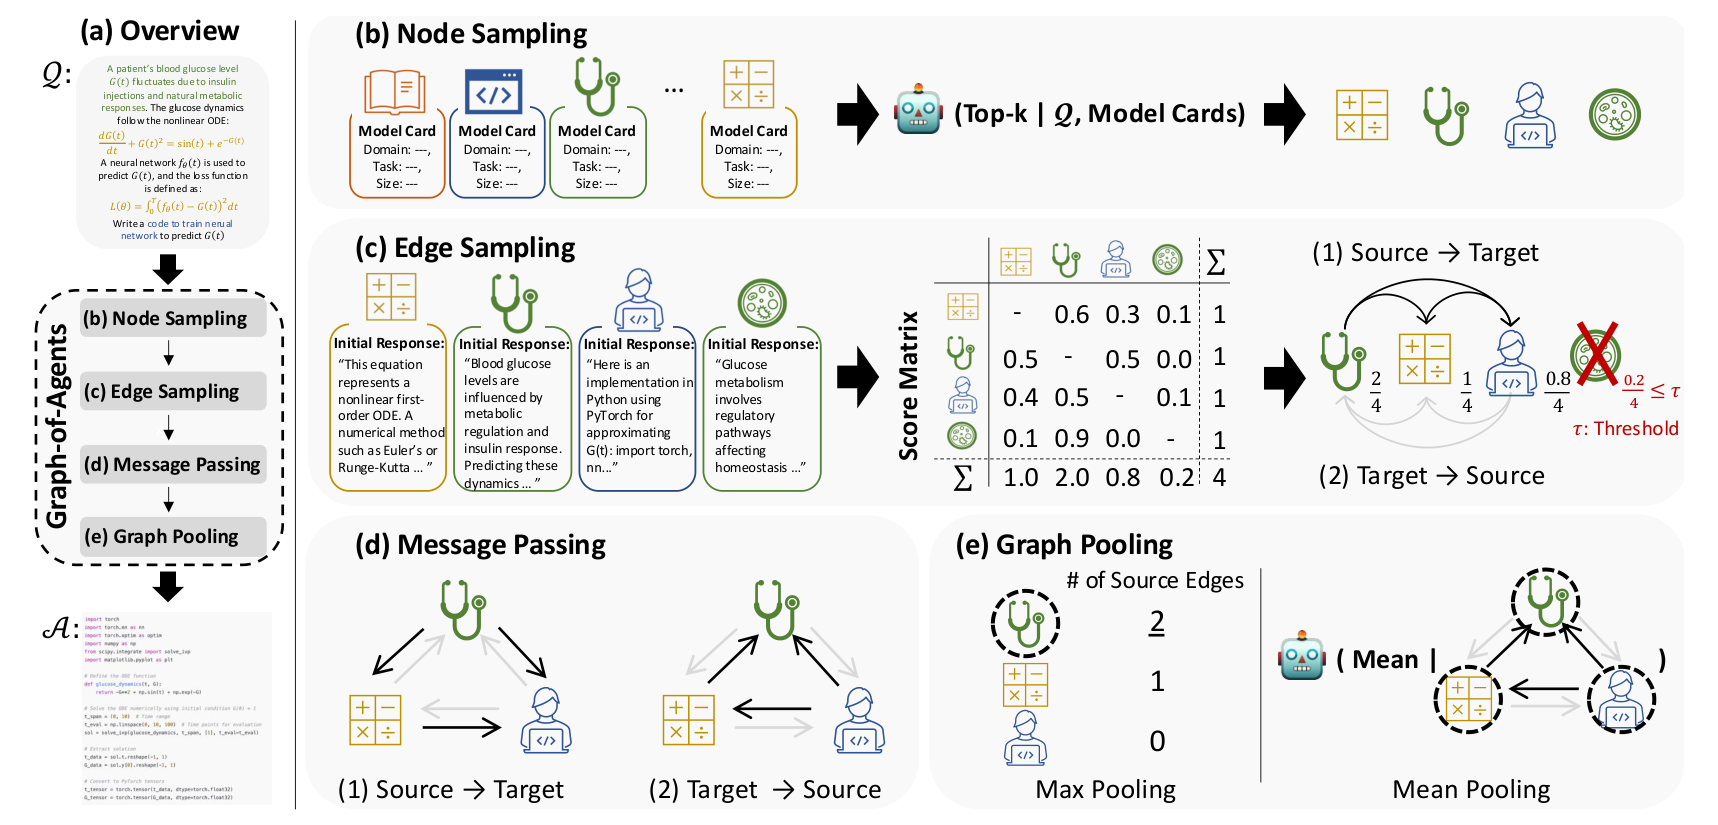
그림 2. 원논문 arXiv v1 PDF p. 4의 Figure 2를 인용했다. node sampling→edge sampling→양방향 message passing→graph pooling의 순서를 보인다. 여기서 메시지 전달은 학습된 GNN의 수치 연산이 아니라 이웃 에이전트의 텍스트 응답을 다음 프롬프트에 넣는 test-time 오케스트레이션이다.
3. 결과: 적은 호출로 낸 조건부 우위
7–8B 모델 여섯 개로 구성한 풀에서, GoA는 상위 세 에이전트를 사용해 MMLU, MMLU-Pro, GPQA, MATH, MedMCQA 다섯 벤치마크에서 표의 최고 점추정치를 보고한다. MMLU-Pro의 GoA_Max 54.78은 Refine 54.71보다 0.07%포인트 높다. 반복 실행의 분산이나 유의성 구간은 제시하지 않아, 이 근소한 차이가 안정적으로 재현되는지는 알 수 없다. MMLU-Pro에서 MoA는 호출 19회·56.05k tokens·240.26초, GoA_Max는 11회·19.18k·100.43초로 보고돼, 이 설정의 비용 절감은 정확도 결과와 별도로 확인할 수 있다. 호출 수와 토큰을 같게 맞춘 비교는 아니므로, 같은 계산 예산에서의 품질 우위보다 비용과 품질의 한 작동점으로 읽어야 한다.
그러나 HumanEval에서는 코드 단일 모델 85.37이 GoA의 84점대보다 높다. gpt-4o 실험에서도 GoA_Max(6)가 GoA_Max(3)보다 세 과제 모두 높고, GPQA에서는 8개를 쓰는 DyLAN이 더 높다. 따라서 ‘세 에이전트가 여섯 또는 여덟을 이긴다’는 말은 효율적인 작동점에 관한 것이지 보편적 규모 법칙은 아니다.
4. 무엇이 성능에 기여했나
저자 절제에서 메시지 방향을 뒤집으면 MMLU-Pro와 GPQA가 각각 2.60, 5.05 points 낮아지고 한 방향을 제거하거나 간선 점수를 끄는 경우도 하락한다. 이 구성에서는 선택된 에이전트 사이의 순서와 관련도 점수가 중요하다는 근거다. 다만 ‘선택만 하고 메시지를 보내지 않는’ 직접 기준선이 없어, 노드 선택과 메시지 전달의 이득을 완전히 나누지는 못한다.
GoA가 MoA를 일반화한다는 명제는 범위를 좁혀 읽어야 한다. 선택 노드를 전부로 늘리고, 그래프를 완전 연결로 만들고, mean pooling을 강제하면 MoA 형태가 된다는 구조적 관찰이다. 이것은 유용한 통합 관점이지만 표현력이나 최적성을 증명한 정리는 아니다.
5. 적용 조건
여러 모델이 실제로 다른 강점을 갖고, 모델 카드가 충분하며, 호출 예산이 제한된다면 GoA의 선택 단계는 실용적이다. 반대로 전문가 한 명이 압도적으로 맞는 코드 과제나 모델 카드가 빈약한 사내 풀에서는 meta-LLM의 선택 오류가 바로 병목이 될 수 있다. 실제 도입 전에는 같은 총 토큰 예산에서 단일 강한 모델, 무선택 MoA, GoA를 함께 비교하고 실행 간 분산도 기록해야 한다.
References
Yun, S., Peng, J., Li, P., Fan, W., Chen, J., Zou, J., Li, G., & Chen, T. (2026). Graph-of-agents: A graph-based framework for multi-agent LLM collaboration (arXiv:2604.17148). arXiv. https://arxiv.org/abs/2604.17148