Memory is Reconstructed, Not Retrieved: Graph Memory for LLM Agents
기억을 찾는 대신 다시 조립한다: MRAgent의 그래프 메모리
MRAgent는 대화 기억을 한 번 검색해 넣는 대신, 중간 증거에 따라 그래프를 여러 번 순회한다. 두 장기 기억 벤치마크의 향상은 유망하지만, 그래프 구조와 능동 정책의 기여는 완전히 분리되지 않았다.
Paper: Shuo Ji; Yibo Li; Bryan Hooi (2026). "Memory is Reconstructed, Not Retrieved: Graph Memory for LLM Agents." arXiv:2606.06036v1. PDF
1. 검색 한 번으로는 왜 부족한가
장기 대화에서 질문에 필요한 사실은 한 문장에 모여 있지 않을 때가 많다. “Nate가 세 번째 게임에서 쓴 상금은 무엇인가?”라고 물으면, 인물·게임·승리·상금처럼 서로 다른 시점의 단서를 이어야 한다. 기존 memory-augmented agent는 질의로 관련 항목을 한 번 골라 프롬프트에 넣은 뒤 답하는 경우가 많다. MRAgent는 이 방식을 수동 검색이라 부르고, 중간에 발견한 단서가 다음 검색 방향을 바꾸지 못하는 것이 약점이라고 본다.
제안 방법은 기억을 Cue–Tag–Content 그래프로 저장한다. Cue는 질문에서 출발하는 단서, Tag는 연결을 돕는 의미 표지, Content는 에피소드나 의미 기억이다. 답을 찾는 에이전트는 현재까지 얻은 증거를 상태로 들고 다니며 다음에 어느 연결을 볼지 선택한다. 즉 최종 답에 필요한 기억 집합을 한 번 꺼내는 대신, 여러 번 탐색해 재구성한다.
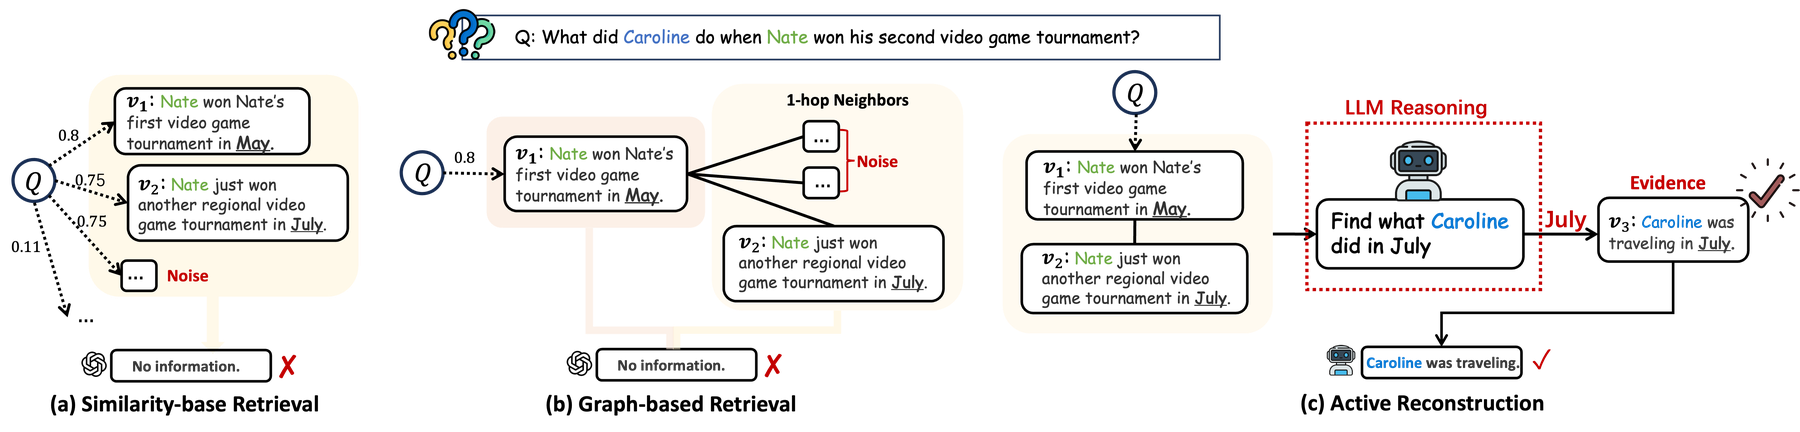
그림 1. Ji et al., Figure 2, PDF p. 2, arXiv:2606.06036v1 원도판. 수동 검색, 고정 그래프 확장, 중간 증거를 이용해 다음 행동을 바꾸는 능동 재구성을 예시로 대비한다. 삽화 속 ‘July’ 경로는 설명용 사례이지, 검색 오류율을 재는 실험은 아니다.
2. 한 번의 답변이 만들어지는 순서
먼저 대화 기록에서 관계와 사건을 추출해 그래프를 만든다. 질의가 들어오면 LLM이 초기 단서를 고르고 현재 노드에서 다음 연결을 탐색하거나, 찾은 사실로 새 단서를 만들거나, 필요 없는 길을 버린다. 누적 증거가 충분하다고 판단하면 선택한 내용만 최종 답변 모델에 보낸다. 예를 들어 ‘토너먼트’에서 ‘승리’ 태그로, 다시 당시의 에피소드와 상금 관련 의미 기억으로 가는 식이다.
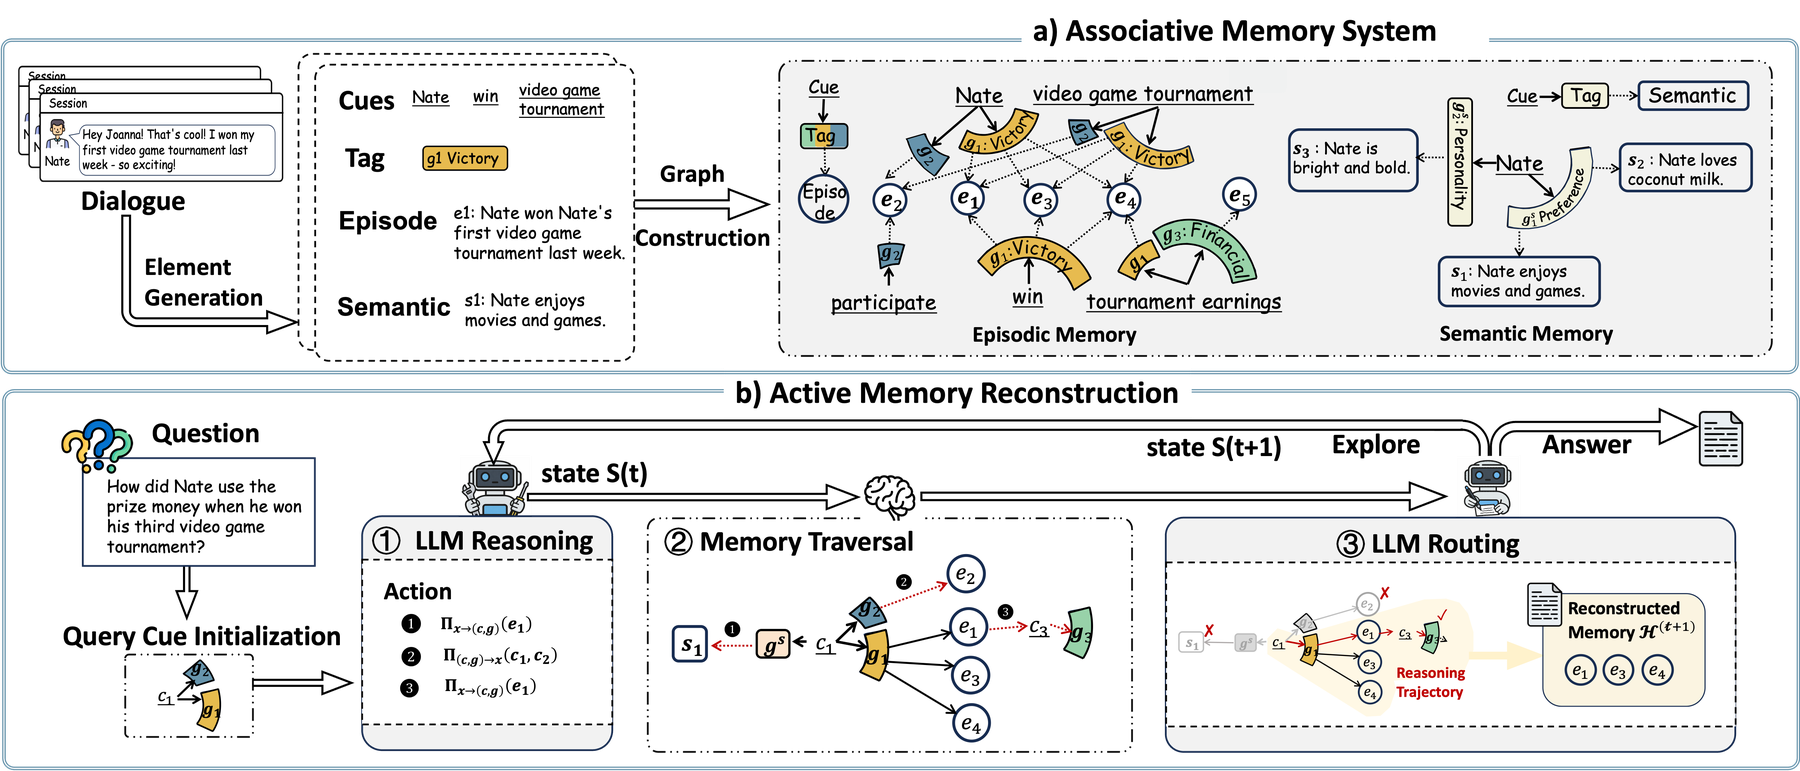
그림 2. Ji et al., Figure 4, PDF p. 4, arXiv:2606.06036v1 원도판. 대화에서 cue·tag·episode·semantic 요소를 만들고 LLM reasoning, traversal, routing을 거쳐 재구성 문맥을 누적하는 흐름을 보인다. Tag를 노드로 그린 도식은 접근 방식의 개념도이며, 노드 유형의 형식 정의와 동일한 실험 변수 표는 아니다.
그래프 자체보다 증거 조건부 정책이 중요하다. 같은 그래프라도 고정된 이웃을 넓히기만 하면 잡음이 쌓일 수 있다. MRAgent는 다음 행동을 선택해 가지를 자르고 기존 검색 결과에서 나온 단어를 다시 질의 제약으로 쓴다. 논문의 ‘능동이 수동보다 표현력이 크다’는 정리는 이처럼 정책이 중간 상태를 읽는다는 가정 아래의 구분이며, 모든 메모리 데이터 구조에서의 보편적 우위를 뜻하지 않는다.
3. 성능표가 말하는 범위
주요 평가는 LoCoMo와 LongMemEval이다. 논문은 다섯 수동 기준선보다 높은 결과를 보고하며, 초록의 최대 개선은 LoCoMo 기준 최대 23%다. LongMemEval 본문은 최강 기준선 대비 32% 상대 개선이라고 적는다. Table 2의 72.95와 54.92로 다시 계산하면 약 32.8%가 되지만, 이는 표에서 재계산한 값이지 본문에 인쇄된 수치가 아니다. 두 숫자는 벤치마크와 분모가 다르므로 한 줄의 ‘최대 향상’으로 섞으면 안 된다.
비용표는 LongMemEval에서 기억 구축과 검색을 합친 표본당 토큰·시간을 잰다. MRAgent는 118k tokens로, 표 안의 네 memory baseline 중 최소 245k보다 작다고 보고된다. 그러나 실행 시간은 586.11초로 Mem0의 533.29초보다 길다. 토큰 절감은 시간 절감과 같은 결론이 아니다. 표에는 성능표의 RAG도 없으므로 비용 비교는 표에 있는 네 memory baseline에만 한정된다. 이 값에는 기억 구축과 검색 비용이 모두 들어간다.
4. 절제가 증명한 것과 남은 것
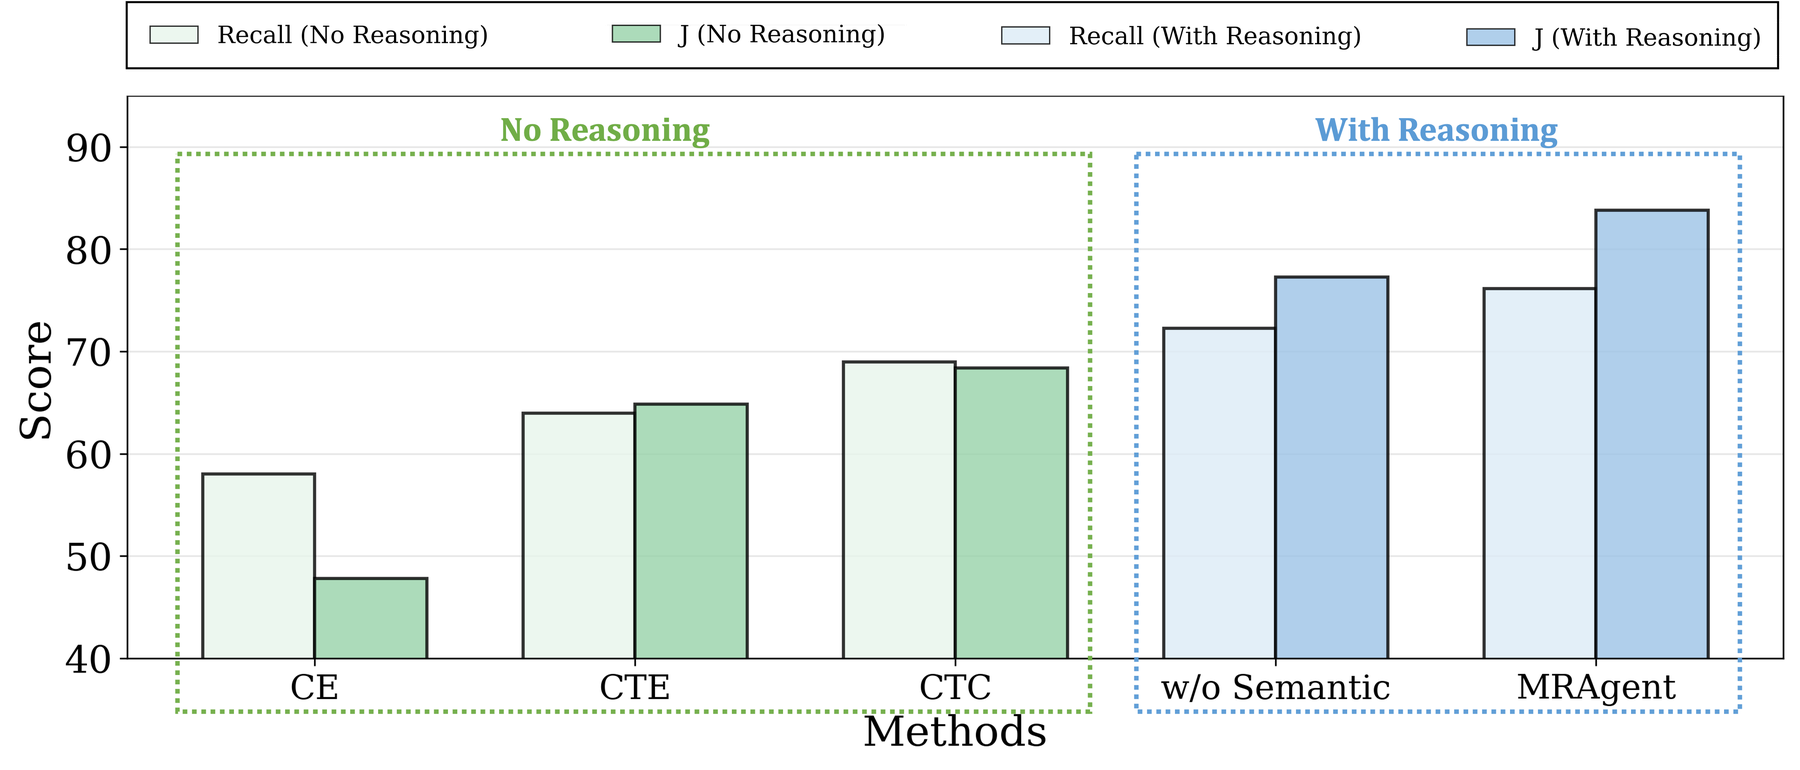
그림 3. Ji et al., Figure 5, PDF p. 8, arXiv:2606.06036v1 원도판. LoCoMo 다중 홉 질의와 Claude 백본에서 CE·CTE·CTC 구조 변형, reasoning 유무, semantic memory 유무를 비교한다. 막대 높이는 이 벤치마크·구성의 점수이며 일반적인 인과 기여도나 다른 백본의 효과 크기는 아니다.
그림 5에서는 추론이 없는 CE→CTE→CTC에서 Recall과 Judge 점수가 올라가고 추론을 켠 변형이 더 높다. 이는 구조화된 연결과 다단계 선택이 함께 유용하다는 증거다. 그러나 능동 정책만 제거하고 그래프·토큰 예산·추론 횟수는 동일하게 둔 절제는 없다. 부록의 상한은 최대 8 reasoning turns와 턴당 10 tool calls지만, 수동 기준선의 검색·top-k 예산은 맞춰 제시되지 않는다. 따라서 ‘그래프가 좋아서’인지 ‘더 많은 탐색을 해서’인지의 정확한 기여 비율은 표로 분해되지 않았다.
또한 그래프 생성 오류가 이후 순회를 어떻게 왜곡하는지, 단일 홉 질문에서 추가 탐색이 손해인지에 대한 세부 오류 분석은 제한적이다. 깊은 질의일수록 여러 턴이 도움이 될 수 있지만, 턴과 도구 호출을 늘리면 지연과 비용도 커진다. 그 균형은 업무의 응답 시간 제한에 따라 달라진다.
5. 사용 조건과 결론
이 방법은 시간·인물·사건을 이어야 하는 고객 지원 기록, 개인 비서 로그, 긴 시뮬레이션처럼 다중 홉 연결이 필요한 경우에 가장 자연스럽다. 반대로 필요한 사실이 한 문서에 있고 낮은 지연이 우선이면 단순 검색이 더 적합할 수 있다. 도입 시에는 추출한 그래프를 사용자가 감사할 수 있는지, 삭제·수정된 기억이 연결에서 완전히 빠지는지, 턴당 도구 호출 한도를 어떻게 둘지를 정해야 한다.
MRAgent는 두 장기 기억 벤치마크에서 능동 그래프 재구성이 수동 기준선보다 좋았음을 입증했다. 사람 기억처럼 ‘회상한다’는 비유나 모든 장기 에이전트에서의 비용 우위는 아직 실험의 범위를 넘는다.
6. 기억 그래프를 제품에 둘 때
대화 메모리는 틀릴 수 있고, 사용자가 삭제를 요구할 수도 있다. 따라서 노드만 지우는 것이 아니라 그 노드를 근거로 만든 태그·요약·연결·캐시가 이후 재구성에서 쓰이지 않는지 확인해야 한다. MRAgent의 그래프는 탐색 경로를 보여 줄 수 있어 감사에 유리하지만, 노드가 많아질수록 어떤 사실이 어느 답에 영향을 주었는지 추적하는 일도 복잡해진다.
실무 평가에서는 단일 사실 질의와 다중 홉 질의를 분리해 비용을 재야 한다. 다중 홉에서만 추가 턴이 실질적으로 회수를 높인다면, 쉬운 질문에도 같은 깊이를 강제할 이유는 없다. 턴 수, 턴당 병렬 호출, 최종 문맥 길이에 예산을 따로 두면 ‘더 오래 탐색해서 좋아진 것’과 ‘더 좋은 기억 구조’의 효과를 분리해 볼 수 있다.
그래프를 만드는 추출 단계도 독립적으로 재야 한다. 인물 이름이 바뀌거나 시간 표현이 모호할 때 cue와 tag가 잘못 연결되면, 이후의 능동 탐색은 더 정교하게 틀린 곳을 찾을 수 있다. 그래서 그래프 정확도, 질문별로 실제 사용한 경로, 최종 답의 근거 문장을 나란히 저장하는 것이 좋다. 벤치마크의 평균 점수만으로는 어느 단계에서 오류가 발생했는지 알기 어렵다.
개인화된 기억에서는 특히 관계의 민감도가 다르다. 약속 시간이나 선호처럼 사용자가 즉시 수정할 수 있는 사실과, 추론으로 만들어진 ‘성격’ 요약을 같은 확신도로 연결하면 안 된다. 각 노드의 원문 근거와 생성 시각, 사용자 수정 여부를 표기하고, 불확실한 요약은 다음 탐색의 약한 단서로만 다루는 정책이 필요하다. 능동 재구성은 더 많은 연결을 볼 수 있게 하지만, 더 많은 연결이 곧 더 신뢰할 만한 답을 뜻하지는 않는다.
이 구분은 기억 삭제와 정정 기능의 신뢰성에도 직접 영향을 준다.
References
Ji, S., Li, Y., & Hooi, B. (2026). Memory is reconstructed, not retrieved: Graph memory for LLM agents (arXiv:2606.06036v1). https://arxiv.org/abs/2606.06036