Planetary Prediction Engine: Autonomous Geospatial Prediction via Intelligent Data Selection and Foundation Model Embeddings
지리공간 예측의 병목을 자동화한다: Planetary Prediction Engine
PPE는 자연어 질문에서 데이터 선택, 파운데이션 임베딩 융합, 모델 탐색까지 잇는다. 여러 지리 과제의 높은 점수는 유망하지만, 서로 다른 기준선·공간 분할·불확실성을 한 성능 주장으로 묶어선 안 된다.
Paper: Evelyn Ma; Rama Kumar Pasumarthi; Kishwar Shafin; Mandar Sharma; Mimi Sun; Hamed Sadeghi; Dav M. Ebengo; Mbulayi Onesime; Rouslan Solomakhin; John Wamburu; William Ogallo; Aisha Walcott-Bryant; Sanxing Chen; Arbaaz Muslim; Yael Mayer; Ronald Ho; Roy Lee; Ruth Alcantara; Abdoulaye Diack; Monica Bharel; Lambert Rosique; Jeremy Amez-Droz; Christopher Haire; James Manyika; Yossi Matias; Niv Efron; Gautam Prasad; Shravya Shetty (2026). "Planetary Prediction Engine: Autonomous Geospatial Prediction via Intelligent Data Selection and Foundation Model Embeddings." arXiv:2608.26088v1. PDF
1. 이 논문이 자동화하려는 병목
식량안보·질병·재난위험처럼 지리공간 예측을 만들 때 어려운 일은 모델 하나를 고르는 데만 있지 않다. 자료 출처가 흩어져 있고, 행정구역·좌표계·시간 단위를 맞춰야 하며, 타깃을 사실상 다시 넣는 누출을 막아야 한다. Planetary Prediction Engine(PPE)은 자연어 과제를 받으면 이 준비부터 예측 모델과 보고서까지 이어 가려는 시스템이다.
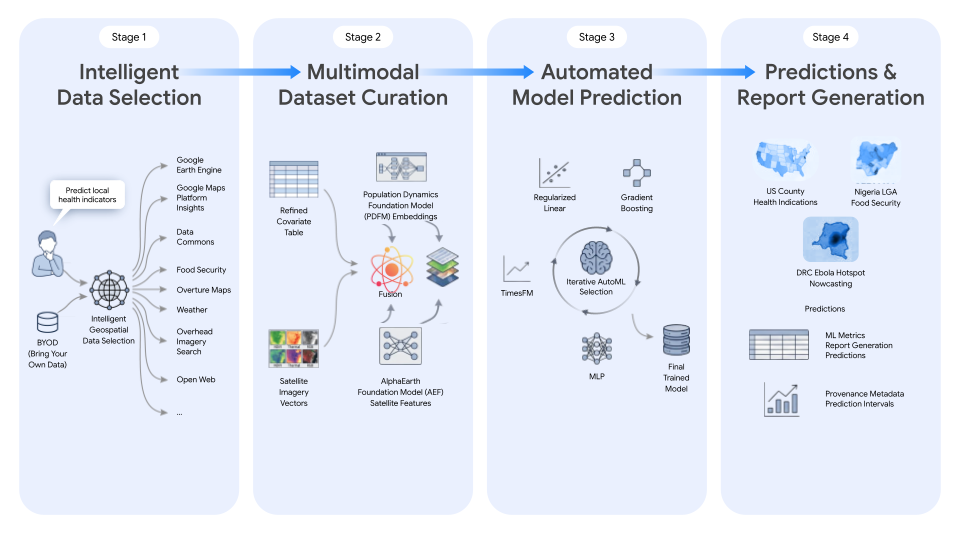
그림 1. Ma et al., Figure 1, PDF p. 2, arXiv:2608.26088v1 원도판. Intelligent Data Selection, Multimodal Dataset Curation, Automated Model Prediction, Report Generation의 네 단계를 보인다. 흐름도는 각 단계가 사람 개입 없이 모든 공개 웹 자료를 정확히 처리한다는 성능 증거는 아니다.
첫 단계는 Data Commons, Google Earth Engine, 열린 웹에서 후보 공변량을 찾고 출처·라이선스·시공간 적합성·신호 적합성·중복을 기준으로 고른다. 둘째는 표형 공변량에 Population Dynamics Foundation Model(PDFM)과 AlphaEarth Foundations 임베딩을 붙인다. 셋째는 정규화 선형 모델, 부스팅, XGBoost, MLP 계열을 과제에 맞게 탐색한다. 말하자면 “이 지역의 다음 지표를 예측해 달라”를 바로 예측기로 바꾸는 과정이다.
2. 자동 수집에서 가장 중요한 안전장치
공변량을 자동으로 찾는 시스템의 큰 위험은 타깃 또는 그 구성요소를 특징으로 다시 넣는 것이다. PPE의 Feature Gate는 타깃의 수학적 정의를 입력받았을 때, 직접 대리변수·같은 설문이나 대치 모형에서 나온 변수·인과적으로 하류인 변수·예측 시점 뒤의 변수를 제외한다고 설명한다. 예를 들어 주거비 부담을 예측할 때 그 계산에 들어가는 중위 임대료를 넣지 않는 식이다.
이 기준은 타당한 의도로 만들어졌지만 서술적 규칙을 해석하는 모델의 판단에 따라 작동한다. 어떤 점수에서 후보를 버리는지, 다섯 축을 어떻게 합산하는지, 인과 방향을 어떻게 검증하는지는 공개되지 않았다. 논문도 복잡한 양방향 관계의 인과 방향 필터 검증은 열린 문제라고 쓴다. 따라서 Feature Gate는 누출 방지의 선언이 아니라, 로그와 입력 타깃 정의까지 감사해야 할 검증 대상으로 봐야 한다.
3. 서로 다른 세 종류의 결과
PPE는 공간회귀, 다운스케일링, 나우캐스팅을 함께 시험한다. 미국 공간회귀에서 CDC 건강지표 21종 평균 R²는 76.8% 대 60.0%, FEMA 위험지수는 64.9% 대 약 60.0%다. SVI는 Table 7에서 full stack 66.2% 대 “Foundation Model Signals” 60.3% [55.2, 64.9]로 제시된다. 초록과 본문은 66.2% 대 58.6%라고도 적어 서로 맞지 않는다. 나이지리아 Table 3의 66.1% 대 31.5% R²는 ADM1 주 단위 목표의 30-state bootstrap 결과다. 각 숫자는 서로 다른 타깃·공간 단위·분할·기준선의 결과다.
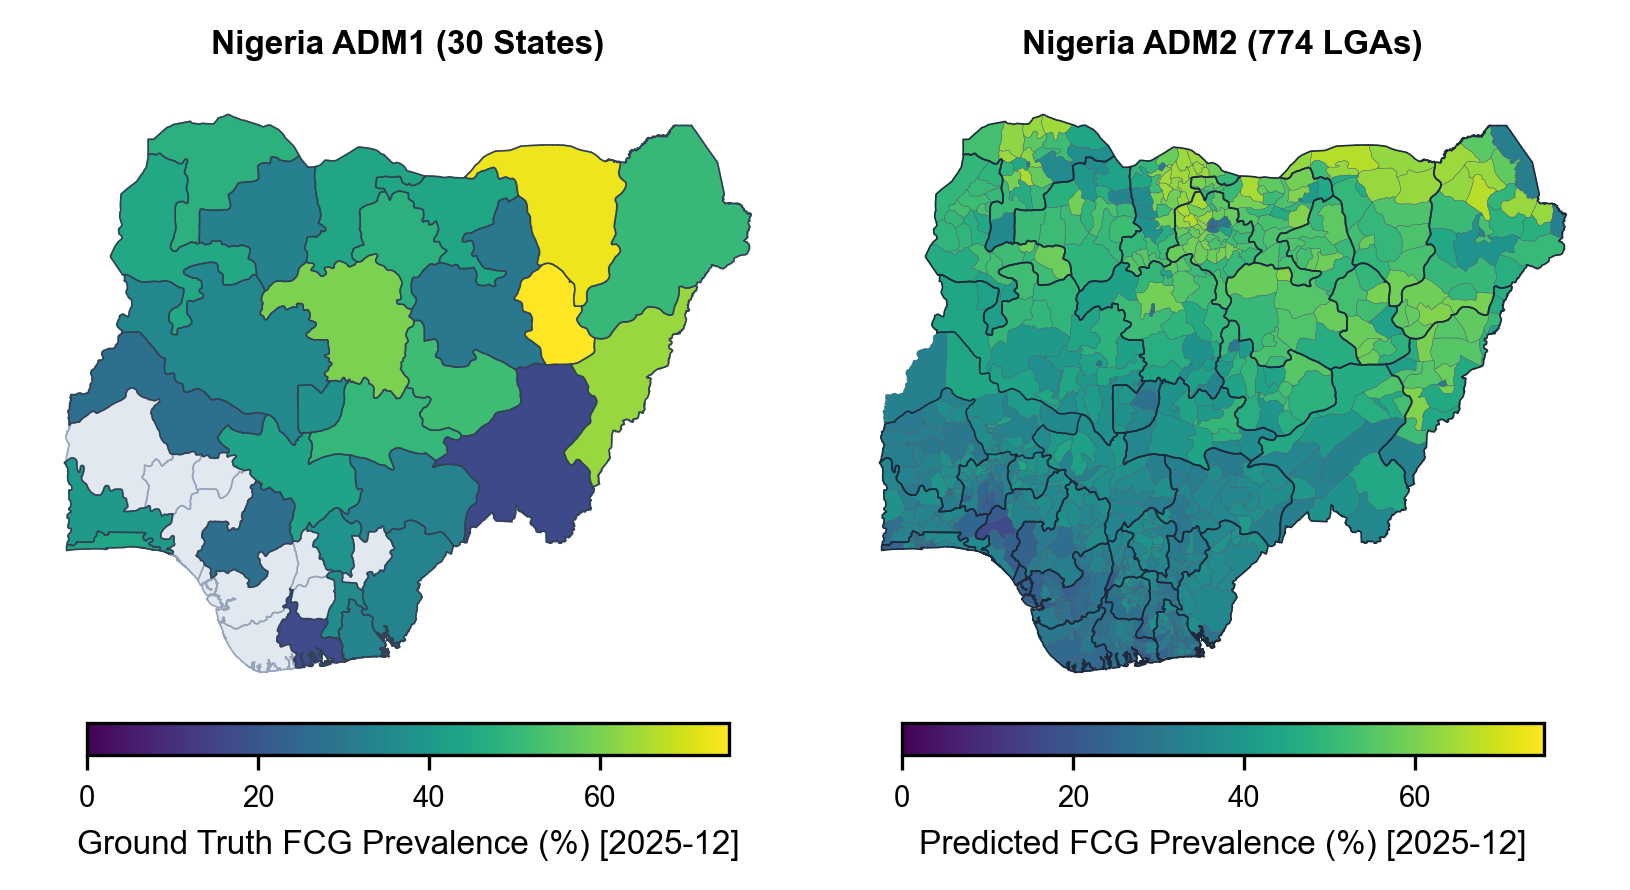
그림 2. Ma et al., Figure 3, PDF p. 8, arXiv:2608.26088v1 원도판. 30개 ADM1 주의 관측 FCG prevalence와 774개 ADM2 LGA의 2025년 12월 예측을 나란히 보인다. 오른쪽은 고해상도 추정치이지 LGA별 독립 관측의 지도는 아니다. 별도의 blind/out-of-fold ADM2 검증은 581-LGA 월별 패널에서 MAE 10.0% 대 13.6%로 보고되며, ADM1 R² 66.1%와 다른 지표·분모다.
Ebola 나우캐스팅에서는 다섯 주의 새로 침범된 18개 보건구역 중 15개를 상위 10개 후보에 넣어 Recall@10 83.3%를 보고한다. 신뢰구간은 [60.8, 94.2]이고, 비교 기준선의 점추정치 약 73%가 이 구간 안에 있다. 기준선의 신뢰구간이나 차이의 신뢰구간은 제시되지 않아, 이 다섯 주 조건에서 우위의 불확실성을 따로 판단하기 어렵다.
4. 성능표를 하나의 리더보드로 읽으면 안 되는 이유
초록의 큰 숫자들은 비교 대상을 다르게 둔다. CDC·FEMA는 같은 연구진의 선행 전문가 파이프라인, SVI는 내부 configuration 비교, 나이지리아는 보간 기준선이다. 특히 SVI의 58.6%는 초록·본문이 부르는 값이고 Table 7의 “Foundation Model Signals” 행은 60.3%다. 58.6%를 Table 7의 확정 기준선이나 깔끔한 단일 모달 절제라고 부를 수 없다. 그러므로 76.8%, 66.1%, 83.3%를 한 모델의 일관된 ‘SOTA’ 지표처럼 평균낼 수 없다.
분할도 중요하다. CDC와 FEMA는 인구조사 표준지역의 무작위 80:20 분할이다. 가까운 지역은 사회·환경 특성이 비슷하므로, 임의 분할 성능이 새로운 지역으로의 일반화를 그대로 말해 주지는 않는다. 논문은 공간 그룹 분할을 가능한 전략으로 설명하지만, 어느 벤치마크의 모델 선택에 사용했는지는 명확히 적지 않는다. 반면 나이지리아 평가는 30개 주를 이용한 leave-one-state-out 성격의 더 강한 지리 분리를 쓴다.
5. 실무에서 남는 가치와 조건
PPE는 데이터 선택·정렬·임베딩 융합·모델 탐색을 분리된 단계로 만들고 출처와 누출을 시스템 설계의 중심에 뒀다. 여기에 실용적 기여가 있다. 데이터가 희소한 국가나 여러 행정 단위를 오가는 과제에서는 이 파이프라인이 빠른 출발점이 될 수 있다. 하지만 최종 사용 전에는 자동 선택된 변수 목록, 각 자료의 시점·라이선스, 공간적으로 분리한 시험 성능, 그리고 타깃 정의가 Feature Gate에 실제로 전달됐는지를 검토해야 한다.
이 논문은 여러 제한된 평가에서 높은 예측 점수를 보고한다. 지구 규모의 범용 예측기, 원인 효과 판정기, 무인 자동 수집의 안전성까지 검증한 연구는 아니다. 특히 사람에게 영향을 주는 보건·취약성 예측에서는 불확실성과 지역 외 일반화 검증을 결과표와 동등하게 공개해야 한다.
6. 재현 가능한 지리 예측의 최소 기록
자동 시스템의 결과를 다시 확인하려면 최종 모델 파일만으로는 부족하다. 질문 원문, 타깃의 정의와 기준 시점, 후보 자료 목록과 접근일, 제외된 변수와 이유, 좌표계 변환, 공간 분할의 경계, 난수 시드가 함께 있어야 한다. 특히 PPE처럼 열린 웹과 여러 플랫폼을 연결하면 같은 이름의 변수라도 시점과 집계 단위가 달라질 수 있다.
정책 판단에 쓸 때는 지도 한 장보다 지역별 오차와 실패 사례를 먼저 봐야 한다. 나이지리아 그림의 ADM2 값은 ADM1 관측을 더 세밀한 단위로 풀어낸 예측이지, 모든 LGA에서 새 관측으로 검증한 값이 아니다. 따라서 현장 조사·배분 결정을 바꾸기 전에는 지역 밖 홀드아웃, 시간 밖 홀드아웃, 독립 관측 자료에서의 재검증을 추가해야 한다.
공변량의 출처는 결과와 함께 표기해야 한다. 기술 문서의 부록만으로는 부족하다. 한 지역에서 관측된 위성·인구·행정 자료가 다른 지역에는 없거나 갱신 주기가 다르면, 동일한 파이프라인도 다른 오류 구조를 낼 수 있다. PPE의 자동화는 이런 차이를 빠르게 드러내는 도구가 될 수 있지만, 데이터 공백을 모델의 확신으로 가려서는 안 된다. 예측 지도에는 값뿐 아니라 자료 커버리지와 적용 가능 범위를 함께 표시해야 한다.
자동 모델 선택도 사람이 결정을 넘겨받기 위한 근거를 남겨야 한다. 후보 모델별 검증 점수와 버려진 대안, 과적합 방어가 발동한 시점이 공개되어야 현장 전문가는 예측을 재현하거나 보수적으로 사용할 수 있다.
References
Ma, E., Pasumarthi, R. K., Shafin, K., et al. (2026). Planetary prediction engine: Autonomous geospatial prediction via intelligent data selection and foundation model embeddings (arXiv:2608.26088v1). https://arxiv.org/abs/2608.26088