LoongReflect: Boosting Long-Horizon Reflection in Search Agents via Global Perspective Distillation
긴 탐색에서 반성은 기억 제어다: LoongReflect 쉽게 읽기
LoongReflect는 긴 탐색 에이전트의 reflect·backtrack을 기억 제어 행동으로 보고 전역 관점을 가진 교사 증류와 결과 보상 학습을 결합한다. 보고된 QA 성능은 이 설정과 모델 범위에서만 해석해야 한다.
한눈에 보기
여러 문서를 찾아 답을 만들어야 하는 질문을 생각해 보자. 첫 검색이 틀린 인물을 가리키면 이후의 검색과 추론이 그 오류를 계속 참조할 수 있다. LoongReflect는 이 문제를 “모델이 생각을 더 길게 하게 하자”가 아니라 어떤 정보를 작업 기억에 남기고, 어느 분기를 되돌릴지 결정하는 제어 문제로 바꾼다.
논문의 핵심 행동은 reflect와 backtrack이다. reflect는 확인된 사실·부족한 근거·현재 분기의 위험을 작업 기억으로 압축한다. backtrack은 믿을 수 없는 분기 뒤쪽을 활성 문맥에서 제거하고 다음 시도에 쓸 짧은 교정 교훈은 남긴다. 이 둘은 검색이나 답변 자체가 아니라 궤적을 관리하는 행동이다.
| 항목 | LoongReflect의 선택 | 범위 |
|---|---|---|
| 문제 | 국소 반성의 가치는 최종 정답에서만 드러난다 | 긴 retrieval/추론 궤적 |
| 실행 | 되돌릴 수 있는 궤적 트리와 명시적 제어 행동 | controller가 상태를 유지해야 함 |
| 학습 | 전역 관점 교사 증류 + 결과 기반 GRPO | 논문이 쓴 QA·수학 벤치마크와 모델 설정 |
왜 결과 보상만으로는 부족한가
결과 보상은 마지막 답이 맞았는가를 알려 주지만, 12번째 단계에서 한 reflect가 도움이 됐는지는 늦고 희소하게 알려 준다. 반성에만 즉시 점수를 매기면 반대로 “반성처럼 보이는 문장”을 많이 만드는 보상 해킹이 생길 수 있다. 저자들이 말하는 local–global mismatch는 바로 이 틈이다. 현재 분기는 가까이 보이지만, 그 분기를 버릴 가치가 전체 탐색 끝에서야 판명된다.

그림 1. Zhang et al. (2026), arXiv:2608.11967v1, Figure 1, 물리 PDF p. 1의 원도판. 왼쪽은 계획·행동·관찰 사이에서 오류와 상태 오염이 누적되는 긴 실행을, 오른쪽은 결과 보상만의 희소성(C1)과 분기 국소 관점/최종 궤적 가치의 차이(C2)를 그린다. 볼 점은 반성의 대상이 답변 문장보다 활성 상태라는 점이다. 이 도식은 실패율의 측정치가 아니라 저자들의 문제 설정이다.
방법: 빠른 교정과 느린 결과 학습
실행 때 에이전트는 생각·검색·도구·답변에 더해 reflect·backtrack을 낸다. backtrack을 선택하면 불신 분기의 suffix를 지우고 checkpoint를 복원한 뒤, 교정 교훈을 기억에 쓴다. 실패 흔적을 전부 대화에 쌓지 않는 방식이다. 다만 checkpoint 선택, 메모리 압축, 되돌릴 수 없는 외부 도구 부작용의 처리까지 저절로 해결되지는 않는다.
학습은 두 채널이다. 빠른 채널은 정답 문자열을 가린 EMA teacher가 완전한 궤적 트리와 이진 종단 결과를 참고해 만든 반성 행동을 학생에게 증류한다. 이 전역 관점은 훈련 때만 쓰는 특권 정보이며, 배포 에이전트가 미래 답이나 종단 결과를 보는 기능은 아니다. 손실은 reflect/backtrack 토큰에 제한해, 일반 답변 문체를 교사가 통째로 베끼지 않게 했다. 느린 채널은 완성된 궤적의 최종 보상으로 GRPO를 수행한다. 저자들은 임시로 빠른 방향을 적용한 뒤 그 효과를 느린 결과로 평가하고 두 방향을 조정하는 look-ahead 조정을 사용한다.
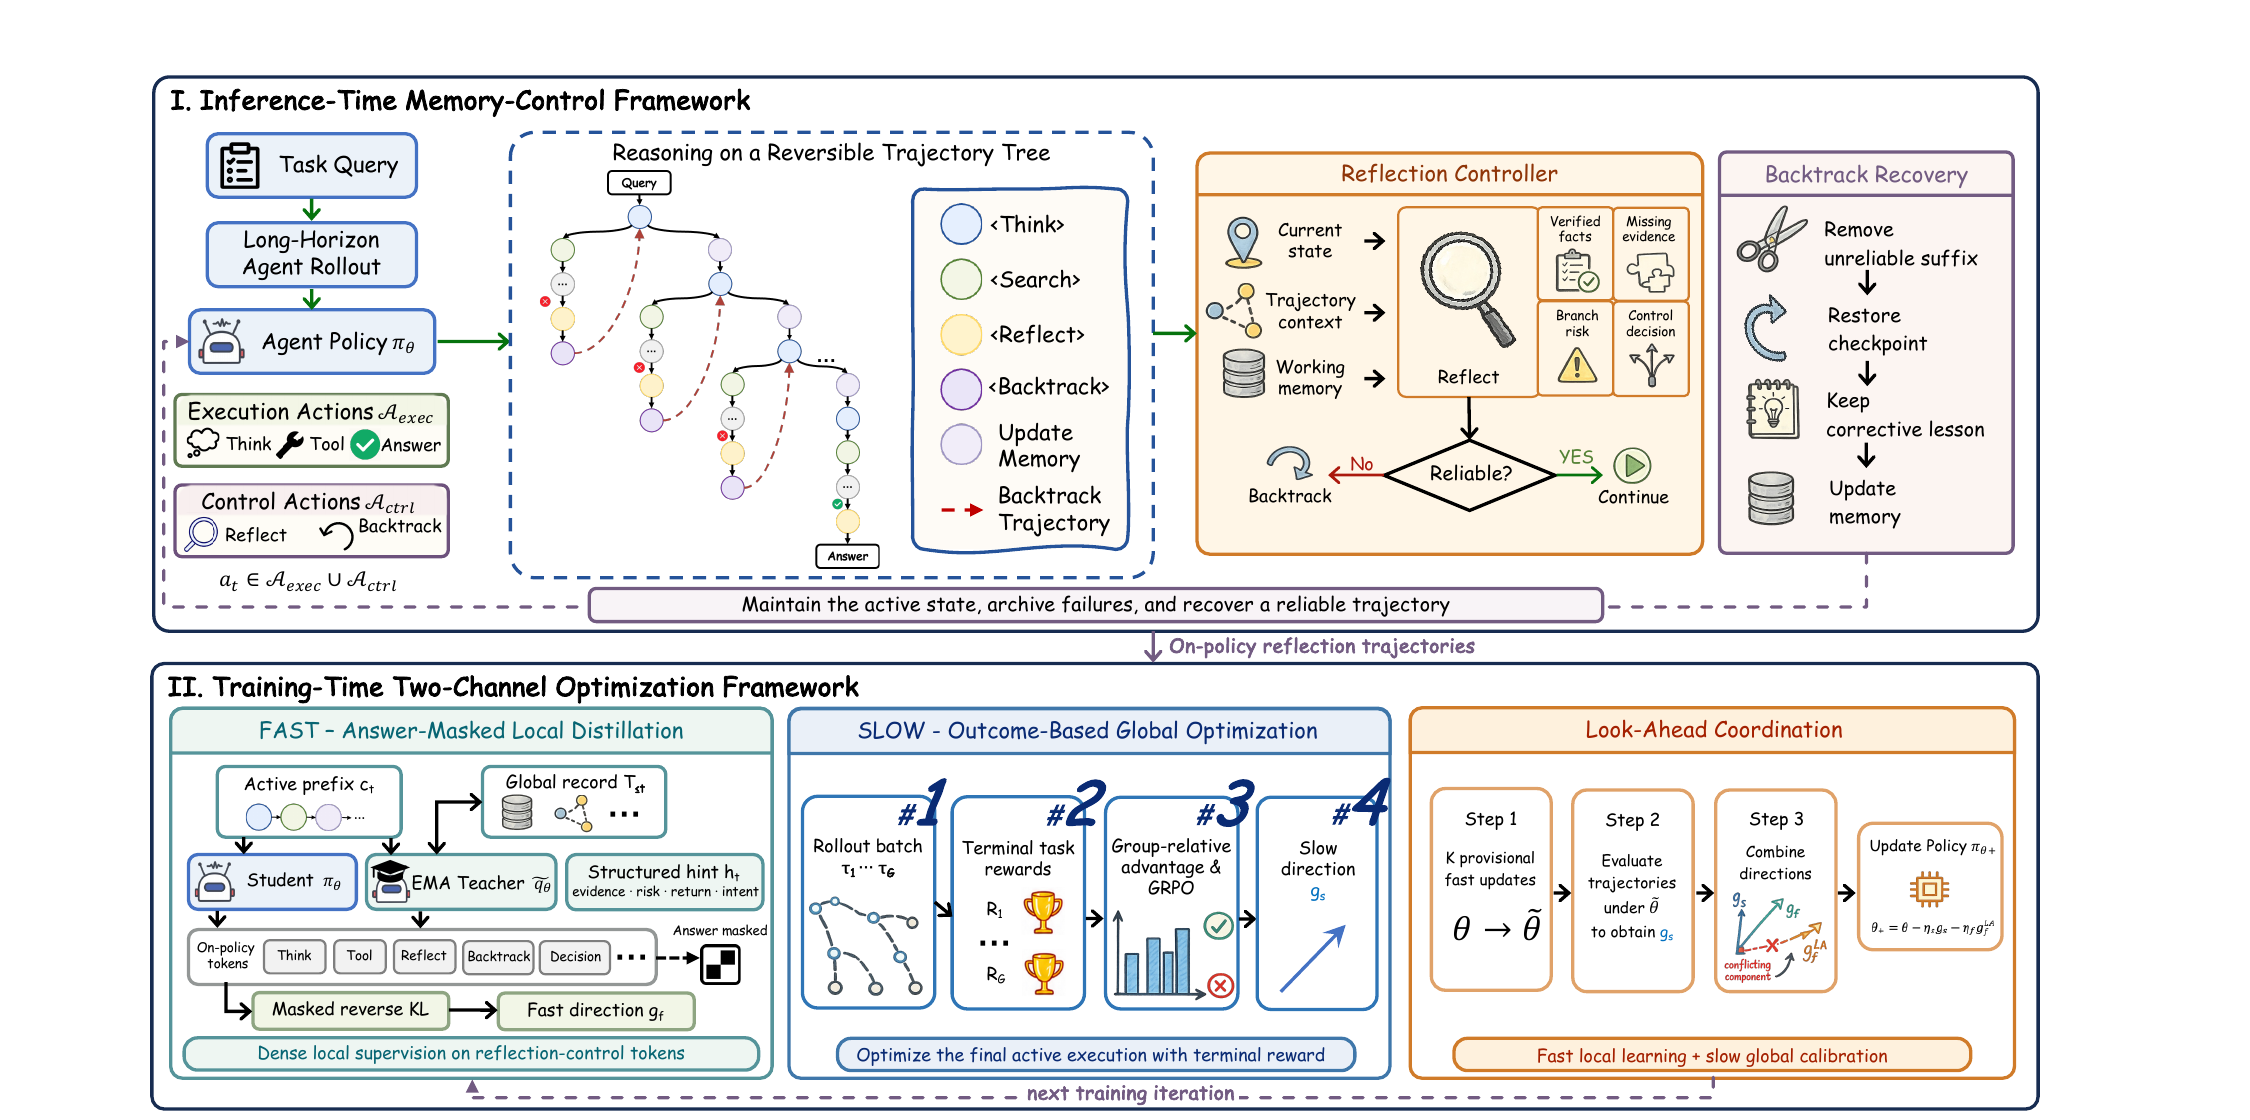
그림 2. Zhang et al. (2026), arXiv:2608.11967v1, Figure 2, 물리 PDF p. 4의 300 dpi 도식 전용 크롭. 위는 reversible trajectory tree, reflection controller, backtrack recovery의 실행 경로이고, 아래는 answer-masked local distillation(FAST), outcome-based GRPO(SLOW), look-ahead coordination의 학습 경로다. 원문 캡션은 이미지에서 제외하고 이 캡션으로 대체했다. 교사는 훈련 중 전체 트리와 이진 종단 결과를 보지만, 배포 때 에이전트가 미래 정답을 보는 뜻은 아니다.
보고된 결과는 무엇을 말하나
주 평가에서는 HotpotQA와 2WikiMultiHopQA로 학습하고, 두 데이터셋을 in-domain으로, Bamboogle·FRAMES·MuSiQue·NQ·TriviaQA를 out-of-domain으로 둔다. Table 1은 Qwen2.5 3B/7B 기반 여러 패러다임의 F1을 비교하며, LoongReflect가 표의 해당 조건에서 가장 높은 평균을 보고한다. 별도 ablation 표에서 전체 모델의 평균 F1은 46.15이고 reflect를 없앤 구성은 30.84, backtrack을 없앤 구성은 33.09로 보고된다. 두 제어 행동은 이 학습·평가 설정에서 중요했다. 모든 에이전트에서 같은 차이가 난다는 증명은 아니다.
수학으로의 전이도 MATH와 GSM8K에서 평가하지만, 검색 QA에서 배운 기억 제어가 모든 도구 사용 환경으로 일반화된다는 주장과는 거리가 있다. 학습 궤적은 HotpotQA·2Wiki에서 걸러낸 자료, Qwen3-32B 교사가 참조 답과 대조해 실패를 개입시킨 과정, 그리고 Search-R1이 실패한 사례를 포함한 600개의 retained SFT 궤적에 의존한다. 그러므로 표의 전체 비교 격차를 두 채널 학습만의 효과로 귀속할 수 없다. 다른 검색 API, 문서 품질, 비용 제한, 비가역 행동에서는 새 검증이 필요하다.
적용 전 확인할 것
이 방법은 “정답 전 추론을 많이 출력하라”는 기법이 아니다. 신뢰할 수 있는 checkpoint, 분기 폐기 규칙, 사실·불확실성·교정 교훈을 구분하는 메모리 형식이 있어야 한다. 특히 외부에 메일을 보내거나 데이터를 바꾸는 행동은 backtrack으로 되돌릴 수 없으므로, 실행 로그와 보상 설계만으로 안전성을 얻을 수 없다. LoongReflect는 긴 탐색에서 반성을 가역적 상태 관리로 정의한다. 문장 생성으로만 보지 않는다는 점이 설득력 있다.
References
Zhang, Z., Jiang, X., Yang, Z., Xu, W., Qiu, G., Chu, X., Zhao, J., & Wang, Y. (2026). LoongReflect: Boosting long-horizon reflection in search agents via global perspective distillation (arXiv:2608.11967v1). arXiv. https://arxiv.org/abs/2608.11967
상세 검토: /blog/loongreflect-long-horizon-reflection-search-agents?view=deep