SEED: Self-Evolving On-Policy Distillation for Agentic Reinforcement Learning
끝난 뒤의 반성을 다음 행동에 쓰기: SEED
SEED는 긴 에이전트 작업이 끝난 뒤 궤적을 자연어 hindsight skill로 정리하고, 그 skill이 지지한 기존 행동 token을 더 강하게 학습한다. ALFWorld·Search-based QA·WebShop의 GRPO 비교 개선은 이 논문의 정해진 모델·예산·환경 조건에서 읽어야 한다.
Paper: Jinyang Wu; Shuo Yang; Zhengxi Lu; Fan Zhang; Yuhao Shen; Lang Feng; Haoran Luo; Zheng Lian; Shuai Zhang; Zhengqi Wen; Jianhua Tao (2026). "SEED: Self-Evolving On-Policy Distillation for Agentic Reinforcement Learning." arXiv:2607.14777v1. PDF · arXiv
1. 마지막 점수만으로는 무엇이 좋았는지 알기 어렵다
웹에서 물건을 찾거나 텍스트 게임을 푸는 에이전트는 여러 번 관찰하고 행동한 뒤에야 성공·실패 점수를 받는다. 성공한 궤적에도 우회 행동은 섞일 수 있고, 실패한 궤적에도 다음번에 살릴 판단은 있다. 그러나 outcome-based RL은 보통 마지막 보상을 궤적 전체 행동에 넓게 되돌려 준다. 그래서 어느 검색어, 어느 확인 행동, 어느 도구 호출이 실제로 도움이 됐는지 구분하기 어렵다.
SEED의 출발점은 간단하다. 작업이 끝난 뒤에는 진행 중에는 몰랐던 힌트를 읽을 수 있다. 완료된 궤적을 보고 “이 관찰을 먼저 확인했어야 한다” 또는 “이 실패 경로는 피하라”는 재사용 가능한 문장, 즉 hindsight skill을 만들고 학습 신호로 쓴다. skill은 학습 중에만 쓰는 사후 설명이다. 배포 중 모델에게 주는 장기 메모는 아니다.
2. 두 단계: 궤적을 설명하게 한 뒤, 설명을 행동에 되돌린다
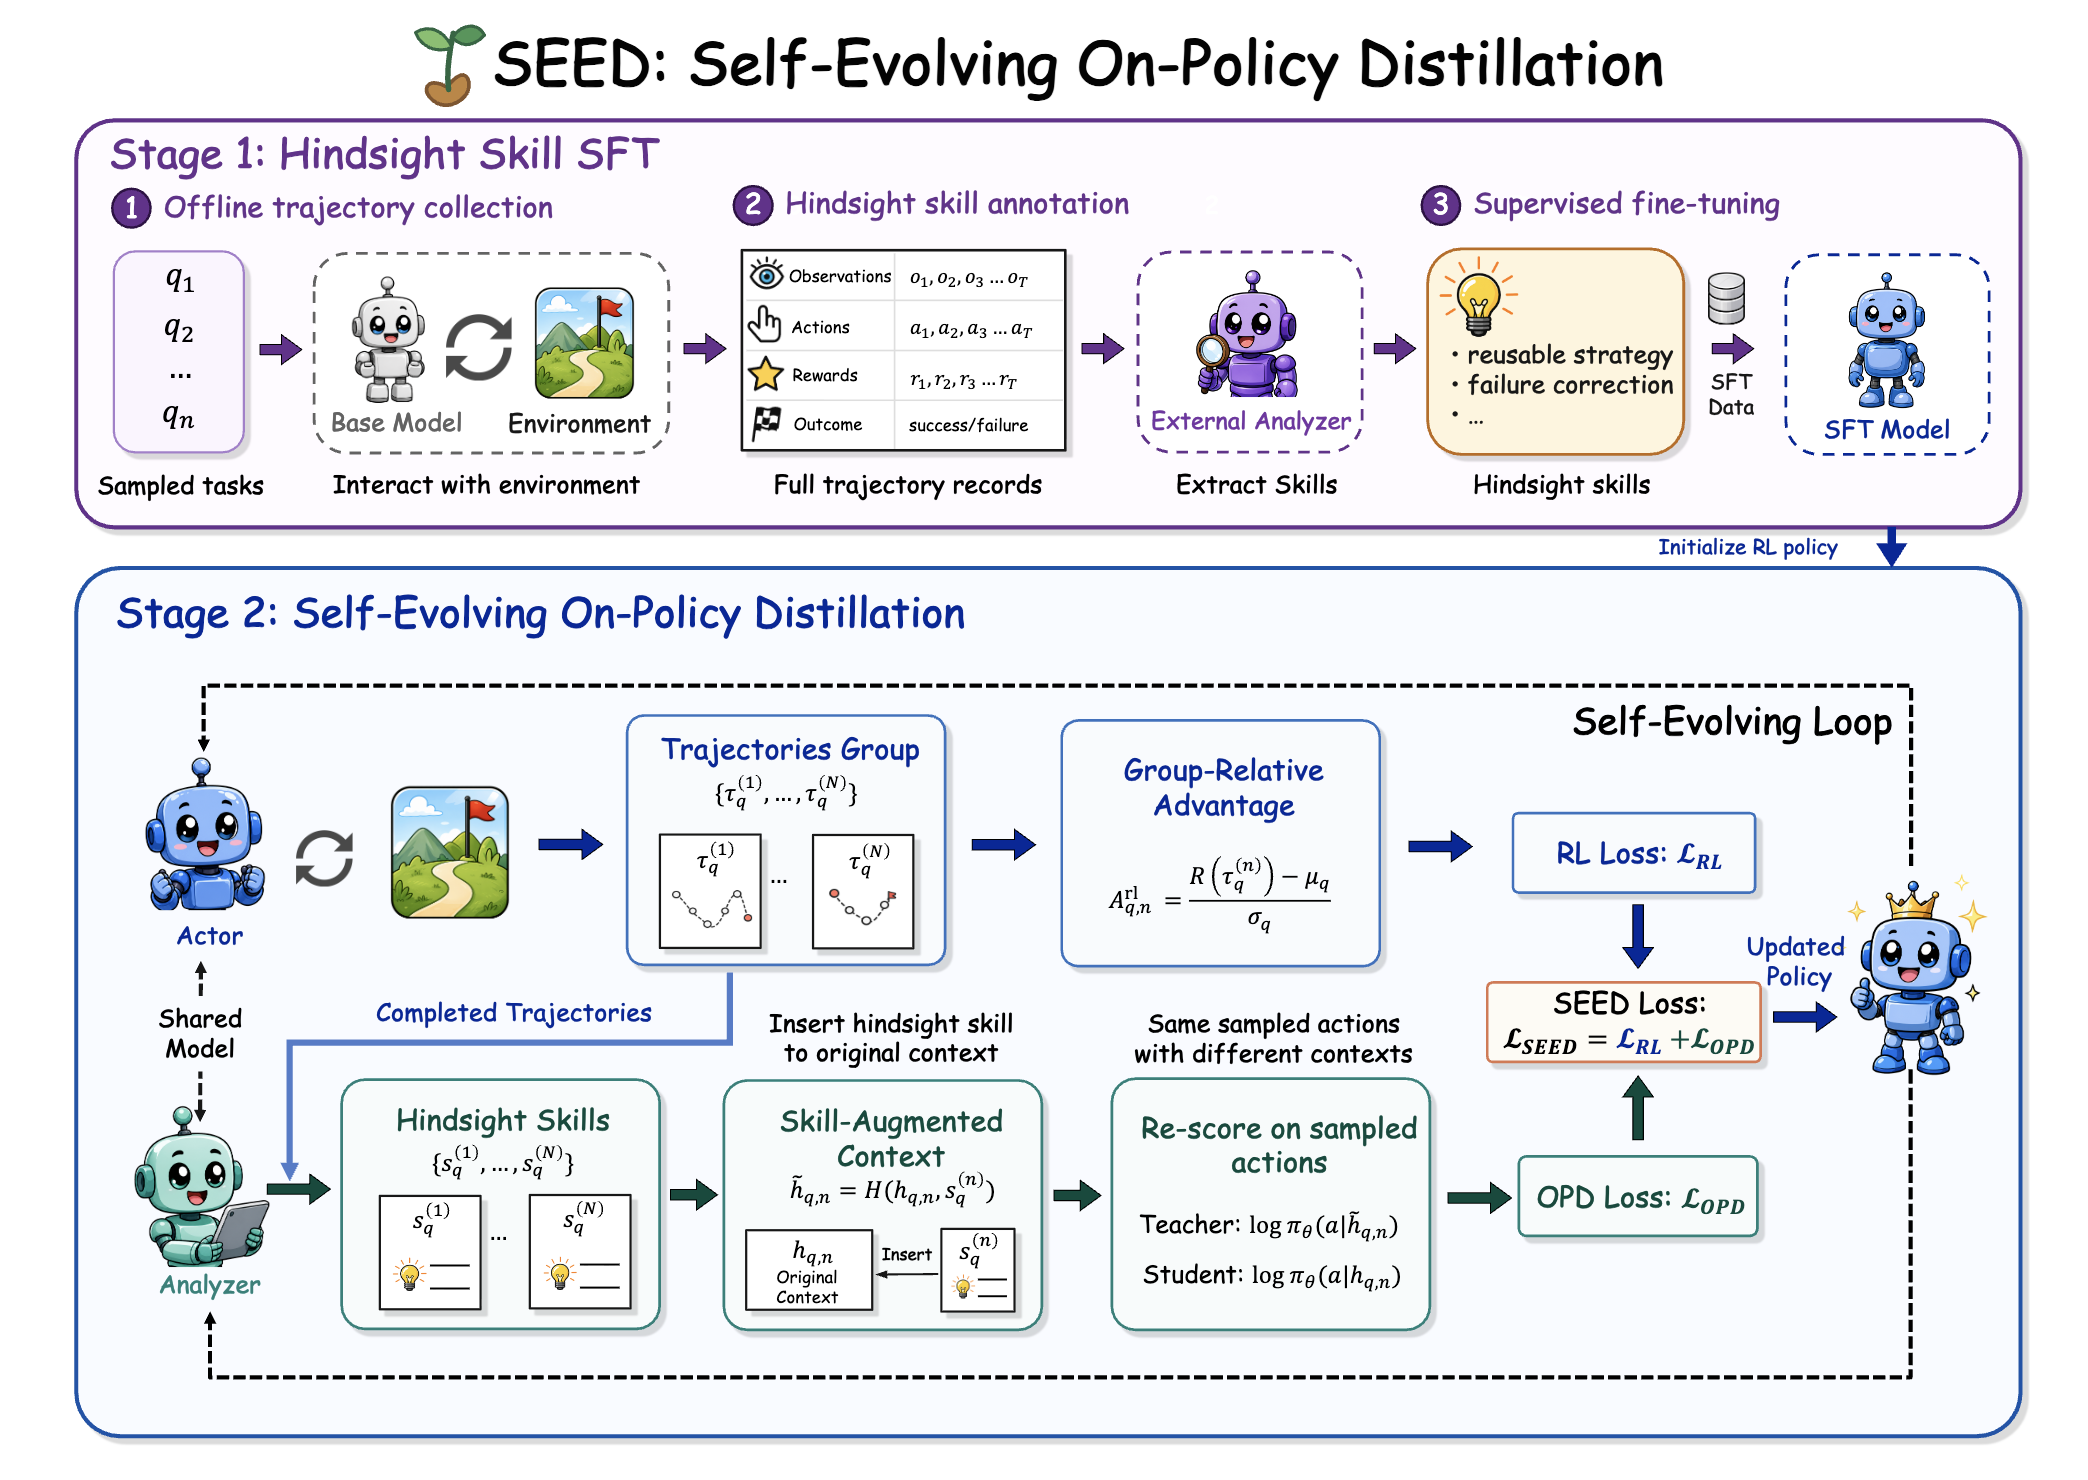
그림 1. Wu et al., 「SEED: Self-Evolving On-Policy Distillation for Agentic Reinforcement Learning」, arXiv:2607.14777v1 Figure 2, PDF 4쪽. 위는 외부 분석기가 완료 궤적에서 hindsight skill을 만들고 SFT하는 단계, 아래는 같은 정책이 행동 생성과 분석을 맡는 단계다. 저자 제공 그림을 그대로 사용했다.
첫 단계에서는 base model이 만든 완료 궤적에 외부 GLM-5.2 분석기가 skill을 붙이고 그 궤적–skill 쌍으로 모델을 3 epoch supervised fine-tuning(SFT)한다. 논문 설정은 benchmark마다 180개 task에서 8개 rollout씩, 곧 1,440개 완료 궤적이다. 이 단계의 목적은 정답 행동을 바로 가르치는 것이 아니라, 모델이 자기 경험을 읽고 반성문을 쓸 능력을 갖게 하는 것이다.
둘째 단계에서는 직전 checkpoint 하나가 두 역할을 동시에 맡는다. actor는 환경에서 새 on-policy 궤적을 만들고, analyzer는 끝난 궤적에서 skill을 생성한다. Action token은 에이전트가 이미 뽑은 행동 문장의 토큰, 곧 두 문맥에서 확률을 다시 계산할 동일한 학습 단위다. 그 뒤 학습 중인 정책은 이미 뽑힌 같은 action token을 두 번 채점한다. 하나는 원래 history, 다른 하나는 hindsight skill을 넣은 history다. skill 문맥에서 확률이 더 높아진 token에는 더 큰 보조 학습 가중치를 주고, outcome reward에서 온 GRPO loss와 함께 최적화한다. 새 행동을 skill 문맥에서 다시 샘플링하는 방식은 아니다.
중요한 구현상 경계도 있다. 논문에서 ‘teacher’라 부른 값은 별도의 큰 모델이 아니라 같은 현재 정책을 다른 문맥에 넣어 다시 계산한 값이다. skill 쪽과 가중치에는 gradient를 흘리지 않고, 보통 문맥의 action 확률만 올린다. 학습이 끝나면 analyzer, skill bank, retrieval, skill-augmented prompt를 모두 빼고 일반 policy만 배포한다.
3. 무엇을 더 강하게 배우게 하나
Credit assignment는 최종 성공·실패를 여러 중간 선택에 어떻게 돌릴지 정하는 일이다. SEED는 “이 궤적은 성공했으니 전 token을 똑같이 강화하자”는 방식을 추가하지 않는다. hindsight skill이 어떤 token을 지지하는 정도를 0과 1 사이 gate로 만들고, 지지도가 큰 sampled token의 log-probability를 더 세게 높인다. terminal reward는 궤적이 전반적으로 좋았는지 알려 주고, OPD는 그 안에서 어떤 행동 조각을 더 보존할지 세분화한다.
이 구분에는 장점과 전제가 함께 있다. skill이 실제로 좋은 행동을 더 지지해야 신호의 방향도 좋다. 최신 checkpoint가 자기 실패를 잘 설명한다는 보장, 또는 skill이 참이라는 보장은 없다. 논문의 이론은 현재 policy가 방문한 문맥에서 학습한다는 점, reward가 동률이어도 token별 gate가 다르면 보조 gradient가 남는다는 점을 설명한다. return이 자동으로 증가한다는 정리는 아니다.
4. 저자 보고 결과: GRPO보다 높았지만 모든 칸의 1위는 아니다
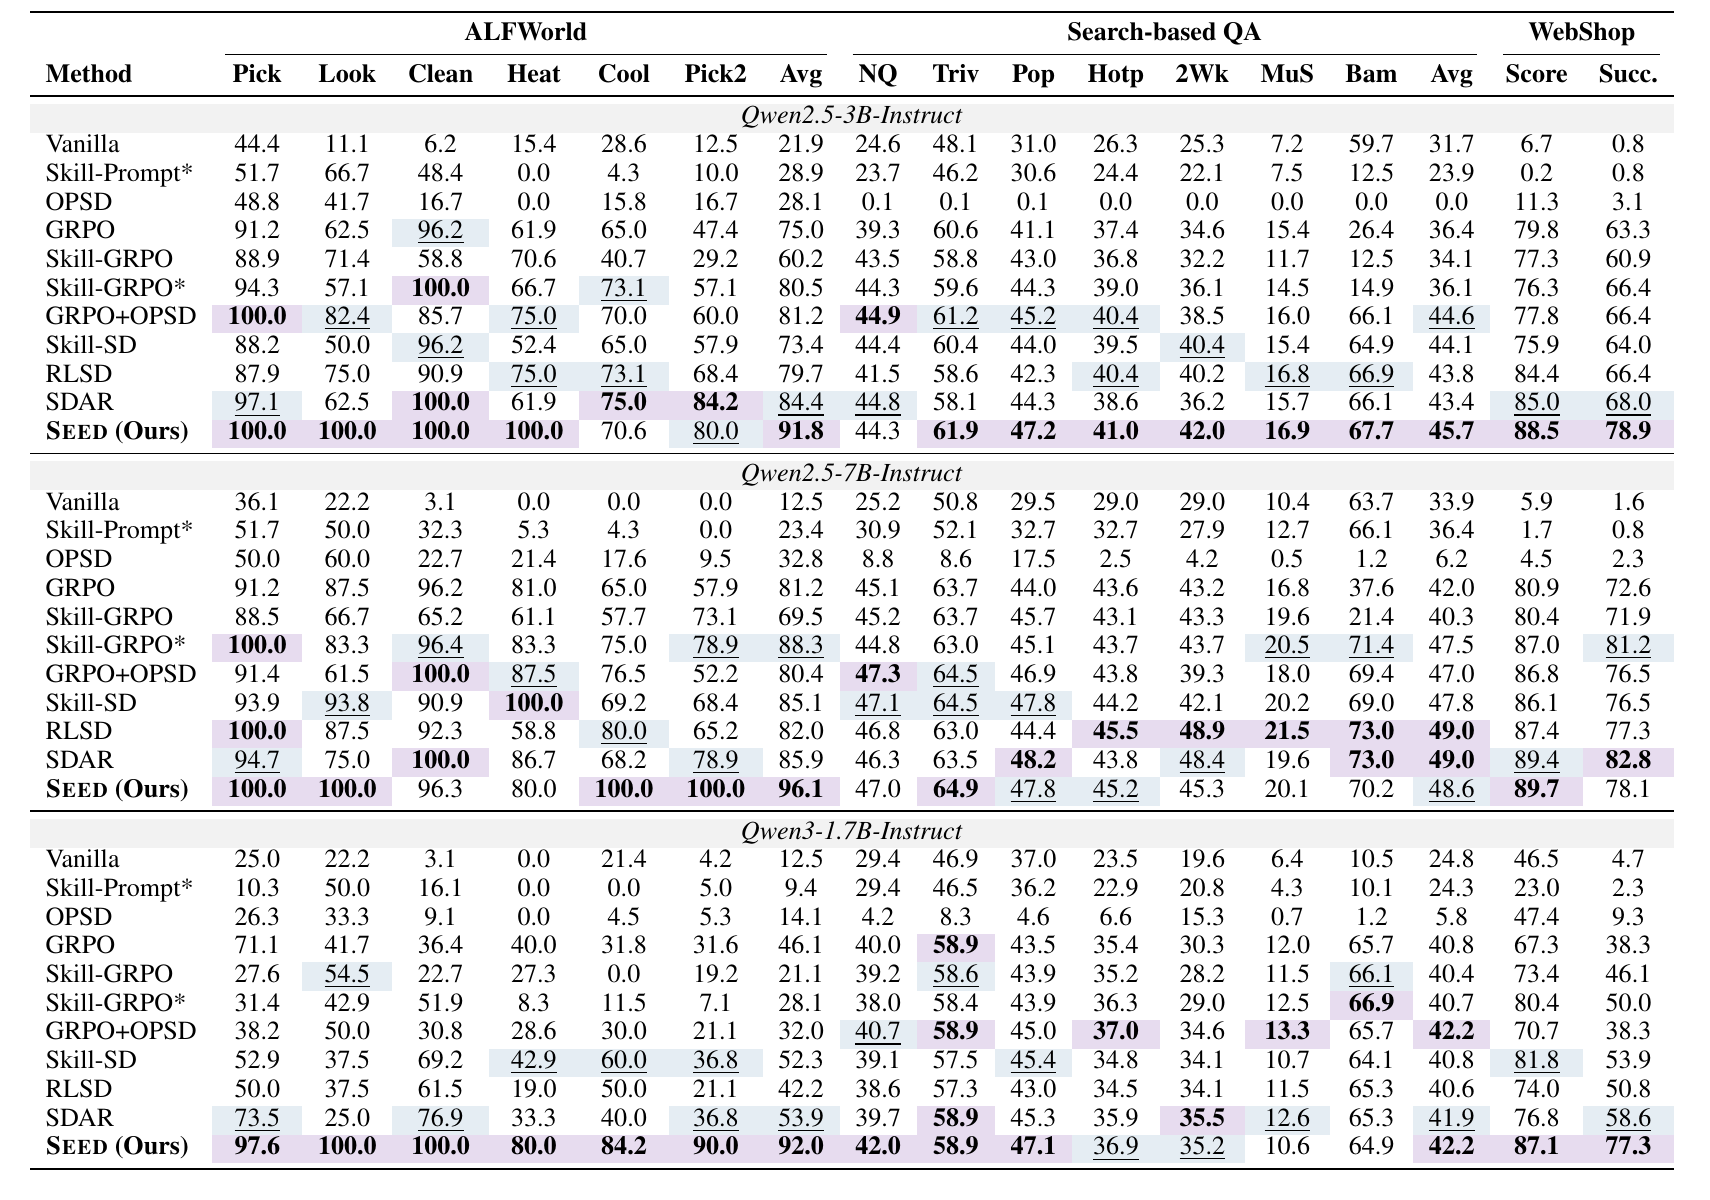
그림 2. Wu et al., 「SEED」, arXiv:2607.14777v1 Table 1, PDF 9쪽과 대조한 저자 제공 결과 그림. ALFWorld는 성공률, Search-based QA는 정확도, WebShop은 task-completion score와 success rate다. 색과 굵은 표시는 이 표 안의 비교용이다.
세 text backbone에서 SEED는 GRPO의 집계 점수보다 높게 보고됐다. 예를 들어 Qwen2.5-3B-Instruct에서 ALFWorld 평균은 75.0에서 91.8, Search-based QA 평균은 36.4에서 45.7, WebShop success는 63.3에서 78.9가 됐다(Table 1). 이 표의 조건은 같은 backbone, rollout budget, training schedule로 재현한 post-training baseline들이다. 또한 ALFWorld에서는 학습 data 60%만 쓴 SEED가 80.7로 full-data GRPO의 75.0을 넘었다(Table 6). 이는 Stage 2에서 수집한 데이터 효율 결과다.
다만 ‘항상 최고’라는 표현은 표와 맞지 않는다. Qwen2.5-3B Search 평균은 Skill-SD 47.8보다 SEED 45.7이 낮고, Qwen2.5-7B Search 평균은 RLSD·SDAR 49.0보다 SEED 48.6이 낮다. 같은 7B의 WebShop success도 SDAR 82.8, SEED 78.1이다. 논문은 GRPO와의 일관된 개선을 보였지만, 모든 baseline·환경·metric에서 지배했다는 증거는 아니다.
5. 적용할 때 확인할 조건
SEED를 실험에 쓴다면 “긴 작업의 결과 보상만으로 중간 credit assignment가 부족한가?”부터 확인할 만하다. 그리고 hindsight skill이 실제로 유용한 행동을 지지하는지, 실패 설명이 반복적으로 왜곡되지 않는지, 일반 history만으로도 결과가 유지되는지를 따로 검사해야 한다. 논문 설정은 rollout group 8, 150 policy update, 8장의 NVIDIA A800 80GB를 썼다. 학습 중에는 trajectory 분석과 두 문맥 재채점이 추가된다.
따라서 sample efficiency와 end-to-end compute efficiency는 다르다. 60% data 결과는 유망하지만, Stage 1의 외부 GLM-5.2 annotation·SFT와 Stage 2의 분석·paired scoring까지 합친 wall-clock, token, 비용 비교는 논문에 없다. 또 ALFWorld unseen 평균은 70.9에서 86.2로 올랐지만 여섯 family 중 Clean은 82.4에서 79.5로 내려갔다(Table 7). 이 결과는 특정 unseen split과 Qwen2.5-3B 조건의 일반화 근거이지, 모든 agent environment의 보장은 아니다.
References
Wu, J., Yang, S., Lu, Z., Zhang, F., Shen, Y., Feng, L., Luo, H., Lian, Z., Zhang, S., Wen, Z., & Tao, J. (2026). SEED: Self-evolving on-policy distillation for agentic reinforcement learning (arXiv:2607.14777v1). arXiv. https://arxiv.org/abs/2607.14777