Where Reasoning Matters: Rethinking Latent Reasoning in Semantic ID-based Generative Recommendation
IBA는 시맨틱 ID의 위치별 정보이득과 관측된 정제 이득을 이용해 잠재 추론 스텝을 배분한다. 이는 정확도 자체가 아니라 손실 감소를 활용한 대리 목표다.
Paper: Shangxin Yang; Min Gao; Zongwei Wang; Junliang Yu (2026). "Where Reasoning Matters: Rethinking Latent Reasoning in Semantic ID-based Generative Recommendation". arXiv:2607.12425v1 PDF.
한눈에 보기
생성 추천은 아이템을 번호 하나로 고르는 대신, 아이템을 나타내는 짧은 시맨틱 ID 토큰열을 왼쪽에서 오른쪽으로 생성할 수 있다. 앞 토큰이 정해지면 가능한 아이템 후보가 크게 줄고, 뒤 토큰은 이미 좁아진 후보를 세밀하게 가르는 역할을 한다. 이 논문은 모든 위치에 똑같은 잠재 추론 단계를 주는 관행에 질문을 던진다. 같은 계산 예산이라면 후보를 크게 줄이는 앞쪽에 더 쓰는 편이 낫지 않을까?
저자들은 위치별 정보이득을 이용해 이 직관을 수치화하고 Information-Gain Budget Allocation(IBA)으로 사용자·토큰 위치마다 다른 refinement step 수를 고른다. 여기서 잠재 추론은 더 긴 자연어 chain-of-thought가 아니라, 토큰을 내기 전 decoder의 hidden state를 반복 정제하는 계산이다. 그러므로 ‘생각을 더 길게 출력한다’는 접근과는 구분해야 한다.
왜 토큰 위치가 중요한가
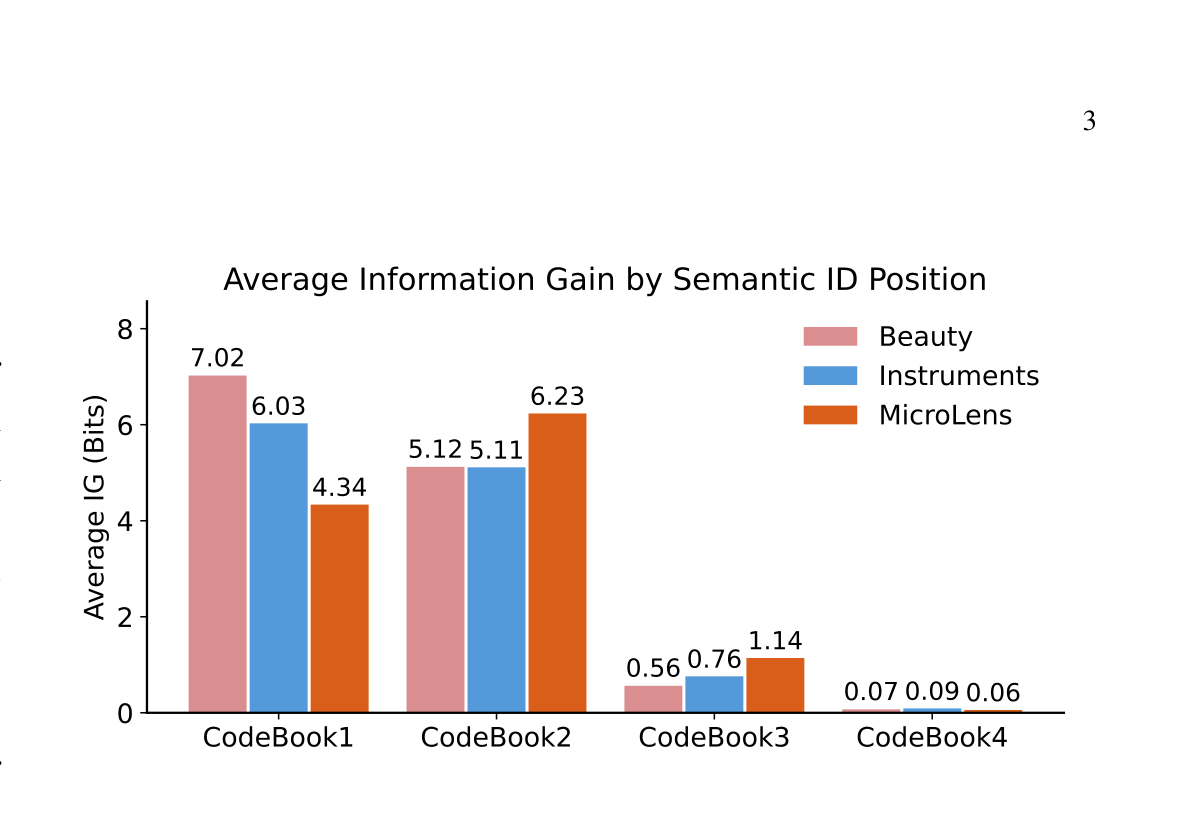
그림 1. Yang et al. (2026), Figure 2, arXiv:2607.12425v1 PDF p. 3의 원도판을 인용. Beauty·Instruments·MicroLens에서 ID 위치별 평균 정보이득을 비교한다. 앞쪽 위치가 대체로 더 큰 후보 불확실성 감소와 연결된다는 저자 관찰을 보여 주지만, 모든 데이터셋·모든 사용자에서 동일한 순서를 보장하는 그림은 아니다.
예를 들어 세 자리 코드의 첫 자리가 ‘가전’과 ‘도서’를 가르고, 둘째 자리가 세부 군을, 마지막 자리가 비슷한 상품을 구별한다고 하자. 첫 자리 오류는 이후 선택 공간 전체를 바꾸지만 마지막 자리 오류는 이미 선택된 가지 안에서 일어난다. IBA는 이 차이를 전역적인 위치 prior로 쓴다. 다만 정보이득이 높다고 해서 모델이 실제로 그 위치에서 항상 큰 정확도 향상을 얻는 것은 아니다. 어려운 사용자 이력, 데이터 분포, 현 단계의 hidden state가 함께 작용한다.
두 단계로 배분을 학습한다
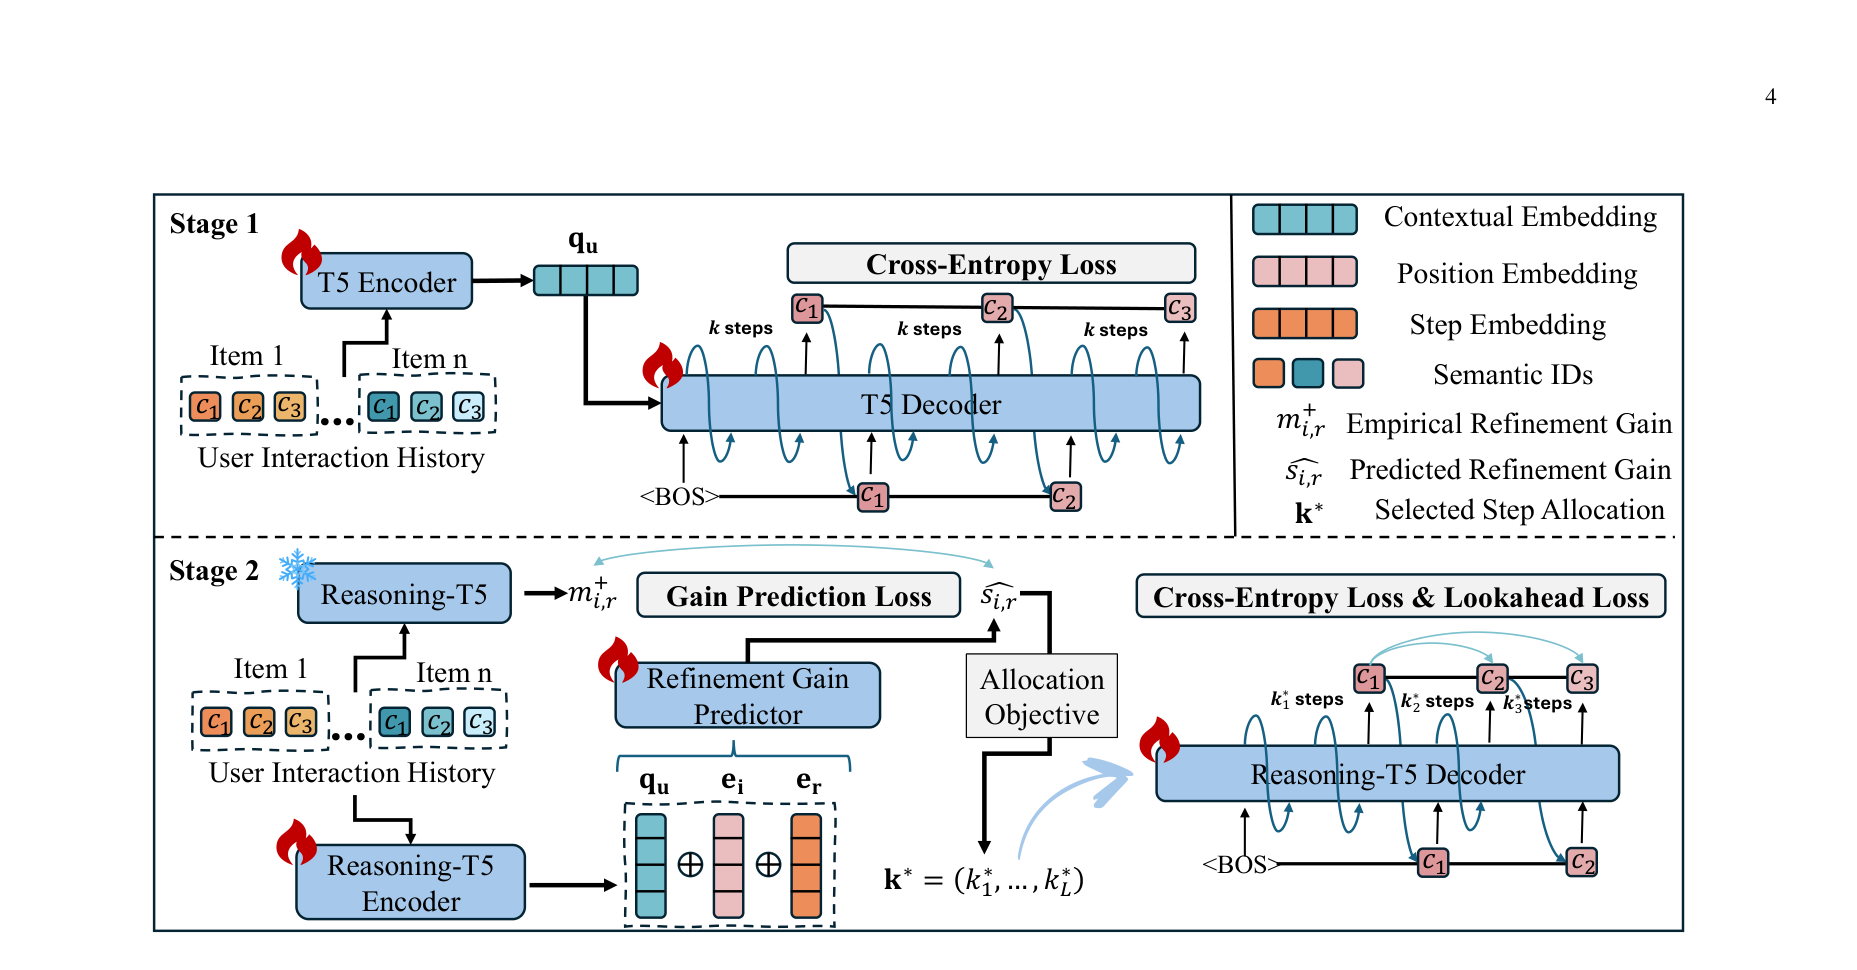
그림 2. Yang et al. (2026), Figure 3, arXiv:2607.12425v1 PDF p. 4의 원도판을 인용. Stage 1은 균등 정제에서 스텝별 손실 감소를 관측하고, Stage 2는 gain predictor와 제약식 기반 할당으로 사용자별 step 열을 골라 재학습한다. 불꽃 표시는 학습되는 모듈이다.
Stage 1에서 모델은 여러 정제 스텝을 균등하게 적용하며, 각 토큰 위치에서 추가 스텝이 줄인 cross-entropy 손실을 관측한다. Stage 2의 gain predictor는 사용자 문맥, 토큰 위치, 후보 스텝을 받아 이 이득을 예측한다. 이후 총 예산 안에서 위치별 step 수 열을 선택한다. 세 보조 장치는 다음처럼 읽으면 된다. semantic alignment는 위치마다 대응하는 codebook 공간에 hidden state를 맞추는 장치, horizontal refinement는 같은 위치에서 state update를 여러 번 되풀이하는 장치, lookahead는 앞 위치 state가 뒤쪽 ID token도 예측하게 하는 손실이다. 이들은 가변 깊이 계산을 안정화하려는 설계다.
predictor가 직접 학습하는 값을 구분해야 한다. 논문에서의 목표는 “추가 스텝이 추천 정확도를 얼마나 올릴지”가 아니라, clipped cross-entropy 감소량에 정보이득을 곱한 대리 신호다. 좋은 대리 신호라면 더 낮은 토큰 손실이 더 좋은 추천과 연결될 수 있지만, 둘이 모든 순위 지표에서 같은 방향으로 움직인다는 보장은 아니다. 논문의 효용을 지나치게 넓혀 해석해서는 안 된다.
결과가 지지하는 범위
저자들은 TIGER와 LETTER 두 생성 추천 backbone에 IBA를 붙이고 Beauty·Instruments·MicroLens에서 Recall·NDCG 등의 12개 보고 지표가 모두 개선됐다고 제시한다. Table III에서 앞쪽 prior (3,2,1,0)와 뒤쪽 prior (0,1,2,3)는 각각 총 6 step이므로, 이 둘의 비교가 배분 방향을 같은 예산에서 시험한다. 균등 prior (2,2,2,2)는 8 step이어서 앞쪽 6-step 설정과 계산 예산을 맞춘 대조가 아니다. 따라서 세 설정 모두를 한꺼번에 ‘같은 예산의 우위’로 부르면 안 된다.
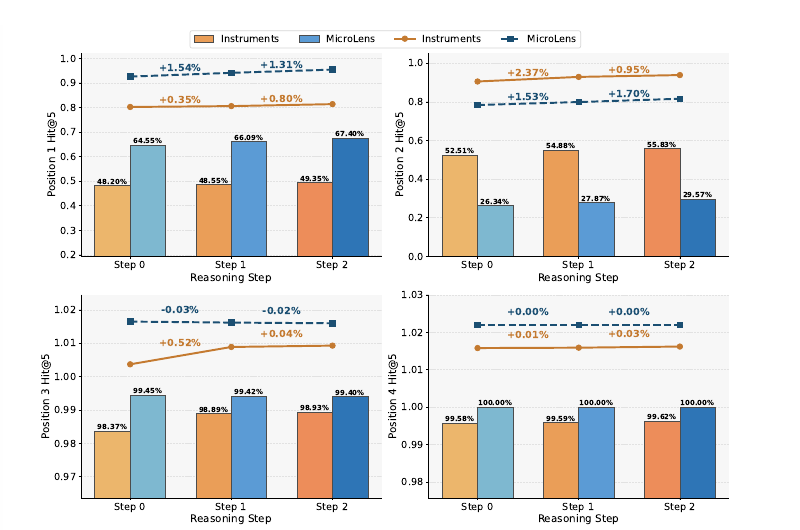
그림 3. Yang et al. (2026), Figure 7, arXiv:2607.12425v1 PDF p. 10의 원도판을 인용. Instruments·MicroLens에서 위치별 refinement step 수와 Token Hit@5의 관계를 제시한다. 그림은 위치별 계산의 효용이 균일하지 않다는 관찰을 보이지만, 전체 아이템 추천의 모든 지표를 단독으로 대표하지는 않는다.
이 결과는 적어도 세 공개 데이터셋과 두 backbone에서, 균일한 계산보다 위치·사용자 조건부 배분이 유리할 수 있음을 지지한다. 하지만 IBA가 모든 semantic ID 부호화 방식에 최적이라는 결론은 아직 이르다. 위치별 정보이득의 모양은 ID를 만든 RQ-VAE와 데이터셋의 item taxonomy에 영향을 받을 수 있고, 사람에게 유의미한 ‘추론 단계’를 실제로 분리해 측정한 것은 아니다.
사용 시 확인할 것
이 방법을 적용하려면 우선 semantic ID의 접두사마다 후보 집합이 어떻게 변하는지, 그리고 고정 스텝 baseline의 오류가 어느 위치에서 집중되는지부터 봐야 한다. 모든 위치가 비슷한 정보를 담는 ID라면 앞쪽 편향 prior는 약해질 수 있다. 총 예산을 고르는 기준도 명시해야 한다. IBA는 계산을 없애는 방법이 아니라 같은 예산을 재배치하는 방법이며, predictor와 할당 탐색의 추가 비용도 실제 serving에서 측정해야 한다. 보고된 실험은 seed 42를 사용하지만 반복 횟수, 신뢰구간·유의성, 튜닝 프로토콜을 충분히 제시하지 않는다. 작은 차이는 독립 반복으로 확인하는 편이 안전하다.
‘추론을 줄일까 늘릴까’보다 ‘어떤 결정이 후보 공간을 많이 바꾸는가’를 먼저 물어야 한다. 다만 정보이득, 손실 감소, 최종 추천 품질은 서로 다른 층위의 지표다. 이 세 가지가 같은 것처럼 쓰지 않는 것이 이 결과를 공정하게 적용하는 출발점이다.
References
Yang, S., Gao, M., Wang, Z., & Yu, J. (2026). Where reasoning matters: Rethinking latent reasoning in semantic ID-based generative recommendation (arXiv:2607.12425v1). PDF
더 긴 수식 없는 방법 재구성과 표 분석은 심화 보기에서 확인할 수 있다.