Accelerating Scientific Research with Gemini in the Real-World
실험을 하는 연구 에이전트는 어디까지 왔나: Co-Scientist 읽기
Co-Scientist는 가설·실험·원고 작성을 연결하지만, 네 평가는 자율성·비용·검증 조건이 다르다. 이 글은 신뢰성 모듈 묶음의 환각 결과와 아직 직접 재지 않은 연구 가속을 분리해 읽는다.
Paper: Samuel Schmidgall; Xiaokai Zhu; Marian Shaw; Lin Yang; Valentin Liévin; Jingyun Yang; Yuchen Zhuang; Tim Strother; Alex Bijamov; Min Woo Sun; Anil Palepu; Justin Chen; David Steiner; Jacqueline Shreibati; Wei-Hung Weng; Yilin Zhao; Xingjian Hu; Nicholas Zahn; Sadhya Garg; Julia Kirby; Yuxiang Gan; Jiaoli Li; Divy Thakkar; Shekoofeh Azizi; David Racz; Juraj Gottweis; Vivek Natarajan; Chenglin Wu; Tal Danino; Keran Rong; Haozhe Wang; Benoit Schillings; Yong Cheng; Quoc V. Le; Tao Tu (2026). "Accelerating Scientific Research with Gemini in the Real-World." arXiv:2608.26701v1. PDF
1. 무엇을 확장했나
이 논문은 이전의 가설 생성 중심 Co-Scientist를 실행 근거를 갖춘 연구 파트너로 넓힌다. 여기서 실행 근거란 그럴듯한 연구 계획을 쓰는 것이 아니라, 코드 실행 로그·실험 장비·측정 결과가 다음 판단의 입력이 되는 구조를 뜻한다. 흐름은 가설 후보를 만들고 실험 프로그램을 실행·수정하고 마지막으로 원고의 수치 주장을 실행 기록과 대조하는 세 단계다.
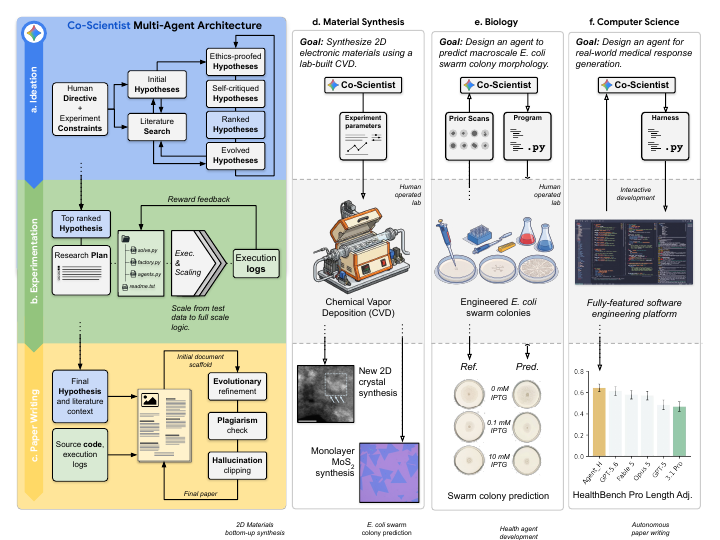
그림 1. 원 논문 Figure 1, PDF p. 3, arXiv:2608.26701v1의 원도판을 크롭한 것(PDF SHA-256 a674…4a042, bbox: x=95–815, y=120–660 at 110 dpi). 가설·실험·원고 단계와 재료·생물·의료 소프트웨어 사례를 함께 배치한다. 이 그림은 시스템 개요이지 네 분야의 성능을 같은 척도로 비교한 결과표는 아니다.
예를 들어 원고 작성 단계에서는 문장에서 수치와 통계 주장을 찾아 실행 로그에 있는지 확인한다. 확인되지 않으면 해당 문장을 고쳐 쓰게 하는 방식이다. 논문이 말하는 신뢰성은 답변 전체의 진실 판정이 아니라, 이처럼 실행 가능한 수치 주장에 대한 대조에 가깝다. 따라서 문헌 해석, 실험 설계의 타당성, 새로운 가설의 과학적 의미까지 자동으로 보증한다는 뜻으로 읽으면 범위를 넘는다.
2. 자율성은 하나의 숫자가 아니다
논문은 재료합성, E. coli 군집 예측, 의료 응답 에이전트 Agent_H, 자동 논문 생성의 네 평가를 묶는다. 그러나 역할 분담은 다르다. CVD 재료 실험에서는 사람이 장비를 운전하고 선택된 프로토콜을 다듬는다. 생물학 사례에서는 전문가가 과제 구성을 반복 조정하고 wet-lab 측정을 수행한다. 반면 Agent_H 설계와 일부 원고 생성은 컴퓨팅 환경 안에서 더 높은 자율성을 보인다.
이 차이는 ‘에이전트가 과학을 했다’는 한 문장보다 중요하다. MXene 유사 물질 사례에서 첫 관찰 후 성공률은 26회 중 3회(11.5%)였고, 장비 유지보수 절차를 바꾼 뒤 25회 중 17회(68.0%)였다. 저자도 원자 구조 확인에는 추가 STEM 분석이 필요하다고 쓴다. 반대로 TMD 세 종류의 단일층 성장 ‘첫 시도 성공’은 별도 실험이며, 앞의 11.5%와 68.0%를 여기에 적용할 수 없다.
3. 생물 예측은 어떤 검증을 받았나
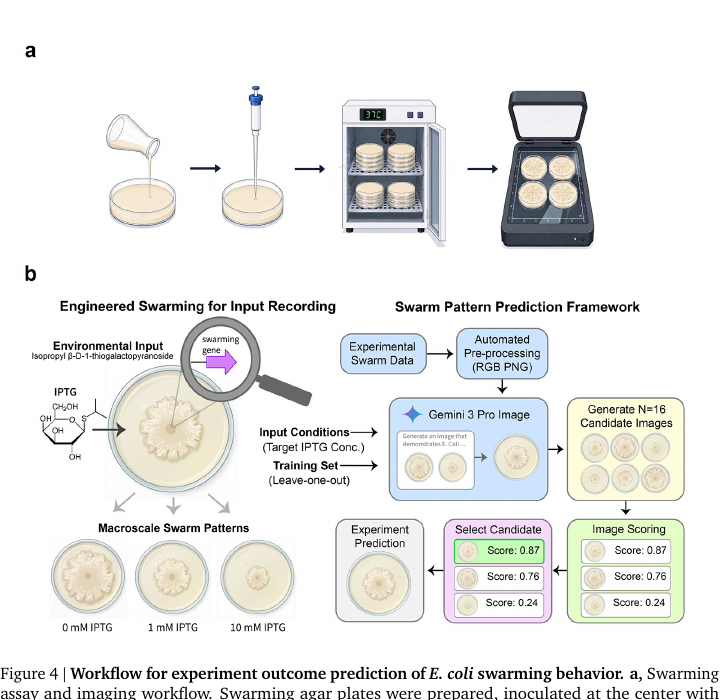
그림 2. 원 논문 Figure 4, PDF p. 17, arXiv:2608.26701v1의 원도판 크롭(PDF SHA-256 a674…4a042, bbox: x=95–815, y=180–880 at 110 dpi). IPTG 농도에 따른 군집 이미지의 leave-one-out 예측과 후보 16개 중 점수 최고 이미지를 고르는 절차를 보여준다. 도식은 과정 설명이며, 모든 생물학 조건에서의 일반화 성능을 뜻하지 않는다.
IPTG는 유전자 발현을 유도하는 화합물이다. 이 사례에서 시스템은 농도별 군집 형태 이미지를 예측한다. 하나의 조건을 빼고 나머지로 구성한 leave-one-out 조건에서, 모델이 후보 이미지 16개를 만들고 보조 평가자가 점수를 매겨 하나를 고른다. 논문은 네 형태 지표 중 세 지표에서 관측과 양적 일치를 보고하며, 대조 균주에서 농도 반응이 없다는 특성도 잡았다고 설명한다.
다만 이 결과의 분모는 광범위한 미생물 실험이 아니라, 공개된 400 dpi 군집 스캔과 특정 균주·IPTG 범위다. 전문가가 입력 과제를 어떻게 다듬었는지와 에이전트가 독자적으로 기여한 부분은 분리된 절제로 제시되지 않는다. 이 사례는 희소 이미지 조건에서 워크플로가 가능함을 보여 준다. 일반적인 wet-lab 스크리닝 비용 절감률까지 보여 주지는 않는다.
4. 숫자가 가장 또렷한 곳: 원고 생성 검증
자동 논문 생성 평가는 50개 주제를 세 조건으로 돌려 만든 원고 150편을 30명 전문가가 맹검 검토한 설계다. 원고마다 세 검토가 있어 총 450개 맹검 검토가 생긴다. 심각한 결과 환각의 원고 비율은 신뢰성 구성을 켠 Co-Scientist에서 4%(2/50), 절제 조건에서 46%, Agent Laboratory에서 90%로 보고된다. 다만 450개 검토는 원고와 검토자 안에 중첩돼 있으므로, 이를 450개의 통계적으로 독립된 관측치라고 읽을 근거는 제시되지 않았다. 논문이 제공한 검토자 배정·맹검 절차 설명만으로는 조건별 배정과 평가 의존성이 편향 없는 비교를 충분히 보장했는지 판정할 수 없다.
이 비교가 바꾼 것은 실행 로그 대조 하나가 아니다. 신뢰성 구성에는 환각·표절에 대한 공동 최적화 페널티, 실행 로그로 수치 주장을 대조하는 결정적 clipping, 윤리 감독이 함께 들어간다. 절제 조건은 소프트 페널티와 clipping을 함께 뺀다. 따라서 4% 대 46%는 신뢰성 묶음 전체의 근거이며, 로그 대조만의 고립된 효과를 재지는 않는다. 로그 대조 자체가 정량 주장 검증을 수행한다는 방법 설명은 유지되지만, 그 인과 효과는 별도 절제가 필요하다.
의료 쪽도 조건을 붙여 읽어야 한다. Agent_H는 HealthBench Hard 1,000문항과 Professional 525문항에서 길이 보정 점수 네 조건 모두 1위였지만, 원점수 네 조건에서는 한 번만 1위다. Agent_H는 질의당 약 40–80회 모델 호출을 쓰고 비교 모델은 한 번 호출한다. 임상의 비교는 106문항, 의사 3명, 문항당 한 평가자였으며 아홉 차원 중 잠재적 임상 위해만 FDR 보정 후 p=0.0486이었다. 이 결과는 호출 예산을 맞춘 우위나 임상 효과를 입증하지 않는다.
5. 적용할 때의 결론
이 논문에서 설득력 있는 부분은 실행 로그를 원고 주장과 맞춰 보는 검증 루프와 서로 다른 자율성 조건의 공개다. ‘완전 자율 연구자’라는 큰 표어보다 이 부분이 중요하다. 실제 도입에서는 세 질문을 따로 물어야 한다. 장비·데이터·안전 제약을 누가 정의하는가, 각 수치가 원시 로그로 되짚어지는가, 사람·시간·호출 비용을 맞춘 비교가 있는가.
저자 보고 결과는 특정 CVD 장비, 특정 이미지 데이터, HealthBench, 그리고 50개 논문 주제의 계산 환경에서 성립한다. 사람 연구자 대비 발견 속도나 비용을 통제한 실험은 없다. 그러므로 이 연구는 폐쇄 루프 연구 시스템의 중요한 시연이지만, ‘과학 연구 전체를 몇 배 가속한다’는 결론까지는 제공하지 않는다.
6. 실험 파트너로 쓰기 위한 기록
현장에서 이 구조를 쓰려면 결과 파일만 남기는 것으로는 부족하다. 실험의 입력 데이터 버전, 장비 상태, 사람이 바꾼 설정, 실패한 후보와 그 사유가 함께 남아야 ‘로그 대조’를 다시 확인할 수 있다. 특히 재료 실험의 68.0%는 레시피만의 변화가 아니라 장비 정비 뒤의 25회라는 조건부 결과다. 이런 개입을 자동 산출물과 같은 줄에 기록하지 않으면 다음 사용자가 원인을 잘못 귀속할 수 있다.
의료·생물학처럼 피해 비용이 큰 분야에서는 선택한 후보뿐 아니라 탈락한 후보, 안전 필터가 막은 실행, 검토자가 본 원시 근거를 감사 가능한 형태로 보관해야 한다. 논문의 신뢰성 모듈은 그중 원고 수치의 대조라는 한 층을 구현한다. 좋은 연구 에이전트라면 사람이 결과의 출처와 결정 경로를 되짚을 수 있어야 한다. 멋진 최종 문장보다 이 능력이 중요하다.
실험실 연결도 별도의 평가 축이다. 장비가 자동으로 실행할 수 있는 명령 범위, 위험한 조합을 차단하는 하드 규칙, 사람이 승인해야 하는 전환점을 사전에 정해야 한다. 논문 속 CVD 사례는 인간 조작과 최적화가 들어간 반자동 환경이므로, 이를 로봇 실험실의 완전 무인 운전과 같다고 부르면 안 된다. 같은 시스템이라도 물리적 실험과 코드 실험은 실패의 비용과 되돌릴 수 있는 정도가 다르다.
그래서 성과 보고에는 성공한 실행만이 아니라 전체 시도 횟수와 중단 이유가 포함되어야 한다. 그 분모가 있어야 새 발견, 운영 개선, 우연한 한 번의 성공을 구분할 수 있다.
References
Schmidgall, S., Zhu, X., Shaw, M., et al. (2026). Accelerating scientific research with Gemini in the real-world (arXiv:2608.26701v1). https://arxiv.org/abs/2608.26701