ColPali: Efficient Document Retrieval with Vision Language Models
PDF를 읽지 않고 페이지를 본다: ColPali의 문서 검색
ColPali는 OCR과 청킹 대신 페이지 이미지를 다중 벡터로 색인한다. ViDoRe의 nDCG@5 차이는 크지만 빠른 색인·30ms 질의·큰 저장 공간을 함께 계산해야 실제 도입 판단이 가능하다.
Paper: Manuel Faysse; Hugues Sibille; Tony Wu; Bilel Omrani; Gautier Viaud; Céline Hudelot; Pierre Colombo (2025). "ColPali: Efficient Document Retrieval with Vision Language Models." ICLR 2025. arXiv:2407.01449v6. PDF
1. 질문은 ‘어떤 임베딩인가’보다 ‘무엇을 버릴 것인가’다
복잡한 PDF에는 문장뿐 아니라 표의 칸, 그림의 범례, 두 단 배치, 글꼴과 위치가 의미를 만든다. 보통 검색기는 PDF를 파싱하고 OCR을 돌린 뒤 레이아웃을 찾고 텍스트를 청크로 나눈다. ColPali는 이 전처리를 피한다. 페이지 이미지를 그대로 시각언어 모델에 넣어 여러 개의 벡터로 바꾸고, 질의 토큰과 페이지 패치가 가장 잘 맞는 조합을 합쳐 페이지 순위를 정한다.
여기서 늦은 상호작용(late interaction)은 질의 하나를 문서 전체와 한 번에 압축 비교하지 않는다는 뜻이다. 질의의 ‘연도’ 토큰은 날짜가 있는 패치를, ‘그래프’ 토큰은 도표 패치를 각각 찾아 가장 큰 유사도를 취한다. 예를 들어 “이 보고서의 탄소세 그래프는 어느 페이지인가?”라는 질문은 OCR 텍스트가 깨져도 축·선·제목의 시각적 조합을 남겨 둘 여지가 있다.
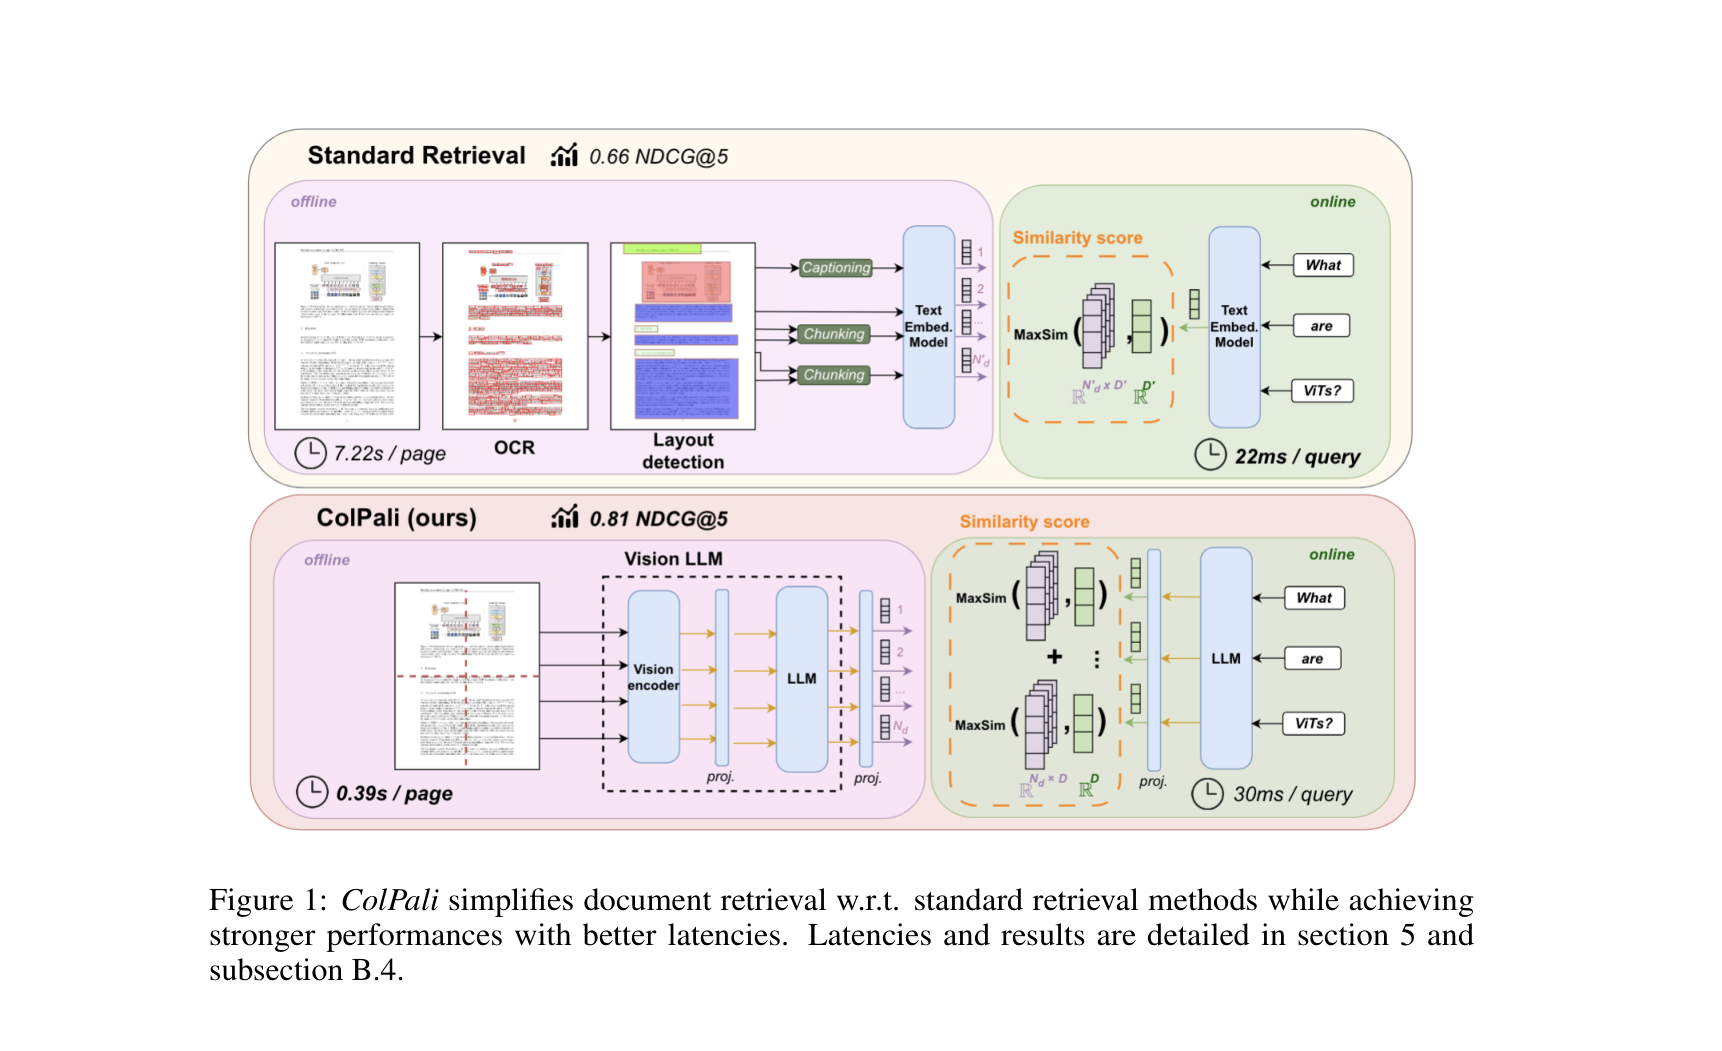
그림 1. Faysse et al., Figure 1, PDF p. 2, arXiv:2407.01449v6 원도판. 위는 OCR·레이아웃·청킹을 거치는 기준 파이프라인, 아래는 페이지 이미지를 바로 다중 벡터로 만드는 ColPali다. 그림의 0.39초/쪽은 색인 시간이고 30ms/질의는 온라인 시간이다. 도식은 모든 PDF 형식에서 OCR보다 정확하다는 증거가 아니다.
2. ViDoRe와 결과의 분모
논문은 페이지 단위 시각 문서 검색 벤치마크 ViDoRe를 함께 제안한다. 결과는 10개 하위 과제의 nDCG@5 평균이다. nDCG@5는 정답 페이지가 상위 다섯 결과에서 얼마나 높은 위치에 놓였는지 보는 순위 지표다. ColPali의 평균은 81.3, 가장 높은 비교 파이프라인인 Unstructured+Captioning+BGE-M3는 67.0으로 보고된다. 따라서 차이 14.3점은 ‘상위 5개 페이지’ 기준이며, 답변 정확도나 문서 전체 검색 성공률을 뜻하지 않는다.
비교는 시각적으로 복잡한 InfographicVQA, ArxivQA, TabFQuAD에서 특히 두드러진다. 이는 글자만 추출하는 방식이 표·그림을 잃기 쉽다는 문제와 맞는다. 다만 벤치마크 구축과 모델 제안이 같은 논문에 있고, 본문은 학습 질의의 37%가 Claude-3 Sonnet으로 생성됐다고 적는다. 이 비율은 내부적으로 완전히 맞물리지 않는다. 본문 총계는 118,695 query-page pairs지만 Appendix Table 3의 행 합계는 118,728이고, Scrapped PDFs 45,940건만 계산해도 본문 총계의 약 38.7%다. ArxivQA에도 합성 질의가 있다. 따라서 37%는 저자가 적은 서술값으로만 읽어야 하며, 표와 재조정된 정확한 합성 비율로 제시할 수 없다.
3. 빠른 곳과 비싼 곳은 다르다
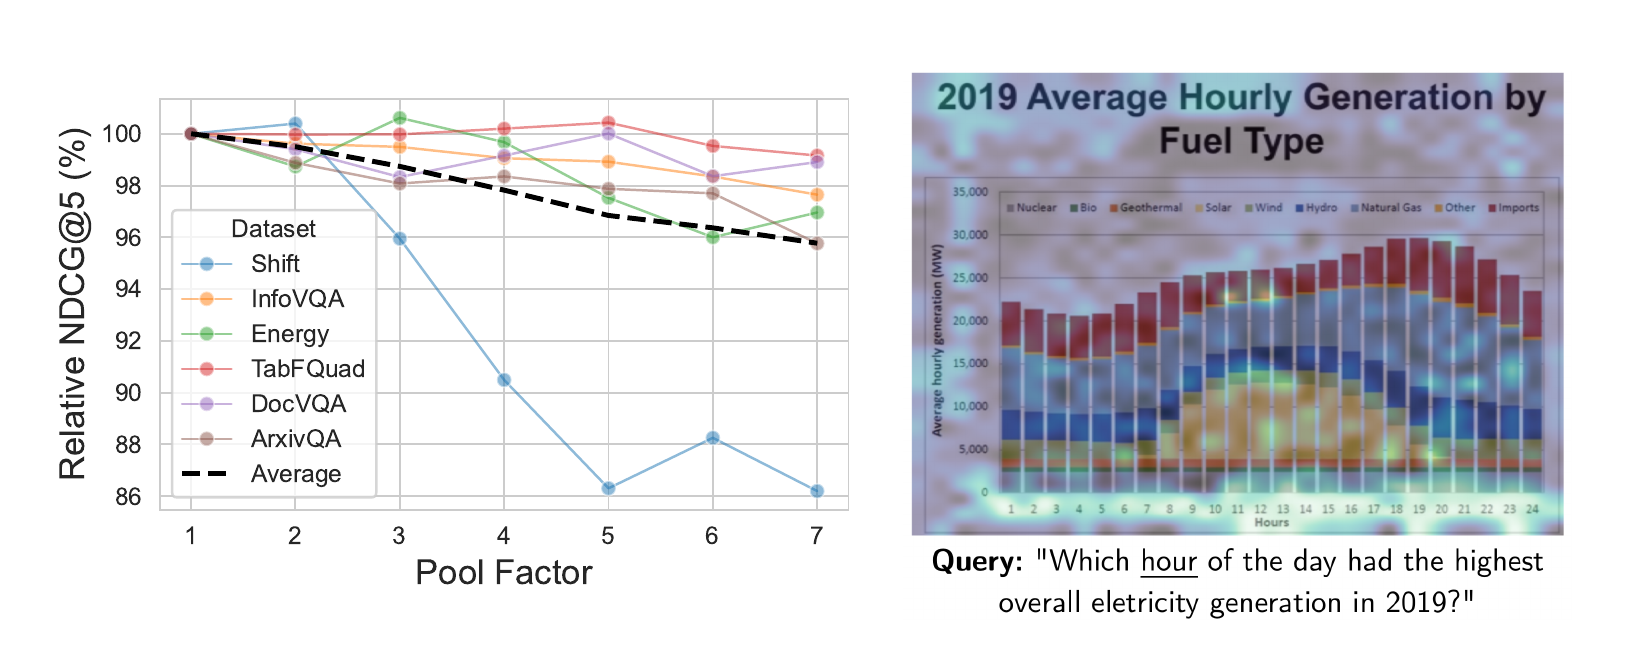
그림 2. Faysse et al., Figure 3, 물리 PDF p. 9, arXiv:2407.01449v6의 300dpi 원도판 패널 크롭(PDF SHA-256 852e…2631, bbox x=450–2100, y=270–930 at 300dpi; asset SHA-256 1a8a…867a). 왼쪽은 토큰 풀링의 상대 nDCG@5 곡선, 오른쪽은 한 질의에서 강조된 문서 패치다. 이 자산은 원논문의 인쇄 캡션과 인접 본문을 의도적으로 제외했다. 오른쪽은 단일 시각화 사례이며, 패치 강조를 인과적 설명이나 신뢰도 점수로 읽을 수 없다.
오프라인 색인은 ColPali가 0.39초/쪽, 비교 파이프라인은 7.22초/쪽으로 보고된다. OCR·캡셔닝 단계를 없앤 효과가 큰 구간이다. 하지만 온라인 질의는 ColPali 30ms, BGE-M3 22ms다. 속도 우위는 색인에 한정된다. 또한 페이지마다 1,024개 패치와 6개 토큰을 128차원 벡터로 보관하는 구조라, 논문 계산상 페이지당 약 257.5KB를 쓴다. BGE-M3보다 저장 공간은 약 30배다.
토큰 풀링으로 이 비용을 줄일 수 있지만 성능과 절충해야 한다. 본문은 풀 인자 3에서 벡터 수를 66.7% 줄이고 상대 성능 97.8%를 유지한다고 적는다. 그러나 Figure 3의 검은 평균선은 인자 3에서 약 98.8%, 인자 4에서 약 97.8%로 읽힌다. 즉 정확한 본문 수치와 도판의 대략적 읽기가 서로 어긋난다. 인자 3·66.7%·약 98.8%, 또는 인자 4·75%·약 97.8%가 서로 대응한다. 이 도판 읽기 값은 눈금에서 읽은 근사치이며, 논문의 본문 수치 97.8%를 그래프가 독립적으로 확인한다고 말할 수 없다.
4. 무엇이 성능을 만들었나
사다리 절제는 SigLIP에서 BiSigLIP, BiPali, ColPali로 한 장치씩 바꾼다. 이 과정에서 비전 언어 모델 교체에 따른 평균 변화는 0.2점, 늦은 상호작용을 넣은 변화는 22.5점으로 보고된다. 적어도 이 설정에서는 페이지를 보고 다중 벡터를 남긴 뒤 토큰별로 맞추는 방식이 핵심 기여라는 해석이 가능하다.
다만 절제와 헤드라인 비교를 동일시하면 안 된다. ColPali는 미세조정된 모델이고 일부 비교 모델은 그렇지 않다. 또한 논문 안에는 질의 지연을 ‘모든 시스템에서 22ms 이하’로 적은 대목과 30ms를 적은 표·그림이 함께 있다. 그림 1의 7.22초는 캡셔닝을 포함한 색인 구성, 0.66 nDCG@5는 캡셔닝을 뺀 구성에서 왔다. 독자가 하나의 균일한 기준선으로 오해하지 않도록 분리해 읽어야 한다.
5. 도입 기준
표와 그림이 정답 근거인 문서, OCR 품질이 자주 깨지는 스캔, 다국어 레이아웃 문서는 ColPali가 겨냥한 환경이다. 반대로 텍스트 중심 문서에서 이미 안정된 검색 색인이 있고, 저장비와 30ms 수준의 질의 지연이 민감하다면 장점이 줄어든다. 운영 전에는 페이지 수에 257.5KB를 곱한 저장 예산, 색인 재생성 빈도, 실제 질의의 표·그림 비율을 먼저 계산해야 한다.
ColPali는 ViDoRe의 상위 5개 페이지 순위와 특정 하드웨어에서의 색인 시간을 보여 줬다. 범용 RAG 품질, 답변의 사실성, 모든 문서에서의 총비용 우위까지 직접 입증한 것은 아니다.
6. 작은 파일럿에서 확인할 것
도입 전에는 실제 문서를 그림·표·양식·스캔·일반 텍스트로 나누고 각 집합에서 같은 질문을 시험하는 편이 좋다. 단지 nDCG@5만 보지 말고, 상위 다섯 페이지를 사람이 열어 답을 찾는 시간과 ‘정답 페이지가 아예 없었던’ 오류를 따로 기록해야 한다. ColPali는 페이지 단위 검색기이므로, 답변 모델이 잘못된 페이지를 인용하는 문제는 별도 평가다.
비용은 코퍼스 규모에 따라 급격히 달라진다. 100만 페이지라면 논문의 표현 크기만 단순 적용해도 약 257.5GB이고, 복제본·메타데이터·색인 오버헤드는 여기에 더해진다. 반대로 매번 OCR·캡셔닝을 다시 해야 하는 업데이트가 잦다면 0.39초/쪽의 색인 단축이 큰 가치가 될 수 있다. 이 두 숫자를 같은 환경에서 재면 논문의 장점을 가장 공정하게 확인할 수 있다.
검색 결과의 설명 방식도 미리 정해야 한다. 패치 유사도 지도는 사용자가 ‘왜 이 페이지가 나왔는지’를 이해하는 데 힌트를 주지만, 모델이 그 패치의 사실을 근거로 답했다는 증명은 아니다. 고위험 문서 검색에서는 페이지와 함께 인용할 원문 영역을 후처리로 추출하고, 표·그림·본문 중 무엇이 매칭 근거였는지 사람이 확인하는 흐름이 필요하다. ColPali의 시각 표현은 그 확인을 대체하지 않는다.
또한 페이지 단위 순위가 좋다고 문서 단위 순위도 자동으로 좋아지는 것은 아니다. 한 문서에서 여러 후보 페이지를 합치는 규칙, 중복된 표지를 제거하는 방식, 후속 답변기가 얼마나 많은 페이지를 읽는지가 최종 경험을 좌우한다. 이 연결 단계는 ColPali의 nDCG@5와 별도로 시험해야 한다.
References
Faysse, M., Sibille, H., Wu, T., Omrani, B., Viaud, G., Hudelot, C., & Colombo, P. (2025). ColPali: Efficient document retrieval with vision language models. ICLR 2025. arXiv:2407.01449v6. https://arxiv.org/abs/2407.01449