WikiSkill: Compiling Agent Experience into Persistent Knowledge for Skill Evolution
실행 기록을 위키로 남기면 스킬은 더 나아질까: WikiSkill
WikiSkill은 실행 기록과 스킬 사이에 지속 위키를 둔다. 다섯 작업·다섯 모델의 평균 개선은 분명하지만, 작은 검증 분할과 한 모델에서만 수행한 절제가 결론의 범위를 정한다.
Paper: Liyan Tang; Cyrus Rashtchian; Chun-Sung Ferng; Andrew Tomkins; Da-Cheng Juan; Tu Vu (2026). "WikiSkill: Compiling Agent Experience into Persistent Knowledge for Skill Evolution." arXiv:2608.27454v1. PDF
1. 문제: 좋은 실패가 다음 회차에 남지 않는다
에이전트 스킬은 특정 작업에서 지켜야 할 절차와 지식을 담은 실행용 문서다. 기존의 스킬 진화는 실행 궤적을 읽고 스킬 수정안을 제안한 뒤 검증 점수가 좋을 때만 채택한다. WikiSkill의 출발점은 그 과정에서 얻은 ‘왜 실패했는가’가 수정된 스킬 속으로만 흩어진다는 진단이다.
논문은 원시 실행 기록, 지속 위키, 실행 스킬을 분리한다. 원시 기록은 명령과 도구 결과를 그대로 보존한다. 위키는 반복되는 실패 패턴과 채택·거절 근거를 주제별로 정리한다. 스킬은 실제 작업 에이전트가 읽는 지침이다. 예컨대 스프레드시트 에이전트가 같은 이동을 반복했다면, 위키에는 반복의 조건과 실패 증거가 남고 스킬에는 ‘한 항목에 같은 연산을 반복하지 말라’는 실행 규칙만 남길 수 있다.
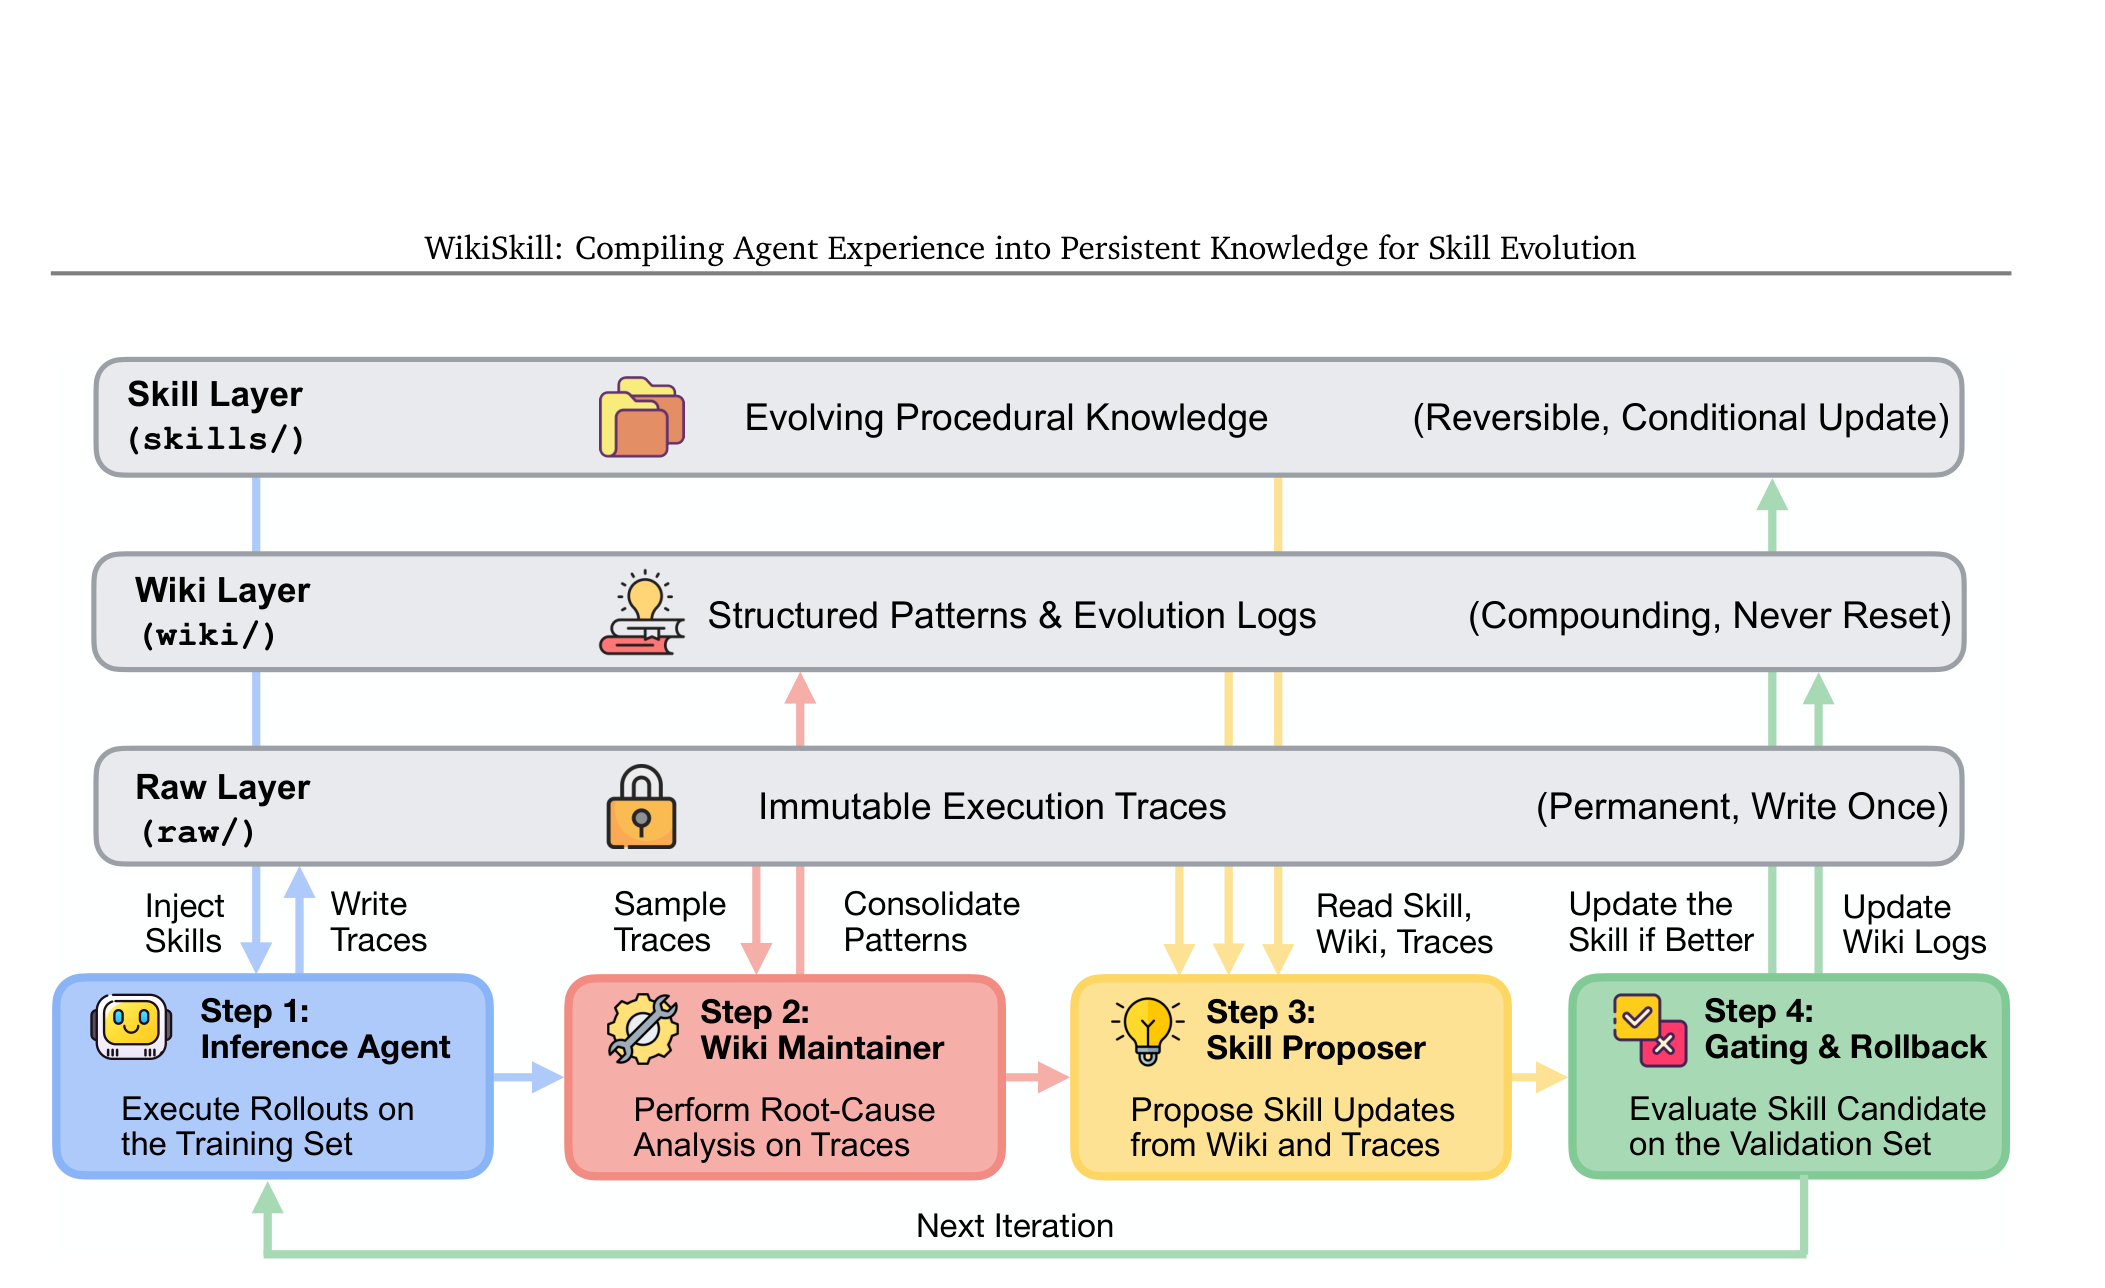
그림 1. Tang et al., Figure 2, PDF p. 2, arXiv:2608.27454v1 원도판(소스 맵 경로: /api/blog/figures/wikiskill-fig2-framework.png). Raw·Wiki·Skill 층과 Inference Agent→Wiki Maintainer→Skill Proposer→Gating/Rollback 순서를 그린다. 구조도는 위키가 성능을 높인다는 측정 결과가 아니다.
2. 핵심은 ‘메모리’보다 권한 분리다
한 회차는 네 단계다. Inference Agent는 현재 스킬을 주입받아 훈련 작업을 수행한다. Wiki Maintainer는 표집한 궤적에서 원인을 찾아 패턴·색인·로그를 고친다. Skill Proposer는 위키를 먼저 읽고 필요한 궤적을 더 찾아 스킬 변경을 제안한다. 마지막으로 검증 분할에서 나빠지면 되돌린다.
여기서 중요한 제한이 있다. 실행 에이전트는 위키를 직접 읽지 않으며, 위키 정리 에이전트는 스킬 파일을 쓰지 않는다. 앞 단계의 긴 기록이 즉시 실행 프롬프트를 오염시키는 일을 막고, 검증 통과한 압축된 규칙만 스킬로 옮기려는 설계다. 하지만 스킬을 검증 후 채택하고 롤백하는 장치는 비교 방법 Trace2Skill·EvoSkill·SkillOpt에도 있으므로, 게이팅 자체는 차별점이 아니다. 위키라는 중간 지식층이 차별점이다.
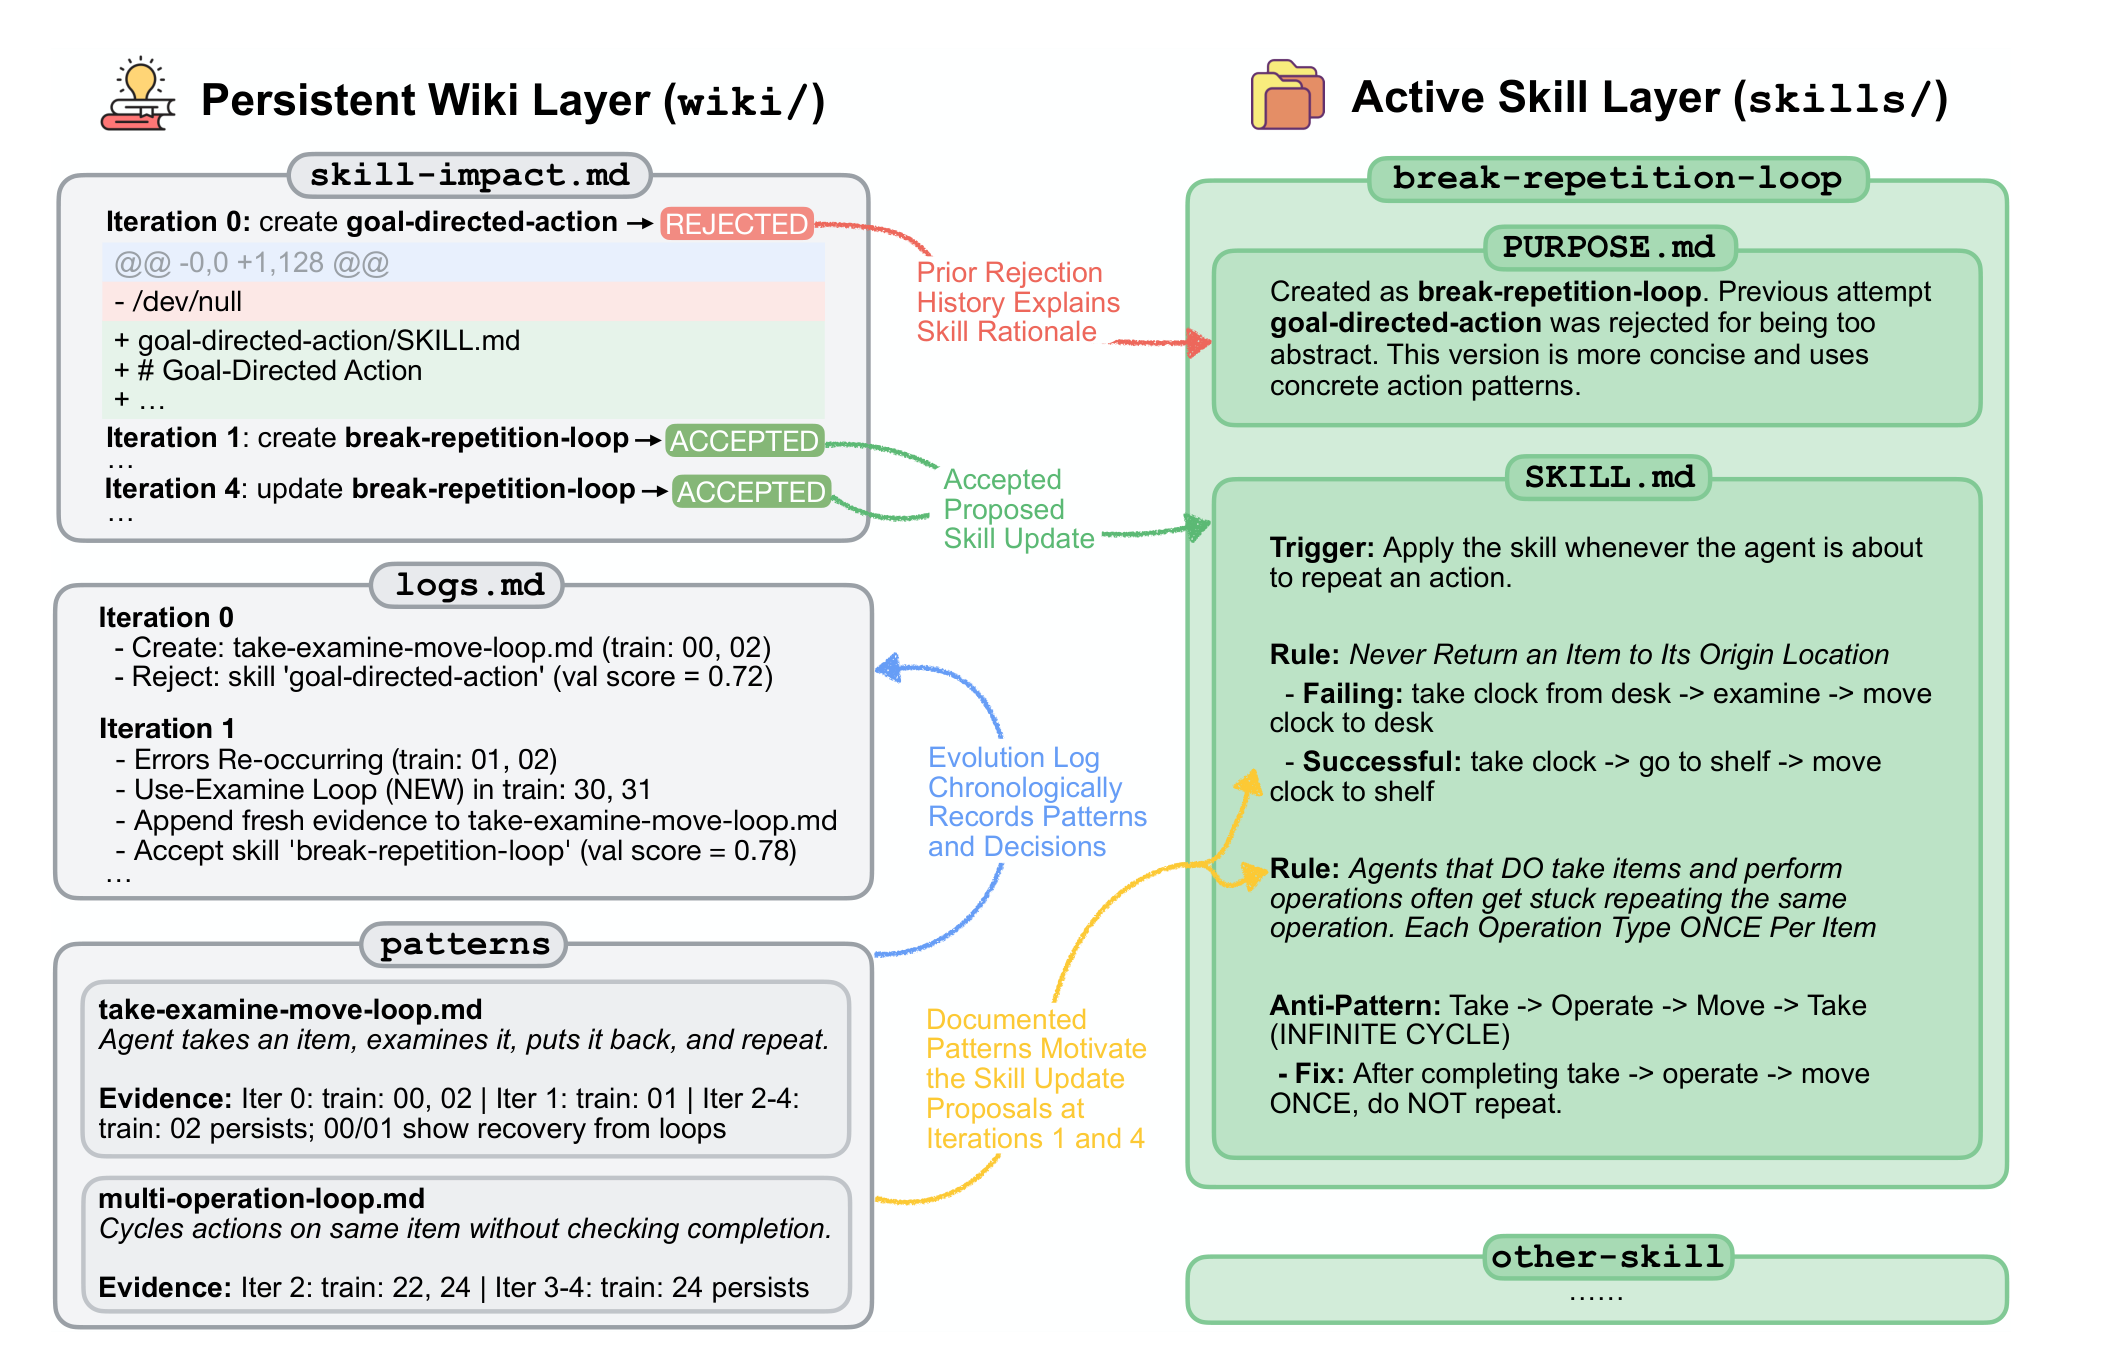
그림 2. Tang et al., Figure 3, PDF p. 5, arXiv:2608.27454v1 원도판(소스 맵 경로: /api/blog/figures/wikiskill-fig3-case.png). ALFWorld에서 거절 이력과 패턴 페이지가 새 스킬 규칙의 근거로 연결되는 한 사례다. 선택된 사례이므로 평균적 성공률이나 모든 작업의 인과 설명으로 일반화할 수 없다.
3. 어떤 조건에서 이겼나
평가는 LiveMath, SealQA, SpreadSheet, OfficeQA, ALFWorld 다섯 작업과 다섯 모델에서 한다. 표의 평균 기준 WikiSkill은 모두 가장 높다. 가장 강한 비교 방법 대비 평균 점수 차는 Qwen-3.5-4B에서 3.3점, Qwen-3.5-9B에서 5.1점, Qwen-3.6-27B에서 10.0점, Gemma-4-31B에서 5.8점, Gemini-3.5-Flash에서 12.0점이다. 이는 다섯 작업의 단순 평균이며, ‘어느 한 작업에서도 늘 우세’라는 뜻은 아니다.
특히 Gemini-3.5-Flash의 ALFWorld는 다섯 방법 모두 85.9다. 논문은 진화 전에 검증 분할에서 이미 100%여서 변경이 채택되지 않았다고 설명한다. 또 무스킬 대비 개선은 25개 모델-작업 칸 중 23칸에서 보이지만, 우연 변동과 직접 구분되는지 판단하려면 볼드 규칙을 봐야 한다. paired bootstrap 1,000회와 p<0.05 규칙 아래 WikiSkill의 단독 볼드는 25칸 중 11칸이다. 나머지는 공동 최고이거나 표기 규칙이 일관되지 않은 칸이다.
4. 위키의 효과는 얼마나 분리됐나
위키 접근 권한을 달리한 절제는 Gemini-3.5-Flash와 네 벤치마크에서만 수행된다. 전체 WikiSkill은 63.7, 위키를 제거한 조건은 48.7이다. 후자의 값은 세 비교 방법의 48.05–48.70 범위로 돌아간다. 이 조건 안에서는 지속 위키가 평균 차이를 설명한다는 강한 근거다.
다만 이것이 위키의 ‘지속성’만 증명하지는 않는다. 위키를 회차마다 초기화하되 같은 정리·탐색 비용을 쓰는 대조군은 없다. 또한 SealQA의 검증 분할은 10문항이고 LiveMath는 18문항이다. 한 문항이 채택 결정을 크게 바꿀 수 있으며, 논문은 전체 진화를 세 번 실행했지만 평균의 표준편차는 보고하지 않는다.
5. 적용 판단
WikiSkill은 긴 로그를 모두 프롬프트에 넣는 방식보다 유용한 경계를 제안한다. 재사용 가능한 지식, 실제 실행 규칙, 감사 가능한 이력을 분리하고 수정은 검증을 거치게 한다. 조직에서 적용한다면 위키에 누가 무엇을 썼는지, 거절된 수정이 다음 제안에 어떻게 영향을 주는지, 그리고 검증 집합이 충분히 큰지를 먼저 점검해야 한다.
이 논문은 다섯 에이전트 과제와 지정된 모델에서 지속 위키를 포함한 루프가 평균 점수를 개선했다는 주장을 뒷받침한다. 모델 크기가 커질수록 보편적으로 더 잘 작동한다거나, 어떤 업무 지식도 안전하게 누적된다는 결론은 이 실험만으로는 이르다.
6. 지속 지식의 운영 조건
위키가 오래 남는다는 것은 장점이자 위험이다. 잘못된 원인 분석이 패턴 페이지에 굳으면, 다음 회차의 제안자가 그 오류를 더 그럴듯한 규칙으로 바꿀 수 있다. 그래서 패턴마다 근거가 된 궤적, 적용한 작업·모델·날짜, 채택과 거절의 검증 점수를 연결해 두어야 한다. Figure 3의 PURPOSE.md처럼 스킬이 어느 판단에서 나왔는지 역추적하는 연결은 실제 운영에서 특히 중요하다.
또한 검증 분할이 작다면 ‘개선’과 ‘그 분할에 맞춘 수정’을 구분할 수 있어야 한다. 배포 전에 별도 홀드아웃과 다른 모델에서 다시 측정하고, 위키를 초기화한 대조 조건도 두는 편이 낫다. WikiSkill의 구조는 이를 가능하게 하지만, 논문 결과 자체가 그러한 장기 안정성까지 검증한 것은 아니다.
권한 분리는 보안과도 연결된다. 실행 에이전트가 위키를 직접 읽지 못하게 한 설계는 프롬프트가 길어지는 문제뿐 아니라, 원시 기록 안의 잘못된 지시가 즉시 행동 규칙이 되는 위험을 낮춘다. 그러나 Skill Proposer가 위키와 기록을 읽어 수정안을 만들기 때문에, 제안 단계에는 출처 신뢰도와 인용 범위를 검사하는 별도 장치가 필요하다. 검증 점수가 높아도 금지된 행동이나 편향된 규칙이 들어가지 않았다는 보장은 아니다.
위키에 남길 지식의 단위도 작업에 맞춰야 한다. 지나치게 넓은 ‘검색을 잘하라’ 같은 문서는 다음 수정의 근거가 되기 어렵고, 너무 세밀한 실패 기록은 다른 작업으로 옮기기 어렵다. 논문의 사례처럼 관찰된 반복 패턴, 그 패턴이 성립한 조건, 바꾼 규칙, 검증 결과를 함께 남기는 단위가 재사용성과 감사를 모두 돕는다.
이 네 항목이 없으면 위키는 단순한 장기 로그가 된다.
References
Tang, L., Rashtchian, C., Ferng, C.-S., Tomkins, A., Juan, D.-C., & Vu, T. (2026). WikiSkill: Compiling agent experience into persistent knowledge for skill evolution (arXiv:2608.27454v1). https://arxiv.org/abs/2608.27454