A Decoder-Only Foundation Model for Time-Series Forecasting
TimesFM은 여러 시계열을 사전학습해 새 데이터셋을 zero-shot 예측하려는 decoder-only 모델이다. 집계 방식과 데이터셋별 편차를 함께 읽어야 성능 범위를 알 수 있다.
Paper: Abhimanyu Das; Weihao Kong; Rajat Sen; Yichen Zhou (2024). "A Decoder-Only Foundation Model for Time-Series Forecasting". Proceedings of the 41st International Conference on Machine Learning, PMLR 235, 10148–10167. PDF.
한눈에 보기
전통적인 시계열 예측은 판매량·전력·교통처럼 데이터셋 하나가 바뀔 때마다 모델을 새로 맞춘다. TimesFM은 다양한 실제·합성 시계열을 한꺼번에 사전학습하고, 처음 보는 데이터셋에도 가중치를 다시 학습하지 않고 예측하는 foundation model을 제안한다. 텍스트 token 대신 연속된 시계열 조각인 patch를 token으로 쓰고, 과거 patch 다음의 미래 patch를 예측하도록 decoder-only Transformer를 학습한다.
예를 들어 하루 단위 매출 256개를 예측하려면, 모델은 값을 하나씩 읽는 대신 32개 시점씩 묶어 여덟 token으로 본다. 각 token 위치에서 다음 128개 시점을 예측한다. 긴 예측 지평은 방금 생성한 128개를 다시 문맥에 붙여 이어서 만든다. 따라서 TimesFM은 horizon 전체를 한 번에 뽑는 직접 예측기가 아니라, 출력 patch를 길게 해 자기회귀 횟수를 줄인 절충안이다.
패치가 하는 일
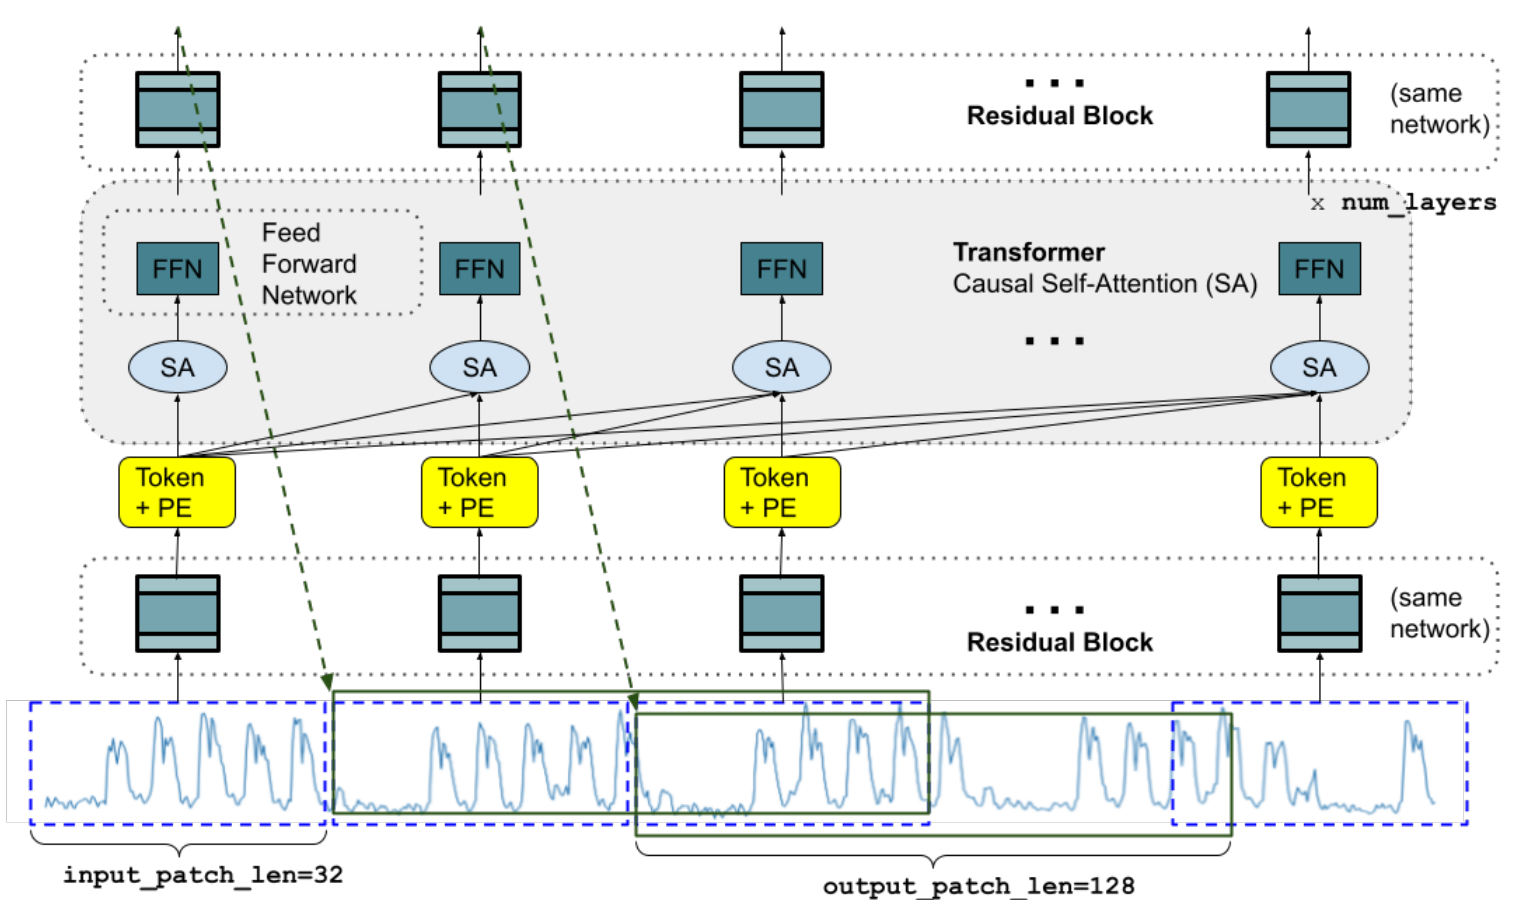
그림 1. Das et al. (2024), Figure 1, ICML 2024 PMLR PDF p. 4에서 새로 추출한 원도판이다. 길이 32 입력 patch가 residual block과 causal Transformer를 거쳐, 각 위치에서 길이 128의 미래 patch를 만든다. 점선 파란 상자는 입력 patch, 초록 상자는 다음 출력 구간을 나타낸다.
200M 모델의 입력 patch 길이는 32, 출력 patch 길이는 128이다. 문맥이 512개 시점이면 attention이 처리하는 token은 512개가 아니라 16개이므로, 긴 문맥의 계산량을 줄일 수 있다. 반대로 patch 하나에 너무 긴 구간을 넣으면 세부 변화가 한 token에 눌릴 수 있다. 논문의 절제는 입력 16·32가 Monash 설정에서 가장 낮은 오차를 보이고, 더 긴 입력 patch에서는 성능이 나빠지는 경향을 보고한다.
또 하나의 장치는 첫 patch의 일부를 무작위로 가리는 masking이다. 비중첩 patch만 쓰면 모델은 32, 64, 96처럼 32의 배수 길이 문맥만 자주 보게 된다. 첫 patch 앞부분을 가리면 28, 60, 92처럼 다른 문맥 길이도 학습에 등장한다. 가변 문맥 대응은 학습 데이터 구성에서 나온다. Transformer에서 저절로 생긴 성질로 볼 수 없다.
zero-shot은 어디까지인가
논문에서 zero-shot은 평가 데이터셋마다 가중치를 fine-tune하지 않는다는 뜻이다. 입력은 univariate series이며, 200M 모델은 MSE로 point forecast를 학습한다. 확률 예측·공변량 입력·다변량 상호작용을 이 논문의 핵심 기능으로 읽어서는 안 된다.
또한 일부 Monash 데이터셋에서는 훈련 구간 끝을 검증 구간으로 써 문맥 길이 32·64·최대값 중 하나를 고른다. 가중치는 고정이므로 저자 정의의 zero-shot에는 들어가지만, 아무 설정도 바꾸지 않는 완전한 out-of-box 적용과는 다르다. 실제 배포에서는 문맥 길이 선택 규칙과 데이터 정규화가 결과에 얼마나 민감한지 따로 확인해야 한다.
결과는 집계와 함께 읽어야 한다
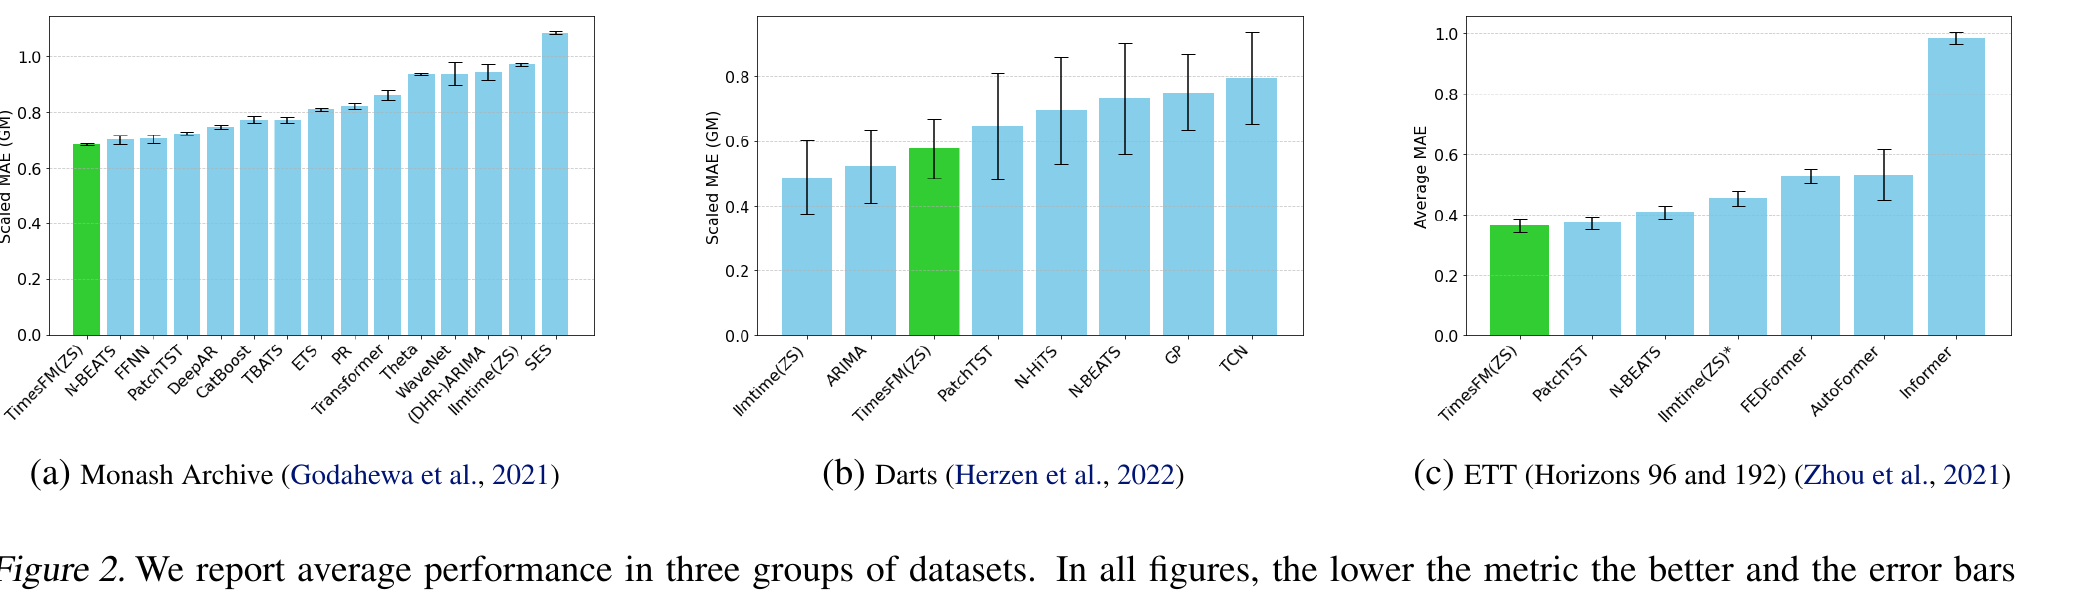
그림 2. Das et al. (2024), Figure 2, ICML 2024 PMLR PDF p. 6에서 새로 추출한 원도판이다. Monash·Darts·ETT의 대표 집계를 비교하며 낮을수록 좋고 error bar는 표준오차다. 서로 다른 데이터셋군·기준선·집계 방식을 하나의 동질적 순위표로 합쳐 읽어서는 안 된다.
Monash에서 TimesFM은 기하평균 scaled MAE 0.6846으로 1위지만, 산술평균에서는 0.8005로 N-BEATS 0.7844 뒤의 2위다. Darts에서는 기하·산술평균 모두 3위다. 데이터셋별 오차 분포를 어떤 방식으로 요약하느냐가 headline 순위에 영향을 준다. 모델의 결과가 틀렸다는 의미는 아니다. 평균 막대 하나만 보고 모든 시계열에서 전용 지도학습 모델을 대체한다고 결론 내리면 안 된다.
저자들은 모델 크기·패치 길이·합성 데이터 혼합도 절제한다. FLOPs가 늘수록 Monash의 scaled MAE가 낮아지는 경향, 출력 patch를 8에서 128로 늘릴수록 특정 ETT 장기 지평의 MAE가 낮아지는 경향을 보인다. 그러나 이는 세 크기의 초기 scaling 실험과 특정 benchmark 조건의 관찰이다. compute-optimal scaling law나 모든 예측 지평에서의 단조 개선을 확정하는 근거는 아니다.
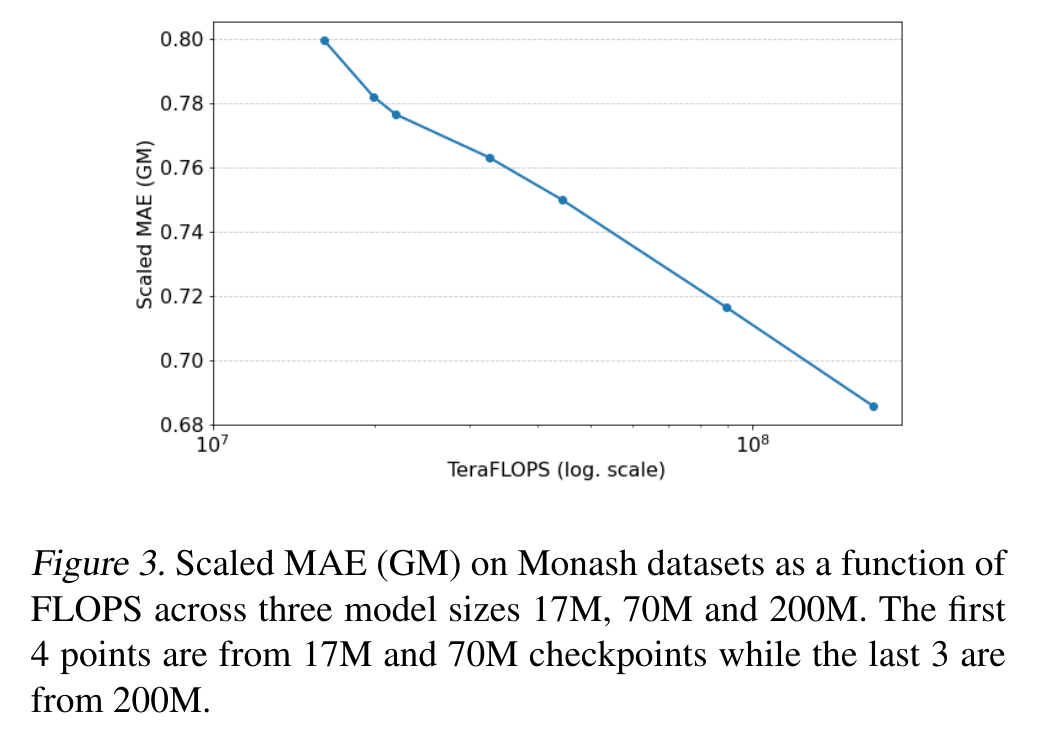
그림 3. Das et al. (2024), Figure 3, ICML 2024 PMLR PDF p. 7에서 새로 추출한 원도판이다. 17M·70M·200M checkpoint의 Monash scaled MAE와 FLOPs 관계를 보인다. 이 그림은 scaling 경향만 보이며, 입력·출력 patch와 합성 데이터 절제는 논문의 별도 절제 결과다.
적용할 때 볼 조건
사전학습 원시 코퍼스는 Wiki pageviews 비중이 크지만, 학습 loader는 real 80%와 synthetic 20%를 표집한다. 원시 시점 수만으로 실제 배치 노출 비율을 계산할 수는 없다. 합성 데이터를 빼면 Monash·ETTm에서 악화하는 절제는 있지만, 20%가 최적인지 또는 trend·seasonality 같은 어느 생성 요소가 기여했는지는 분리되지 않는다.
TimesFM은 여러 도메인·지평에서 경쟁력 있는 zero-shot 기준선을 제시한다. 사용자는 데이터셋별 naive baseline, 계절성, 문맥 길이, 원하는 예측 구간을 먼저 확인해야 한다. 일부 데이터셋에서는 단순 naive보다 오차가 큰 사례도 표에 있으므로, 전역 평균보다 자신의 시계열에서 backtest하는 것이 안전하다. 이 논문은 범용 예측기의 가능성을 보였지만, 도메인별 검증을 대체하지는 않는다.
References
Das, A., Kong, W., Sen, R., & Zhou, Y. (2024). A decoder-only foundation model for time-series forecasting. Proceedings of the 41st International Conference on Machine Learning, 235, 10148–10167. PMLR
더 긴 데이터 구성·평가표 분석은 심화 보기에서 확인할 수 있다.