Dynamic Latent Routing: 이산 코드로 언어 모델의 계산을 조절하기
답을 더 길게 쓰지 않고 계산을 바꾼다면: Dynamic Latent Routing
몇 토큰마다 코드 하나를 골라 모델의 중간 표현을 바꾸면 추론에 도움이 될까? DLR의 라우팅과 공동 학습을 설명하고, 24개 QA 설정의 개선과 산술 코드 개입이 무엇을 보여 주는지 살펴본다.
Paper: Fangyuan Yu; Xin Su; Amir Abdullah (2026). "Dynamic Latent Routing". arXiv:2605.14323v1. PDF
1. 문제를 더 읽는 대신 읽는 방식을 바꾼다
장보기 문제를 생각해 보자. 사과를 몇 개 샀고 일부를 나누어 준 뒤 몇 개가 남는지 답해야 한다. 언어 모델에게 중간 계산을 길게 쓰게 하면 계산할 기회가 늘어난다. 하지만 같은 문장을 읽으면서 내부에서 처리하는 방식 자체를 조절하는 방법도 있을까?
Dynamic Latent Routing, 줄여서 DLR은 이 두 번째 방향을 탐구한다. 새 잠재 토큰 대신 몇 토큰마다 코드를 골라 그 벡터를 모델 내부에 더한다. 장보기 이야기는 원리를 설명하는 예시이지 이 논문의 별도 실험이 아니다.
핵심은 정답을 외워 둔 카드가 아니라 학습되는 조절 선택지다. 어떤 벡터가 도움이 되는지와 언제 그 벡터를 고를지를 함께 배운다. 논문은 여러 질의응답 과제에서 개선을 보고하지만, 계산 비용을 같게 맞춘 비교는 아니며 실제 후보 수 등 일부 설정도 문서 안에서 서로 다르다. 이 글은 저자 보고 실험의 해설이지 새로 학습해 확인한 결과가 아니다.
2. 작은 선택기가 코드 하나를 고른다
모델 안에서 문장은 숫자들의 배열로 바뀐다. 아직 답이 되기 전의 중간 메모라고 생각하면 된다. DLR의 라우터는 이 메모를 읽는 작은 선택기다. 코드북에는 번호별로 더할 숫자 벡터가 들어 있다.
설명을 위해 네 토큰씩 묶는다고 하자. 첫 구간에서 코드 7을 고르면 지정된 층의 그 구간에 7번 벡터를 더한다. 다음 구간에서는 코드 2를 골라 다른 벡터를 더할 수 있다. 먼저 조절 전 표현을 읽어 고르고, 그다음 조절한다. 계산을 계속하는 것은 여전히 같은 언어 모델이다.
7이 덧셈이고 2가 검산이라고 정해 놓은 것은 아니다. 역할은 학습되며 효과는 문제와 위치에 따라 달라진다. 네 토큰도 한 추론 단계와 같지 않다. 이 7→2 흐름은 가상 예시다.
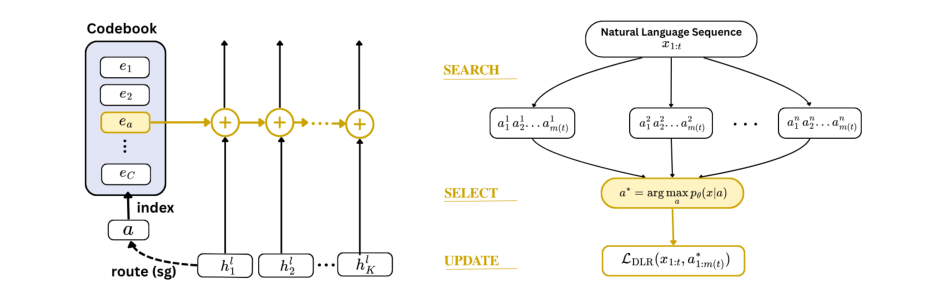
Figure 1. 코드 하나의 선택이 토큰 구간의 벡터 조절로 이어진다. 출처: Yu, Su, & Abdullah (2026), v1 PDF 5쪽, Fig. 1.
라우터는 구간 첫 입력 위치의 표현을 읽는다. 보통의 자기회귀 언어 모델에서는 이미 읽은 토큰까지의 표현으로 다음 토큰을 예측하므로, 이것만으로 미래 정답을 미리 본다는 뜻은 아니다. 다만 이는 일반적인 입력·예측 정렬의 설명이며 해당 구현의 패딩과 캐시까지 검증됐다는 뜻도 아니다.
DLR은 프롬프트 기법이나 별도의 전문가 모델을 고르는 방식이 아니다. 내부와 가중치에 접근해 같은 모델의 계산을 바꾼다.
3. 정답을 아는 학습에서는 여러 선택을 비교한다
학습 데이터에는 문제와 답이 있지만 ‘여기서는 코드 7을 쓰라’는 정답표는 없다. 그래서 DLR은 여러 후보 코드열을 시험한다. 각 후보로 정답 시퀀스를 얼마나 잘 예측하는지 비교하고, 그중 가장 높은 가능도를 주는 후보를 고른다. 이후 모델 본체와 벡터, 라우터를 함께 갱신한다.
학생이 답을 아는 연습 문제에서 여러 풀이 습관을 시험하고 잘된 선택을 다시 익히는 상황에 비유할 수 있다. 다만 점수는 독립적인 채점 교사의 판단이 아니라 현재 모델의 정답 시퀀스 가능도다. 후보 중 가장 낫다는 말이지 모든 코드 조합의 최적해는 아니다.
학습 신호는 네 가지 역할을 한다. 조절 없이도 문장을 예측하게 하고, 조절된 예측을 잘하게 하며, 선택된 코드열을 다시 고르게 하고, 모든 문제에 같은 코드만 쓰는 붕괴를 막는다. 기준값의 역전파를 끊는 장치가 있지만 기본 모델 전체를 고정하는 것은 아니다. 코드 선택과 벡터뿐 아니라 언어 모델도 배운다.
실제 사용에서는 정답을 모른다. 따라서 학습 때의 ‘정답 가능도로 후보를 고르기’를 그대로 배포 절차라고 설명하면 틀린다. 논문은 평가에서 정답 토큰을 강제로 넣지 않았다고 밝히고 QA의 입력 처리·생성 코드열도 보여 준다. 그러나 정답 없이 후보를 고르는 세부 규칙과 캐시 처리는 더 명확한 명세가 필요하다. 본문은 후보 8개, 부록은 주결과 후보 4개와 두 배 예산 8개를 적으므로 여기서 어느 하나를 확정 기본값으로 소개하지 않는다.
4. 정확도는 올랐지만 무료 계산은 아니다
주 실험은 여섯 언어 모델과 네 질의응답 데이터셋의 조합, 모두 24개 설정이다. 비교 대상인 SFT는 정답 토큰을 잘 예측하도록 보통의 지도 미세조정을 한 모델이다. 아래는 원문 표에서 설정별 정확도 차이를 같은 무게로 평균한 값이다.
| 비교 범위 | DLR의 SFT 대비 평균 차이 |
|---|---|
| GSM8K 수학 문장제 | +6.50퍼센트포인트 |
| ScienceQA 과학 질의응답 | +10.73퍼센트포인트 |
| StrategyQA 질의응답 | +6.17퍼센트포인트 |
| CommonsenseQA 상식 질의응답 | +2.82퍼센트포인트 |
| 24개 설정 전체 | 약 +6.6퍼센트포인트 |
24칸 모두 DLR의 인쇄된 정확도가 SFT보다 높다. 여기서 6.6은 정답 문항을 전부 합쳐 얻은 하나의 정답률 차이가 아니고, 상대적으로 6.6% 더 좋아졌다는 뜻도 아니다. 첫 세 과제만 모은 18개 설정의 평균 차이는 7.8퍼센트포인트다.
데이터와 학습 업데이트 수를 맞춘 점은 의미가 있다. 하지만 DLR은 후보들을 시험하고 조절 전후의 가능도를 계산한다. 같은 횟수로 학습했다고 같은 양을 계산한 것은 아니다. 새 토큰을 넣지 않는다고 반드시 더 빠르거나 싸다는 결론도 나오지 않는다.
표의 오차막대는 시험 문항을 다시 뽑는 bootstrap에서 얻은 구간이다. 다른 무작위 시드로 모델을 재학습한 변동까지 포함하지 않는다. 따라서 모든 설정에서 통계적으로 확정된 개선이나 재학습 안정성이 증명됐다고 말할 수 없다. 선행 잠재 토큰 기준선도 일부 셀에서는 SFT보다 높으므로, DLR의 좋은 결과를 다른 모든 방법의 보편적인 실패로 바꾸어 읽지는 않아야 한다.
5. 코드를 끄면 점수가 내려간다는 것은 무엇을 뜻할까
코드가 실제 계산에 쓰이는지 알아보려면 조절을 끄거나 다른 코드로 바꿔 볼 수 있다. ScienceQA의 Qwen3-8B에서 원래 정확도는 80.6%이고 벡터 주입 강도를 0으로 만들면 17.4퍼센트포인트 떨어진다. 무작위 코드 교체도 성능을 떨어뜨린다. 단순히 번호를 기록만 한 것이 아니라 출력에 영향을 주는 경로라는 근거다.
그러나 코드를 끄는 것은 SFT 모델로 돌아가는 일이 아니다. DLR에서는 모델 본체도 함께 학습됐기 때문이다. 위 개입 후 정확도는 63.2%지만 별도로 학습한 SFT는 61.8%다. ‘조절 경로의 효과’와 ‘두 학습법의 전체 차이’를 구분해야 한다.
코드 하나의 효과도 단순하지 않다. 논문에는 같은 코드를 없애자 한 주제의 성능은 오르고 다른 주제는 내려가는 사례가 있다. 코드에 ‘생물학 담당’처럼 이름 하나를 붙이는 것보다, 특정 상태에서 계산 방향을 바꾸는 선택지라고 보는 편이 안전하다.
한 번의 교체는 이후 생성과 다음 코드 선택까지 바꿀 수 있다. 따라서 관측한 것은 전체 행동에 대한 효과이지 뇌 지도처럼 특정 회로 하나의 정체를 찾은 결과가 아니다. 개입할 수 있다는 것은 중요한 진전이지만, 모두 이해했다는 뜻은 아니다.
6. 작은 계산기에서는 더 자세히 볼 수 있다
논문은 큰 QA 모델과 별도로 작은 transformer에게 여섯 자리 덧셈·뺄셈을 학습시킨다. 올림과 빌림이 언제 생기는지 알 수 있어 코드가 계산과 어떻게 연결되는지 살피기 쉽다. 대표 모델은 2층·1헤드·128차원이며 학습 문제 100K를 사용했다.
저자 보고로 26개 split의 평가 문제 2,600개에서 원래 정확도는 95.5%다. 코드 순서를 섞으면 26.6%, 무작위 코드로 바꾸면 12.3%, 모든 코드를 고정된 [UNK] 임베딩으로 바꾸면 0.1%가 된다. 마지막은 벡터를 0으로 만드는 QA 개입과 다르다. 해당 모델이 학습된 코드 경로에 크게 의존한다는 뜻이지 코드 없는 모든 모델이 산술을 못 한다는 뜻은 아니다.
잘못된 코드만 고치면 답도 바로잡을 수 있을까? 저자들은 오답마다 29개 대체 코드와 5개 위치를 조합한 145개 개입을 시험했다. 앞쪽 d0–d2 위치에서 27–31%는 고칠 수 있는 교체가 그중 존재한다는 보고다. 정답 없이 한 번의 선택으로 그 비율을 고친 자동수정기가 아니다. 대표 교체도 오답 10개를 고치면서 정답 5개를 망가뜨린다.
코드 30개 중 23개가 활성화되고 올림·빌림 및 위치와 연관된다는 분석도 흥미롭다. 하지만 모든 코드가 한두 위치만 맡지는 않으며, 그림과 표의 코드별 빈도·역할 표기가 서로 맞지 않는 부분도 있다. 안정된 코드 사전이나 완전한 계산 프로그램을 얻었다고 결론 내리기는 이르다.
산술 정확도는 13개 설정 중 12개에서 전체 점수가, 13개 모두에서 가장 깊은 C6 올림 점수가 SFT보다 높다. 다만 이는 고정 여섯 자리 입력의 결과다. 더 긴 수나 새로운 연산 조합으로의 전이는 입증되지 않았다. 26개 split이라는 설명과 달리 Table 21은 12개 행만 보여 주며 완전한 생성기·분할·중복 점검 자료도 부족하다. 이 공백은 누출의 증거가 아니라 일반화의 범위를 확인할 수 없는 부분이다.
7. 이론은 안내도이지 성능 보증서가 아니다
이 논문은 General Dijkstra Search라는 이론적 탐색도 제시한다. 시간에 따라 보상이 달라질 때 여러 부분 정책을 이어 붙여 목표에 이르는 문제를 다룬다. 여기서 얻은 탐색·선택·갱신의 관점이 DLR의 설계로 이어진다.
하지만 이론의 탐색은 명시적인 후보 관리와 가정을 사용하고, 실제 DLR은 학습된 라우터에서 제한된 후보를 뽑는다. 점수도 현재 언어 모델이 바뀌면 달라진다. 저자 역시 이론이 실제 DLR을 보증하지 않는다고 명시한다. 이론적 최적성과 신경망의 경험적 개선은 다른 층위다.
재현 자료에도 남은 질문이 있다. 후보 수뿐 아니라 주입층·일부 절제 기준선과 코드 프로필이 문서 안에서 충돌한다. 부록은 ‘공개된 코드’를 언급하지만 체크리스트는 제출본 미공개와 출판 시 공개를 말한다. 현재 공식 저장소는 검증하지 않았으므로 비공개라고 단정하지 않는다. 문서 차이를 결과 조작이나 실제 구현 실패의 증거로 삼는 것도 맞지 않는다.
8. 무엇을 얻었고 무엇을 더 알아야 할까
DLR은 ‘생각을 더 길게 쓰기’와 다른 길을 보여 준다. 모델이 같은 토큰을 처리하면서 내부 조절을 선택하도록 학습할 수 있고, 그 선택을 관찰하고 바꾸는 실험도 가능하다. 여러 QA 설정의 개선과 작은 산술 모델의 코드 의존성은 그 인터페이스가 유용하다는 근거다.
아직 남은 질문은 구체적이다. 같은 계산 예산을 쓰는 다른 학습법보다도 좋은가? 정답을 모르는 상황에서 고쳐야 할 코드와 위치를 알아낼 수 있는가? 입력 길이와 연산 조합이 달라져도 같은 코드가 비슷한 기능을 하는가? 이런 검증은 완료된 결과가 아니라 다음 판단에 필요한 조건이다.
현재로서는 유용한 조절 손잡이를 배웠지만, 최적의 계산법이나 완전히 읽을 수 있는 추론 프로그램을 얻었다고 보기는 어렵다는 결론이 알맞다. 정확도 향상, 계산 효율, 코드의 의미를 나누어 읽을 때 이 논문의 기여와 불확실성이 함께 보인다.
References
Yu, F., Su, X., & Abdullah, A. (2026). Dynamic latent routing [Preprint]. arXiv. https://arxiv.org/abs/2605.14323v1