JEV-as-a-Judge: Accept When Confident, Escalate When Unsure
답 천 개를 검토한다면: JEV가 자신 없는 판정을 넘기는 방법
JEV가 판정과 라벨 확률을 이용해 추가 검토가 필요한 응답을 가려내는 방법을 설명한다. 작업별 정확도, 호스팅 요금, 동결된 이중 순서 정책의 결과와 적용 조건을 살펴본다.
Paper: Yubo Li; Yidi Miao; Ramayya Krishnan; Rema Padman (2026). "JEV-as-a-Judge: Accept When Confident, Escalate When Unsure". arXiv:2609.26550v1 · 논문 PDF · 원문
1. 모든 답을 가장 비싼 판정자에게 맡겨야 할까
AI가 만든 답 천 개를 검토한다고 하자. 어떤 답은 지시를 어긴 것이 바로 보이지만, 어떤 답은 계산을 다시 해 봐야 틀린 곳을 찾을 수 있다. 매번 강한 모델에게 전부 맡기면 편리하다. 그러나 검토가 반복될수록 답을 만드는 비용 외에 평가 비용도 커진다. 저렴한 판정자가 먼저 보고, 어려운 것만 추가 검토에 넘기면 어떨까?
JEV-as-a-Judge는 이 역할 분담을 시험한 논문이다. JEV는 긴 해설 대신 어느 답을 선택했는지와 각 선택지에 배정한 확률을 돌려주는 호스팅 서비스다. 연구진은 JEV가 얼마나 맞히는지뿐 아니라, 자신 없는 항목이 실제로 더 자주 틀리는지도 살폈다. 이것이 맞아야 추가 검토 예산을 필요한 곳에 쓸 수 있다.
천 개라는 숫자는 운영 상황을 설명하기 위한 예다. 논문의 핵심 정책 검증은 별도 확장 510쌍에서 이루어졌으며, 천 개의 새 답을 실제 서비스에서 순차 처리한 실험은 아니다. 이 차이를 기억하면 정확도와 비용 숫자가 무엇을 뜻하는지 이해하기 쉽다.
2. 선택과 확신은 다른 일을 한다
가령 고객 문의에 대한 답 A와 B가 있다. JEV가 A에 0.95, B에 0.05를 배정했다면 선택은 A다. 반대로 0.52 대 0.48이면 여전히 A를 고르지만, 두 후보 사이에서 덜 확신한 셈이다. 논문은 가장 큰 라벨 확률을 q라고 부른다. 앞의 q는 0.95, 뒤는 0.52다.
선택은 최종 답의 후보가 되고, 확신은 추가 검토 여부를 정하는 신호가 된다. 다만 0.95를 받았다고 정답 인증이 끝나는 것은 아니다. 실제로 비슷한 확률을 받은 항목들이 얼마나 맞는지 따로 확인해야 한다. 서비스에는 별도의 native confidence도 있지만, 논문의 주 분석과 넘김 규칙은 그 비공개 내부 통계량이 아니라 명시적으로 정의한 최대 라벨 확률을 사용한다.
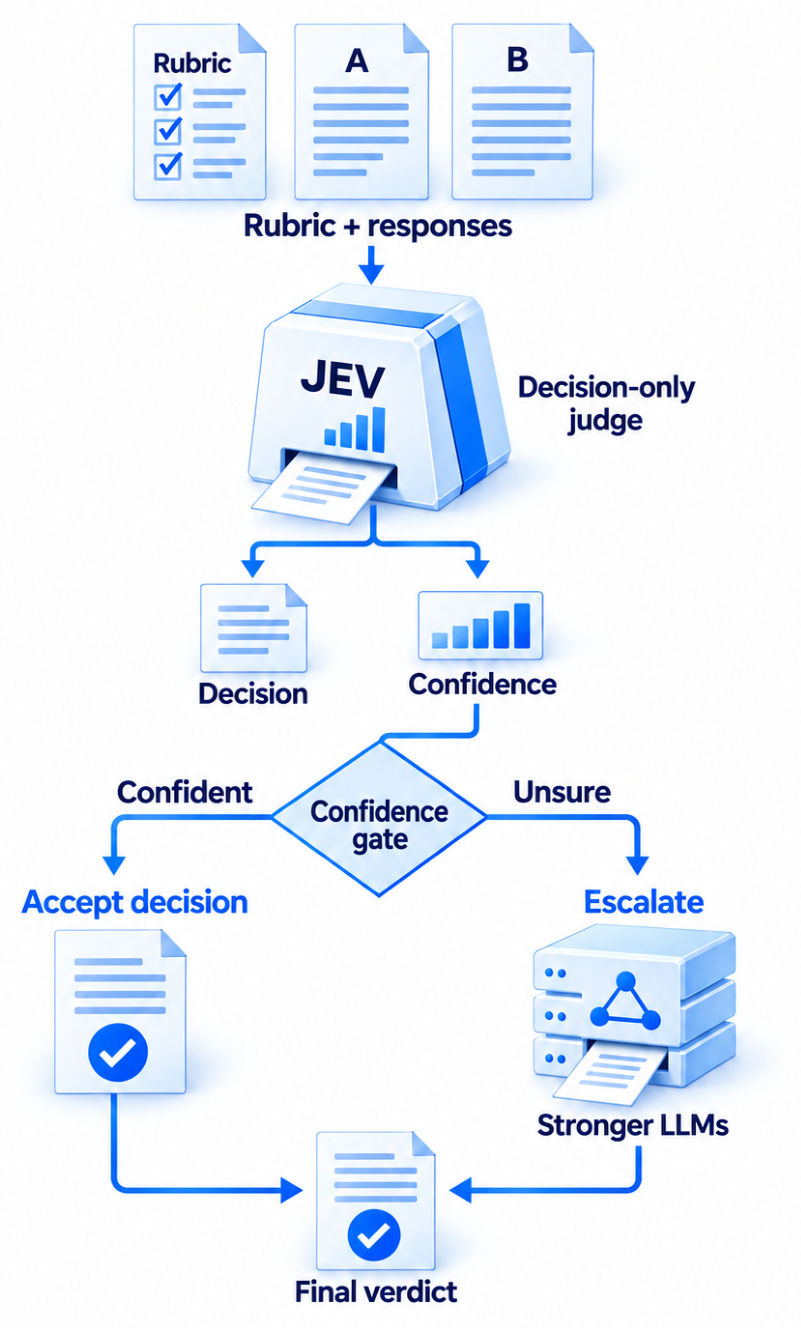
Figure 4. 먼저 판정한 뒤, 불확실한 항목만 추가 검토한다. 실제 쌍별 정책은 후보 순서를 바꾼 두 판정의 확률을 함께 쓴다. 논문 v1, 9쪽.
이 그림을 “JEV는 짧게 답하고 비교 모델은 긴 해설을 쓰니 싸다”로 읽으면 안 된다. 생성형 비교 모델도 같은 지시와 입력을 받고 설명 없이 판정과 확률만 출력했다. 출력 규약은 맞췄지만 모델 크기, 내부 추론과 서빙 환경은 같지 않다. 따라서 서비스 요금 비교이지 설명 생략의 효과만 분리한 실험은 아니다.
3. 저렴한 판정자는 어디까지 잘했나
답 천 개의 성격부터 알아야 한다. 평범한 선호 비교인지, 주어진 증거와 맞는지 확인하는 일인지, 복잡한 추론의 오류를 찾아야 하는 일인지에 따라 결과가 달랐다. 다음은 과제별 평가 결과를 발췌한 표다. 앞의 세 행은 기본 순서 평가이며, RM-Bench는 두 순서를 합친 별도 후속 평가다. 정확도는 각 데이터의 기존 라벨과 일치한 비율이다.
| 어떤 검토인가 | 표본 | JEV | GPT-6 |
|---|---|---|---|
| 통상적 답 선호: RewardBench | 400쌍 | 92.2% | 93.5% |
| 증거에 비춘 사실성: HaluEval | 120문항의 240답 | 87.5% | 86.7% |
| 어려운 정오 비교: JudgeBench | 350쌍 | 78.6% | 93.1% |
| 정교한 문체의 오답 비교: RM-Bench hard | 80문항의 480제시 | 74.8% | 94.6% |
GPT-6는 선택된 강한 비교 대상이지 모든 과제의 최고 점수 모델은 아니다. 예를 들어 RewardBench에서는 Gemini 3.1 Pro가 더 높았고, HaluEval에서는 다른 GPT 구성이 더 높았다. 또 두 정확도가 가깝다고 성능이 같다는 뜻은 아니다. RewardBench의 JEV−GPT-6 차이는 −1.3퍼센트포인트이며 저자 보고 95% 신뢰구간은 −3.8에서 +1.5까지다.
뒤의 두 행은 왜 추가 검토가 필요한지를 보여 준다. 계산이나 코드를 따져야 하는 문제와, 틀렸지만 더 정교하게 쓴 답을 비교하는 문제에서는 격차가 커졌다. 특히 480제시는 서로 독립적인 480문제가 아니라 같은 80문항의 문체와 순서를 바꾼 결과다. 논문은 이런 같은 출처의 반복을 묶어 신뢰구간을 계산한다.
출력 실패도 검토 업무의 실패다. 논문은 읽을 수 없는 라벨이나 유효하지 않은 확률을 정확도에서 오답으로 남겼다. 다만 확률 품질 지표는 유효한 출력만 사용하므로 둘의 분모는 다르다. 운영자가 성공한 요청만 남겨 정확도를 계산하면 실제 처리 품질을 과대평가할 수 있다.
4. 0.36%는 어떤 비용인가
가장 눈에 띄는 요금 결과는 JEV가 GPT-6의 0.36%였다는 것이다. 이 값은 세 공개 과제에서 40판정씩, 총 120판정을 같은 조건으로 비교한 별도 패널에서 나왔다. 1,000판정으로 환산한 추정 요금은 JEV 0.044, GPT-612.182였다. 논문이 제시한 수집 시점 가격과 사용량을 기준으로 약 1/277이다.
이는 실제 청구서도, 컴퓨터가 수행한 연산량도 아니다. JEV의 서비스 가격, 비교 모델의 추론 설정, 사용 토큰과 캐시 할인 등이 함께 반영된다. 나의 천 개 답이 훨씬 길거나 어려운 문제에 치우치면 이 숫자를 그대로 예산으로 잡을 수 없다. 로컬 GPU 모델까지 포함한 비용 순위도 아니다.
중앙 결과 지연은 JEV 0.152초, GPT-6 1.885초였다. 네트워크와 제공자 처리, 재시도까지 들어간 클라이언트 관측 시간이다. 이를 처리량이 그만큼 늘었다거나 내부 추론이 그만큼 효율적이라고 해석할 수는 없다. 특히 두 단계를 실제로 이어 부르는 시스템의 지연을 잰 결과는 아니라는 점이 중요하다.
5. 후보 순서를 바꾸고 규칙을 고정한다
추가 검토를 결정하기 전에 해결할 문제가 하나 있다. 같은 두 답도 A를 먼저 보여 주는지 B를 먼저 보여 주는지에 따라 판정이 달라질 수 있다. 그래서 핵심 정책은 JEV를 두 번 부른다. (A, B)와 (B, A)로 보여 준 뒤, 두 결과를 같은 답의 확률로 맞추어 평균한다.
예를 들어 첫 요청에서 A가 0.9이고, 순서를 바꾼 요청에서 첫 위치의 B가 0.2라면 두 번째 요청의 A 확률은 0.8이다. 둘을 평균하면 A는 0.85가 된다. 이는 설명용 예다. 두 판정이 반드시 일치해야 통과한다는 별도 규칙이나, 둘 중 작은 확률만 취하는 방식이 아니다.
이 평균 확률에 어디서 선을 그을까? 연구진은 RewardBench 64쌍과 JudgeBench 32쌍, 총 96쌍의 선택 집합에서 후속 모델마다 임계값을 골랐다. 후속 모델 단독보다 정확도를 2퍼센트포인트 이상 낮추지 않으면서 가능한 한 많이 JEV에서 끝내는 규칙이다. 96쌍의 2포인트는 순정답 점수 1.92건에 해당해, 정확히 두 오답을 더 허용한다는 뜻은 아니다.
이렇게 정한 규칙을 바꾸지 않고 별도 확장 510쌍에 적용했다. 구성은 RewardBench 240쌍과 JudgeBench 270쌍이다. 답을 본 뒤 잘 나오는 임계값을 고르는 분석과 달리, 선택에 쓰지 않은 자료에서 규칙이 유지되는지 본 것이다. 다만 같은 벤치마크 가족의 확장이며 분석자에게 새로 숨겨진 외부 실험은 아니다.
6. 99% 유지와 99% 정답은 다르다
GPT-6를 후속 판정자로 둔 정책은 임계값 0.9에서 53.7%를 JEV 판정으로 끝냈다. 확장 정확도는 92.5%, GPT-6 단독은 93.1%였다. 이 비율이 약 99.4%이므로 논문은 강한 판정자의 정확도를 약 99% 유지했다고 설명한다. 전체 답의 99%를 맞혔다는 뜻은 아니다.
천 개의 비슷한 쌍을 처리하는 상황으로 직관만 옮기면 대략 절반 남짓을 1단계에서 끝내는 분업이다. 그러나 논문이 새 천 개에서 같은 수용률과 정확도를 보장한 것은 아니다. 510쌍에서 관측한 정확도 차이의 95% 신뢰구간은 −1.78에서 +0.59포인트여서 더 큰 손실 가능성도 남는다.
추정 요금은 GPT-6 단독의 56.8%였고, 사용량을 보수적으로 회계 처리하면 62.2%였다. 모든 쌍에서 JEV를 두 번 부른 비용과 실제로 넘긴 항목의 후속 호출을 포함한다. 앞의 0.36%는 단독 패널 요금이고, 이 56.8%는 별도 510쌍의 2단계 정책 요금이다. 둘은 같은 질문의 답이 아니다.
반례도 있다. GPT-5.6을 후속 모델로 둔 정책은 확장에서 2.35포인트를 잃어 선택 시 목표인 2포인트를 넘었다. 규칙을 고정했다는 사실만으로 손실 한도가 보장되지는 않는다. 또한 논문의 990건 단일 순서 사후 곡선은 이 510쌍 동결 검증과 다른 분석이다. 서로 더 유리한 숫자만 골라 하나의 정책 성과처럼 합칠 수 없다.
7. 자신 있게 틀리면 넘김 규칙도 약해진다
RM-Bench의 어려운 문체 조건에서 JEV가 0.9 이상 확률을 준 251제시 중 27개는 오답이었다. 틀린 답을 자신 있게 선택하면 낮은 확신만 넘기는 규칙은 그 오류를 놓친다. 평균적으로 좋은 판정자라도 자신의 오류를 찾아내는 데는 약할 수 있다는 뜻이다.
더 뚜렷한 경계는 참조 없는 자연 응답이었다. 80응답에서 기존 사람 환각 라벨과의 일치율은 JEV 52.5%, GPT-4.1 mini 53.8%, GPT-5.4 55.0%였다. 여기서는 이 세 구성만 시험했고 GPT-6는 돌리지 않았다. JEV의 평균 최대 확률은 0.90인데 오류 구별 지표 AUROC는 0.518로 약했다. 모든 판정자의 보편적 한계라기보다, 시험한 세 구성에서 자신감이 충분한 검증 신호가 되지 못한 결과다.
문서 기반 요약 후속은 구성한 라벨을 쓰고, 참조 없는 응답은 기존 사람 주석을 쓴다. 자료와 라벨 출처가 달라 둘의 차이를 단순히 참조 유무의 효과로 볼 수도 없다. 확률 보정도 만능 해결책은 아니었다. 과제별 선택 자료에 각각 맞춘 온도를 같은 과제의 확장에서 시험했을 때 세 과제 중 둘은 확률 손실이 악화됐다. 그 보정이 동결 넘김 규칙에 자동 적용된 것도 아니다.
8. 가져갈 아이디어는 분업이지 보증서가 아니다
내 답 천 개에 적용한다면 먼저 실제 작업과 비슷한 검토 자료를 만들고, 임계값을 고르는 자료와 평가하는 자료를 나눠야 한다. 마지막 정확도만 보지 말고 얼마나 넘겼는지, 자신 있게 틀린 항목이 무엇인지, 두 번의 호출과 실패까지 포함하면 얼마가 드는지를 함께 봐야 한다. 실제 순차 처리의 지연도 별도로 측정해야 한다.
정답 라벨 자체의 한계도 남는다. 논문의 사람 감사는 선택된 183건을 팀원 한 명이 검토하고, Claude의 두 번째 검토로 39개 불일치를 골라 사람이 해결한 절차다. 최종 라벨은 사람 결정이지만 독립 전문가 여러 명의 합의는 아니며 36건은 미결이었다. 그 재판정에서도 어려운 비교의 GPT-6 우세는 유지됐지만, 일부 라벨을 바꾼 결과가 전체 자료의 새 정답률을 확정하지는 않는다.
이 글은 원문을 검토한 해설이며 모델 실행을 독립적으로 재현하지 않았다. 논문 부록이 설명하는 익명 보충 ZIP도 직접 접근과 실행 가능성을 확인하지 못했다. 남는 실용적 메시지는 단순하다. 추가 검토를 나누는 기준은 자신감의 크기 자체가 아니라, 그 자신감이 내 작업의 오류를 실제로 구별하는가다.
딥리뷰에서 실험 분할, 신뢰구간, 순서 평균식과 한계 읽기
References
Li, Y., Miao, Y., Krishnan, R., & Padman, R. (2026). JEV-as-a-Judge: Accept when confident, escalate when unsure [Preprint]. arXiv. https://arxiv.org/abs/2609.26550v1