Language Models Can Control Their Own Attention
모델이 필요한 맥락을 직접 선언하면 추론 엔진은 어디까지 덜 읽을 수 있을까. Declarative Attention의 세 모드, 주의 토큰 절감과 정확도의 교환, 실측과 구분해야 할 시간 추정을 살펴본다.
Paper: Namgyu Ho, Huzama Ahmad, Woosung Koh, Se-Young Yun, Tal Schuster, & Cicero Nogueira dos Santos (2026). Language Models Can Control Their Own Attention. arXiv:2609.02737v1 · 원문 PDF · HTML
긴 문서에서 회사의 설립 연도와 상장 연도를 찾았다고 하자. 두 시점의 차이를 계산하는 동안에는 찾아 둔 숫자만 있으면 된다. 그런데 언어 모델은 답을 한 토큰씩 만드는 동안에도 긴 맥락을 반복해서 읽는다. 필요한 정보가 몇 줄뿐이어도 읽는 범위는 훨씬 넓을 수 있다.
이 논문은 모델이 “이제 이 구간을 읽겠다”, “이제 모아 둔 정보만으로 계산하겠다”고 직접 선언하게 한다. 추론 엔진은 그 말을 단순한 설명으로 두지 않고, 실제로 읽을 기억의 범위를 바꾼다. 이름은 **Declarative Attention(DA)**이다.
핵심은 기억을 지우는 것이 아니라 지금 읽을 부분을 고르는 것이다. 결과를 볼 때도 이 구분이 중요하다. 논문의 “52% 절감”은 저장 공간이나 사용자가 기다리는 시간이 절반으로 줄었다는 뜻이 아니다.
1. 이미 계산해 둔 기억도 읽는 데 비용이 든다
언어 모델은 앞선 토큰의 정보를 KV 캐시에 저장한다. 같은 표현을 매번 다시 계산하지 않기 위한 장치다. 하지만 전역 주의 층은 다음 토큰을 만들 때 이 캐시를 넓게 읽는다. 입력이 길어질수록 메모리에서 가져와야 하는 양도 커진다.
덜 중요한 부분을 건너뛰는 희소 주의는 이 부담을 줄이려는 방법이다. 문제는 어떤 부분을 건너뛸지 정하는 일에도 비용이 든다는 점이다. 가벼운 선택기를 쓰더라도 매 생성 단계마다 긴 캐시를 훑는다면 그 비용이 남는다.
DA는 별도 선택기의 반복 스캔 대신 모델이 생성한 참조 계획을 사용한다. 그렇다고 선택 비용이 완전히 사라지는 것은 아니다. 처음에 필요한 근거를 찾는 과정, 선언을 생성하고 처리하는 과정은 여전히 필요하다. 무엇을 읽을지 잘못 고르면 답의 정확도도 떨어질 수 있다.
2. 전체를 찾고, 필요한 곳을 읽고, 모은 정보로 답한다
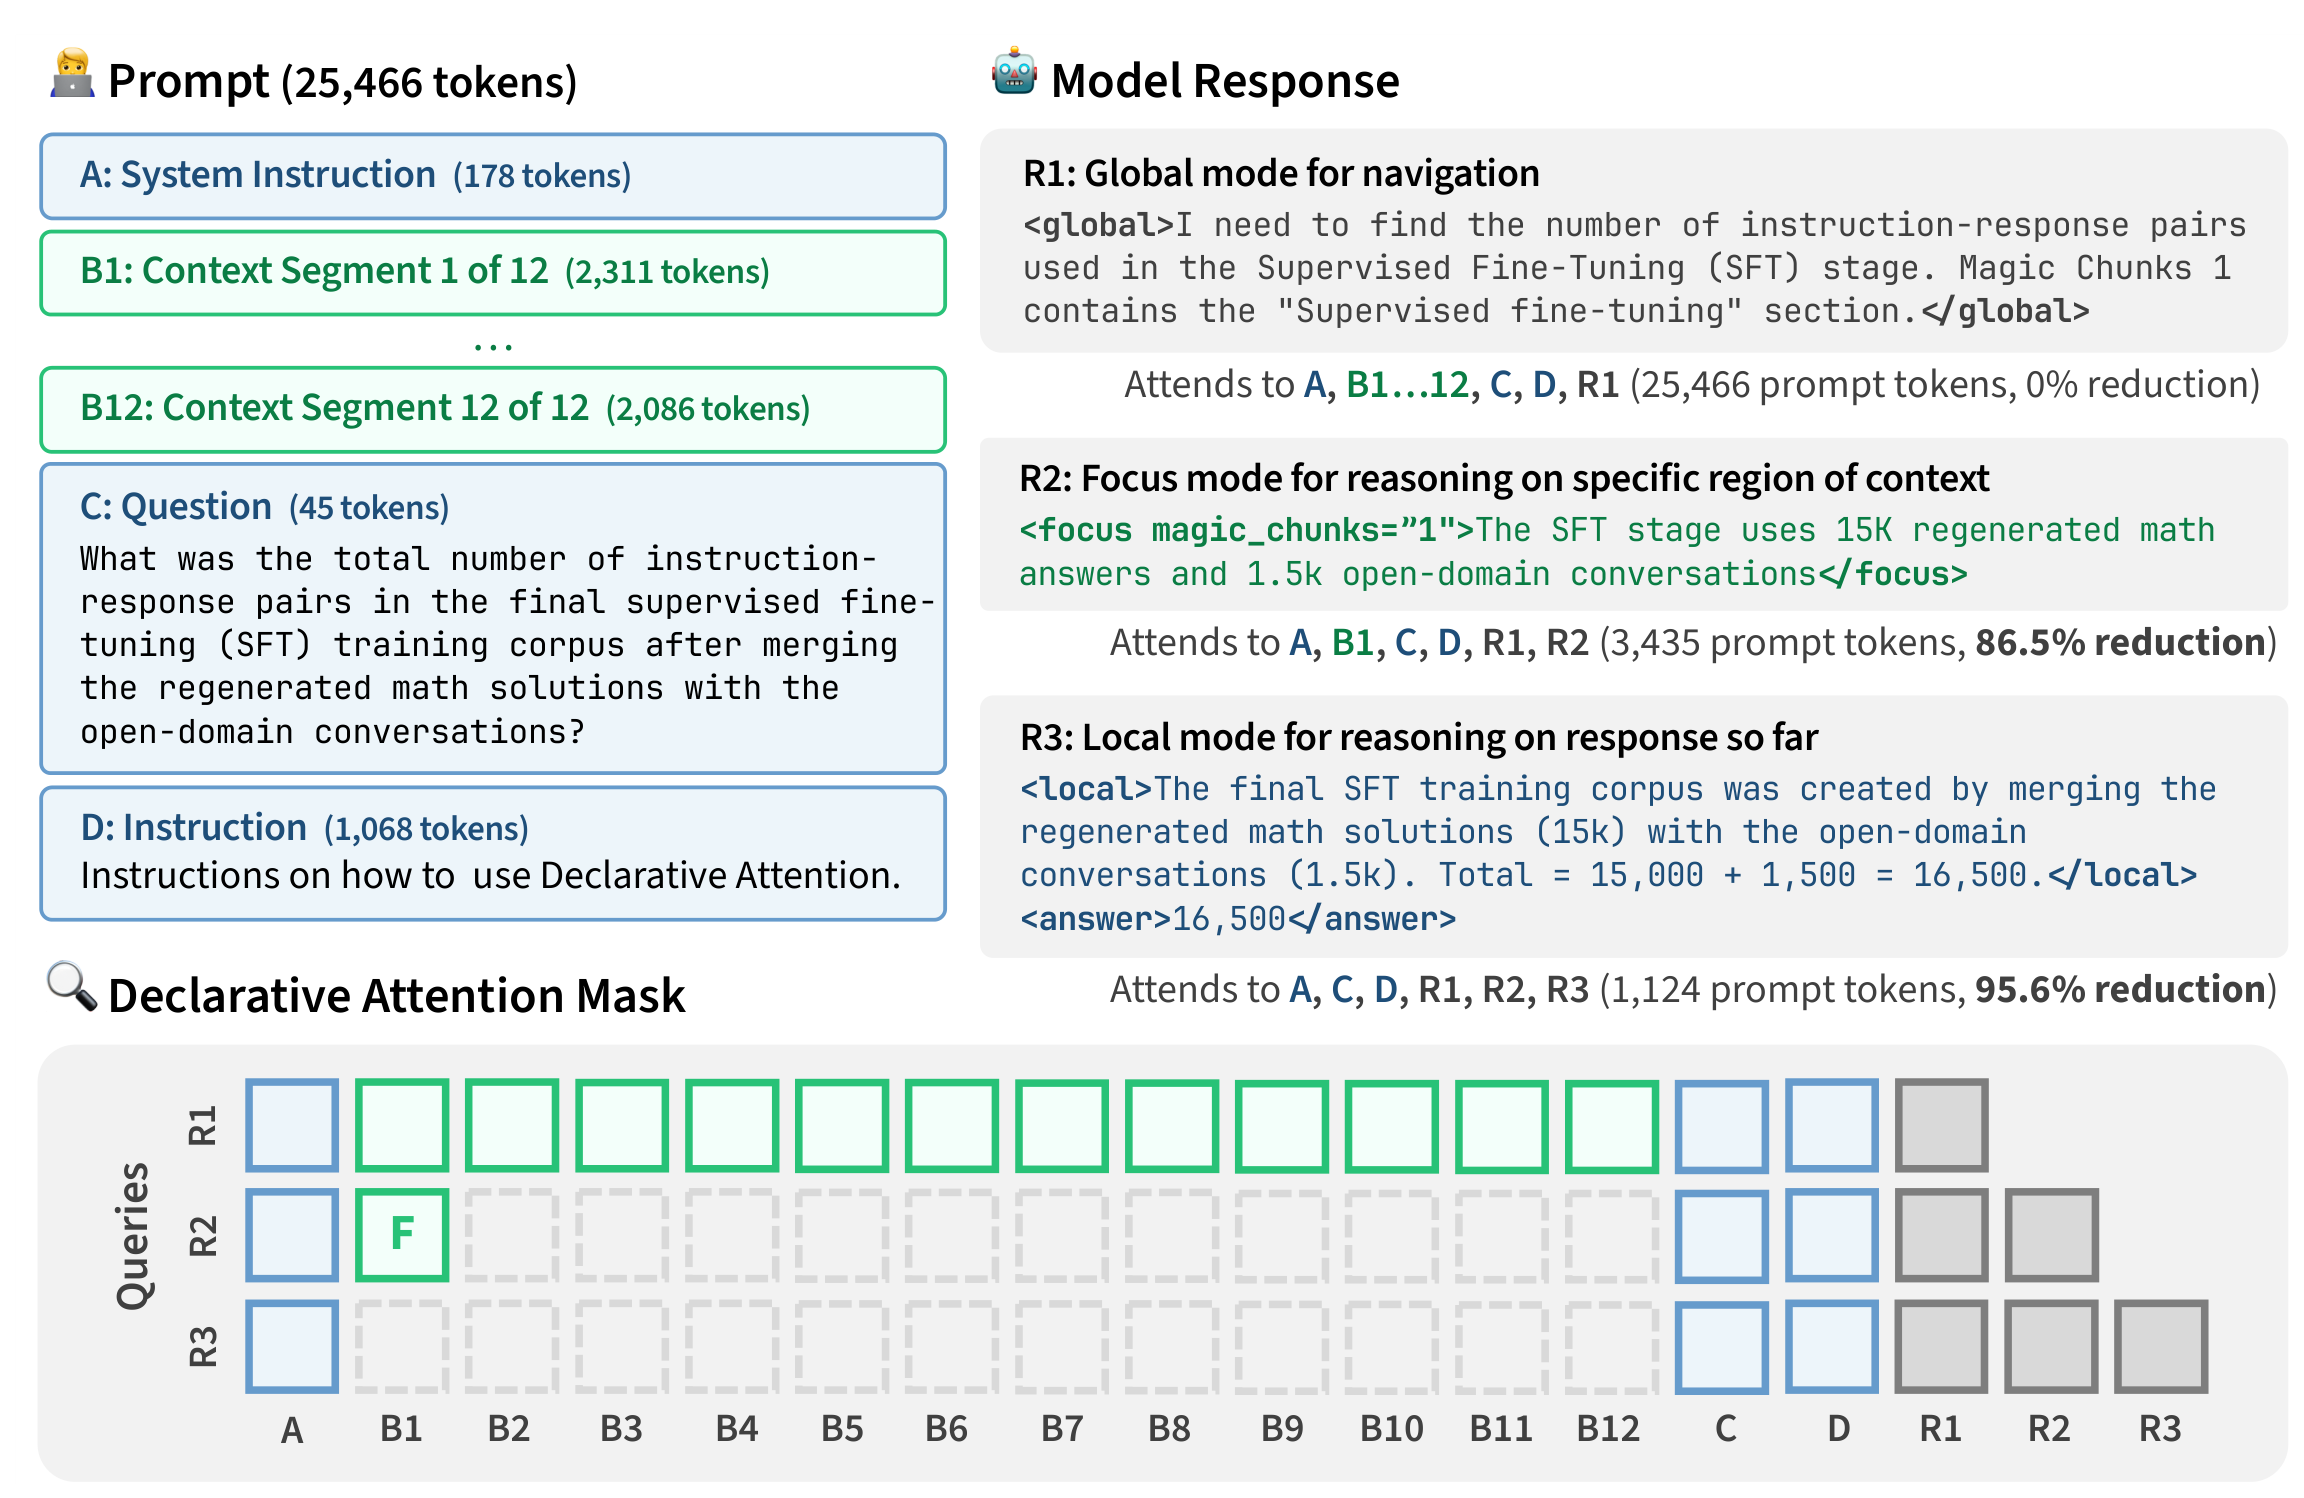
Figure 1. 모델은 전체 맥락을 탐색하다가 필요한 구간에 집중하고, 이미 얻은 정보만으로 답을 구성할 수 있다. 긴 입력을 제한해도 질문·지시문과 누적 응답은 계속 참조한다. 논문 v1, 1쪽 Figure 1에서 도판 영역을 추출해 인용.
DA는 긴 문서를 약 2천 토큰의 구간으로 나누고 번호를 붙인다. 모델은 세 모드로 읽는 범위를 바꾼다.
- Global: 전체를 보며 근거가 있는 구간을 찾는다.
- Focus: 지정한 구간을 읽고 필요한 정보를 추출한다.
- Local: 긴 입력을 다시 읽지 않고, 질문과 지금까지 응답에 모아 둔 정보로 계산하거나 답을 만든다.
회사 연혁의 예라면 먼저 전체를 보며 설립 연도가 있는 구간을 찾는다. 그 구간에서 연도를 꺼내 응답에 적고, 같은 방식으로 상장 연도를 찾는다. 두 값을 얻은 뒤에는 문서를 계속 읽는 대신 두 숫자를 빼면 된다.
이 과정에서 캐시 자체를 삭제하지는 않는다. 다시 전체를 탐색할 필요가 생기면 global로 돌아갈 수 있다. 따라서 중요한 내용을 영구히 버리는 압축이나 캐시 퇴출과는 다르다. 논문 §2
또 하나의 조건이 있다. 모델에게 태그만 출력하게 한다고 자동으로 빨라지지는 않는다. 논문은 vLLM 추론 엔진을 확장해 선언에 맞는 KV 블록만 읽도록 연결한다. 모델의 지시와 엔진의 실제 동작이 함께 바뀌어야 한다.
3. 더 길게 답해도 덜 읽을 수 있는가
논문은 세 조건을 비교한다. 원래 입력을 쓰는 Vanilla, DA의 구간 분할과 지시문만 쓰는 DA-no-mask, 그리고 선언에 맞춰 읽기까지 제한하는 DA다. 가운데 조건이 있어야 프롬프트를 바꾼 효과와 실제 읽기를 줄인 효과를 구분할 수 있다.
주 비교는 Gemma-4-31B와 Qwen-3.6-27B로 15개 장문 과제 소스를 평가한다. thinking을 끈 설정이며, 소스별 점수를 먼저 구한 뒤 15개를 같은 비중으로 평균한다. 정확도는 정답과 문항별 기준을 받은 LLM 판정자가 채점한 값이다.
| 모델 | Vanilla 정확도 | DA 정확도 | 정확도 변화 | 주의 토큰 감소 |
|---|---|---|---|---|
| Gemma-4-31B | 87.01% | 85.74% | −1.27%p | 52.0% |
| Qwen-3.6-27B | 85.31% | 82.56% | −2.75%p | 31.1% |
여기서 주의 토큰은 출력한 토큰 수가 아니라, 답을 생성하는 모든 단계에서 참조한 KV 위치의 누적량이다. 같은 위치를 여러 번 읽으면 여러 번 센다. 캐시에 저장된 서로 다른 토큰의 개수와도 다르다. 논문 §4–5
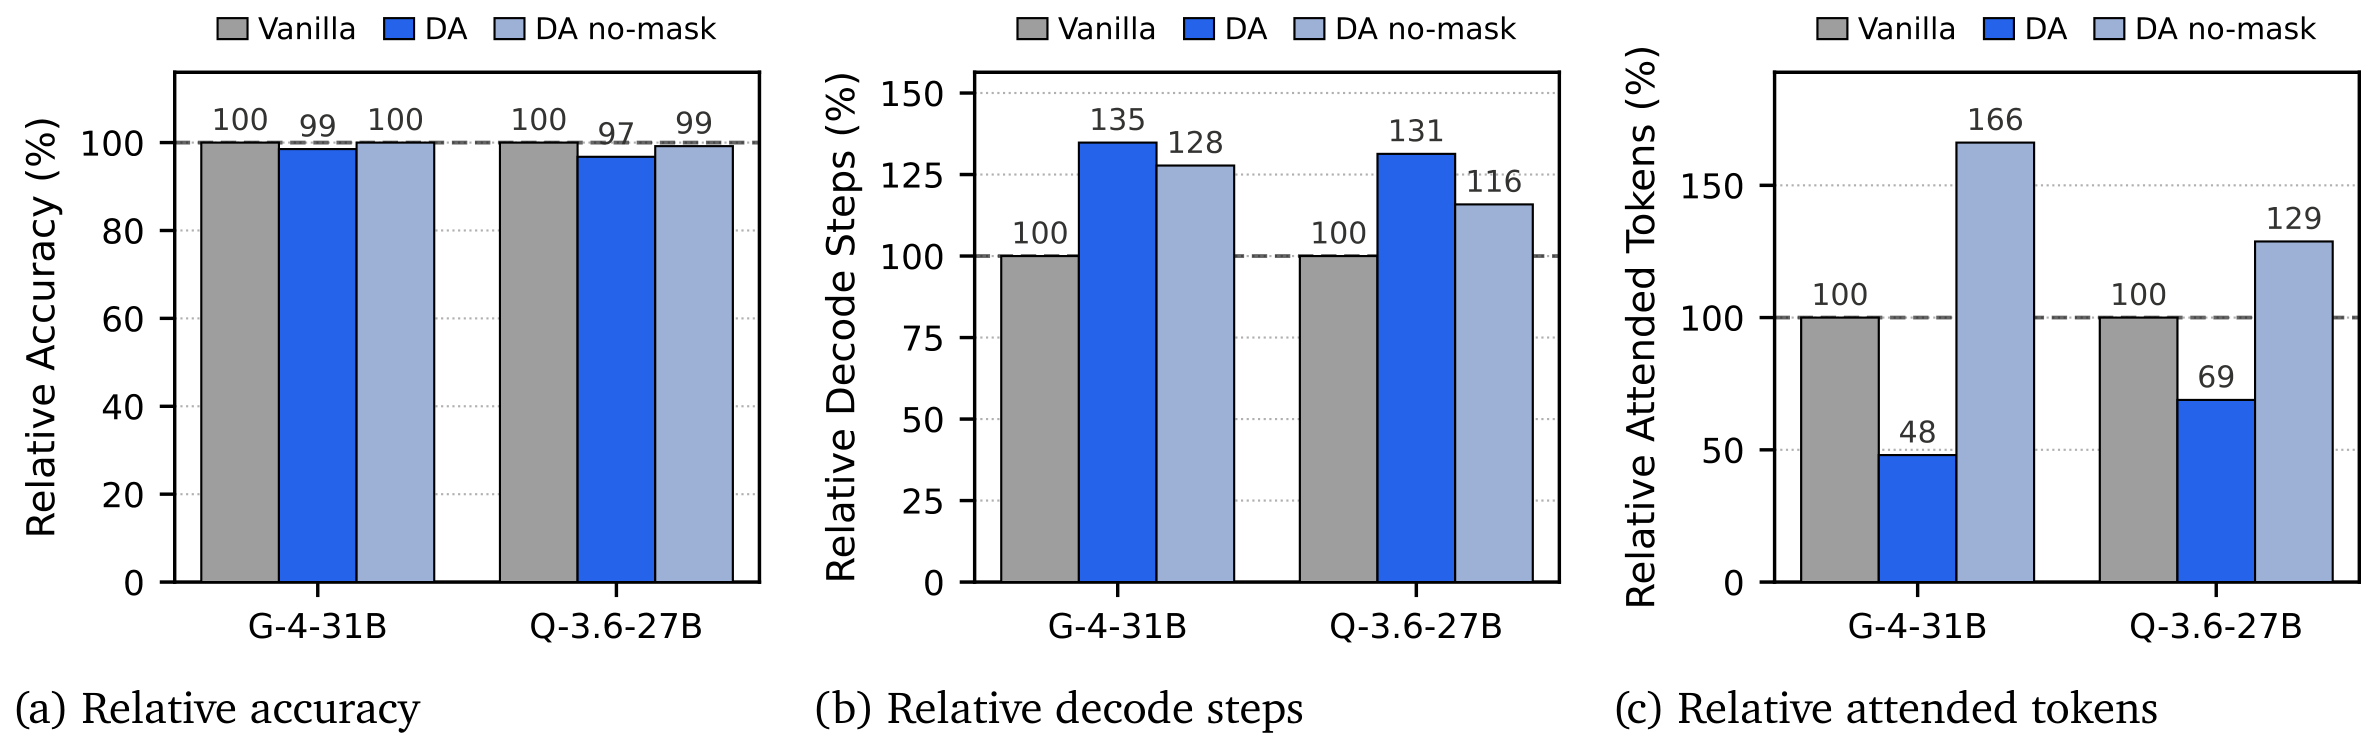
Figure 2. Vanilla를 100으로 두면 DA는 생성 스텝이 늘면서도 총 참조량은 줄어든다. 프롬프트만 바꾸고 읽기를 제한하지 않은 DA-no-mask에서는 참조량이 오히려 증가한다. 논문 v1, 9쪽 Figure 2에서 인용.
DA는 선언과 정보 추출을 위해 더 많은 토큰을 생성한다. 두 모델의 생성 스텝은 Vanilla보다 약 35%, 31% 많다. 그럼에도 각 단계에서 읽는 양을 줄여 응답 전체의 참조량을 낮춘다. 짧게 답해서 아끼는 방법과는 다른 교환이다.
마스크 없는 DA-no-mask의 평균 정확도는 Vanilla와 같거나 가깝지만 참조량은 더 많다. 반면 실제 마스크를 켜면 참조량이 줄고 정확도도 추가로 낮아진다. 이 결과는 선택적 읽기의 이득과 비용을 함께 보여 준다. 다만 평균이 비슷하다는 이유로 모든 과제에서 프롬프트 변경이 무손실이라고 말할 수는 없다.
4. 52% 덜 읽었다고 두 배 빨라지는 것은 아니다
언어 모델의 계산은 KV 읽기만으로 이루어지지 않는다. DA가 더 많은 토큰을 생성하면 다른 층의 계산도 더 반복한다. 일부 층은 애초에 짧은 창이나 고정 크기 상태를 사용하므로, 긴 맥락을 덜 읽는 마스크가 그 비용까지 줄여 주지는 않는다.
논문이 제시한 시간 배율은 Gemma에서 Vanilla의 0.71배, Qwen에서 0.77배다. 하지만 이는 실제 응답 시간을 재서 얻은 값이 아니다. B200 GPU의 연산 성능과 메모리 대역폭에 이용률을 가정하고, 관측한 생성량과 참조량을 넣어 계산한 추정이다.
입력을 처음 처리하는 프리필 비용은 포함하지 않으며, 동시 요청이 적은 서비스에 같은 이용률을 적용해서도 안 된다. 논문도 이런 조건을 명시한다. 따라서 이 연구가 보여 준 것은 특정 조건에서의 비용 절감 가능성이지, 어떤 서비스에서도 응답이 일정 비율로 빨라진다는 보장이 아니다. 논문 §5.4
5. 전체를 읽어야 하는 문제에는 잘 맞지 않을 수 있다
문서의 몇 군데에서 근거를 찾는 문제와, 모든 내용을 세거나 순서대로 정리하는 문제는 다르다. 전자는 필요한 정보를 모은 뒤 나머지 읽기를 생략할 여지가 크다. 후자는 특정 구간만 보면 빠뜨리는 정보가 생기기 쉽다.
논문 부록은 주 결과의 15개와 별도로 여섯 과제 소스의 실패 사례를 평가한다. 전체에서 수를 세거나 표 구조를 보존해야 하는 과제에서는 정확도가 크게 떨어진다. 구간별 요약처럼 출력이 문서 길이에 따라 늘어나는 과제에서는 한 단계의 참조량을 줄여도 응답 전체의 참조량이 증가한다.
이 여섯 소스의 Gemma-4-31B 평균은 정확도 63.28→54.26%, 주의 토큰 38.62→45.97M이다. 스텝당 읽기는 줄었지만, 전체적으로는 더 많이 읽고 덜 정확해진 결과다. 이 수치를 본문 15개 과제의 성능으로 바꿔 읽어서도 안 되지만, 반대로 헤드라인 절감률만 보고 모든 장문 작업에 적용해서도 안 된다. 논문 부록 D.4
답만 출력하라는 과제 지시와 단계별 선언이 충돌하는 경우도 있다. 저자들은 그런 이유로 일부 소스를 건너뛰었다고 밝힌다. 실무에서 중요한 질문은 “긴 문서인가”뿐 아니라 어떤 정보를 모아 어떤 형태의 답을 만들어야 하는가다.
6. 큰 모델의 결과를 작은 모델에 그대로 옮길 수 없다
규모 분석에서는 큰 모델일수록 DA의 정확도가 자신의 Vanilla 기준선에 가까워진다. 작은 Gemma-E4B는 Vanilla 정확도의 29%만 남고, 가장 큰 Gemma-4-31B는 약 99%를 유지한다. 이 29%와 99%는 절대 정답률이 아니라 각 모델의 기준선 대비 비율이다.
프로토콜을 따르는 능력도 제약이다. 유효한 구간 주소를 출력해야 하고, 필요한 근거를 고른 뒤 제한된 정보로 답할 수 있어야 한다. 다만 구간 주소가 유효하다는 것과 그 구간이 실제 정답 근거라는 것은 다르다. 논문의 집계값만으로 오류 원인을 모두 분리할 수는 없다.
규모 비교에는 다른 차이도 섞여 있다. Qwen은 작은 모델이 3.5, 큰 모델이 3.6이며, 모델별 입력 한도와 토크나이저 때문에 평가 문항이 달라질 수 있다. 따라서 파라미터 수만 늘리면 같은 비율로 개선된다는 법칙으로 읽기 어렵다. 논문 §5.2
개별 과제의 작은 정확도 차이도 신중하게 봐야 한다. 논문은 소스당 최대 128개라고 쓰지만 실제 평가 문항 수를 소스별로 명확하게 싣지는 않는다. 반올림된 정확도나 별도 판정자 검증 응답 수만으로 그 문항 수를 확정할 수 없다. 몇 %p 차이가 얼마나 안정적인지 판단하려면 평가 규모와 반복 실행의 변동이 함께 필요하다.
7. 선언을 실행 가능한 제어로 바꾸는 인터페이스
DA의 흥미로운 지점은 모델이 쓴 추론을 설명문으로만 두지 않는 데 있다. “어디를 볼 것인가”라는 선언을 추론 엔진이 실행해, 정보 접근 비용을 바꾼다. 이미 답에 필요한 정보를 얻었다면 긴 입력을 계속 읽지 않는 단계를 만들 수 있다는 것이다.
그 가치는 선언이 얼마나 그럴듯한지가 아니라, 정확도와 생성 길이, 실제 시스템 비용을 함께 보아야 판단할 수 있다. 필요한 근거가 좁은 구간에 모이고 답이 짧은 작업에는 유망하지만, 전체를 집계하거나 긴 출력을 만드는 작업에는 다른 설계가 필요할 수 있다.
후학습이나 도구 응답의 자연스러운 경계를 활용하는 에이전트 적용은 저자들이 제안한 확장 방향이다. 이번 실험으로 이미 확인한 성과는 아니다. 이 글도 원문과 표를 대조한 리뷰이며, 모델 실행과 지연시간 실험을 독립적으로 재현한 것은 아니다.
블록 마스크, 시간 추정의 가정, 표본 수와 판정 절차까지 살펴본 글은 상세 읽기에서 이어진다.
References
Ho, N., Ahmad, H., Koh, W., Yun, S.-Y., Schuster, T., & Nogueira dos Santos, C. (2026). Language Models Can Control Their Own Attention. arXiv:2609.02737v1.