InCoder-32B-Thinking: Industrial Code World Model for Thinking
코드가 실패한 기록으로 배우기 — InCoder-32B-Thinking 쉽게 읽기
InCoder-32B-Thinking은 실제 실행 오류와 수정 기록으로 추론 데이터를 만들고 실행 결과를 예측하는 모델로 그 과정을 늘린다. 코드 추론 성능은 높아졌지만, 예측 모델이 실제 툴체인을 대신해 정답을 보증하는 것은 아니다.
Paper: Jian Yang; Wei Zhang; Jiajun Wu; Junhang Cheng; Tuney Zheng; Fanglin Xu; Weicheng Gu; Lin Jing; Yaxin Du; Joseph Li; Yizhi Li; Yan Xing; Chuan Hao; Ran Tao; Ruihao Gong; Aishan Liu; Zhoujun Li; Mingjie Tang; Chenghua Lin; Siheng Chen; Wayne Xin Zhao; Xianglong Liu; Ming Zhou; Bryan Dai; Weifeng Lv (2026). "InCoder-32B-Thinking: Industrial Code World Model for Thinking" (arXiv:2604.03144v1, 2026-04-03). 논문 · PDF · GitHub · 가중치
한눈에 보기: GPU 커널, 칩 설계, 펌웨어처럼 실행 환경이 복잡한 코드에서는 ‘그럴듯한 코드’를 쓰는 것만으로 부족하다. 컴파일러 오류, 메모리 제한, 시뮬레이터의 진단을 읽고 고쳐야 한다. InCoder-32B-Thinking은 실제 실행의 실패와 수정 과정을 추론 데이터로 만들고, 그 실행 결과를 예측하는 별도 모델로 데이터 생성을 늘린다. 논문은 코드 추론과 일부 산업 벤치마크에서 높은 점수를 보고한다. 다만 실행을 예측하는 모델은 실제 컴파일러나 시뮬레이터가 아니며, 모든 코딩 업무에서 성능이 좋아졌다는 결과도 아니다.
1. 산업용 코드에서 어려운 것은 코드 다음에 일어난다
CUDA 커널 하나를 만든다고 생각해 보자. 문법이 맞아도 공유 메모리를 너무 많이 쓰면 실행되지 않는다. Verilog 코드도 문장이 그럴듯해 보이는 것과 테스트벤치·합성 도구를 통과하는 것은 다르다. 펌웨어라면 메모리 배치와 헤더, 링커 설정이 함께 맞아야 한다.
사람 엔지니어는 보통 한 번에 정답 코드를 쓰지 않는다. 코드를 내고, 도구가 돌려준 오류를 읽고, 원인을 추측하고, 수정한 뒤 다시 실행한다. 그런데 공개 코드 말뭉치에는 완성본은 많아도 이 과정의 기록은 적다. 논문은 바로 이 기록의 부재를 다룬다. 답만 학습하는 대신, 실패를 어떻게 다음 수정의 근거로 바꾸는가를 학습시키려 한다.
2. 첫 번째 장치: 실제 오류를 따라가는 ECoT
논문의 Error-driven Chain-of-Thought, 줄여서 ECoT는 이 기록을 만드는 절차다. 과제에는 코드 조각뿐 아니라 코드를 검사하고 실행하는 데 필요한 파일과 설정도 들어간다. 칩 설계라면 동작을 확인할 테스트와 합성 도구 설정을, 펌웨어라면 메모리 배치와 빌드 설정을 함께 묶는다. 그래야 모델이 낸 코드가 어떤 조건에서 검증되는지 정해진다.
생성기는 먼저 추론과 후보 코드를 낸다. GPU 코드는 컴파일러와 실행기, 칩 설계 코드는 시뮬레이터와 합성 도구, 펌웨어는 가상 실행 환경에서 검사한다. 3D 모델링 코드도 실제 형상을 만드는 도구로 검증한다. 결과는 PASS만이 아니다. 컴파일 오류, 메모리 부족, 기하 오류와 진단 로그가 다음 입력으로 돌아간다. 모델은 그 피드백을 읽고 수정한 코드와 다음 추론을 낸다. 논문은 최대 네 번의 수정 라운드를 허용한다. 논문 §2.2
ECoT는 성공한 마지막 코드만 남기지 않고 실패한 중간 턴도 보존한다. 예를 들어 커널이 공유 메모리 한도를 넘었다는 진단이 왔을 때, 다음 턴에 블록 크기를 어떻게 고쳤는지를 함께 데이터로 남긴다. 이 흐름이 실제 실행을 통해 만든 궤적이다. 즉 ECoT는 모델이 상상으로 오류 메시지를 꾸며 내게 하는 방식이 아니라, 적어도 초기 수집 단계에서는 실제 도구가 돌려준 관측에서 출발한다.
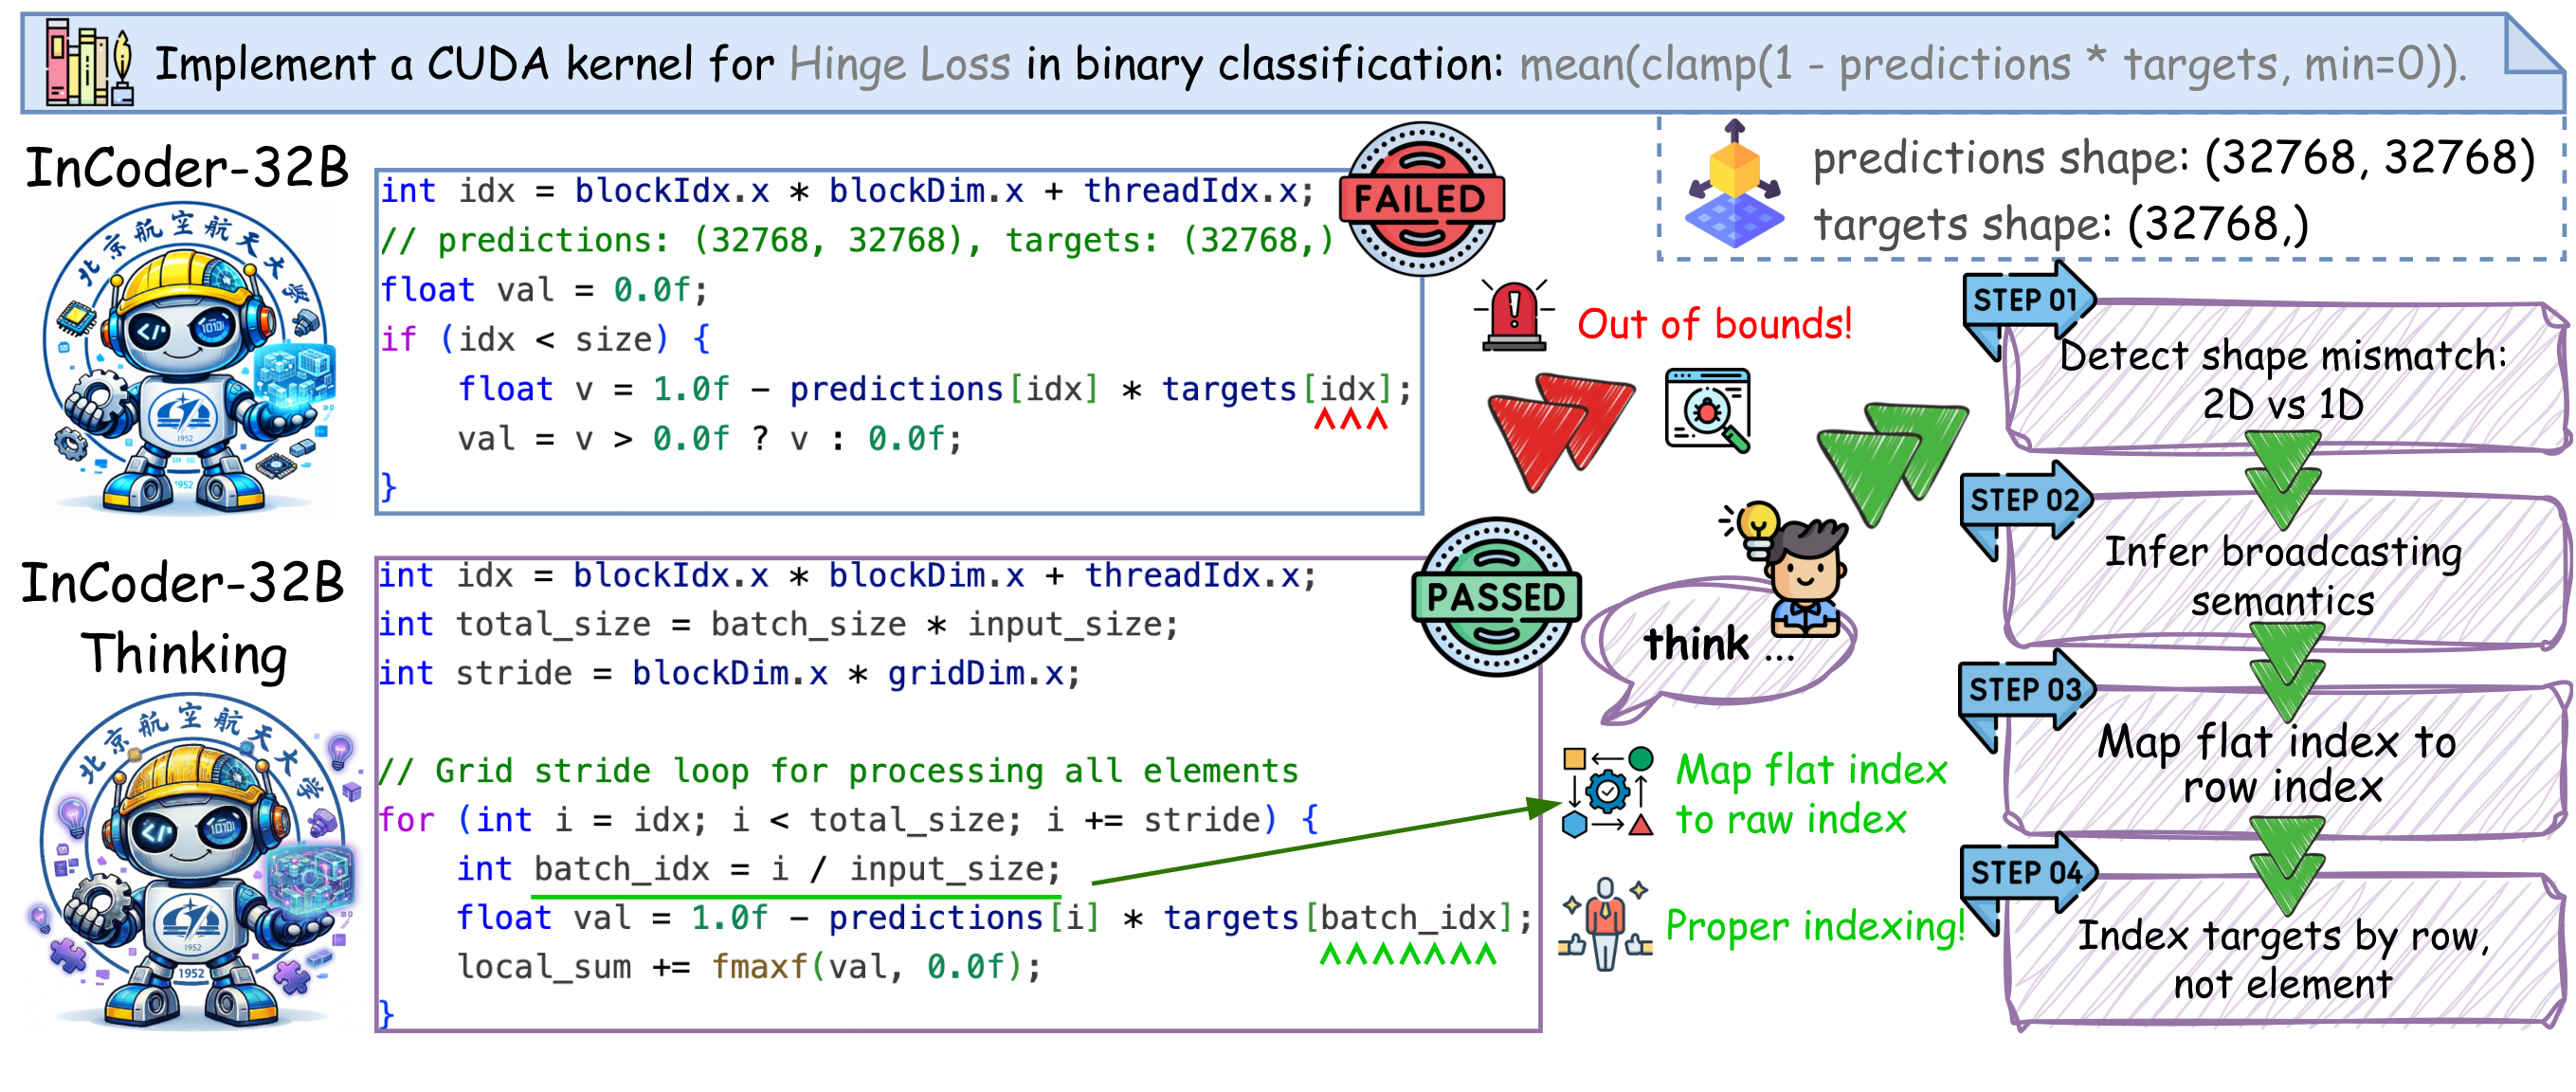
코드의 모양만 보는 대신, 실행 오류를 읽고 배열의 차원과 인덱스가 어떻게 맞아야 하는지 따져 수정한 사례다. 한 커널의 예시이므로 다른 작업에서도 같은 빈도로 오류를 고친다는 성능 증거는 아니다. 원논문 Figure 3, p. 2을 그대로 인용했다(arXiv:2604.03144v1).
3. 두 번째 장치: 실행 자체가 아니라 실행 결과를 예측하는 ICWM
실제 백엔드를 매번 부르면 비용도 크고 환경 운영도 까다롭다. 그래서 논문은 Industrial Code World Model, ICWM을 따로 학습한다. ICWM은 과제의 실행 환경과 후보 코드를 받아서, 실제 도구가 어떤 결과와 진단을 돌려줄지 예측하는 언어 모델이다.
ICWM은 실제 실행과 다르다. ICWM은 컴파일러·GPU·시뮬레이터의 물리적 동작을 직접 실행하는 제품이 아니다. 이전의 실제 실행 기록에서 배운 **대리 환경(proxy)**이다. 학습한 뒤에는 합성 루프에서 실제 백엔드 대신 피드백을 낼 수 있어, 더 많은 오류 수정 궤적을 싸게 만들 수 있다. 논문은 일부 실제 실행을 다시 점검하는 방식으로 이 예측기를 보정한다고 설명한다. 논문 §2.3
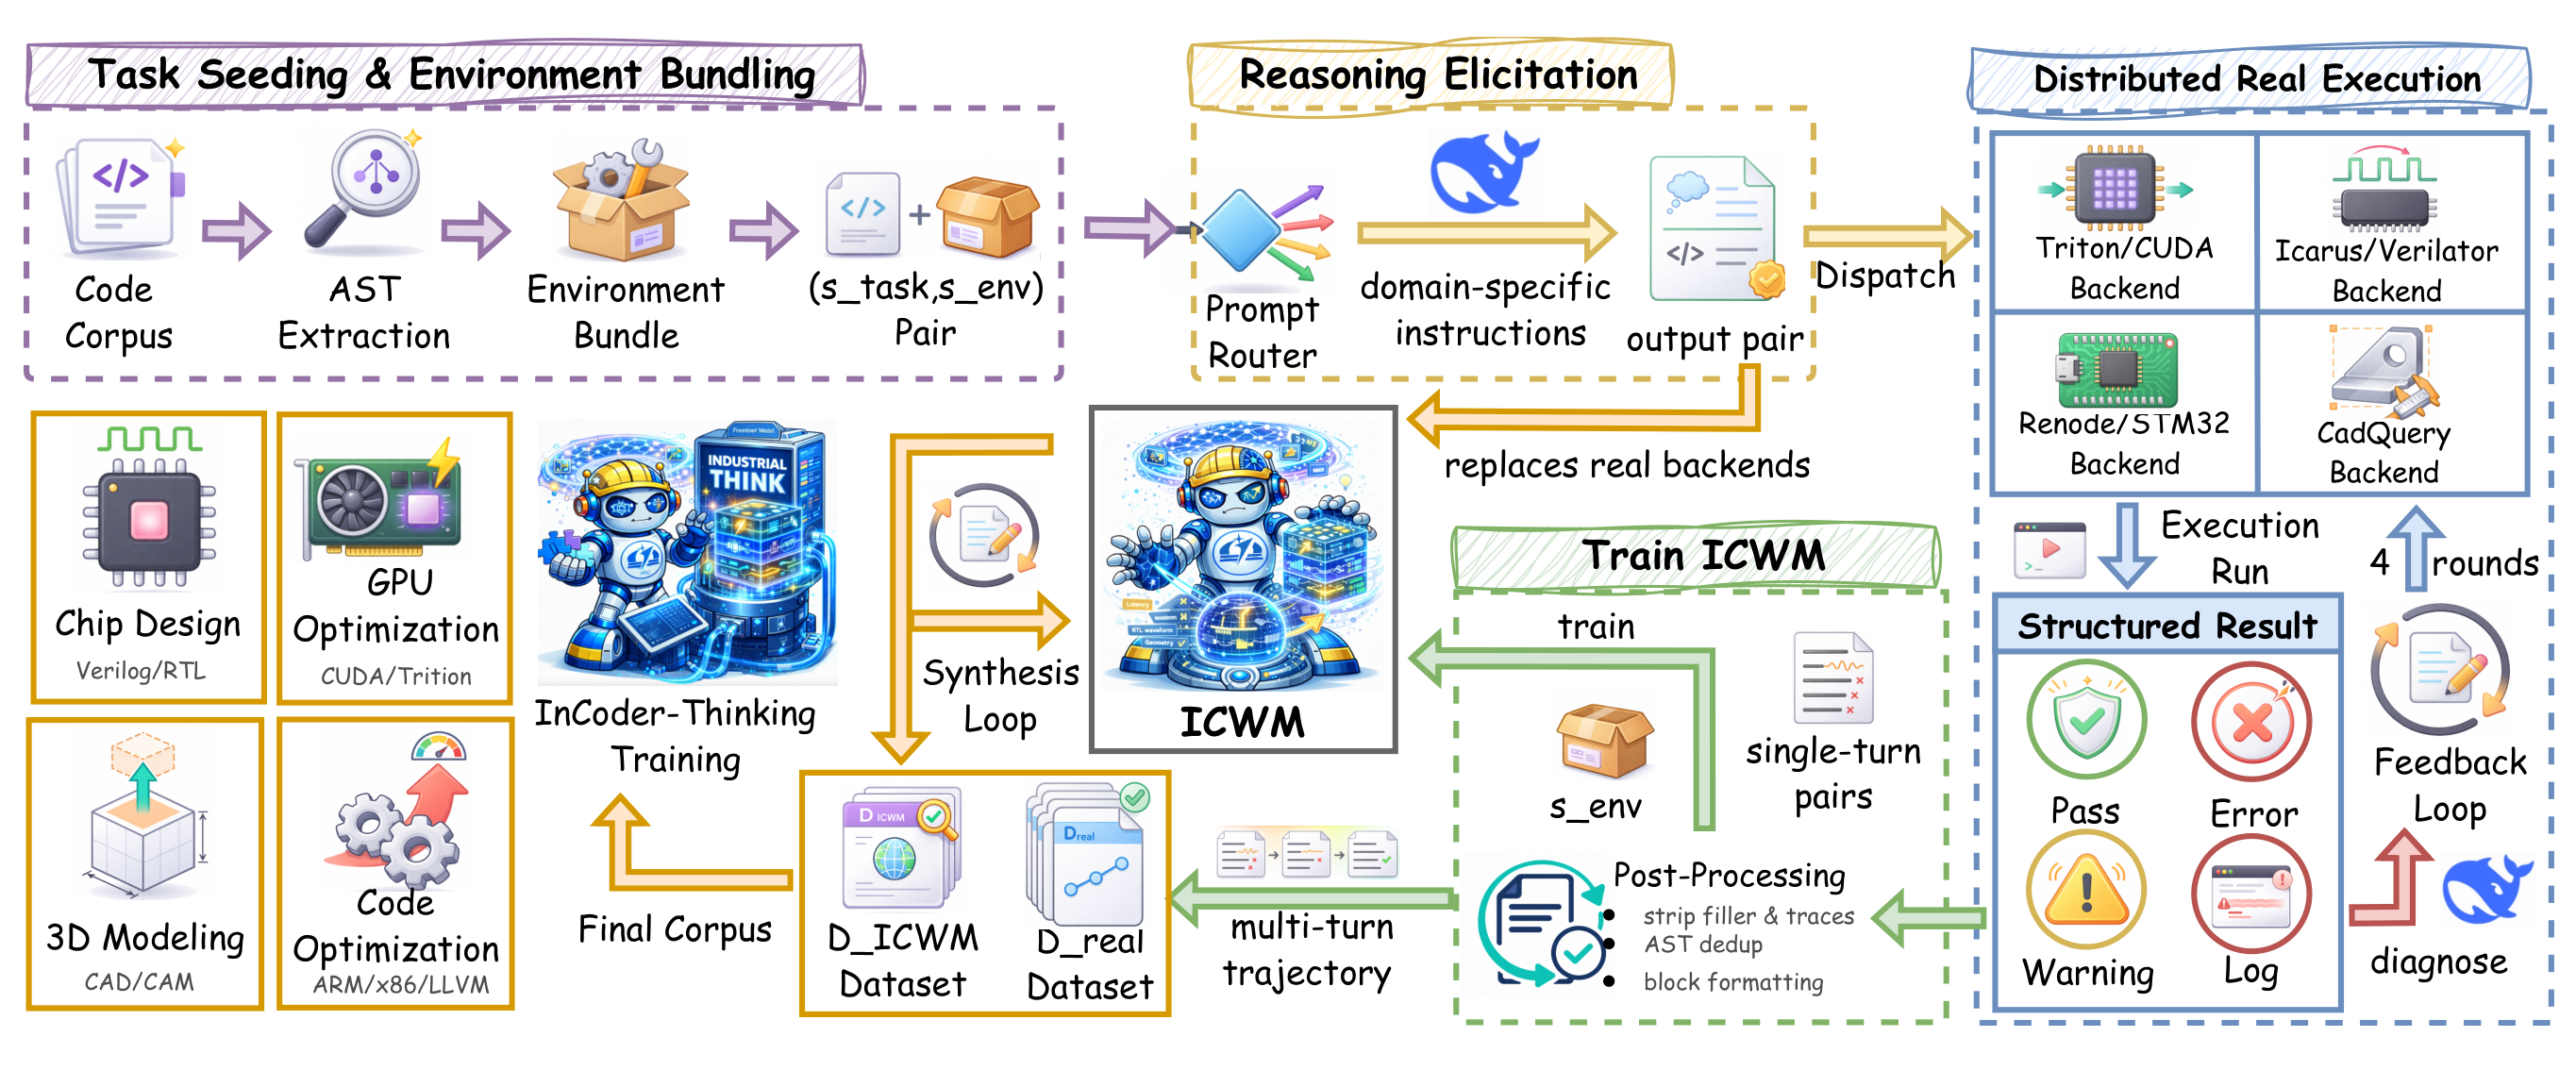
실제 도구가 돌려준 결과로 기록을 모은 뒤, 그 기록으로 학습한 ICWM을 합성 루프에 넣는다. 실제 실행과 예측 피드백을 구별해서 보면, ICWM이 검증을 보증하는 장치가 아니라 데이터를 늘리는 보조 환경임을 알 수 있다. 원논문 Figure 4, p. 4을 그대로 인용했다(arXiv:2604.03144v1).
| 단계 | 무엇을 하나 | 얻는 것 | 잊으면 안 될 점 |
|---|---|---|---|
| 실제 실행 수집 | 코드 실행 뒤 오류·로그를 다음 턴에 되돌림 | 근거가 있는 수정 궤적 | 느리고 운영 비용이 든다 |
| ICWM 학습 | 실제 실행 턴에서 결과를 예측하도록 학습 | 빠른 대리 환경 | 예측이 실제 결과와 같다는 보장은 없다 |
| 데이터 증폭 | ICWM 피드백으로 추가 수정 궤적 생성 | 더 많은 추론 학습 데이터 | 감사 비율과 합성 비율이 논문에 충분히 공개되지 않았다 |
| 최종 코드 모델 학습 | 실제+합성 궤적으로 학습 | InCoder-32B-Thinking | 어느 장치가 성능을 얼마나 올렸는지 분리 측정되지 않았다 |
논문은 ICWM이 한 번의 실행 결과를 맞힌 평균 비율을 96.7%로 보고한다. 여러 수정 턴을 거친 뒤 실제 실행과 최종 성공·실패 판정이 같았던 비율은 94.4%였다. 중간의 모든 수정 과정이 같았다는 뜻은 아니다. 이 값은 다섯 도메인에서 학습에 쓰지 않고 남겨 둔 실행 자료로 측정했다. 3D 모델링에서는 각각 95.9%, 93.1%로 차이가 가장 컸다. 논문이 제시한 사례에서는 실제 3D 모델링 도구인 CadQuery가 퇴화한 기하 구조에 오류를 냈는데, ICWM은 코드가 문법적으로 보인다는 이유로 PASS를 예측했다. 논문 §4.1, Figure 5
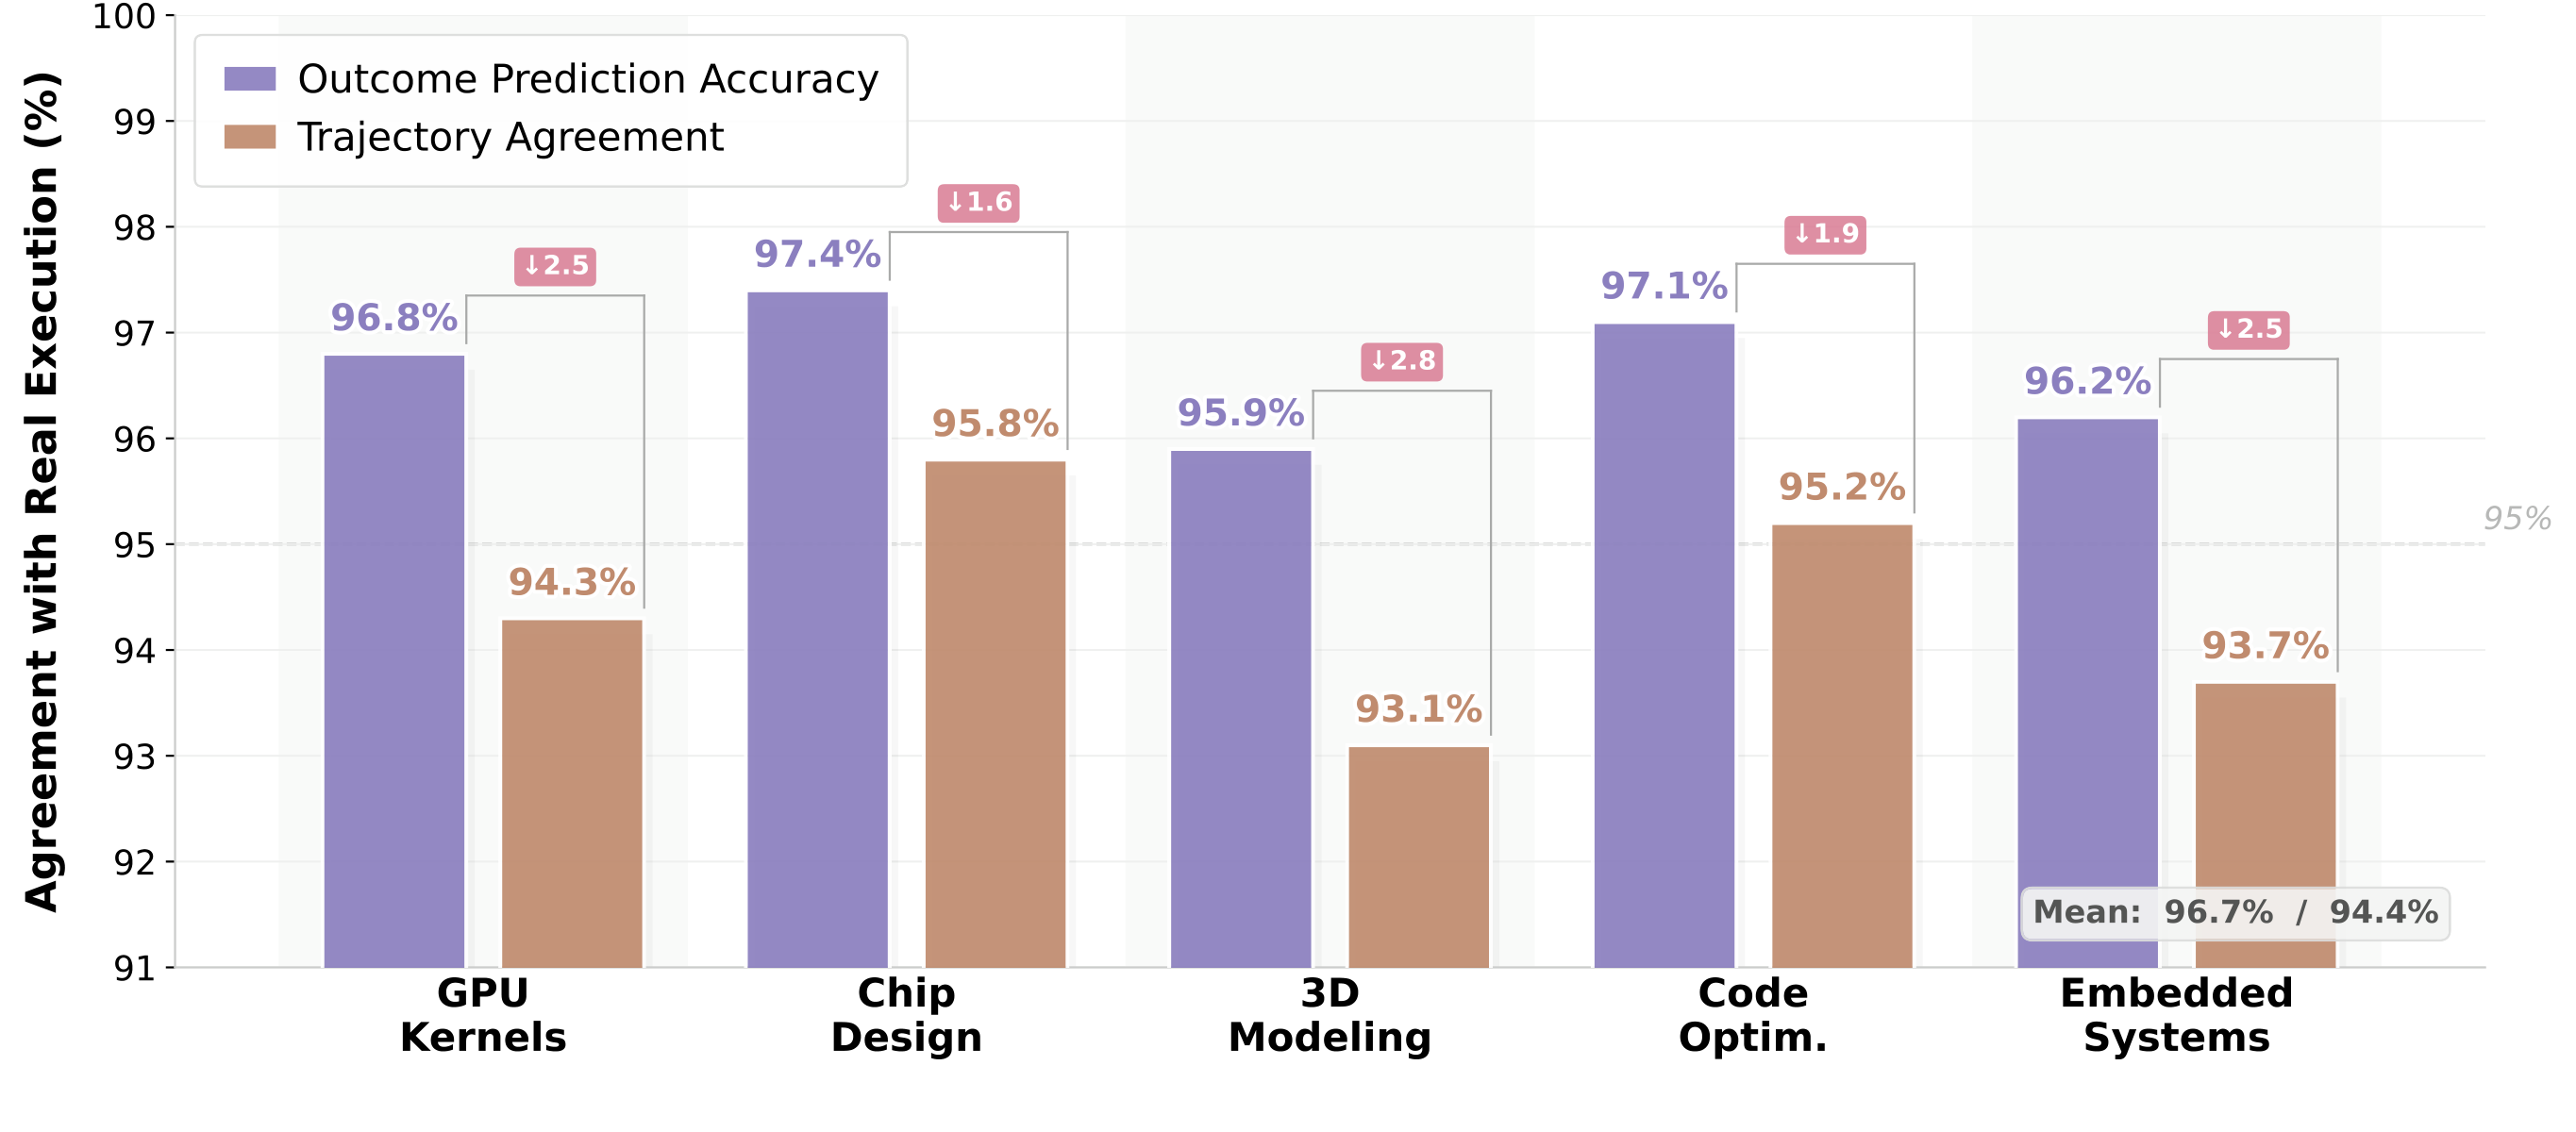
보라색은 한 실행 결과를 맞힌 비율이고, 갈색은 여러 수정 턴 뒤 최종 성공·실패 판정이 같았던 비율이다. 세로축이 91%에서 시작하므로 막대 높이 차이를 과장해 읽지 말아야 하며, 갈색 막대가 중간 수정 과정 전체의 일치를 뜻하지도 않는다. 원논문 Figure 5, p. 10을 그대로 인용했다(arXiv:2604.03144v1).
따라서 96.7%를 ‘이제 실제 실행이 필요 없다’로 읽을 수는 없다. 한 번의 예측 오류는 다음 수정 방향을 바꾸고, 특히 거짓 PASS는 모델이 더 고칠 필요가 없다고 믿게 만들 수 있다. 논문도 주기적 실제 실행 점검을 말하지만, 얼마나 자주 어떤 표본을 점검했는지는 제시하지 않는다.
4. 숫자는 어떤 질문에 답하는가
InCoder-32B-Thinking은 14개 일반 코드 벤치마크와 9개 산업 벤치마크에서 평가됐다. 논문 초록은 LiveCodeBench v5 81.3%, CAD-Coder 84.0%, KernelBench L2 38.0%를 제시한다. 하지만 이 숫자는 같은 단위의 시험 점수가 아니다. LiveCodeBench는 코드 문제 풀이, CAD-Coder는 3D 모델링 관련 지표, KernelBench L2는 GPU 커널 최적화 난이도 층을 가리킨다. 세 숫자를 평균 내어 ‘산업 코딩 성공률’이라고 부를 수 없다. 논문 Abstract, Tables 2·5
같은 계열의 InCoder-32B instruct 판본과 대조하면 변화도 한 방향이 아니다. LiveCodeBench v5는 77.1에서 81.3으로, CruxEval Output-COT는 73.9에서 95.5로 올랐다고 보고된다. 반면 코드 효율을 보는 Mercury, Text2SQL의 Bird·Spider, 일부 도구 사용·에이전트 코딩 지표는 instruct 판본보다 낮다. 논문 Tables 2–3
비교한 두 모델은 학습 데이터량도 다르다. 논문은 Thinking 판본의 사고 학습 데이터 540M 토큰을 선행 InCoder-32B에 쓰인 250M 토큰과 비교한다. M은 백만을 뜻한다. ECoT, ICWM으로 늘린 데이터, 교사–학생 학습 등도 함께 쓰였다. 어느 요소가 점수 차이를 만들었는지 따로 떼어 비교하지 않았으므로, 이 결과만으로 ECoT나 ICWM의 효과를 분리할 수는 없다. 논문 §4.3, Figure 7
5. 적용 전에 확인할 것
이 논문의 가장 재사용하기 좋은 아이디어는 ‘실패 로그도 학습 데이터’라는 관점이다. 도메인별 테스트·시뮬레이터·컴파일러가 있고, 실패 원인이 다음 행동을 고르는 데 의미가 있다면, 실제 실행 궤적을 보존하는 방식은 설득력이 있다.
다만 도입 판단은 별도다. 과제와 실행 환경을 다시 실행할 수 있는 형태로 묶고 예측 모델의 거짓 PASS를 실제 검증으로 어떻게 잡을지 정해야 한다. 이어서 실제 실행만 쓴 데이터와 대리 환경으로 늘린 데이터를 분리해 측정해야 한다. 논문에 공개된 점수는 이런 설계가 가능함을 보여 주지만, 운영 환경에서 검증을 생략해도 된다는 증거는 아니다.
6. 실행 기록을 학습에 쓴다는 것
InCoder-32B-Thinking은 ‘코드가 생각을 잘하게 한다’는 추상적 주장보다, 실제 실행의 오류와 수정 과정을 데이터로 만들고 그 비용을 예측 모델로 줄이려는 구체적 경로를 제시한다. 이 경로는 코드 추론과 일부 산업 과제에서 좋은 결과와 연결됐지만, 예측은 실행이 아니며 성능은 과제마다 엇갈린다. 월드 모델은 자동 채점기로 보기 어렵고 실제 검증을 계속 붙여야 하는 빠른 데이터 생성 보조자로 읽는 편이 가장 안전하다.
더 긴 방법·벤치마크 열별 비교·수치 불일치 검토는 상세 읽기에서 이어진다.
References
Yang, J., Zhang, W., Wu, J., Cheng, J., Zheng, T., Xu, F., Gu, W., Jing, L., Du, Y., Li, J., Li, Y., Xing, Y., Hao, C., Tao, R., Gong, R., Liu, A., Li, Z., Tang, M., Lin, C., et al. (2026). InCoder-32B-Thinking: Industrial Code World Model for Thinking (arXiv:2604.03144v1). arXiv. https://arxiv.org/abs/2604.03144v1