Agent Memory Distillation: Empowering Small LLM Agents with Hierarchical Teacher Memory
작은 에이전트에게 교사의 경험을 건네는 세 겹의 메모리
AMD는 교사의 성공 경험을 전체 계획·하위 과제·함수 호출 메모리로 나눠, 작은 에이전트가 가중치 갱신 없이 활용하게 한다. 세 도구 사용 벤치마크에서 성능이 개선됐으며, 평가 과제의 교사 경험이 메모리에 포함됐는지에 따라 결과를 구분해야 한다.
Paper: Taeil Kim; Kangsan Kim; Sung Ju Hwang (2026). "Agent Memory Distillation: Empowering Small LLM Agents with Hierarchical Teacher Memory". arXiv:2608.07169v1 / PDF
작은 언어 모델 에이전트는 도구를 몇 번 잘못 써도 행동 예산을 빠르게 소진한다. 강한 교사의 성공 기록을 그대로 주는 방법은 있어 보이지만, ‘음악을 재생하기 전에 로그인하라’ 같은 문장만으로는 작은 모델이 어떤 API를 어떤 인자로 호출해야 하는지 알기 어렵다. Agent Memory Distillation(AMD)은 교사의 성공 궤적을 학생이 실제로 쓸 수 있는 세 수준의 외부 메모리로 다시 만든다. 학생 가중치를 학습시키지 않고 prompt와 오류 후 검색으로 경험을 전달한다는 점이 출발점이다.
1. 기록을 많이 주는 것과 실행할 수 있게 주는 것은 다르다
논문은 작은 학생이 스스로 쌓은 실패·성공 기록만으로 메모리를 진화시키기 어렵고 교사 기록을 통째로 옮기면 능력 차이 때문에 따라 하지 못할 수 있다고 본다. AMD는 성공한 교사 궤적만 골라, 전체 목표를 푸는 Workflow, 중간 작업을 끝내는 Subtask, 실패한 함수 호출을 고치는 Function 메모리로 바꾼다.
예를 들어 “이번 달 Venmo 송금액을 합산하라”는 과제라면 Workflow는 인증→거래 조회→금액 합산이라는 큰 순서를 준다. Subtask는 인증과 페이지 순회가 포함된 실제 도구 호출 예시를 준다. Function은 오류가 난 venmo.login의 username 형식 같은 호출 규칙을 알려 준다. 셋은 같은 정보를 반복하지 않는다. 계획·실행 단위·오류 복구라는 서로 다른 빈칸을 채운다.
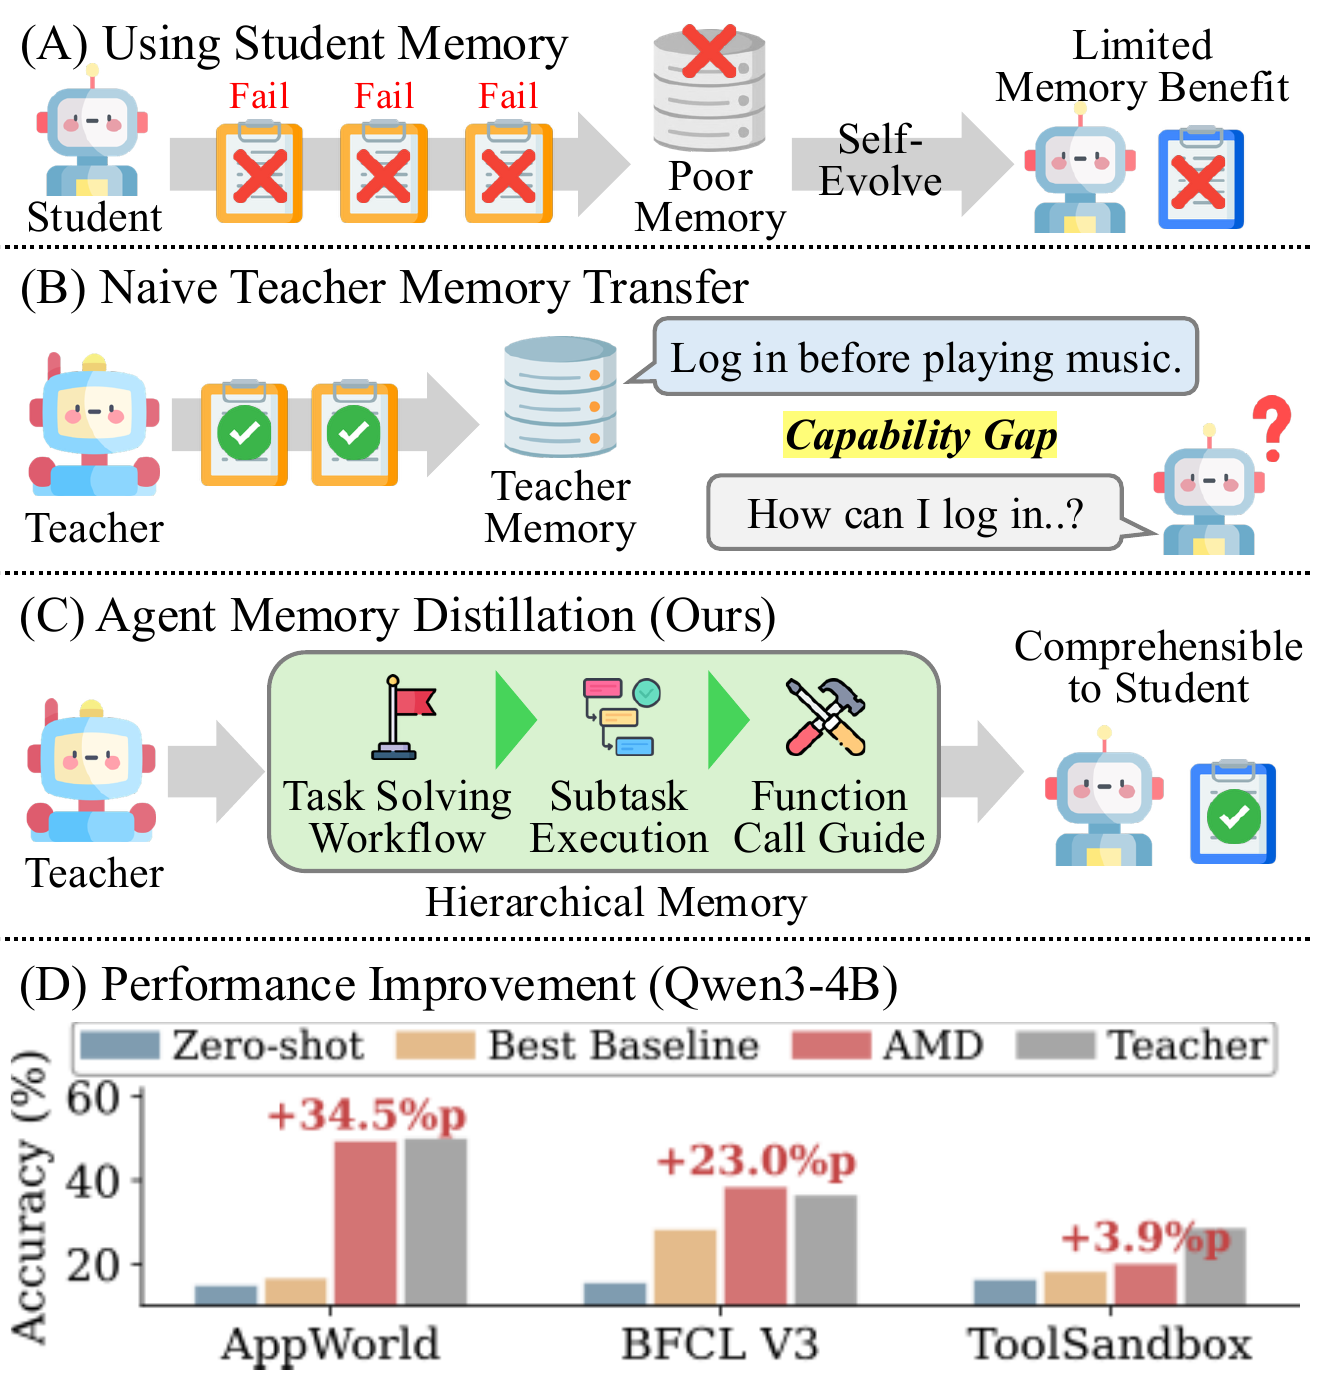
그림 1. Kim et al. (2026), Figure 1, PDF p. 1의 원도판이다. 위는 학생 자신의 빈약한 메모리, 가운데는 교사의 추상 조언과 학생 실행 사이 capability gap, 아래는 세 단계 메모리를 대비한다. 하단 Qwen3-4B 막대는 본평가 결과이며 과제 분리 결과가 아니므로, 새 과제 일반화의 직접 증거로 읽으면 안 된다.
2. 주입 시점도 메모리 종류에 맞춘다
논문 Algorithm 1의 설명에서는 Workflow와 Subtask를 학생이 첫 행동을 내기 전에 system prompt에 넣는다. 정상 실행을 시작하기 전 ‘무엇을 하려는가’와 ‘유사 작업이 어떻게 끝났는가’를 보게 하려는 선택이다. Function 메모리는 반대로 오류 관찰 뒤에 가져온다. 함수 설명과 call example을 처음부터 모두 넣으면 긴 context가 실행을 방해할 수 있기 때문이다. 다만 공개 BFCL 실행 예는 Workflow를 첫 turn에 고정하면서 Subtask를 매 turn 다시 검색해 system prompt의 해당 부분을 바꾼다. 이 동적 경로가 논문 Table 1·2의 정확한 실행 설정인지는 공개 매핑만으로 확인되지 않아, ‘모든 benchmark에서 시작 전 한 번만 Subtask를 주입했다’고 일반화할 수는 없다.
이 설계는 프로그래머에게 설명서와 디버그 로그를 한꺼번에 읽히지 않는 것과 비슷하다. 처음에는 전체 절차와 관련 예시로 방향을 잡고, 실제 오류가 생기면 그 함수의 사용법만 확인한다. 다만 오류를 정확히 분류하고 맞는 Function 메모리를 검색해야 효과가 난다. 논문은 메모리 검색 자체의 완벽한 정확도나 임의 API에 대한 보장을 주장하지 않는다.
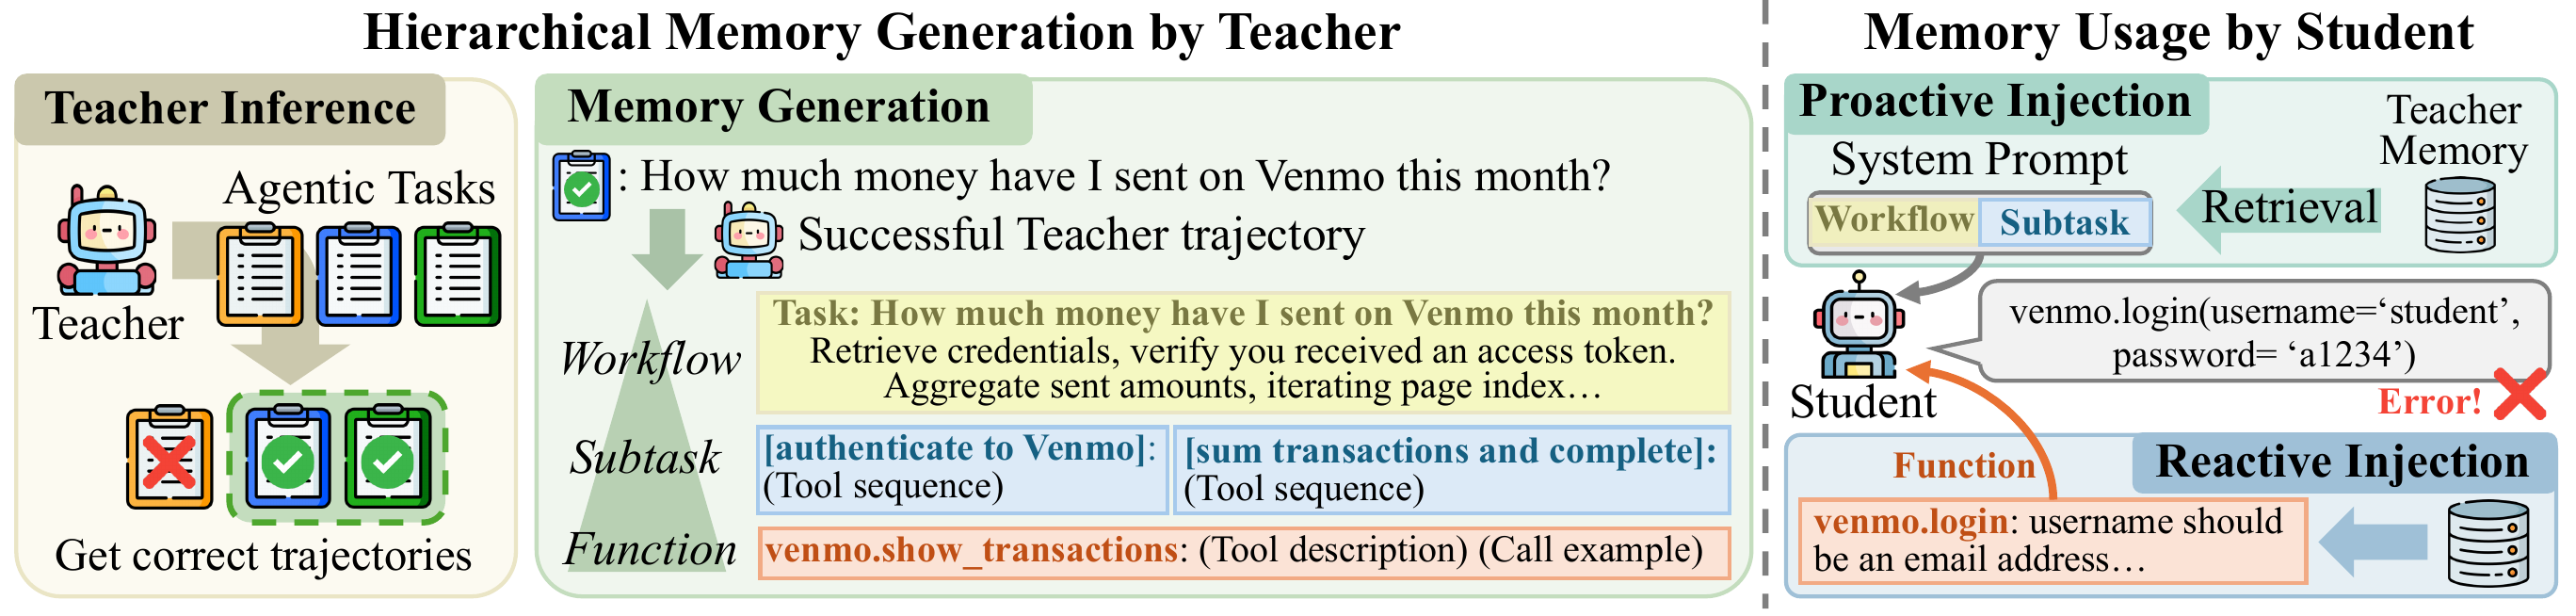
그림 2. Kim et al. (2026), Figure 2, PDF p. 4의 원도판이다. 성공 궤적에서 Workflow·Subtask·Function을 만든 뒤, 앞의 둘은 실행 전, 함수 지침은 오류 뒤에 주입한다. 그림 속 로그인 예시는 작동 방식의 사례이며, 모든 오류가 단일 함수 규칙으로 복구되거나 학생이 교사의 긴 실행 예시를 항상 이해한다는 뜻은 아니다.
3. 성능 수치는 메모리의 출처와 함께 읽어야 한다
본평가에서 네 학생 모델의 AMD−zero-shot 평균 향상은 AppWorld 27.2%p, BFCL V3 11.2%p, ToolSandbox 3.4%p다. Qwen3-4B의 AppWorld 전체 AMD는 14.88%에서 49.40%로 34.52%p 높아졌다. 같은 조건에서 ReasoningBank 10.71, MemP 16.67, SASM 15.48보다 AMD가 높게 보고됐다. 이 조건에서는 계층적 메모리의 표현·검색·주입을 합친 설계가 작동했다는 근거다. 그러나 표는 주입 시점만 바꾼 독립 실험이 아니므로, 이 결과를 timing 효과 하나로 귀속할 수는 없다.
그러나 본평가의 교사 메모리는 같은 benchmark의 성공 경험으로 만들어진다. 따라서 본평가를 완전히 새 도구·새 도메인으로의 전이 성능으로 부르면 안 된다. Qwen3-4B AppWorld의 전체 AMD는 Table 1에서 49.40이다. 저자들은 teacher의 같은 evaluation task를 빼는 self-excluded 설정도 보고하며, 그 protocol의 AMD는 46.43, zero-shot은 14.88이다. 별도 cross-split protocol의 AMD는 41.07이고 zero-shot은 16.07이다. 직접 자기 과제 메모리를 배제한 뒤에도 차이는 남지만, 단일 학생과 제한된 벤치마크의 별도 검증이다.
4. 세 겹은 항상 같은 방향으로 더해지지 않는다
AppWorld의 Qwen3-4B에서 Workflow만 쓴 22.02에 Subtask를 더하면 47.02로 올라간다. Function까지 넣으면 49.40이다. 이 표는 특히 중간 실행 예시가 복잡한 도구 과제에서 큰 역할을 할 수 있음을 보인다. 하지만 Llama3.1-8B는 WF+ST 30.36에서 Function까지 넣으면 27.38로 내려간다. 더 많은 설명이 곧 더 좋은 prompt라는 규칙은 없다.
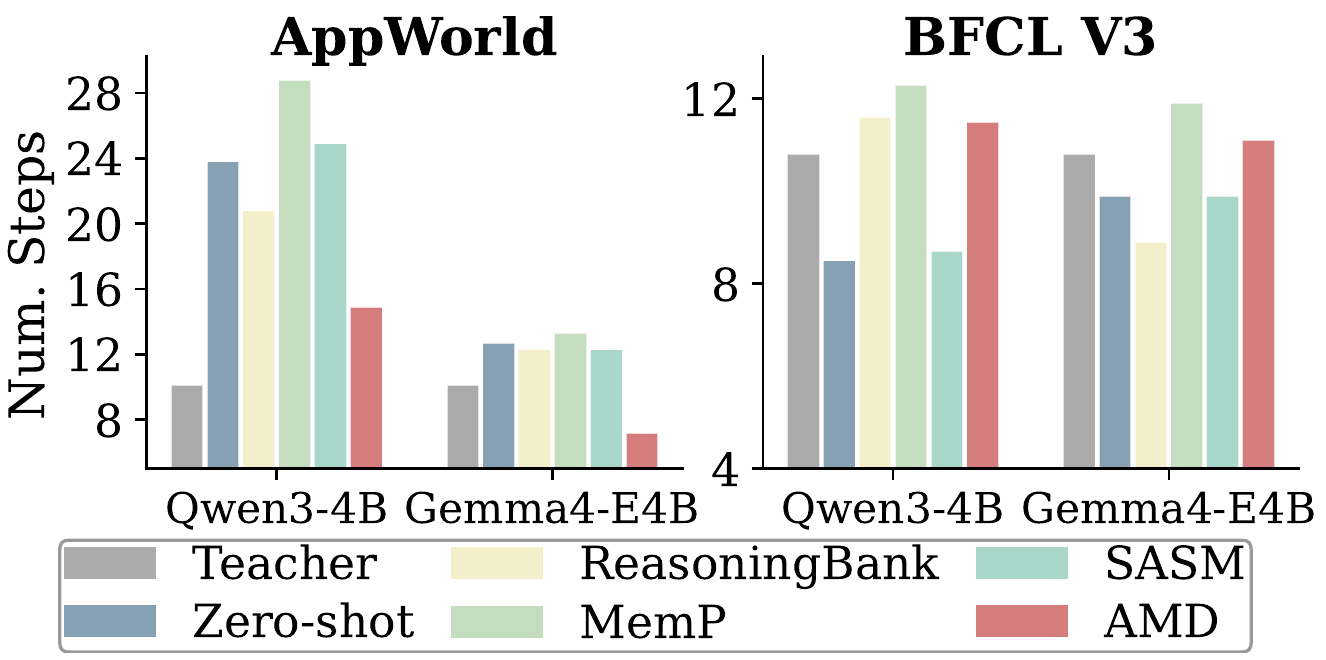
그림 3. Kim et al. (2026), Figure 3, PDF p. 6의 원도판이다. AppWorld와 BFCL V3에서 각 방법이 완료까지 사용한 평균 interaction step을 비교하며, AppWorld의 AMD는 Qwen3-4B에서 탐색 turn을 줄인다. 세로축은 비용이나 latency가 아니라 step 수라서, 메모리 생성·검색과 늘어난 prompt token까지 포함한 총비용 절감으로 해석할 수 없다.
학생이 teacher보다 높은 셀도 있다. BFCL V3에서 Qwen3-4B AMD는 38.50, teacher는 36.50이다. 이는 학생 자체가 더 똑똑해졌다는 비교가 아니라, 교사의 성공 경험이라는 추가 정보를 받은 시스템이 교사의 원래 실행 점수보다 높을 수 있다는 관측이다. 표의 작은 차이에 대한 신뢰구간도 제공되지 않는다.
5. 적용 전에 확인할 것
AMD는 반복되는 도구 과제에서 신뢰할 수 있는 성공 궤적이 있고, 학생이 예시의 API 문법을 수행할 최소 능력이 있을 때 설득력 있다. 운영 전에는 memory가 현재 평가 과제에서 왔는지, train/eval task가 분리됐는지, 메모리별 retrieval 개수와 context 길이가 어떤지 기록해야 한다. 실패 사례에서 Function 메모리의 검색과 오류 분류가 실제로 맞았는지도 별도 점검할 필요가 있다.
이 리뷰는 2026년 8월 7일 공개된 arXiv v1을 기준으로 한다. 논문은 under review로 표시되어 있으며, 여기의 수치는 저자 보고 benchmark 결과다. 이 글은 교사·학생 시스템을 재실행하지 않았고, 세 벤치마크 밖에서의 일반화나 총 운영비 절감을 주장하지 않는다.
References
Kim, T., Kim, K., & Hwang, S. J. (2026). Agent memory distillation: Empowering small LLM agents with hierarchical teacher memory (arXiv:2608.07169v1). https://arxiv.org/abs/2608.07169v1