CLAUSE: Agentic Neuro-Symbolic Knowledge Graph Reasoning via Dynamic Learnable Context Engineering
CLAUSE는 그래프 확장·경로 탐색·근거 선별을 함께 학습해 정확도와 자원 사용을 조절한다. 다만 평균 비용 제약과 질의별 보장은 구별해야 한다.
Paper: Yang Zhao; Chengxiao Dai; Wei Zhuo; Yue Xiu; Dusit Niyato (2026). "CLAUSE: Agentic Neuro-Symbolic Knowledge Graph Reasoning via Dynamic Learnable Context Engineering". ICLR 2026 PDF.
한눈에 보기
다중 홉 질문에 답할 때 지식 그래프의 주변을 넓게 펼치면 필요한 사실도 찾을 수 있지만, 관계없는 간선과 긴 프롬프트도 함께 따라온다. CLAUSE는 이 문제를 “무엇을 보여 줄까”만이 아니라 “무엇을 추가하고, 어느 길을 걷고, 언제 멈출까”라는 순차 의사결정으로 바꾼다. 논문의 대상은 그래프에서 답 근거를 조립하는 과정이며, 최종 문장을 생성하는 reader LLM 자체를 새로 학습하는 연구는 아니다.
가령 ‘어떤 배우와 함께 출연한 사람’을 찾는다면, 출연 배우에서 영화로, 영화에서 다른 배우로 가는 관계가 필요하다. 그러나 감독·장르·제작사까지 무차별적으로 펼치면 답을 지지하는 경로가 오히려 묻힌다. CLAUSE는 질문별로 작은 작업용 부분 그래프를 만들고 필요한 경로와 텍스트 근거만 reader에 넘긴다. 저자들은 이를 세 정책과 비용 제약이 있는 강화학습으로 학습한다.
세 역할이 나누는 일
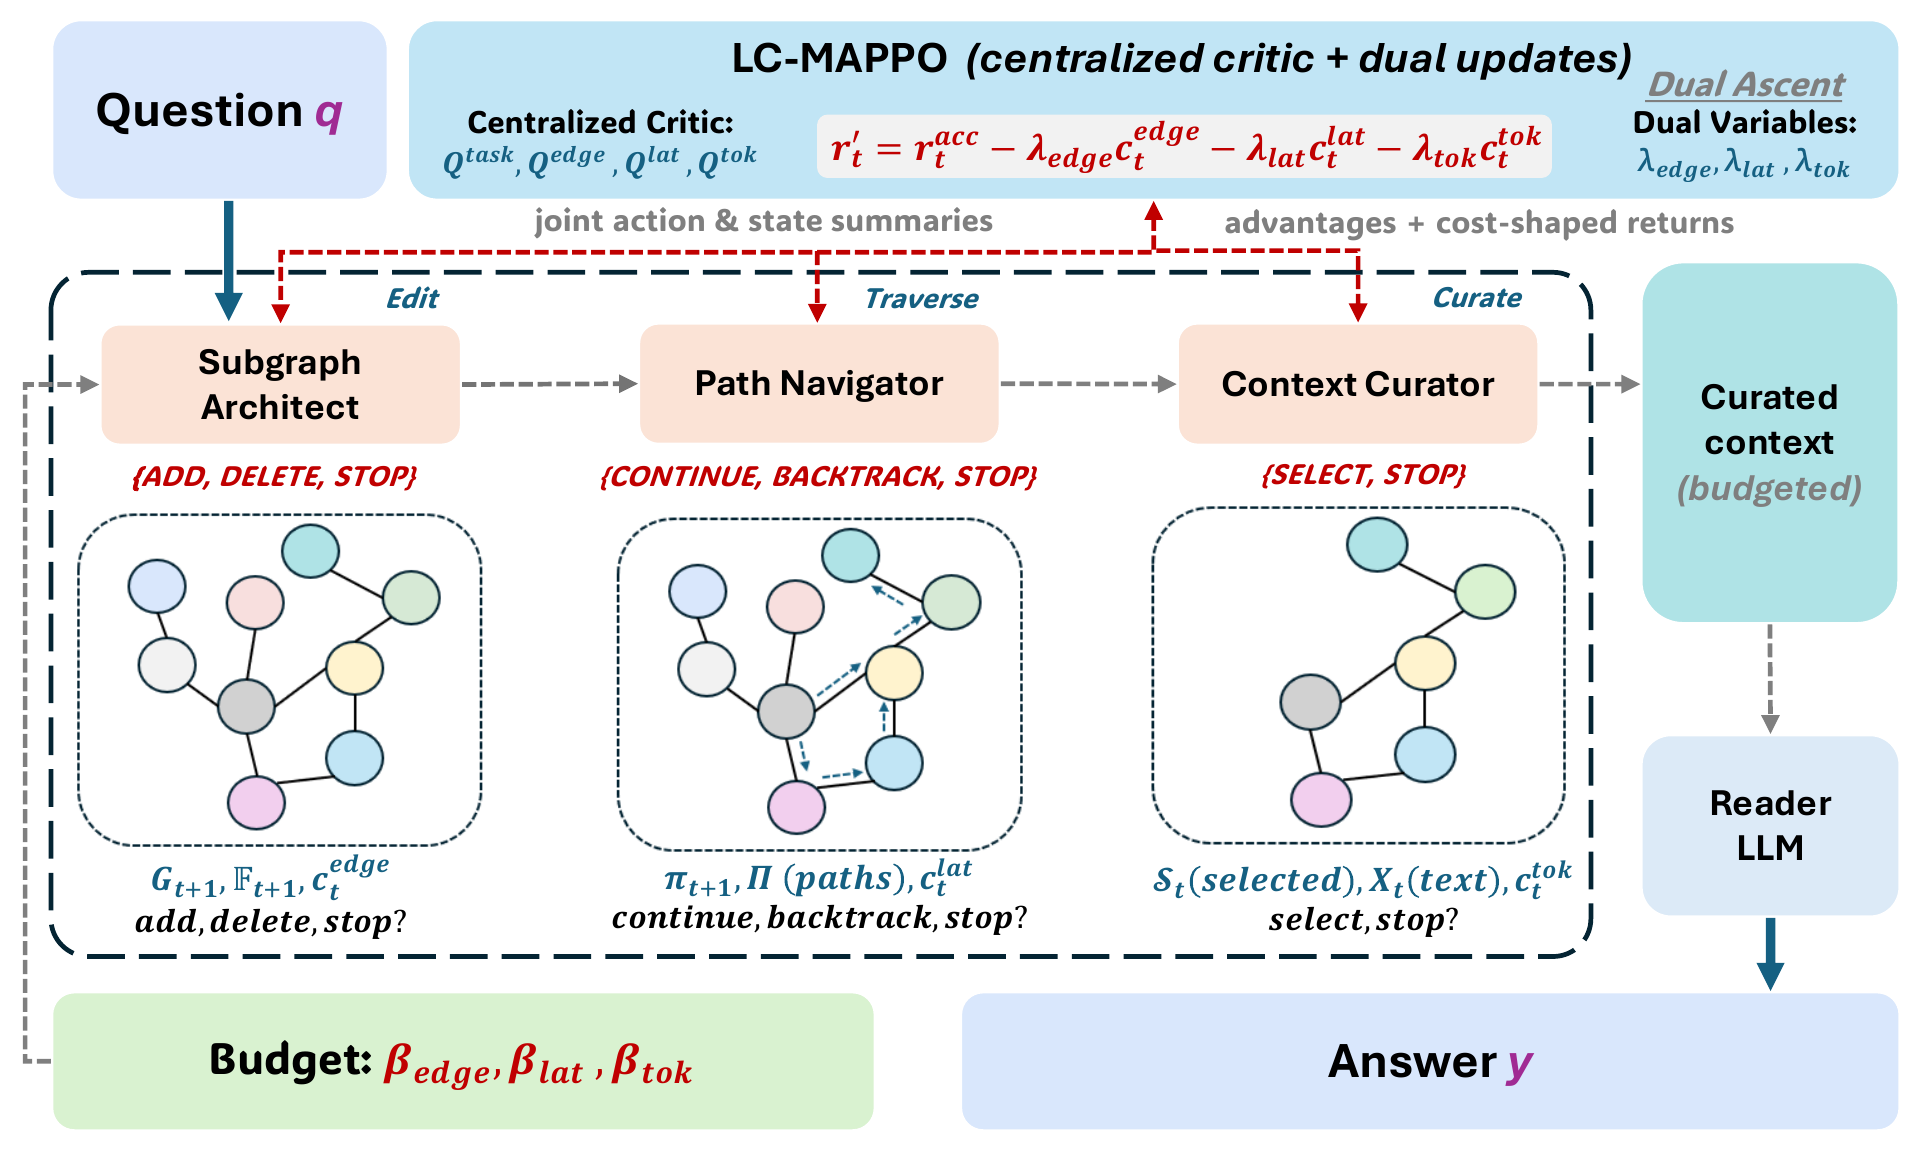
그림 1. 원 논문 Figure 1, ICLR 2026 PDF p. 5의 원도판을 인용. Architect가 작업용 그래프를 편집하고 Navigator가 경로를 탐색하며 Curator가 reader에 보낼 근거를 고른다. 위쪽 critic과 dual update는 학습 단계의 장치다.
| 역할 | 하는 선택 | 남기는 산출물 |
|---|---|---|
| Subgraph Architect | 간선을 추가·삭제·중지 | 질문 주변의 작업용 그래프 |
| Path Navigator | 진행·되돌아감·중지 | 답 후보로 이어지는 경로 |
| Context Curator | 근거 선택·중지 | reader에 넣을 짧은 근거 목록 |
여기서 DELETE는 원본 지식 그래프를 지우는 일이 아니다. 한 질문을 푸는 동안의 작업용 그래프에서 후보를 빼는 행동이다. ‘neuro-symbolic’도 완전한 논리 증명기를 뜻하지 않는다. 개체·관계·경로라는 명시적 기호 상태 위에서, 신경망이 다음 행동의 우선순위를 매기는 구조다. 이 분해 덕분에 답 자체뿐 아니라 어떤 경로를 따라왔는지도 남길 수 있다.
예산은 무엇을 제한하는가
CLAUSE는 세 비용을 따로 센다. 간선 편집 수, 탐색 상호작용 단계, 그리고 최종으로 선택한 토큰 수다. 세 비용에 각각 가격을 붙여 정확도 보상과 함께 학습하고, 실행 때는 같은 체크포인트에 예산 상한(cap)이나 가격(price)을 넣는다. 따라서 토큰이 넉넉하지만 탐색 단계가 부족한 질의와, 반대 질의를 같은 방식으로 다루지 않아도 된다.
두 가지를 구분해야 한다. 먼저 논문의 CMDP에서 C_lat은 상호작용 단계의 latency proxy다. 반면 결과 표의 정규화 평균 latency는 그래프 구성 오버헤드와 다단계 도구 숙고를 포함해 측정한 별도 지표다. 따라서 Table 3의 1.40→1.14를 단순한 step count 감소라고 읽어서는 안 되지만, 서비스의 실제 지연시간을 모든 배포 조건에서 보장한다는 뜻도 아니다.
둘째, 제약 학습은 에피소드 비용의 기댓값을 예산 이하로 두려는 목적이므로 모든 개별 질의에서 절대로 초과하지 않는다는 주장과 다르다. 추론 의사코드도 자원마다 동일한 강도를 보이지 않는다. Algorithm 4는 근거를 더하기 전에 토큰 예산을 확인하지만, Algorithm 2는 간선을 편집한 뒤 초과 여부를 확인할 수 있다. 엄격한 간선·단계 상한이 필요하다면 행동 마스킹, rollback, 실제 카운터 순서를 별도로 검증해야 한다. 이는 논문에서 위반이 관찰됐다는 주장이 아니라, cap의 보장 범위를 구현 순서가 좌우한다는 점이다.
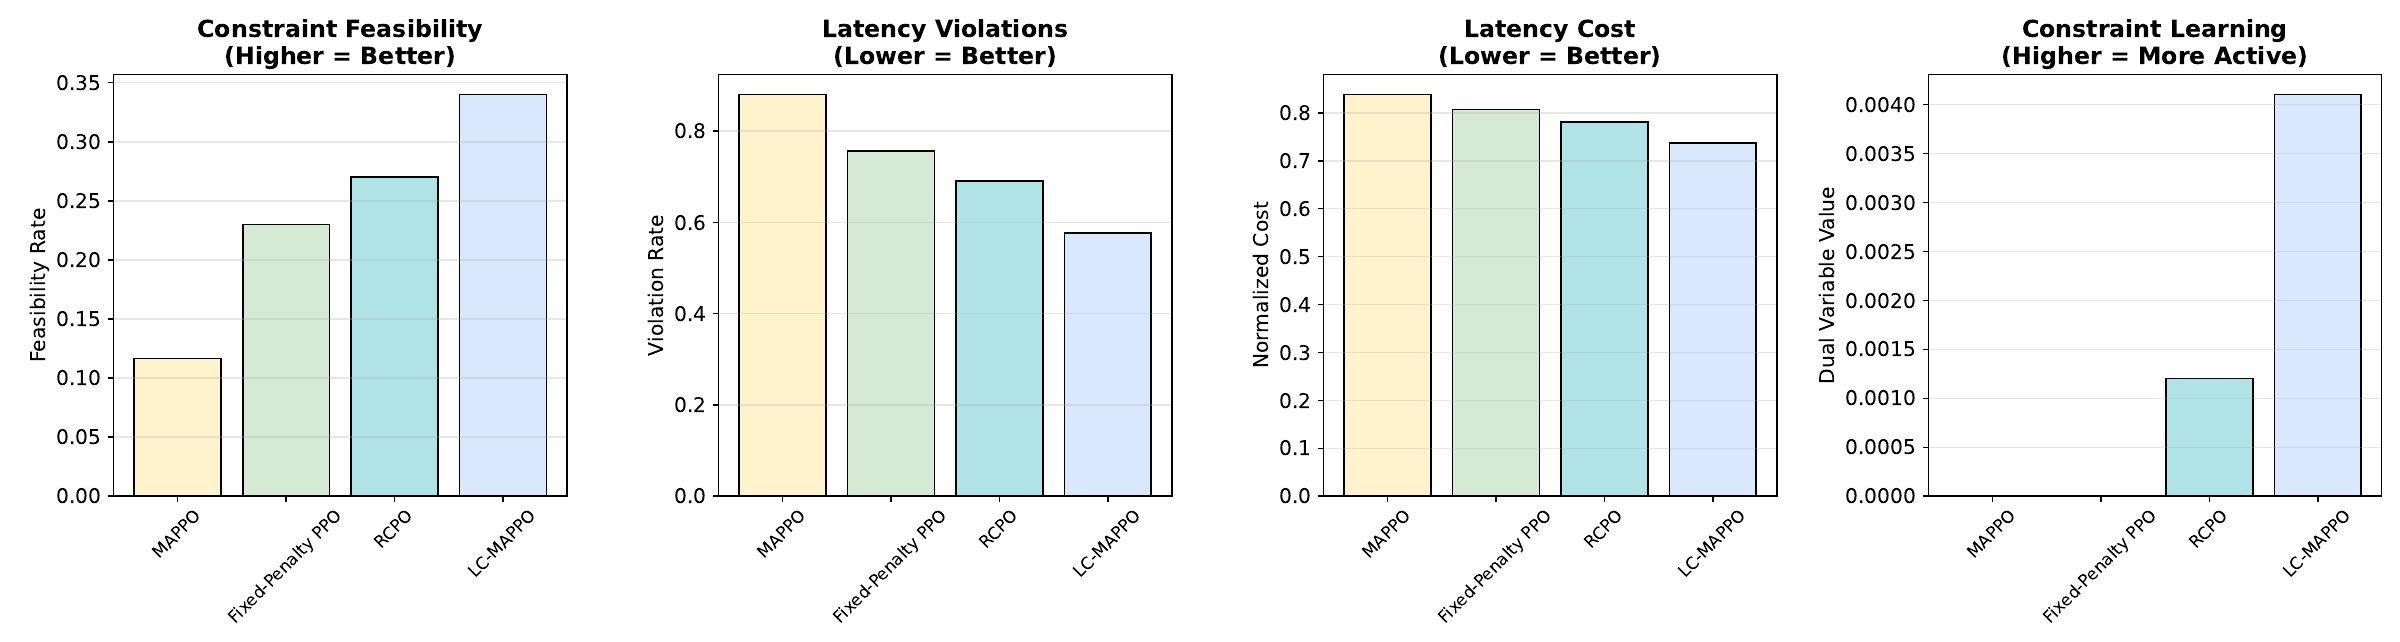
그림 2. 원 논문 Figure 3, ICLR 2026 PDF p. 9의 원도판을 인용. MetaQA에서 edge budget 0.5, latency budget 0.7을 둔 조건이다. LC-MAPPO는 MAPPO보다 feasibility와 비용 관련 지표에서 더 나은 경향을 보이지만, 첫 패널의 feasibility가 1.0에 이르지는 않는다. 이 그림은 완전한 질의별 준수를 보장하는 증거가 아니다.
저자 실험이 보여 주는 것
저자들은 HotpotQA, MetaQA, FactKG에서 Qwen3-32B reader를 두고 여러 RAG·agent 기준선과 비교한다. MetaQA 2-hop에서 CLAUSE의 EM@1은 87.3, GraphRAG는 48.0이며 차이는 39.3 percentage points다. 같은 열에서 더 강한 agent 계열 비교인 KG-Agent는 78.0이므로 차이는 9.3 points다. 큰 수치를 읽을 때는 비교 기준을 함께 적어야 한다.
효율 결과도 과제별로 다르다. MetaQA 2-hop에서는 GraphRAG 대비 정규화 지연이 1.40에서 1.14, 간선 지표가 1.32에서 0.78로 낮다. 하지만 HotpotQA와 FactKG에서 CLAUSE가 GraphRAG보다 항상 낮은 지연을 보인 것은 아니다. 여러 조건에서 근거 선별과 경로 제어를 함께 학습하는 방식이 정확도와 자원 사용의 절충을 만들 수 있다는 결론이 가장 강하게 뒷받침된다. 모든 조건에서 속도·정확도를 지배한다는 결론까지 뒷받침되지는 않는다.
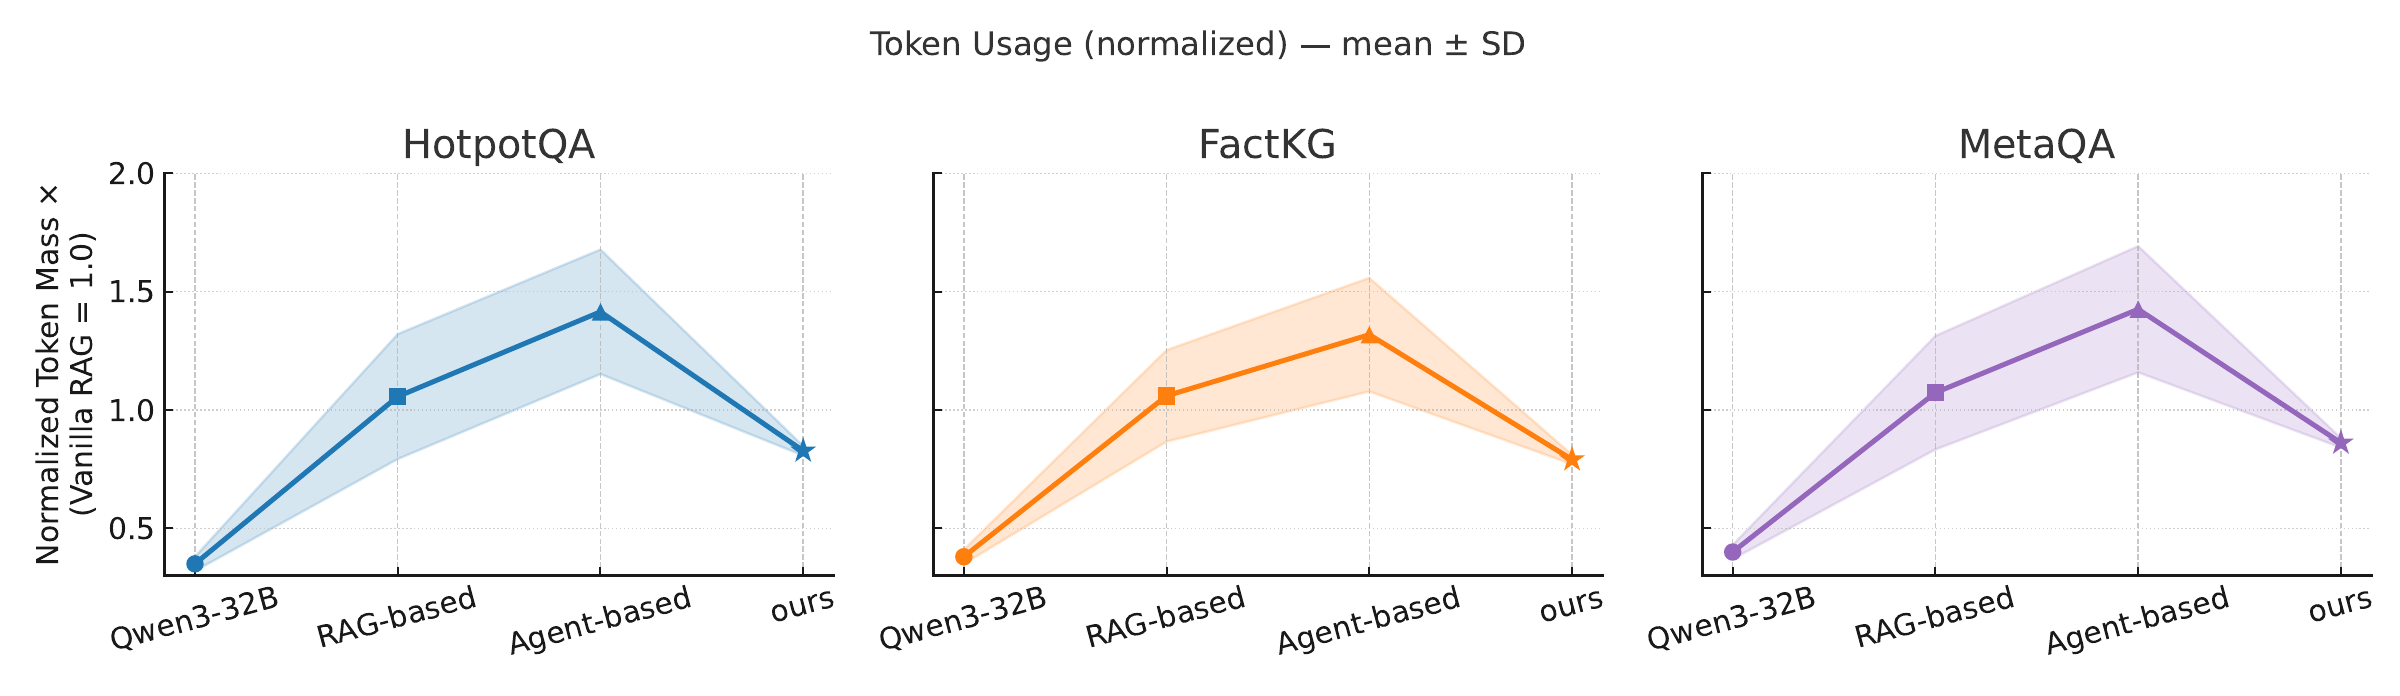
그림 3. 원 논문 Figure 2, ICLR 2026 PDF p. 9의 원도판을 인용. 기준은 Vanilla RAG의 토큰 사용량 1.0이며, RAG-based·Agent-based 막대는 방법군 평균이다. 개별 방법 사이의 정확한 토큰 차이를 이 그림만으로 확정할 수는 없다.
적용할 때 확인할 조건
이 방식은 관계가 명시된 그래프, 질문에 연결할 수 있는 anchor, 그리고 경로를 텍스트 근거로 바꿀 수 있는 환경에서 가장 자연스럽다. 반대로 그래프 사실이 부정확하거나 entity linking이 약하면, 정교한 제어도 잘못된 출발점에서 시작한다. 실제 적용에서는 CMDP의 단계 proxy와 Table 3의 측정 latency, API 호출·reader 생성·네트워크를 포함한 서비스 응답시간을 각각 계측해야 한다.
CLAUSE가 주는 실무적 교훈은 단순하다. 고정 top-k나 hop 수를 늘리기 전에, 어느 자원이 병목인지 분리해 기록해야 한다. 토큰, 탐색 단계, 그래프 확장은 같은 비용이 아니다. 이 논문은 그 분리를 학습 목표에 넣는 구체적인 설계를 보였고, 개별 요청의 엄격한 비용 준수는 실행 계측과 별도로 검증해야 함을 함께 보여 준다.
References
Zhao, Y., Dai, C., Zhuo, W., Xiu, Y., & Niyato, D. (2026). CLAUSE: Agentic neuro-symbolic knowledge graph reasoning via dynamic learnable context engineering. International Conference on Learning Representations. PDF
더 긴 방법·표·사례 분석은 심화 보기에서 확인할 수 있다.