Causal Foundation Models
Causal Foundation Model: 새 데이터마다 다시 학습하지 않는 인과효과 추정
다양한 인과적 데이터 생성 과정을 미리 학습해 새 관측 데이터에서 처치 효과를 추정하는 CFM을 설명하고 세 모델을 비교한 연구다. 과제별 학습 부담을 줄일 수 있지만 효과를 식별하는 가정과 사전학습 분포의 적합성은 여전히 필요하다.
Paper: Christopher Stith; Hossein Rahmani; Jesse C. Cresswell (2026). "Causal Foundation Models". arXiv:2609.03003v1 / PDF
“광고를 보인 것이 구매를 늘렸는가?”는 구매를 잘 예측하는 문제와 다르다. 광고를 본 사람이 원래 구매 의향이 높았을 수도 있기 때문이다. Causal foundation model(CFM)은 많은 가상의 인과 세계를 먼저 학습하고, 새 관측 데이터셋을 context로 받은 뒤 개인별 처치 효과(CATE) 같은 값을 바로 추정하려는 접근이다. 매 데이터셋에서 새 신경망을 학습하지 않는다는 점이 매력적이지만, 인과추론의 가정을 지워 주는 마법은 아니다.
1. 무엇을 입력하고 무엇을 답하는가
논문의 기본 데이터는 공변량 X, 실제로 받은 처치 T, 관측 결과 Y다. 새 데이터셋의 여러 행은 context가 되고, “특성이 x인 사람에게 처치 0과 1을 각각 했더라면 결과가 어떻게 달랐을까?”라는 query가 들어간다. CFM은 이 query에 대한 잠재 결과의 조건부 평균을 추정하고, 두 처치의 차이로 CATE를 만든다.
그림의 .fit()은 보통의 재학습 API와 다르다. pretrained CFM의 가중치를 새 데이터에 맞춰 업데이트하는 대신, 관측 행을 context로 올려 모델이 조건부 추론할 재료를 준다. 즉 계산을 생략하는 것이 아니라, 반복되는 ‘데이터셋별 학습’을 사전학습 단계로 옮긴다.
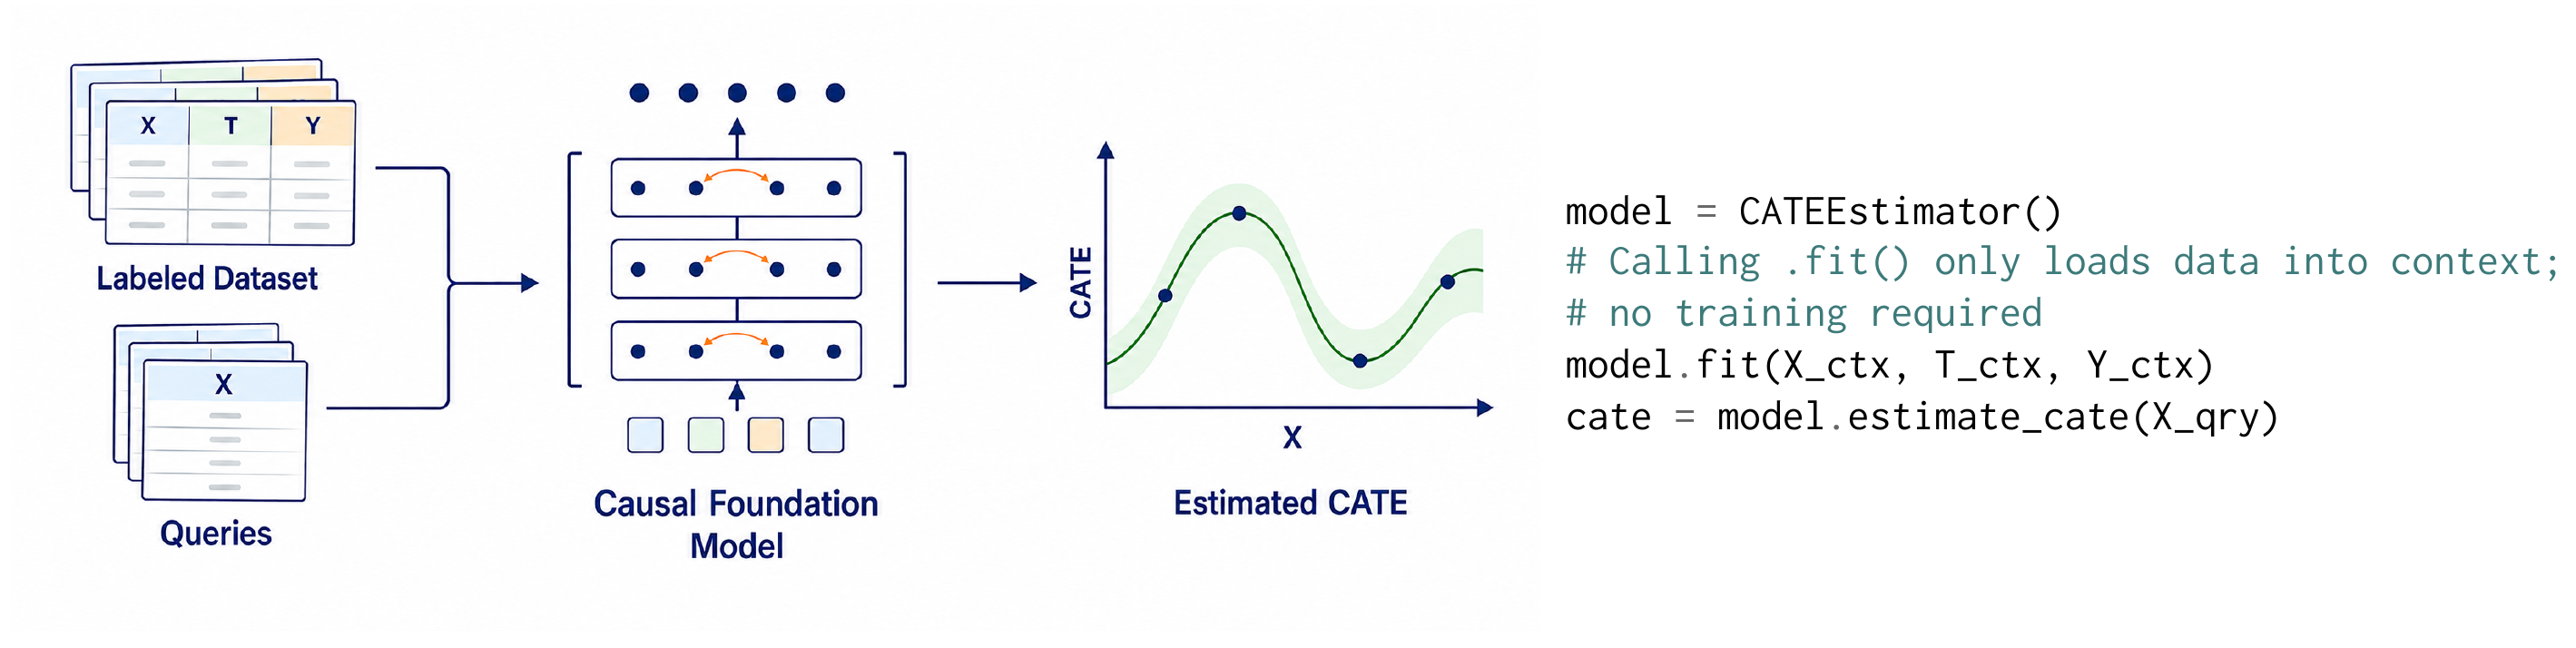
그림 1. Stith et al. (2026), Figure 1, PDF p. 2의 원도판이다. labeled context와 query가 CFM을 거쳐 추정 CATE로 이어지고, 코드 예시는 .fit()이 data를 context에 넣는다고 설명한다. 새 데이터에서 학습을 하지 않는다는 말은 사전학습 비용이나 관측 데이터의 품질이 필요 없다는 뜻이 아니다.
2. 예측이 잘 맞아도 인과효과가 맞는 것은 아니다
처치 T와 결과 Y에 모두 영향을 주는 X가 있으면, 단순 상관은 처치 효과와 섞인다. 논문의 backdoor-adjustment 예인 CausalPFN에서는 관측 공변량으로 교란을 충분히 막는 strong ignorability와 각 집단에서 처치가 가능한 overlap 같은 가정이 필요하다. 하지만 이 조건을 모든 CFM에 똑같이 적용할 수는 없다. Table 1은 식별되지 않는 prior를 쓰는 Do-PFN과, backdoor 외에도 관측한 중개변수 경로를 이용하는 frontdoor, 처치 선택에는 영향을 주지만 결과에는 처치를 통해서만 영향을 준다고 가정하는 별도 변수를 이용하는 IV 등 서로 다른 전략의 CausalFM 변형을 구분한다. 각 전략은 자기 식별 가정을 따로 요구한다.
예를 들어 광고 노출과 구매를 비교할 때 기존 충성도나 가격 할인 정보가 빠지면, 아무리 좋은 foundation model도 숨은 교란을 관측 데이터만으로 확인할 수 없다. 논문은 CFM을 Bayesian prior-data fitted network와 연결해 설명하지만, posterior처럼 보이는 출력이 현실 세계에서 식별된 인과효과라는 보증은 별도의 설계·도메인 근거에서 와야 한다.
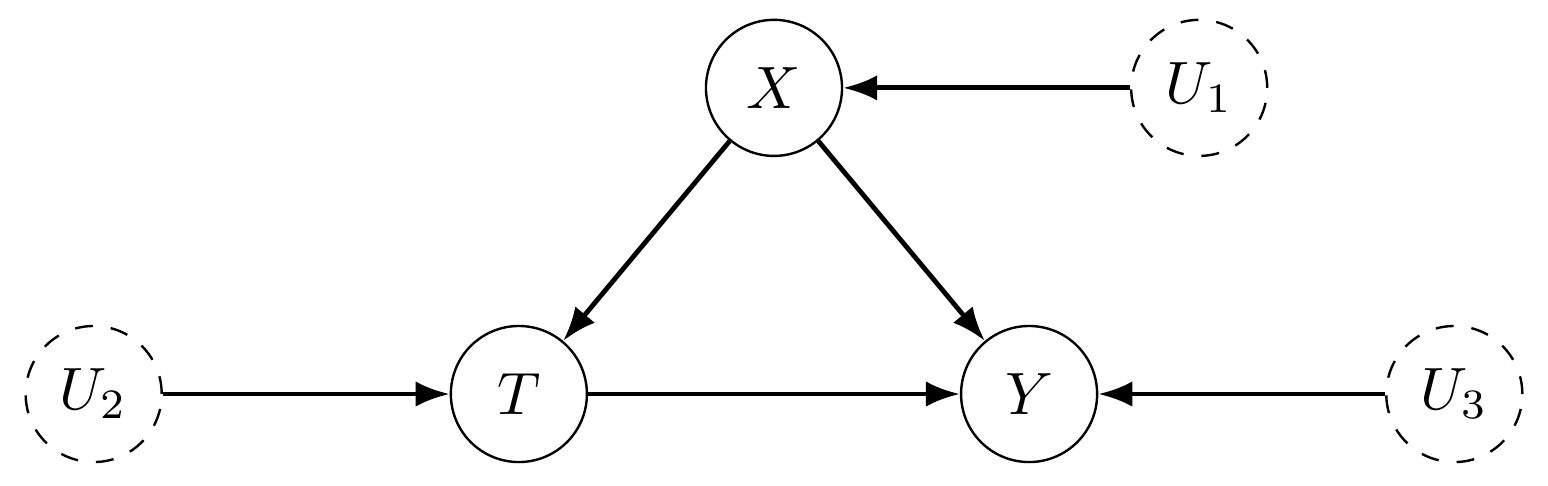
그림 2. Stith et al. (2026), Figure 2, PDF p. 8의 원도판이다. X가 T와 Y에 모두 영향을 주고 T가 Y에 영향을 주는 단순 SCM을 보여 주며, U1·U2·U3는 이 예에서 각 변수에 들어가는 서로 독립인 외생 잡음항이다. 따라서 점선 노드는 공유된 잠재 교란을 그린 것이 아니며, 실제 분석에서 숨은 교란이 없는지는 이 도식이 아니라 연구 설계와 데이터 근거로 따로 점검해야 한다.
3. 사전학습은 어떤 인과 세계를 본 것인가
CFM은 실제 환자·고객 데이터를 무한히 모아 학습하는 방식이 아니다. 저자들은 그래프 구조, 구조방정식, 잡음 분포, 처치 배정 규칙을 prior에서 샘플링해 synthetic structural causal model을 만든다. 이 세계에서 관측 데이터와 개입했을 때의 정답을 함께 생성한다. 모델에는 관측 데이터만 context로 주고, 개입 정답은 loss를 계산하는 데 쓴다.
이 과정에서는 학습 중에 알 수 있는 ground truth를 사용해 ‘관측에서 개입을 추정하는 함수’를 배울 수 있다. 반면 실제 데이터의 인과 구조, effect heterogeneity, 처치 정책이 prior 밖에 있으면 좋은 입력–출력 규칙을 배웠더라도 빗나갈 수 있다. 따라서 CFM의 빠른 적용성은 prior가 새 문제를 얼마나 잘 덮는지와 분리할 수 없다.
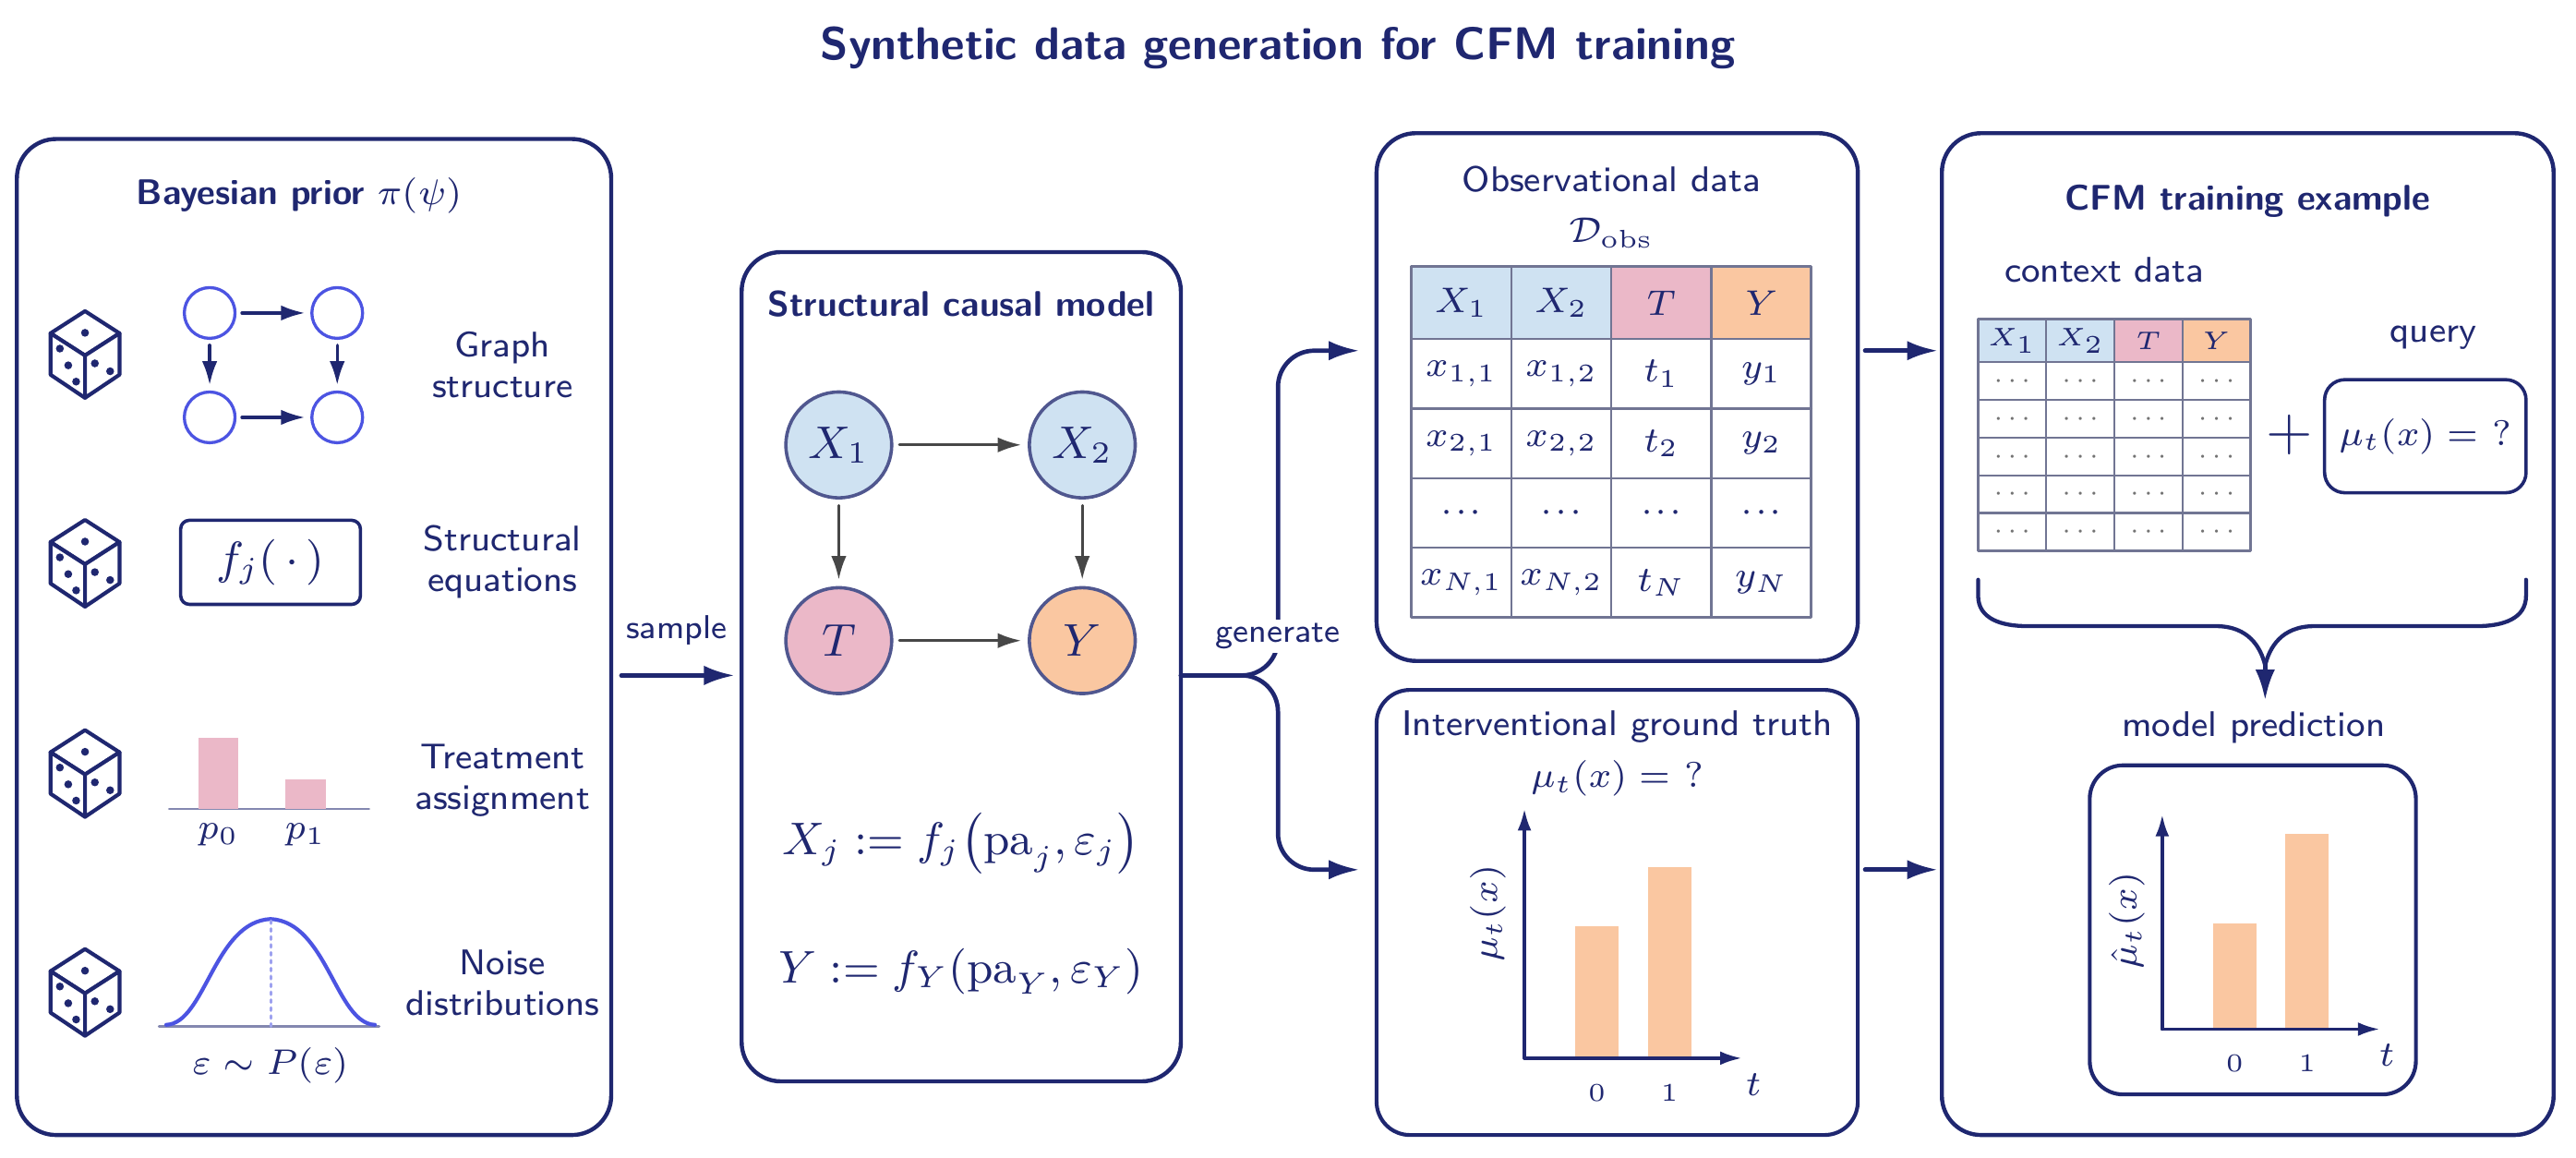
그림 3. Stith et al. (2026), Figure 5, PDF p. 16의 원도판이다. prior에서 그래프·방정식·처치 배정·잡음을 뽑아 관측 데이터와 개입 정답을 만들고, 전자는 context, 후자는 학습 target으로 쓴다. 합성 세계의 ground truth가 정확하더라도 실제 적용 데이터가 그 prior의 범위에 들어온다는 검증을 대신하지는 않는다.
4. 세 CFM과 기존 추정기를 어떻게 읽을까
논문은 Do-PFN, CausalPFN, CausalFM을 비교한다. 세 모델은 모두 사전학습 후 context-conditioned prediction을 쓰지만, prior와 식별 전략, 출력 분포가 다르다. 그래서 ‘CFM’이라는 한 수치만 보고 어느 모델도 같은 가정을 갖는다고 보면 안 된다.
RealCause-Lalonde에서 CausalPFN은 세 CFM 중 CATE 성능이 가장 좋고 CPU CATE 처리시간 중앙값 18.4초로 보고됐다. 이 평가는 Lalonde-CPS와 Lalonde-PSID의 실제 공변량을 기반으로 결과를 생성한 semi-synthetic benchmark이며, 두 비교 집단에서 각각 10개 독립 생성본을 사용하며, 관측한 X로 교란을 조정할 수 있도록 결과를 생성했다. 그러므로 숨은 교란에 대한 강건성이나 실제 정책 개입의 성공을 직접 검증한 결과는 아니다. Table 3의 전체 CATE 평균 순위에서는 튜닝된 T-Learner가 앞섰고, ATE에서는 IPW와 T-Learner가 강했다. 개인별 효과를 잘 맞추는 문제와 모집단 평균 효과를 잘 맞추는 문제는 다르다. CFM이 특정 benchmark에서 경쟁력 있는 속도·정확도 지점을 보인다는 것이 기존 추정기를 전면 대체한다는 결론은 아니다.
속도 비교도 공정하게 읽어야 한다. 전통 추정기의 runtime에는 데이터셋별 tuning과 학습이 포함되지만, CFM의 대규모 사전학습은 제외된다. 한 조직이 이미 pretrained model을 갖고 있고 새 데이터셋을 반복 분석하는 상황에는 후자의 비용 모델이 적절할 수 있다. 처음부터 CFM을 만드는 총 연구 비용을 비교하려면 사전학습 자원까지 따로 계산해야 한다.
5. 실무에서 남는 질문
CFM을 쓰기 전에는 효과 정의(ATE인가 CATE인가), 관측한 교란 변수, overlap, 데이터가 사전학습 prior와 다른 정도를 먼저 기록해야 한다. 이어서 단순한 T-Learner·IPW 같은 기준선과 같은 target·같은 hardware에서 비교하고, uncertainty가 의사결정에 충분한지도 확인해야 한다. 빠른 .fit()은 좋은 인터페이스지만, 인과 설계 검토를 생략할 근거는 아니다.
이 리뷰는 2026년 9월 2일 공개된 arXiv v1과 저자 공개 저장소를 기준으로 한다. 저자 보고 runtime은 특정 benchmark와 하드웨어 조건의 값이며, 이 글은 결과를 재실행하거나 실제 정책 개입을 검증하지 않았다.
References
Stith, C., Rahmani, H., & Cresswell, J. C. (2026). Causal foundation models (arXiv:2609.03003v1). https://arxiv.org/abs/2609.03003v1