Flow Reasoning Models: Turning Flows Into Efficient Recurrent Reasoners
FRM은 flow 모델의 예측을 다시 입력해 구조적 답을 반복 수정한다. Fixed-Point Forcing은 깊은 반복의 노출 편향을 줄이지만, 퍼즐 밖 일반화는 아직 검증 범위 밖이다.
Paper: Alec Helbling; Andrey Bryutkin; Mauro Martino; Duen Horng Chau; Nima Dehmamy; Hendrik Strobelt (2026). "Flow Reasoning Models: Turning Flows Into Efficient Recurrent Reasoners". arXiv:2606.29150v3 PDF.
한눈에 보기
스도쿠처럼 서로 얽힌 답을 풀 때는 한 칸을 먼저 확정하면 뒤에서 모순이 드러날 수 있다. autoregressive 모델은 앞 결정을 되돌리기 어렵고, 병렬로 답을 다루는 diffusion 계열도 반복 과정을 안정적으로 만들기 쉽지 않다. Flow Reasoning Model(FRM)은 연속적인 flow 모델이 만든 현재 답안을 다시 조건으로 넣어, 여러 위치의 결정을 함께 수정하는 반복 추론기를 제안한다.
여기서 flow는 입력을 한 번에 정답으로 바꾸는 함수라기보다, 노이즈 상태에서 정답 구조로 향하는 변환을 학습하는 틀이다. FRM은 각 반복에서 현재의 clean prediction을 carry로 넘긴다. 잘못된 수를 포함한 중간 답도 다음 반복에서 수정할 기회를 얻는다. 학습 때 한 번 본 예측과, 실행 때 모델이 자기 출력을 여러 번 되먹인 상태가 다르다. 저자들은 이 노출 편향을 Fixed-Point Forcing(FPF)으로 겨냥한다.
무엇을 반복하는가
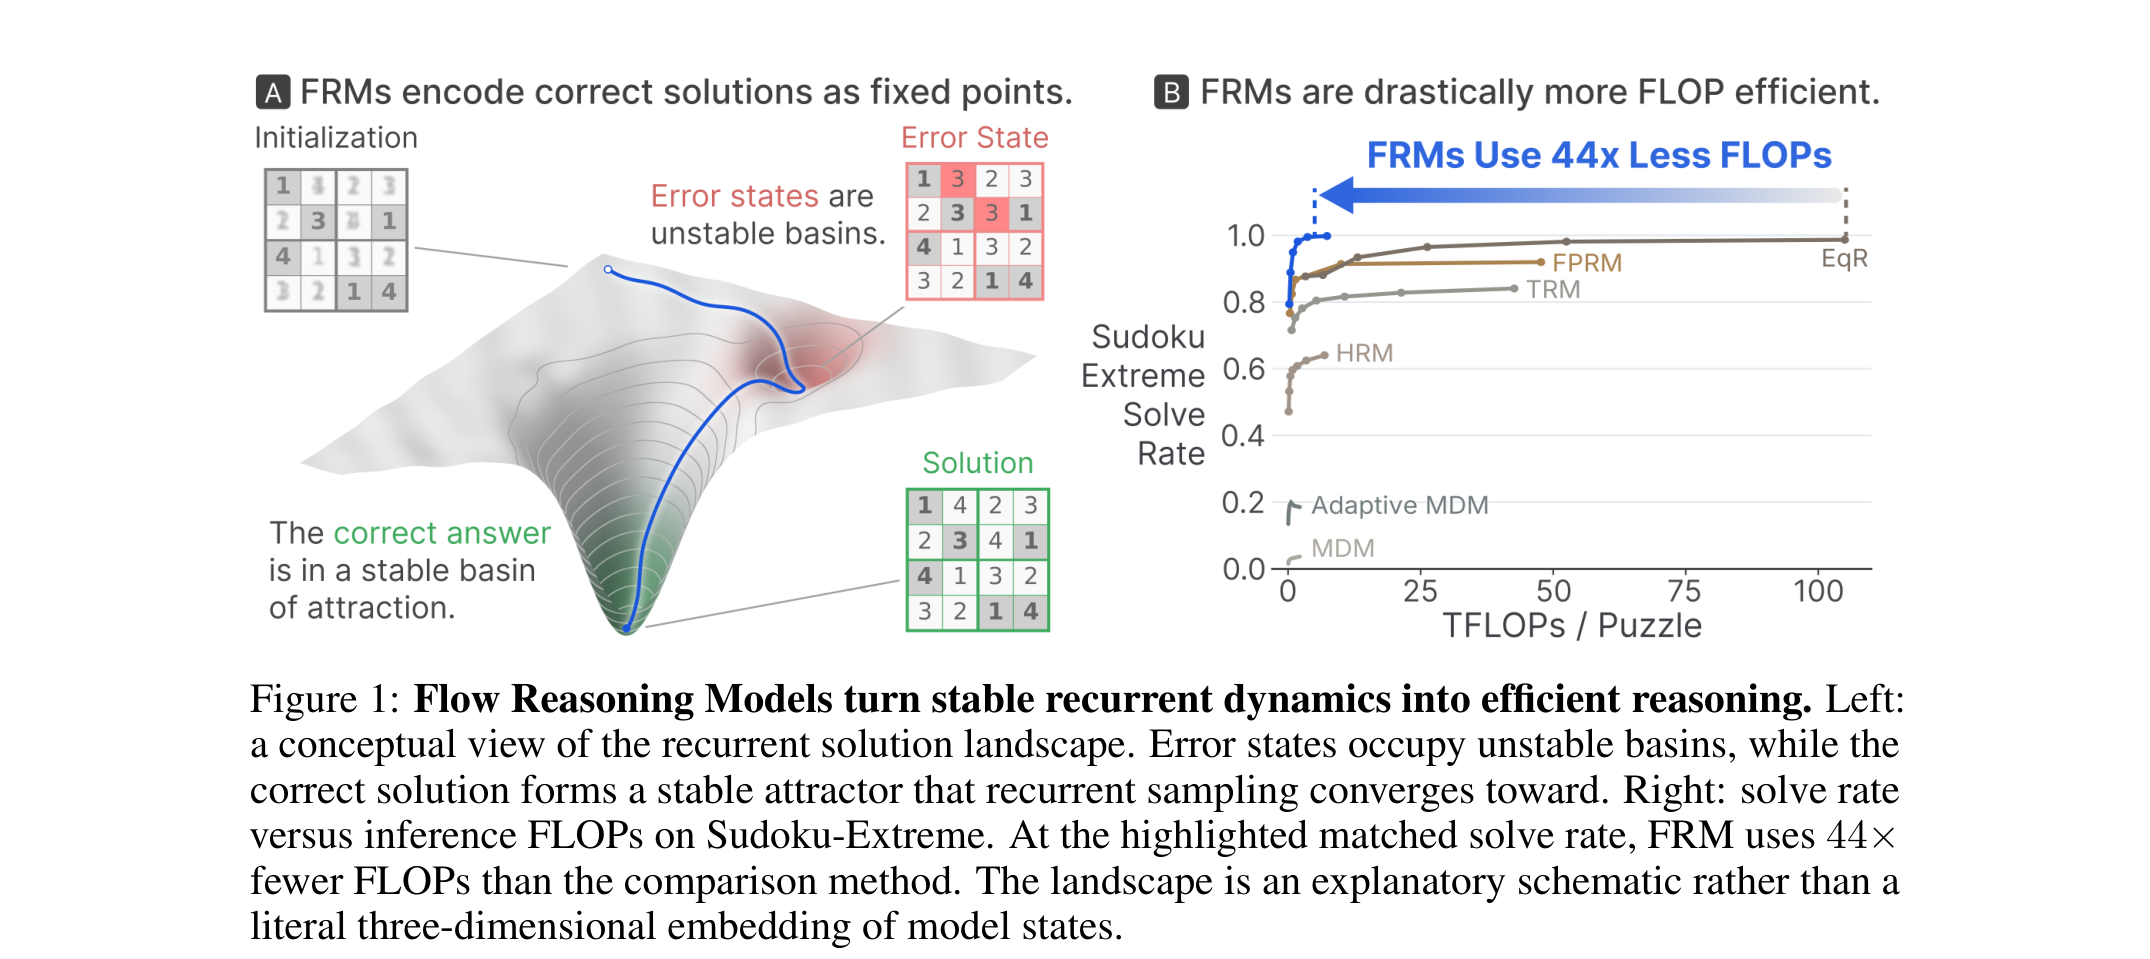
그림 1. Helbling et al. (2026), Figure 1, arXiv:2606.29150v3 PDF p. 2의 원도판을 인용. 왼쪽의 안정·불안정 basin은 정확한 모델 상태를 측정한 3차원 지도라기보다 반복 수정의 목표를 설명하는 개념도다. 오른쪽은 Sudoku-Extreme에서 solve rate와 문제당 추론 FLOPs의 관계를 보인다.
일반적인 self-conditioning은 한 번의 예측을 다음 입력으로 제공한다. 이를 깊게 반복하면 모델은 자신이 이전에 만든, 학습에서 충분히 보지 못한 오류 상태를 만나게 된다. 이때 틀린 답이 계속 강화되거나, 반복할수록 성능이 무너질 수 있다. FRM은 flow 시간과 반복 깊이를 구분한다. flow 시간은 한 번의 노이즈 제거 경로를 뜻하고, 반복 깊이는 그렇게 얻은 답안을 몇 차례 다시 검토할지를 뜻한다.
이 구분은 ‘더 오래 샘플링하면 항상 더 잘 푼다’는 해석을 막는다. 반복은 추가 계산을 쓰며, 좋은 초기 상태와 잘 학습된 수정 동역학이 있을 때만 유용하다. FPF의 목적은 정답이 고정점처럼 남고 오류 상태는 그곳에 머물기 어렵게 만드는 것이지, 수학적 수렴 보증을 제시하는 것은 아니다.
Fixed-Point Forcing의 역할
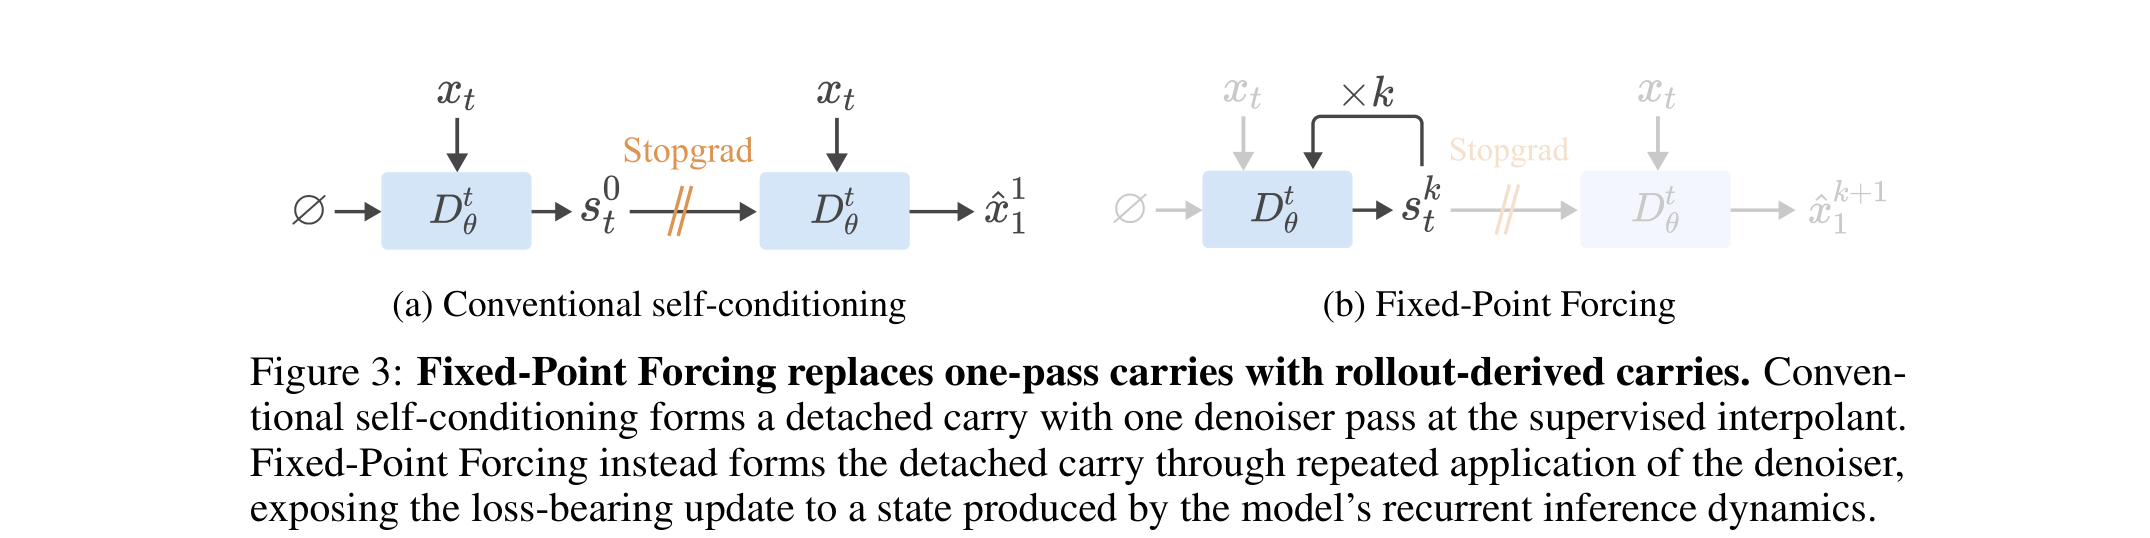
그림 2. Helbling et al. (2026), Figure 3, arXiv:2606.29150v3 PDF p. 4의 원도판을 인용. 일반 self-conditioning의 one-pass carry 대신, 모델 자신의 여러 단계 rollout에서 얻은 carry를 학습에 사용한다. 표준 flow-matching 및 cross-entropy 감독을 버리는 방법이 아니라 carry의 출처를 바꾸는 추가 학습이다.
쉽게 말해 FPF는 학생에게 모범 답안만 보여 주지 않고 자신이 여러 번 고친 초안도 보여 주며 고치는 법을 배우게 한다. 학습 때 rollout에서 나온 carry를 조건으로 쓰므로, 추론 때 만날 자기 생성 상태와의 간격을 줄인다. test-time 반복을 단순히 늘리는 방법과는 다르다. model이 그 반복 과정에서 생기는 입력 분포를 훈련 중 경험하게 만드는 장치다.
보고된 성능과 44배의 의미
저자들은 Sudoku-Extreme, Zebra, Maze-Unique라는 정답형 구조 퍼즐에서 평가한다. arXiv v3 초록은 각각 99.5%, 100.0%, 99.9%의 최고 solve rate를 보고한다. Maze-Unique의 99.9%는 Adaptive MDLM과 FPRM이 보고한 100.0%보다 낮다. 따라서 FRM이 세 과제에서 모두 단독 최고라고 말할 수는 없다. Sudoku-Extreme에서는 비교된 다음 최고점 EqR의 98.7%와 같은 해결률을 약 44배 적은 추론 FLOPs에서 맞춘다고 설명한다. 이 수치는 ‘모든 설정에서 44배 빠르다’가 아니다. 특정 정확도 점과 비교 방법의 높은 계산 지점을 잇는 FLOPs 프런티어의 비교다.
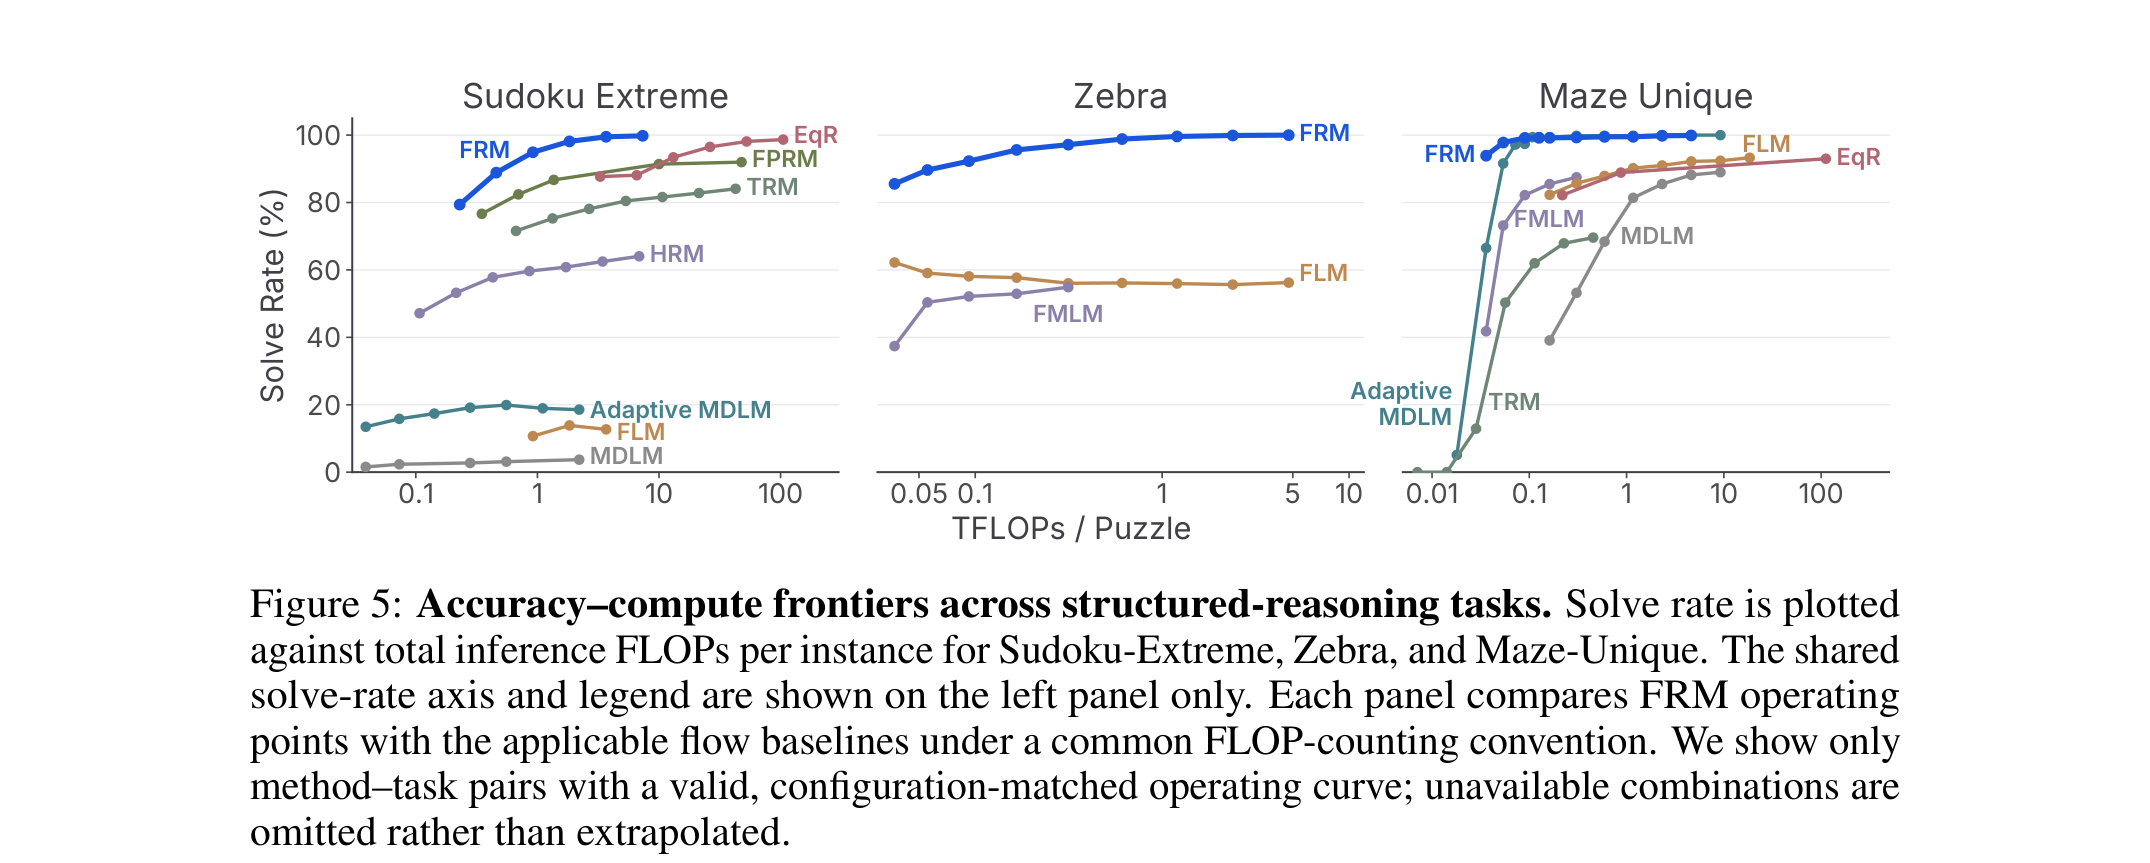
그림 3. Helbling et al. (2026), Figure 5, arXiv:2606.29150v3 PDF p. 6의 원도판을 인용. 세 퍼즐의 exact solve rate와 문제당 추론 FLOPs를 비교한다. 곡선의 각 점은 반복·샘플링 설정에 따라 달라지므로, 단일 최고점만으로 일반적인 지연시간 우위를 단정할 수 없다.
FPF의 직접적인 효과는 반복 깊이가 커질 때 성능을 유지하거나 올리는 데서 읽어야 한다. 다만 Stage B는 rollout-derived carry만 바꾸지 않는다. 추가 학습과 optimizer reset도 함께 들어가며, 같은 계산량의 conventional self-conditioning 대조가 carry 효과 하나를 분리하지는 않는다. 또한 checkpoint·sampler·NFE는 시드별 validation으로 선택된다. 결과는 이 학습 묶음이 효과적이었다는 근거다. carry 하나의 순수 인과 효과를 확정하지는 못한다. 퍼즐의 출력 공간은 명확한 제약과 정답 검증기를 가진다. 자연어의 장문 추론, 도구 호출, 열린 세계 사실성에 같은 안정성이 옮겨간다는 실험은 이 논문에 없다.
적용 범위와 남는 질문
FRM은 많은 변수가 서로 제약을 주고 후보 답을 병렬로 고칠 수 있으며 반복 중간 상태를 평가할 수 있는 문제에 특히 잘 맞는다. 반대로 매 단계의 입력·출력이 길고 비용이 큰 LLM 서비스에서는 carry를 보존하고 반복하는 비용 자체가 병목일 수 있다. 추론 FLOPs도 실제 요청 지연, 메모리, 배치 효율과 같은 지표는 아니다.
이 논문의 유용한 교훈은 반복 횟수보다 훈련 시 본 상태와 실행 시 도달하는 상태의 일치다. 자기 수정 모델을 설계한다면, 한 단계 예측만 학습한 뒤 장기 rollout을 기대하기보다 rollout 상태를 학습에 넣어야 한다. 다만 ‘고정점’은 이 연구에서 해석적 언어이므로, 실제 수렴성·안전성의 보증으로 번역하지 않는 편이 정확하다.
References
Helbling, A., Bryutkin, A., Martino, M., Chau, D. H., Dehmamy, N., & Strobelt, H. (2026). Flow reasoning models: Turning flows into efficient recurrent reasoners (arXiv:2606.29150v3). PDF
더 긴 방법·절제·수렴 분석은 심화 보기에서 확인할 수 있다.