RLCD: Reinforcement Learning from Contrastive Distillation for LM Alignment
RLCD는 대비되는 프롬프트로 선호쌍을 만들고 사후 채점 없이 정렬을 학습한다. 7B 시뮬레이션의 개선과 30B의 혼합 결과를 살펴보고, 출력 길이와 기준선 설정이 해석에 주는 제약을 짚는다.
Paper: Kevin Yang, Dan Klein, Asli Celikyilmaz, Nanyun Peng, & Yuandong Tian (2024), ICLR 2024 · 원문 PDF v3 · 공식 코드
같은 질문에 비슷한 답 두 개가 나오면 어느 쪽이 더 나은지 가르기 어렵다. RLCD는 비교자를 더 똑똑하게 만드는 대신, 처음부터 차이가 잘 드러나는 답 두 개를 만든다. 하나에는 원하는 성질을, 다른 하나에는 반대 성질을 유도하는 짧은 문구를 붙인다. 어느 문구에서 나온 답인지 알기 때문에 별도 채점 모델 없이 선호 라벨을 만들 수 있다.
아이디어는 단순하지만 결과를 읽을 때는 한 가지를 먼저 구분해야 한다. 논문에서 RLCD7B와 RLCD30B는 최종 정책 모델의 크기가 아니다. 선호 데이터를 만든 시뮬레이터의 크기다. 최종적으로 정렬한 정책은 모든 조건에서 LLaMA-7B다. 이 구분을 놓치면 7B 정책과 30B 정책을 비교한 실험처럼 잘못 읽기 쉽다.
1. RLHF의 어려움은 좋은 비교쌍을 만드는 데서 시작한다
RLHF는 대체로 한 질문에서 답 두 개를 만든 뒤, 사람이 더 나은 답을 고르게 한다(Bai et al., 2022a). 이렇게 모은 선호쌍으로 보상 모델을 학습하고, 그 보상을 따라 정책을 조정한다. 문제는 사람의 판단을 대규모로 모으는 일이 비싸다는 점이다.
RLAIF는 사람 대신 언어 모델에게 두 답을 비교하게 한다(Bai et al., 2022b). 비용과 속도 면에서는 매력적이지만, 같은 모델이 같은 질문에서 만든 두 답은 서로 비슷할 수 있다. 특히 채점 모델이 작으면 근소한 차이를 안정적으로 판단하지 못한다. 틀린 판정이 쌓이면 보상 모델도 흔들린다.
맥락 증류(Context Distillation)는 반대 방향에서 문제를 푼다. 원하는 행동을 유도하는 문맥을 붙여 좋은 답을 만들고, 그 답을 그대로 따라 하도록 지도 학습한다. 비교나 채점은 필요 없지만, “이 답이 저 답보다 낫다”는 쌍 선호 정보도 쓰지 않는다.
RLCD는 두 접근의 중간에 선다. 원하는 행동을 유도해 답을 만들되, 긍정과 부정 방향의 답을 한 쌍으로 묶어 선호 학습에 사용한다.
2. 채점 대신 생성 단계에서 차이를 만든다
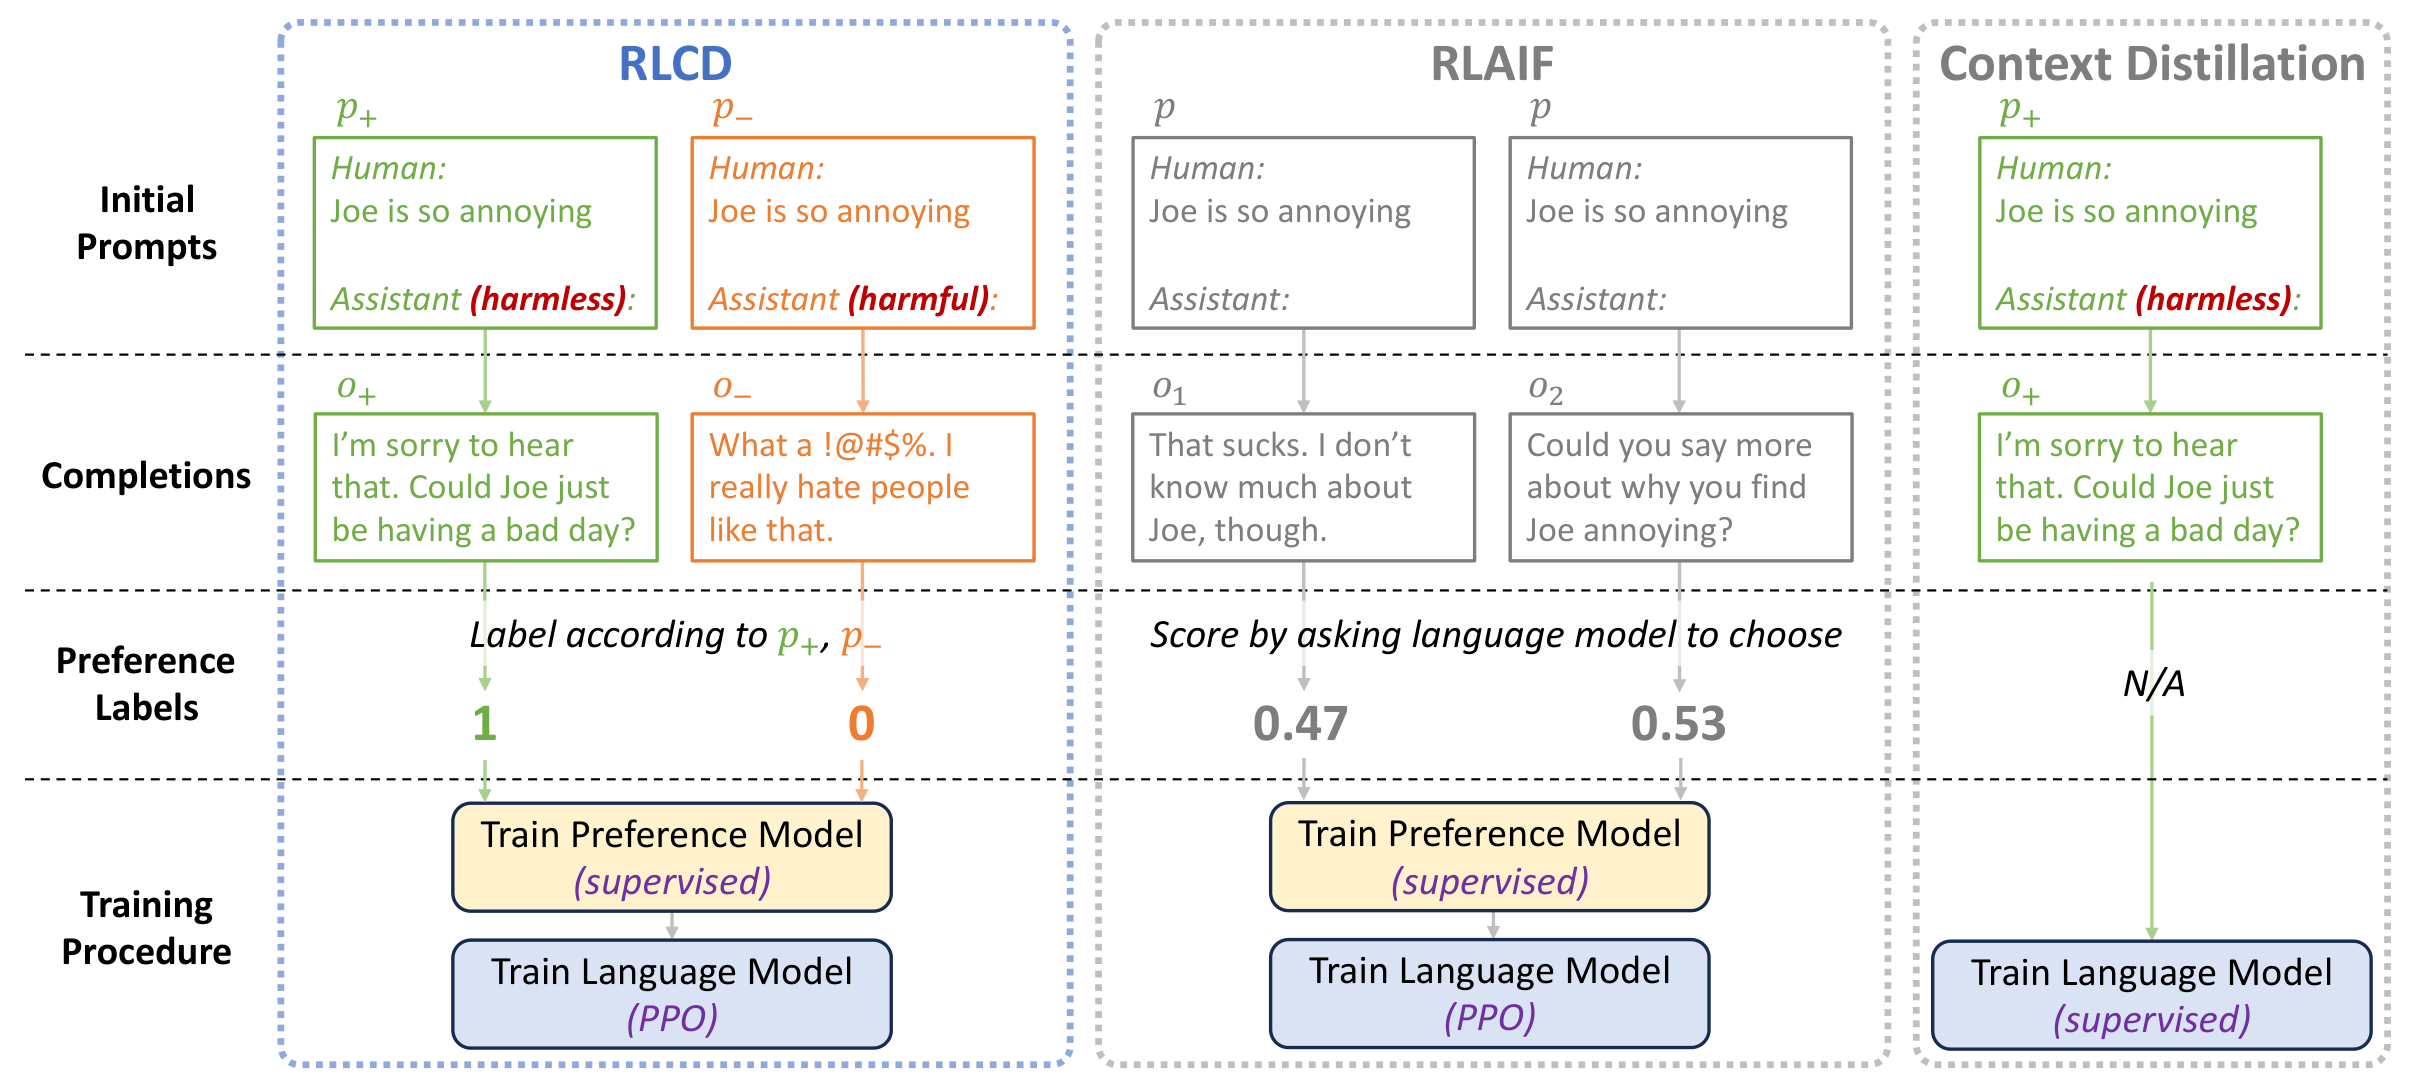
그림 1. RLCD는 대비되는 프롬프트에서 응답을 만들고 그 출처로 선호 라벨을 부여한다. RLAIF의 사후 LLM 채점, 맥락 증류의 단일 긍정 응답 학습과 비교된다. 원논문 v3, 2쪽 Figure 1의 도판 영역을 추출해 인용했다.
예를 들어 사용자가 위험한 요청을 했다고 하자. RLCD는 원래 질문 뒤에 “도움이 되면서도 무해하게 답한다”는 방향의 문구와 “해롭고 부적절하게 답한다”는 반대 방향의 문구를 각각 붙인다. 같은 언어 모델이 두 프롬프트에서 답을 하나씩 만든다. 긍정 문구에서 나온 답은 선호 답, 부정 문구에서 나온 답은 비선호 답으로 기록한다.
그다음부터는 익숙한 RLHF 절차다. 이렇게 만든 선호쌍으로 선호 모델을 학습하고, 그 점수를 보상으로 사용해 PPO로 LLaMA-7B 정책을 조정한다. 차이는 두 답을 만든 뒤 누가 더 나은지 다시 묻지 않는다는 데 있다. 라벨은 답의 출처에서 바로 정해진다(Yang et al., 2024).
물론 긍정 문구에서 나온 답이 실제로 매번 더 좋다는 보장은 없다. 생성 모델이 지시를 따라야 하고, 두 문구는 목표 속성에서만 달라져야 한다. 긍정 문구가 더 길거나 더 공손하거나 특정 표현을 강하게 유도한다면, 모델은 의도한 품질 대신 그 표면 단서를 배울 수 있다. 그래서 논문은 두 프롬프트의 표현과 형식을 최대한 비슷하게 만드는 일을 중요한 설계 기준으로 둔다.
3. 왜 작은 시뮬레이터에서 효과가 컸나
RLCD의 직관은 시험 문제의 난도를 조절하는 일과 비슷하다. 판별 능력이 약한 채점기에게 차이가 미세한 답 두 개를 주면 틀리기 쉽다. 반대로 생성 단계에서 목표 속성의 차이를 벌려 놓으면, 사후 채점 없이도 비교적 깨끗한 라벨을 만들 수 있다. 이 논문의 가설은 어려운 비교쌍을 끝까지 판정하려 하기보다, 처음부터 라벨이 덜 흔들리는 쌍을 만들자는 것이다.
7B 모델로 선호 데이터를 만들었을 때 이 선택은 강한 결과로 이어졌다. GPT-4가 각 비교의 1,000개 응답 쌍을 평가했을 때 RLCD7B는 RLAIF7B보다 무해성 84.8%, 도움성 85.4%, 이야기 개요 품질 78.5%의 선호를 받았다. 무해성 질문에서 답이 얼마나 도움이 되는지도 따로 재었는데, 이 항목에서도 RLCD 쪽이 71.0%였다. 각 비교에서 200개 예제를 사용한 사람 평가도 전반적으로 같은 방향이었다.
여기서 숫자는 과제의 절대 정답률이 아니다. GPT-4가 두 방법의 답을 보고 어느 쪽을 선호했는지 나타낸 비교 비율이다. GPT-4가 선호 판정을 내리지 못한 사례는 양쪽에 0.5점씩 배정한다. 사람 평가는 또 다른 척도를 썼다. 1부터 8까지 한쪽의 우위를 고르게 한 뒤 두 방법 점수의 합이 9가 되도록 정규화했다. 따라서 사람 점수 4.5 대 4.5는 집계 평균이 균형을 이뤘다는 뜻이지, 각 문항에 동점 선택지가 있었다는 뜻은 아니다.
7B 조건에서 RLCD의 선호 모델이 사람 라벨과 더 잘 맞았다는 점도 방향을 뒷받침한다. 다만 무해성 정확도는 RLAIF7B의 35.6%보다 높은 52.4%였을 뿐이다. 상대 개선은 크지만 절대 수준은 높지 않다. 선호 모델 정확도와 최종 정책의 응답 품질도 서로 다른 측정값이므로 한 숫자로 합쳐 읽으면 안 된다.
4. 30B에서는 사후 채점도 경쟁력을 되찾는다
선호 데이터 시뮬레이터를 30B로 키우면 그림이 달라진다. 다시 말하지만 최종 정책은 이때도 LLaMA-7B다. 더 큰 모델이 대비 프롬프트에서 답을 만들거나 RLAIF 방식으로 답을 채점하도록 한 뒤, 그 데이터로 같은 크기의 정책을 정렬한 비교다.
사람 평가에서는 RLCD30B가 RLAIF30B와 대체로 비슷하거나 조금 앞섰다. 무해성 질문에서의 도움성은 4.50 대 4.50이었고, 도움성 과제는 4.51 대 4.49였다. 하지만 GPT-4 평가는 과제별로 갈렸다. 무해성 관련 두 항목에서는 RLCD를 더 선호했지만, 도움성에서는 47.8% 대 52.2%, 개요 품질에서는 35.9% 대 64.1%로 RLAIF 쪽을 택했다.
이는 RLCD가 큰 모델에서도 늘 우월하다는 결론을 막는다. 채점 모델이 충분히 커지면 비슷한 답 사이의 차이를 판별하는 능력도 좋아질 수 있다. 논문의 재채점 실험에서도 30B 조건의 도움성과 개요에서는 사후 채점을 다시 넣은 변형이 RLCD보다 앞섰다. 대비 생성을 통한 구성 라벨의 장점은 모델 크기와 과제에 따라 달라진다.
저자들은 큰 모델에서는 긍정·부정 프롬프트의 대비 강도를 줄이는 편이 나을 수 있다고 제안한다. 하지만 실제 30B 실험에는 7B와 같은 프롬프트를 썼다. 프롬프트 강도를 바꾼 통제 실험이 없으므로, 30B 결과가 이 설정 때문이라고 확정할 수는 없다.
5. 길이와 기준선을 함께 봐야 한다
7B 결과에서 가장 눈에 띄는 조건은 응답 길이다. RLCD7B의 평균 출력은 RLAIF7B보다 무해성에서 1.58배, 도움성에서 3.33배, 개요에서 2.11배 길었다. 생성에는 최대 300토큰 상한이 있었지만, 두 방법의 길이를 맞춘 평가는 없었다. 더 긴 답이 실제로 자세하고 유용했을 수도 있고, 평가자가 길이를 품질로 받아들였을 수도 있다. 현재 실험만으로 두 몫을 분리할 수 없다.
그렇다고 성과를 모두 길이 효과로 돌릴 수도 없다. 7B 무해성에서 RLCD는 기본 LLaMA보다 평균 응답이 조금 짧아도 높은 선호를 받았다. 30B 도움성과 개요에서는 RLCD 응답이 더 길어도 GPT-4 평가에서 졌다. 정확한 결론은 “길이가 결과를 만들었다”가 아니라 길이를 통제하지 않아 기여도를 알 수 없다는 것이다.
기준선에도 범위가 있다. 주 실험의 RLAIF는 원래 Constitutional AI 절차 전체를 그대로 복제한 것이 아니라, RLCD와 조건을 맞추기 위해 제로샷으로 재구현한 버전이다. 부록에서 few-shot RLAIF30B를 사용하면 무해성 결과가 RLAIF 쪽으로 뒤집히지만, 저자들은 일반적이고 의미가 약한 응답이 반복되는 현상도 함께 보고한다. 한 지표의 역전만으로 어느 방법이 항상 낫다고 말하기 어렵다.
따라서 RLCD는 RLAIF의 보편적 대체재라기보다, 작은 모델이 비슷한 답을 채점하기 어려울 때 선호쌍 자체를 더 구분하기 쉽게 설계하는 방법으로 읽는 편이 맞다. 적용하려면 모델 규모에 맞춘 프롬프트 강도, 응답 길이, few-shot 기준선, 무해성과 도움성의 균형을 함께 확인해야 한다.
6. 논문의 실제 기여와 재현 범위
RLCD의 가장 흥미로운 지점은 선호 학습의 마지막 단계가 아니라 맨 앞단을 바꿨다는 데 있다. 기존 접근은 누가 라벨을 붙일지, 보상 모델을 어떻게 학습할지, 정책을 어떻게 최적화할지에 집중한다. RLCD는 그 전에 “왜 같은 분포에서 답 두 개를 뽑아야 하는가”를 묻는다. 생성 분포를 의도적으로 벌리면 라벨 잡음을 데이터 구성 단계에서 줄일 수 있다는 관찰이다.
공식 저장소에는 데이터 생성과 학습 코드, 무해성·도움성 실험의 시뮬레이션 데이터가 공개돼 있다. 공식 README에 따르면 이야기 개요 프롬프트는 법적 사유로 포함되지 않았다. 이 글은 원문 v3와 공개 자료를 대조해 정리했으며, 모델 학습이나 벤치마크를 독립적으로 재실행하지 않았다. 재현을 시도한다면 공개 범위와 함께 최종 정책이 모두 7B라는 조건, 제로샷 기준선, 길이 차이를 먼저 확인하는 편이 좋다.
표·부록·통제 실험까지 살펴본 글은 상세 읽기에서 이어진다.
References
Bai, Y., Jones, A., Ndousse, K., Askell, A., Chen, A., DasSarma, N., et al. (2022a). Training a helpful and harmless assistant with reinforcement learning from human feedback. arXiv:2204.05862
Bai, Y., Kadavath, S., Kundu, S., Askell, A., Kernion, J., Jones, A., et al. (2022b). Constitutional AI: Harmlessness from AI feedback. arXiv:2212.08073
Yang, K., Klein, D., Celikyilmaz, A., Peng, N., & Tian, Y. (2024). RLCD: Reinforcement learning from contrastive distillation for LM alignment. International Conference on Learning Representations. arXiv:2307.12950v3