EvoOntology: A Self-Evolving Ontology Layer for Data Agents
데이터를 더듬는 에이전트에게 검색 가능한 사전을 쥐여 주면 — 쉽게 읽는 EvoOntology
데이터 에이전트가 필요한 의미 정보만 찾아 쓰고 실행 기록으로 온톨로지를 고치는 과정을 수식 없이 설명한다. 세 벤치마크의 성능과 DDR 네 백본에서 측정한 토큰 사용량을 함께 읽는다.
Paper: Meiduo Chong; Shaolei Zhang; Ju Fan; Xiaoyong Du (2026). "EvoOntology: A Self-Evolving Ontology Layer for Data Agents." arXiv:2609.15779v1 (2026-09-14). PDF.
이 글은 논문을 수식 없이 읽는 버전이다. 수치와 재현 조건을 자세히 따지는 글은 딥리뷰에 있다. 본문의 실험 수치는 논문의 표와 도판에 근거하며, 별도 표시가 없는 주 결과는 여섯 백본 평균이다.
요지는 이렇다. 에이전트와 데이터 사이에 용어 사전을 두고 필요할 때 찾아보게 하자, 세 벤치마크에서 성능이 올랐다. DDR-Bench의 네 백본 분석에서는 과제당 총 토큰도 줄었다.
1. 에이전트는 데이터를 더듬는다
회사 데이터에 대해 질문에 답하는 AI 에이전트를 생각해 보자. "지난달에 비용이 왜 올랐지?" 같은 질문이다.
데이터는 에이전트 바깥에 있다. 데이터베이스에, 스프레드시트에, 문서 파일에 흩어져 있고, 에이전트가 손댈 수 있는 건 "SQL을 실행한다" "파일을 읽는다" 같은 일반 도구뿐이다. 어느 표에 '비용'이 들어 있는지, 그 열 이름이 뭔지 미리 알 수가 없다.
그래서 에이전트는 더듬는다. 표 목록을 훑고 그럴듯한 열을 열어 보고, 아니면 다음 걸 열어 본다. 논문은 이 상태를 에이전트–데이터 간극이라고 부른다.
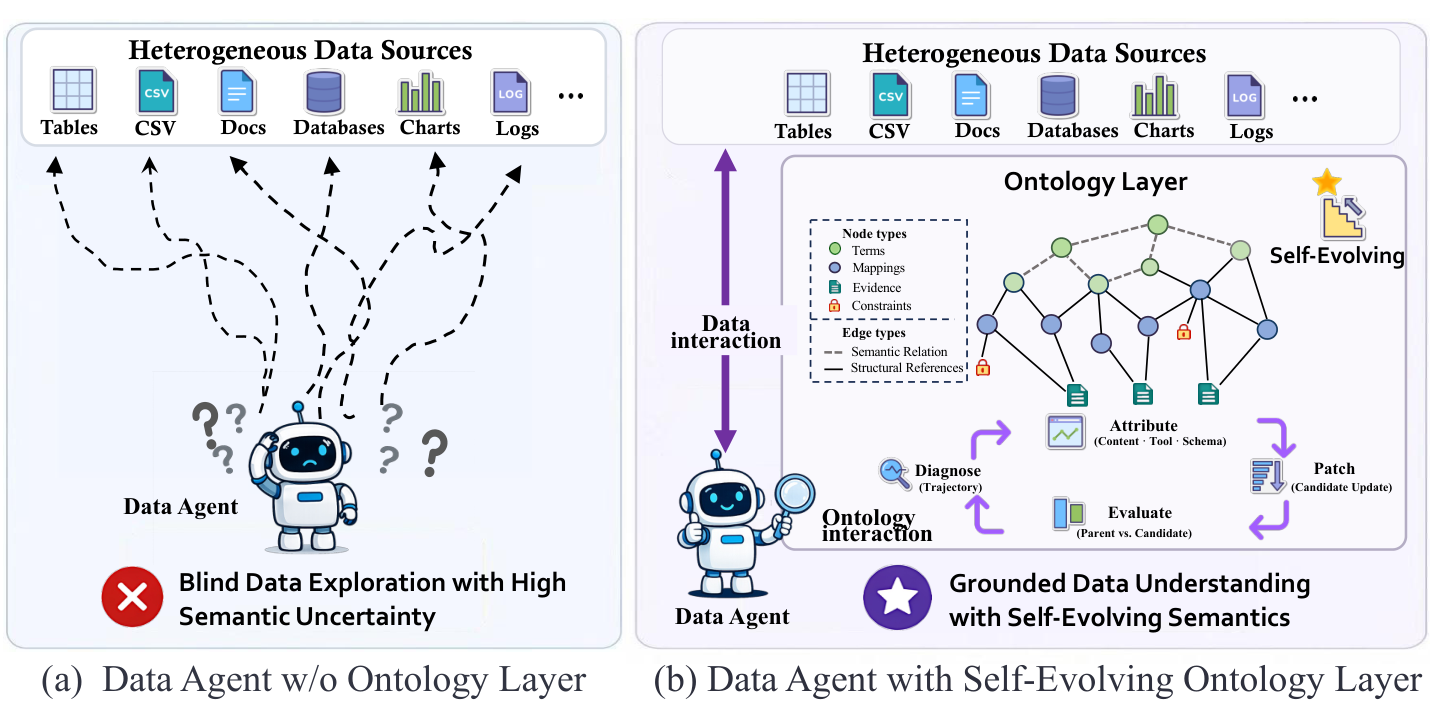
Figure 1. 온톨로지 없이 데이터를 탐색하는 에이전트와, 의미 정보를 찾아 쓰며 네 단계로 사전을 갱신하는 에이전트를 대비한다. 논문 v1, 1쪽 Figure 1에서 인용.
2. 기존 해법 둘, 그리고 각각이 막히는 곳
첫째, 그냥 더듬게 둔다. 작은 데이터에서는 괜찮다. 표가 몇 개 안 되면 다 열어 봐도 된다. 그런데 표가 수백 개고 이름 규칙도 제각각이면 에이전트가 같은 데를 맴돌기 시작한다.
둘째, 사전을 만들어 준다. "매출이란 취소 주문을 뺀 금액이고 fact_rev.net_revenue에 있다" 같은 설명을 미리 써 두는 것이다. 이쪽은 두 군데서 막힌다. 데이터가 크면 사전 전체가 프롬프트에 안 들어가고, 그 사전을 사람이 만들어서 계속 고쳐야 한다.
3. 바꾼 것: 붙여 주지 말고 찾아보게 한다
사전 자체는 두고 주는 방식을 바꾸자는 것이 논문의 제안이다.
프롬프트에 통째로 붙이는 대신, 사전을 서비스로 띄운다. 에이전트는 작업 도중에 browse로 관련 용어를 찾고, resolve로 용어의 상세 정보를 받아 온다. 검색 창을 하나 준 셈이다.
프롬프트에는 어떤 데이터가 있고 두 도구를 어떻게 쓰면 되는지를 적은 안내문만 들어간다. 나머지는 물어볼 때 나온다. 뒤에서 보겠지만 진화 루프에서 가장 큰 이득을 낸 것이 바로 이 안내문을 고치는 일이었다.
왜 차이가 날까. 논문에 따르면 프롬프트에 박아 넣은 사전은 에이전트의 다른 지시와 자리를 다투고, 단계마다 걷어낼 수가 없다. 지금 필요 없는 설명도 계속 눈앞에 있다. 검색해서 꺼내 오면 지금 단계에 필요한 것만 온다.
4. 사전에 뭐가 들어가나
먼저 짚어 둘 게 있다. 여기서 "사전"이라 부르는 것은 논문이 말하는 세 층 가운데 하나다. 실제 내용이 담기는 콘텐츠 층, 그 내용이 어떤 모양이어야 하는지를 정하는 스키마 층, 그리고 그것을 밖으로 내보내는 도구 층이다. 뒤에서 "어느 층을 고쳤나"를 따질 때 이 셋이 다시 나온다.
콘텐츠 층에 담기는 항목은 네 가지가 짝을 이룬다.
| 무엇인가 | 예 | |
|---|---|---|
| Term | 사람이 쓰는 개념 이름 | "비용", "매출", "이익" |
| Mapping | 어느 열에 있는지, 그리고 표를 잇는 경로 | fact_cost.total_cost |
| Constraint | 쓸 때 지켜야 할 규칙 | "매출은 취소 주문을 뺀다" |
| Evidence | 그게 맞다는 근거 | 실제로 조회해 본 결과 |
항목끼리 잇는 선도 두 종류 있다. 용어와 용어를 잇는 선(이익 = 매출 − 비용 같은 파생 관계)과, 용어를 그 매핑·제약·근거에 붙이는 선이다. 논문이 하나씩 가려 본 것은 앞의 것뿐이고 기여가 가장 작았다(−2.1점). 뒤의 것은 따로 가려 보지 않았고 논문은 그 이유를 적지 않는다.
Evidence가 핵심이다. 사전에 올리려면 실제로 조회해 봐서 맞아야 한다. "매출은 아마 이 열일 것이다"로는 등재되지 않는다. 뒤에서 보겠지만 이 결정이 성능에 크게 기여한다.
5. 스스로 고치되, 함부로는 못 고치게
사전을 처음 잘 만들어도 그게 특정 에이전트에게 맞는다는 보장은 없다. 그래서 논문은 에이전트가 실제로 일한 기록을 보고 사전을 고친다. 네 단계다.
- 진단 — 실패한 작업들을 모아 반복되는 패턴을 찾는다. "채널별 비용을 물으면 자꾸 실패하네."
- 귀속 — 그게 어느 층의 문제인지 정한다. 용어가 없나(콘텐츠), 도구가 부족한가(도구), 표현 구조 자체가 모자란가(스키마).
- 수정 — 한 층만 고친다. 여러 군데를 동시에 고치면 뭐가 효과가 있었는지 알 수 없어서다.
- 평가 — 고치기 전 사전과 고친 사전을 따로 떼어 둔 검증 묶음에서 같은 조건으로 나란히 돌려 보고 정해 둔 문턱값 이상 나아졌을 때만 채택한다. 아니면 배포하지 않고 이전 사전을 그대로 둔다. 고칠 때 쓴 문제로 채점하는 것이 아니라는 점이 중요하다.
이 논문에서 가장 중요한 장치는 4번의 평가다. 뒤에서 숫자로 확인된다.
6. 실제로 어떻게 생겼나
논문이 든 예가 구체적이라 그대로 따라가 볼 만하다. 카드 게임 데이터에서 "특정 포맷에서 금지된 카드"를 찾는 작업이다.
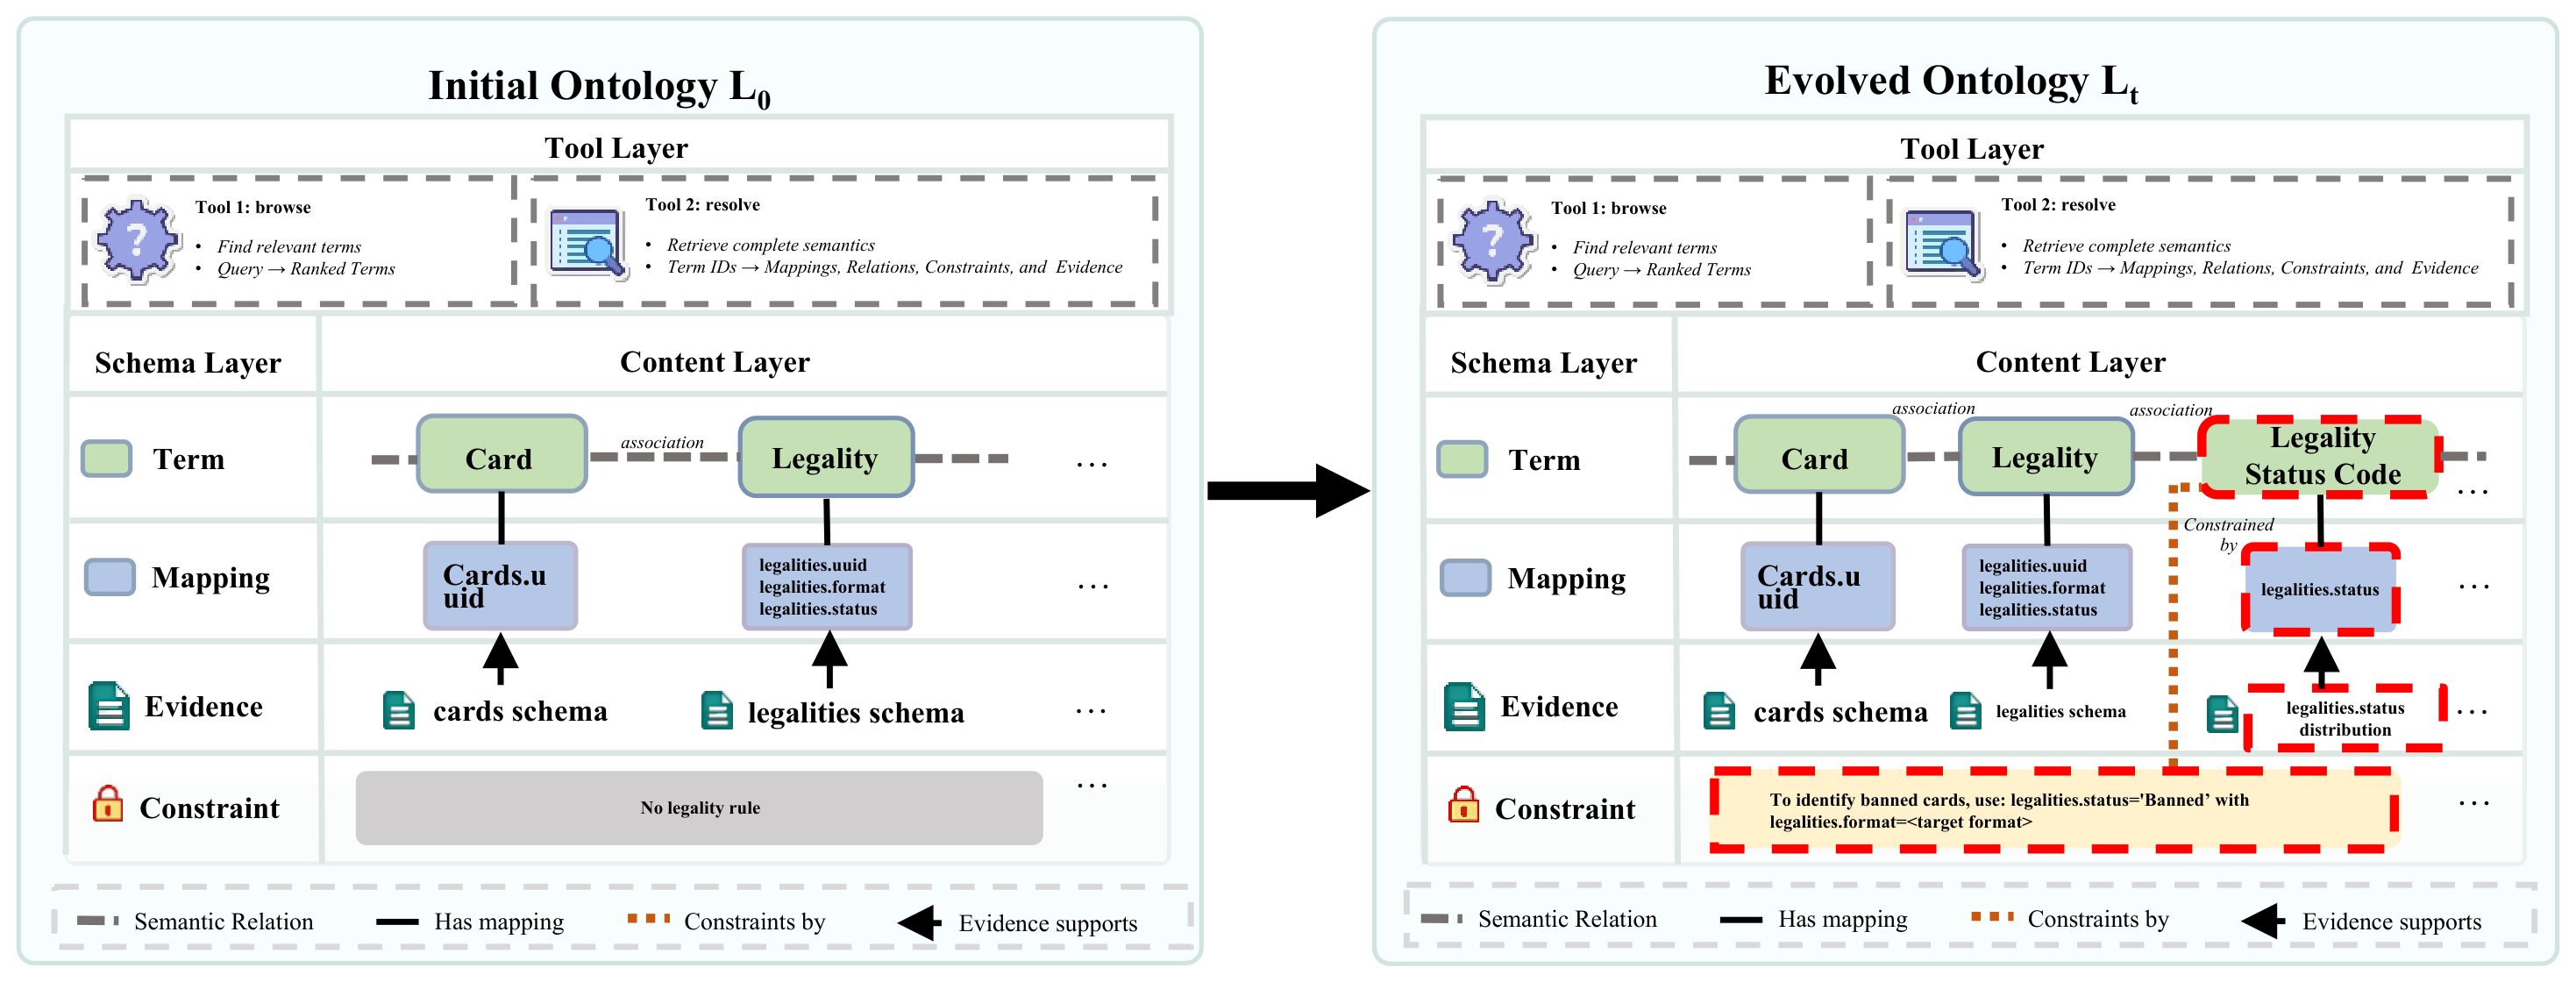
Figure 8. 카드 금지 판정 사례에서 새 용어·매핑·근거·제약이 콘텐츠 층에 추가된다. 도구 층은 그대로다. 논문 v1, 11쪽 Figure 8에서 인용.
초기 사전은 "어느 표를 봐야 하는지"까지는 알려 준다. 그런데 legalities.status에 들어 있는 값을 어떻게 해석해야 하는지는 말해 주지 않고, 금지 여부가 게임 포맷마다 다르다는 것도 말해 주지 않는다. 그래서 에이전트가 매번 실제 값을 뒤져 가며 다시 알아내야 한다.
수정은 용어 하나와 그 부속물만 더한다. 도구도 구조도 건드리지 않는다. 도판에서 위쪽 도구 칸이 양쪽 똑같은 것이 그 뜻이다.
7. 결과
세 벤치마크에서 잰다. 개방형 데이터 리서치(DDR-Bench), 비즈니스 분석(InsightBench), 그리고 자연어를 SQL로 바꾸는 과제(BIRD)다. 백본은 GPT·Claude·DeepSeek·Qwen 계열 여섯이다.
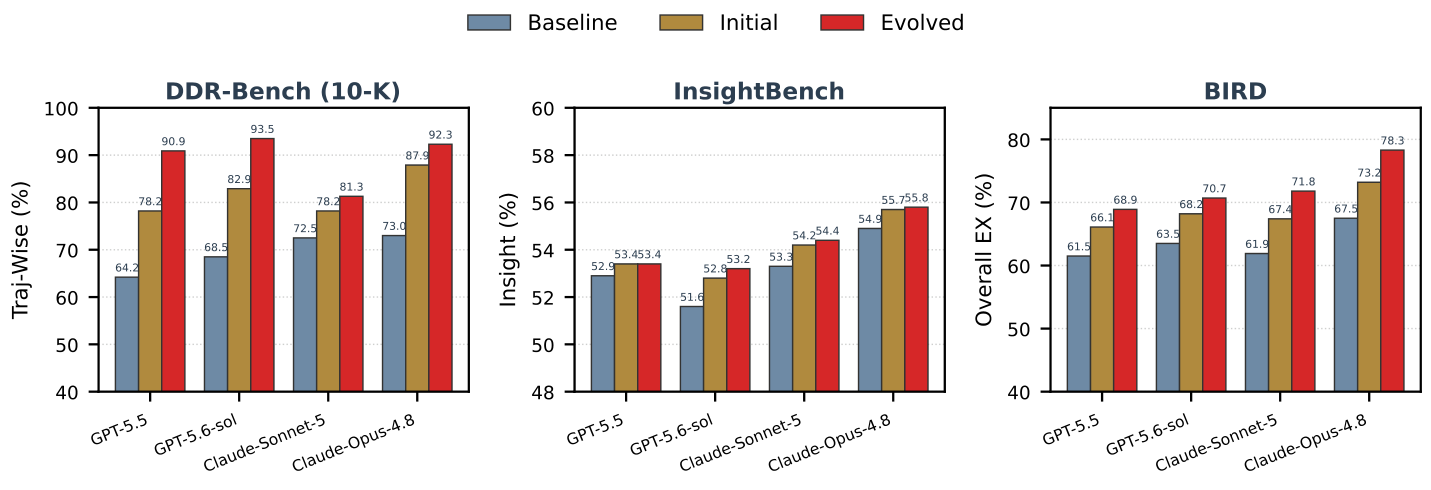
Figure 3. 네 백본의 Baseline·Initial·Evolved를 DDR-Bench, InsightBench, BIRD에서 비교한다. 막대축은 0에서 시작하지 않는다. 논문 v1, 6쪽 Figure 3에서 인용.
DDR-Bench에서 여섯 백본 평균 +17.8점. 폭은 +4.8부터 +26.7까지다. BIRD에서 +7.4점. 여기까지는 크다.
InsightBench는 +1.9점으로 훨씬 작다. 논문은 이 벤치마크의 채점이 짧은 참조 문장과 맞추는 방식이라 답이 맞는 순간 점수가 포화한다고 설명한다.
그리고 비교 대상이 하나 더 있다. 빌더가 만든 시맨틱 레이어를 정적 프롬프트 조각으로 앞세운 버전이다. 이쪽은 일관되게 좋아지지 않는다. DDR-Bench의 한 백본에서는 15.0점 떨어진다. 다만 프롬프트에 실제로 넣은 레이어의 양이 명시되지 않아, 이 차이만으로 도구 접근 방식의 효과를 분리할 수는 없다.
8. 무엇이 일을 하는가
DDR-Bench의 네 백본 부분집합에서 부품을 하나씩 빼 보면 기여가 갈린다.
- 평가 게이트를 빼면 −11.2점. 가장 크다. 거르지 않으면 나쁜 수정이 섞여 들어오고 다음 라운드가 늘 되돌릴 수 있는 것은 아니기 때문이다.
- 귀속 단계를 빼면 −6.3점. 어느 층 문제인지 안 정하면 엉뚱한 층을 고친다.
- 사전 내용 중에서는 Mapping을 가리면 −13.4점, Evidence를 가리면 −8.7점으로 이 둘이 지탱한다. 실제 열에 연결해 주는 것과, 조회해서 확인한 근거다.
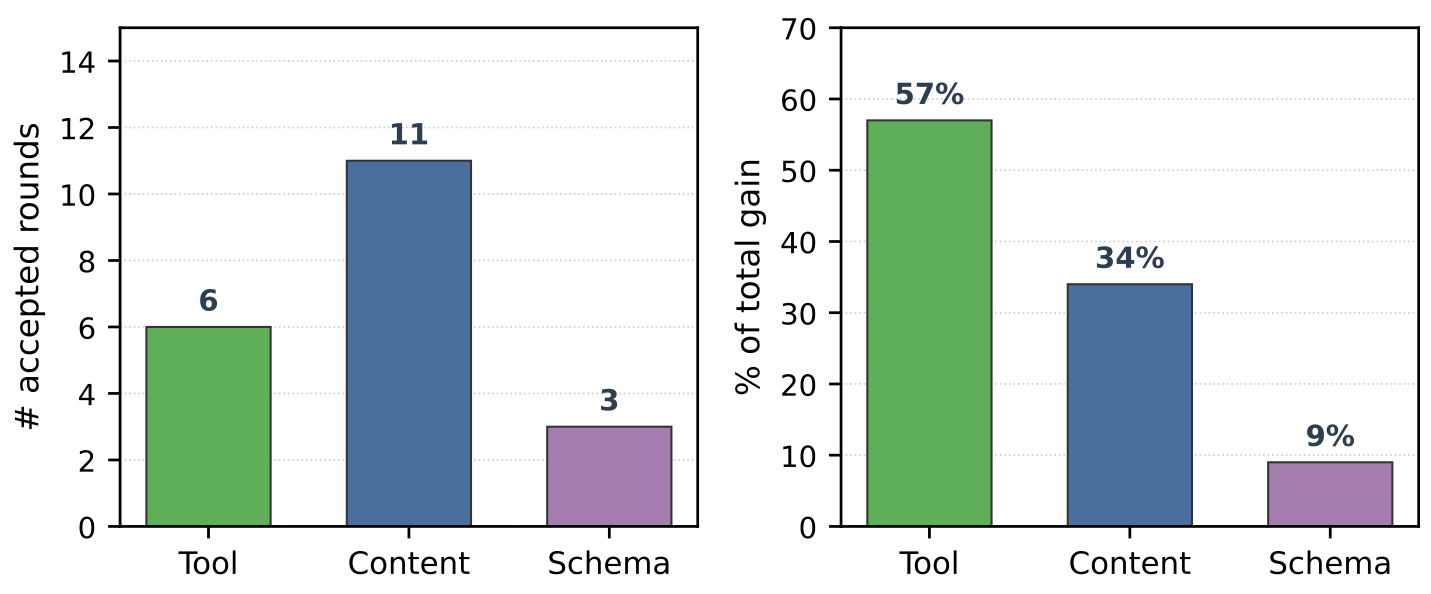
Figure 7. 채택된 수정 횟수는 콘텐츠가 가장 많고, 보고된 이득 비율은 도구 수정이 가장 크다. 논문 v1, 10쪽 Figure 7에서 인용.
횟수와 이득을 나눠 보면 순서가 바뀐다. 내용 수정이 횟수로는 제일 많은데(11번), 이득 비율로는 도구 수정이 제일 크다(57%, 6번). 사전에 뭘 더 넣는 것보다 그걸 어떻게 꺼내 쓰게 하느냐를 손보는 쪽이 효과가 컸다는 뜻이다. 다만 양자택일은 아니다. 논문은 세 층을 하나씩만 써 본 실험도 붙여 두었는데, 도구만 고친 쪽이 +13.2로 가장 크지만 셋을 다 쓴 +20.0에는 어느 하나도 미치지 못한다.
9. 과제당 토큰 사용량은 줄어든다
DDR-Bench의 네 백본 분석 부분집합에서 보고한 결과다.
| 기존 | 사전 도입 | 고친 뒤 | |
|---|---|---|---|
| 한 턴당 입력 토큰 | 3.2K | 4.1K | 4.6K |
| 과제당 턴 수 | 14.6 | 11.2 | 8.4 |
| 과제당 총 토큰 | 52.6K | 50.4K | 42.0K |
한 턴에 쓰는 맥락은 늘어난다. 사전 안내문과 꺼내 온 내용이 붙으니까. 그런데 더듬는 횟수가 줄어서 과제당 총 토큰은 약 20% 감소한다. 이 비교는 사전이 아예 없는 상태와 사전을 둔 상태 사이이고, 프롬프트에 붙인 버전의 토큰 사용량은 논문이 재지 않았다. 같은 비교에서 성능은 69.5에서 89.5로 오른다. 가격·지연 시간·온톨로지 구축과 진화에 든 자원까지 합친 비용은 측정하지 않았다.
이 부분집합에서는 성능이 오르면서 과제당 총 토큰은 줄었다.
10. 걸리는 것들
논문을 읽다 보면 표와 본문이 어긋나는 데가 몇 군데 있다.
초록은 백본이 넷이라 하고 본문은 여섯이라 한다. 표에는 여섯 줄이 있다. 넷은 뒤쪽 분석에만 쓴 부분집합이고 논문이 그걸 밝히기는 하는데, 정작 초록이 자기 실험을 실제보다 작게 적는다.
InsightBench 표에서 두 줄이 같다. 여섯 백본 중 둘(GPT-5.5, Claude-Opus-4.8)에서 EvoOntology의 값이 정적 프롬프트 기준선과 소수점 한 자리까지 같다. 세 지표와 괄호 안 증분도 동일하다. 표의 반올림된 결과에서 관찰되는 일치이며, 이것만으로 표 오류를 단정할 수는 없다.
비교군에 사전이 얼마나 들어갔는지 밝히지 않는다. 논문은 서론에서 "사전 전체를 맥락에 넣는 것은 큰 데이터에서 현실적이지 않다"고 적지만, 정적 프롬프트 기준선의 정의는 "정적 프롬프트 조각으로 앞세운다"까지다. 투입된 정보량을 모르므로 정적 프롬프트와 동적 도구 접근의 효과를 따로 가르기 어렵다.
가장 중요한 장치에 숫자가 없다. 5절의 평가 게이트는 "얼마 이상 좋아지면 채택한다"는 문턱값으로 정의되는데, 논문은 그 문턱을 기호로만 적고 값을 밝히지 않는다. 이 게이트를 빼면 부품 절제에서 가장 크게 떨어진다.
진화가 실제로 얼마나 보태는지는 벤치마크마다 다르다. Figure 3의 네 백본에서 사전을 만들기만 한 상태와 고친 상태를 비교하면, 더해지는 몫이 DDR-Bench에서 7.7점, BIRD에서 3.7점인데 InsightBench에서는 0.2점이고, 그중 한 백본에서는 표시된 차이가 0.0이다. 반올림 전 값이나 반복 실행의 불확실성이 없어 이 작은 차이의 유의성은 알 수 없다. 그런데 논문은 이 문단을 "자기진화 루프는 완전한 성능 이득을 실현하는 데 필수적"이라고 맺는다. 방향으로는 맞지만 폭까지 함께 읽어야 한다.
11. 정리
바꾼 것은 하나다. 에이전트와 데이터 사이의 사전을 프롬프트에 붙이는 자료에서 에이전트가 찾아보는 서비스로 옮기고 그 사전을 실행 기록으로 고치되 검증을 통과한 수정만 남겼다.
얻은 것은 둘이다. 개방형 데이터 리서치에서 큰 폭으로(+17.8점), SQL 생성에서 상당한 폭으로(+7.4점) 오른다. DDR-Bench의 네 백본 부분집합에서는 사전이 아예 없던 상태에 견줘 과제당 총 토큰이 약 20% 준다.
조건도 분명하다. 짧은 참조형 채점에서는 이득이 +1.9점으로 작고, 정적 프롬프트 기준선은 일부 백본에서 떨어진다. 교차 백본 분석에서는 배포 백본에 맞춰 진화한 저장소가 각 열에서 가장 높지만, 새 백본마다 반드시 다시 진화해야 한다는 뜻은 아니다.
설계는 필요한 의미 정보를 도구로 꺼내 쓰게 하고 수정을 배포 전에 검증하는 관문을 둔다. 정적 프롬프트 기준선과의 비교는 전반적으로 이 접근을 지지하지만 투입 정보량이 명시되지 않았고 InsightBench 두 백본에서는 반올림된 값이 같다. 게이트 제거 절제의 하락폭은 DDR-Bench 네 백본에서 −11.2점으로 가장 컸다. 다만 논문은 채택 문턱값을 숫자로 밝히지 않는다.
더 자세한 수치 대조와 검토는 딥리뷰에 있다. 원문은 arXiv:2609.15779에서 볼 수 있다.
References
Chong, M., Zhang, S., Fan, J., & Du, X. (2026). EvoOntology: A self-evolving ontology layer for data agents (arXiv:2609.15779v1). arXiv. https://arxiv.org/abs/2609.15779