EvoOntology: A Self-Evolving Ontology Layer for Data Agents
데이터 에이전트가 필요한 의미 정보만 찾아 쓰고 실행 기록으로 온톨로지를 고치는 과정을 수식 없이 설명한다. 세 벤치마크의 성능과 DDR 네 백본에서 측정한 토큰 사용량을 함께 읽는다.
Paper: Meiduo Chong; Shaolei Zhang; Ju Fan; Xiaoyong Du (2026). "EvoOntology: A Self-Evolving Ontology Layer for Data Agents." arXiv:2609.15779v1 (2026-09-14). PDF. 이 글은 11쪽짜리 v1을 기준으로 한다. 논문 첫 쪽에는 코드 저장소가 적혀 있다.
Abstract: 데이터 에이전트는 표·파일·데이터베이스에 걸친 자연어 지시를 수행하지만, 데이터는 에이전트 바깥에 있고 에이전트는 열 이름이나 파일 경로 같은 일반 도구를 통해서만 접근한다. 이 논문은 그 에이전트–데이터 간극을 메우려고 중간에 온톨로지 층을 놓는다. 온톨로지는 스키마 층·콘텐츠 층·도구 층으로 나뉘고 전체가 MCP 서버로 감싸여, 에이전트가 맥락에 통째로 받는 대신 실행 중에 질의해 필요한 만큼만 꺼내 쓴다. 빌더 에이전트가 학습 워크로드와 원본 데이터에서 초기 온톨로지를 세우고, 진화 루프가 실행 기록을 분석해 유형이 지정된 편집을 제안하되 백본별 짝 평가를 통과한 것만 받아들인다. 세 개의 데이터 에이전트 벤치마크와 네 LLM 백본에서 기준선과 기존 시맨틱 레이어 방식을 모두 앞선다고 초록은 적는다. 본문과 표는 여섯 백본을 싣는데, 그 어긋남은 10절에서 따로 다룬다. 이 글은 그 이득이 어느 축에서 성립하는지, 그리고 표·도판과 본문 서술이 어긋나는 자리를 검토한다. 논문 초록 · §Method · §Experiments
수식 없이 읽는 버전은 쉽게 읽는 EvoOntology에 있다.
Executive Summary
| 항목 | 설명 |
|---|---|
| 연구 질문 | 이기종 데이터 위에서 일하는 에이전트에게, 프롬프트에 밀어 넣는 정적 시맨틱 레이어 대신 실행 중에 질의하는 온톨로지 층을 주면 더 잘하는가? |
| 구조 | 온톨로지 상태 L_t = (콘텐츠 S_t, 스키마 Γ_t, 도구 R_t). 콘텐츠는 노드 네 종류(Term·Mapping·Constraint·Evidence)와 엣지 두 종류(Semantic Relation·Structural Reference)의 타입 그래프다. 도구 층은 browse와 resolve 두 개의 MCP 도구와 세션 매니페스트를 노출한다. |
| 프롬프트에 들어가는 것 | 매니페스트뿐이다. 상세 레코드는 요청할 때 꺼낸다. |
| 진화 루프 | 궤적에서 반복 신호를 뽑고(진단), 콘텐츠·도구·스키마 중 한 층에 귀속하고, 그 한 층만 고치고, 부모 대 후보를 같은 검증 집합에서 비교해 마진 τ를 넘을 때만 채택한다. |
| 주 실험 | DDR-Bench(10-K)·InsightBench·BIRD 세 벤치마크, 여섯 백본. 폴드를 둘로 갈라 A→B와 B→A를 평균한다. 구축·분석에 폴드의 70%, 짝 검증에 30%를 쓰고 나머지 폴드는 동결 후 평가에만 쓴다. |
| 핵심 결과 | DDR-Bench Trajectory-Wise가 기준선 대비 평균 +17.8점(+4.8–+26.7). BIRD는 EX +7.4·VES +8.6. InsightBench는 Overall 평균 +1.9로 훨씬 작다. |
| 정적 레이어와의 대비 | Baseline+SL은 일관되게 개선하지 못하고 Claude-Sonnet-5의 Traj-Wise에서 −15.0이다. BIRD에서는 VES는 오르고 EX는 최대 −5.6으로 갈린다. 정적 프롬프트의 레이어 투입량은 명시되지 않았다. |
| 무엇이 일을 하는가 | DDR 네 백본 절제에서 게이트를 빼면 −11.2로 가장 크게 떨어진다. 도구만 진화시키면 +13.2로 단독 최대이고, Mapping·Evidence를 가리면 −13.4·−8.7이다. |
| 토큰 사용량 | DDR 네 백본 평균에서 턴당 입력 토큰은 3.2K에서 4.6K로 늘지만 14.6턴이 8.4턴으로 짧아져 과제당 총 토큰은 52.6K에서 42.0K로 약 20% 준다. |
| 핵심 한계 | 초록과 기여 목록은 백본이 넷이라 적고 본문·표·결론은 여섯이다. InsightBench 두 행은 정적 기준선과 소수점 한 자리까지 같다. 교차 백본 전이의 두 보조 수치는 도판에서 재현되지 않는다. 채택 마진 τ의 값은 없다. |
목차
- 에이전트와 데이터 사이의 간극
- 세 층으로 나눈 온톨로지
- 빌더 에이전트가 초기 상태를 세운다
- 진화 루프와 채택 게이트
- 세 벤치마크의 결과
- 초기 온톨로지와 진화의 몫
- 무엇이 실제로 일을 하는가
- 백본마다 다른 온톨로지가 자란다
- 토큰 사용량과 성장
- 한계, 재현 조건과 결론
1. 에이전트와 데이터 사이의 간극
출발점은 에이전트와 데이터의 배치 구조다. 실제 환경에서 데이터는 관계형 데이터베이스·반정형 보고서·비정형 문서로 에이전트 바깥에 있고 에이전트는 SQL 인터페이스나 파일 리더 같은 일반 도구로만 접근한다. 구조도 내용도 미리 알 수 없으므로 에이전트는 탐침 질의를 반복하며 어느 개념이 어디 있는지 추측하고 상관없는 내용을 들여다본다. 논문은 이것을 에이전트–데이터 간극이라 부른다. 논문 §Introduction
기존 접근은 둘로 갈린다. 원시 질의 방식은 에이전트가 스키마를 직접 읽고 탐색 질의를 던지게 한다. 작고 단순한 데이터에는 통하지만 넓고 이기종인 데이터에서는 반복적이고 비효율적인 탐색에 갇히기 쉽다. 시맨틱 레이어 방식은 스키마·엔티티·지표 같은 메타데이터를 미리 줘서 안내한다. 이쪽은 두 가지에 걸린다. 큰 데이터 소스에서는 레이어 전체를 맥락에 넣는 것이 맥락 길이 때문에 현실적이지 않고 레이어 자체가 대체로 사람이 미리 만들어 유지하는 것이라 새 데이터·새 과제·새 에이전트에 맞추기 어렵다.
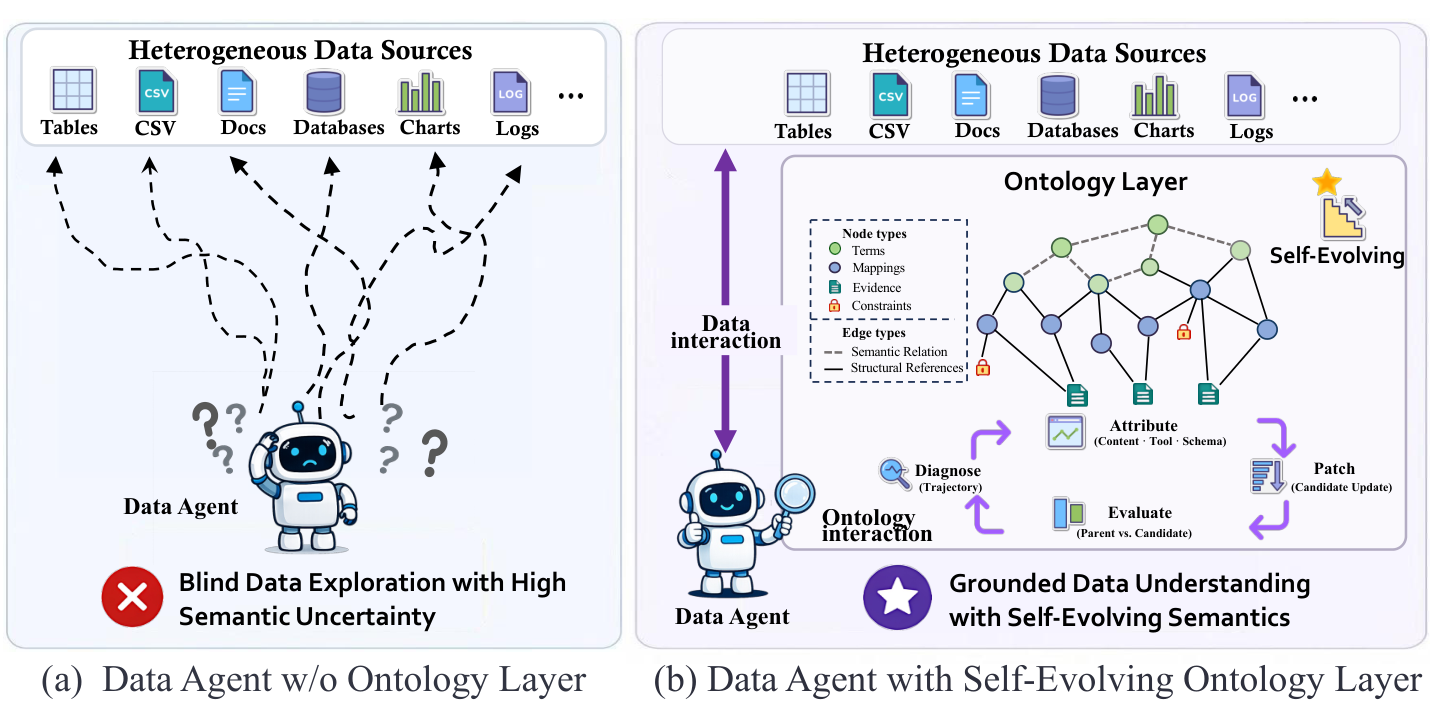
Figure 1. 이기종 데이터에 직접 접근할 때와 검색 가능한 온톨로지 층을 사이에 둘 때를 대비한다. 논문 v1, 1쪽 Figure 1에서 인용.
논문은 "정적인 의미 서술"을 "에이전트가 도구로 접근하는 상호작용형 층"으로 옮기자고 주장한다. 기여는 셋으로 정리된다. 상호작용형 온톨로지 층을 MCP 서버로 감싼 것, 빌더 에이전트와 진화 프레임워크, 그리고 실험이다. 첫 기여의 문장은 "데이터 에이전트를 위한 최초의 자율 상호작용형 온톨로지 층을 제안한다"로 적혀 있다. 배타 주장이므로 이 글에서는 검증 대상 밖으로 둔다. 논문 §Introduction
2. 세 층으로 나눈 온톨로지
온톨로지 상태는 진화 라운드 t에서 L_t = (S_t, Γ_t, R_t)로 적힌다. 세 층이 각각 의미 지식, 그 객체 모델, 그리고 런타임 노출을 맡는다. 이 분리 덕에 배포된 에이전트는 현재 단계에 필요한 의미만 꺼낼 수 있고 진화 에이전트는 한정된 부분만 고칠 수 있다.
콘텐츠 층 S_t는 타입이 있는 의미 그래프다. 노드는 네 종류다. Term은 도메인 개념을, Mapping은 그 개념을 실제 필드와 조인 경로에 접지하는 것을, Constraint는 유효한 사용 조건을, Evidence는 의미 주장을 뒷받침하는 관측을 담는다. 엣지는 두 종류다. Semantic Relation은 Term 사이를 연관·계층·구성·동등·파생으로 잇고, Structural Reference는 Term을 Mapping에 잇고 Constraint와 Evidence를 그것이 지배하거나 뒷받침하는 객체에 붙인다.
스키마 층 Γ_t는 네 노드 종류의 필드, 허용되는 Semantic Relation 유형, 허용되는 참조 패턴을 정의한다. 스키마를 고치면 인스턴스 내용을 바꾸지 않고도 표현 능력 자체를 넓힐 수 있다.
도구 층 R_t는 MCP 도구 두 개와 세션 매니페스트를 노출한다. f_browse(q, k, n)은 질의 q와 종류 k에 대해 상위 n개의 의미 매치를 돌려주고, f_resolve(I, c)는 요청한 레코드와 그것에 연결된 객체를 돌려준다. 매니페스트는 세션 시작 때 소스와 사용법을 압축해 전달한다. 프롬프트에 놓이는 온톨로지 내용은 이 매니페스트뿐이고 상세 레코드는 요청할 때만 꺼낸다. 이 지점에서 정적 시맨틱 레이어와 갈린다. 논문 §Method
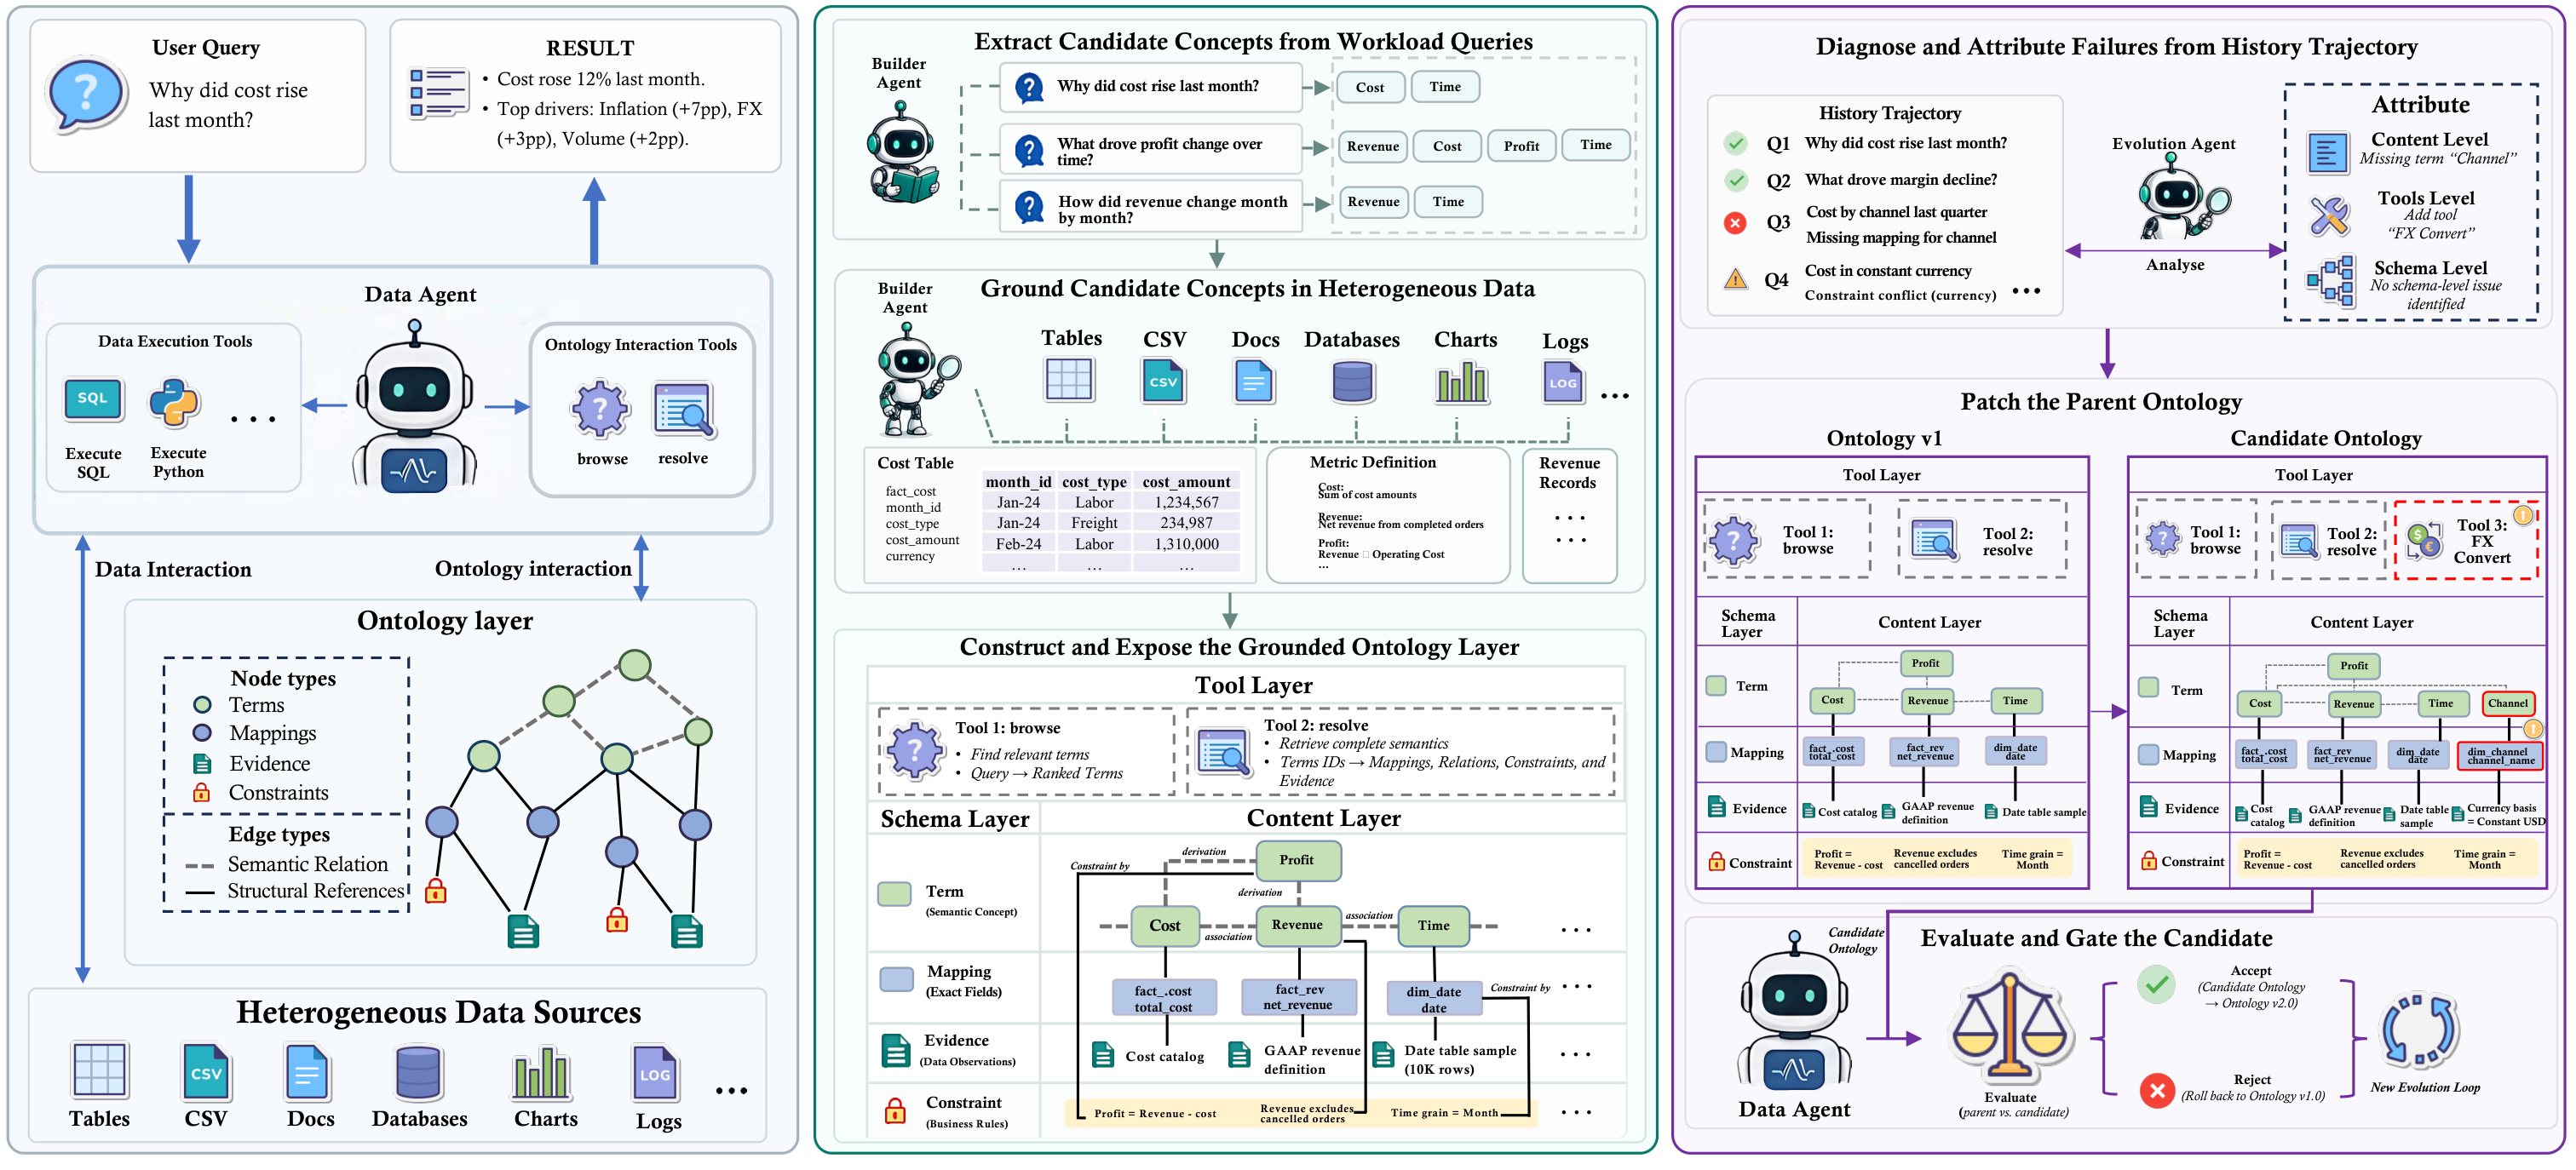
Figure 2. 배포된 에이전트, 초기 온톨로지 구축, 진단·수정·평가 루프를 세 패널로 보여 준다. 논문 v1, 3쪽 Figure 2에서 인용.
3. 빌더 에이전트가 초기 상태를 세운다
데이터 소스마다 도메인 개념·필드 매핑·조인 경로·의미 제약을 사람이 정의하는 것은 비용이 크다. 빌더 에이전트는 학습 워크로드 W와 원본 소스 D에서 초기 온톨로지를 세우되 정답을 보지 않는다. 워크로드가 에이전트에게 무엇이 의미 있는지 알려 주고 실행 가능한 탐침이 그것이 실제 데이터에 접지되는지 확인한다.
빌더는 두 단계로 움직인다. 먼저 워크로드에서 반복되는 엔티티·지표·연산·분석 조건으로 후보 집합 C = propose(W)를 뽑는다. 각 후보 c에 대해 probe(c, D)를 실행해 후보 필드와 조인 경로를 찾고 타입·값·의미 일관성을 살핀다. 그다음 탐침 결과가 뒷받침하는 후보만 커밋한다.
C⁺ = {c ∈ C | verify(probe(c, D)) = 1}, S₀ = construct(C⁺, D; Γ₀)
verify는 선언된 타입·필터·값 분포 요건을 확인하고 통과한 후보는 Γ₀ 아래 인스턴스화되며 뒷받침 레코드가 Evidence로 남는다. 기본 도구 층 R₀과 합쳐 초기 상태 L₀ = (S₀, Γ₀, R₀)가 된다. 모든 항목이 탐침 질의에 걸려 있어야 커밋된다는 것이 이 설계의 요점이고 뒤의 객체군 절제(7절)가 그 결정을 지지한다. 논문 §Method
4. 진화 루프와 채택 게이트
데이터에 접지됐다고 해서 그 온톨로지가 특정 에이전트에 맞는다는 보장은 없다. 그래서 논문은 과거 궤적을 행동 증거로 쓴다. 성공한 실행은 효과적인 의미 구조와 접근 패턴을 드러내고 실패한 실행은 빠졌거나 오해를 부르거나 잘못 노출된 구성요소를 드러낸다.
루프는 네 단계다.
궤적 귀속. 진화 에이전트가 궤적 T_t와 현재 상태 L_t에서 반복 신호 Σ_t = analyze(T_t, L_t)를 뽑는다. 각 신호는 상호작용 패턴, 관련된 온톨로지 객체, 관측된 결과를 요약한다. 에이전트는 신호를 α: Σ_t → {C, T, S}로 콘텐츠·도구·스키마 중 하나에 귀속하고 기대 효과를 진술한다.
국소 개입. 귀속된 신호 σ에 대해 L′_t = patch(L_t, σ, α(σ))를 제안한다. 각 후보는 한 층만 고친다. 콘텐츠 개입은 인스턴스 객체를 더하거나 빼거나 고치고 도구 개입은 관측된 행동에 따라 도구를 고치거나 더하거나 뺀다. 스키마 개입은 객체 모델을 고친다. 같은 가설을 구현하는 여러 콘텐츠 객체는 함께 갱신될 수 있다.
백본별 짝 검증. 백본 m에 대해 ϕ(L, V; m)을 검증 집합 V에서의 점수라 하면, 후보와 부모를 같은 V에서 같은 디코딩·상호작용 예산으로 평가하고 개선이 마진 τ에 이를 때만 채택한다.
L_{t+1} = L′_t (단, ϕ(L′_t, V; m) − ϕ(L_t, V; m) ≥ τ), 아니면 L_t
한 층만 다르므로 귀속된 가설이 분리되고 검증 집합에서의 퇴보가 제한된다. 기각된 후보는 배포되지 않고 그 신호·개입·평가 결과가 기록돼 같은 무용한 갱신이 반복되지 않게 한다. 모든 백본은 같은 L₀에서 독립적으로 진화하며, 그 설계가 채택된 갱신이 백본별 상호작용 패턴을 반영할 수 있게 한다고 논문은 적는다. 논문 §Method
τ의 값은 논문 어디에도 없다. 뒤의 절제(7절)에서 가장 큰 효과를 내는 게이트인데도 문턱값은 제시되지 않는다. 9절과 10절에서 다시 다룬다.
5. 세 벤치마크의 결과
평가 대상은 셋이다. DDR-Bench는 이기종 소스 위의 개방형 데이터 리서치를 평가하며 10-K 시나리오에서 턴별 해석의 Message-Wise와 전체 이력 종합의 Trajectory-Wise를 보고한다. InsightBench는 CSV 데이터셋과 정답 인사이트가 짝지어진 비즈니스 분석 벤치마크로 Insight와 Summary 점수를 쓴다. BIRD는 실제 데이터베이스 위의 텍스트-투-SQL 벤치마크로 공식 Oracle Knowledge 설정에서 Execution Accuracy(EX)를 주 지표, Valid Efficiency Score(VES)를 부 지표로 쓴다.
백본은 여섯이다. GPT-5.5, GPT-5.6-sol, Claude-Sonnet-5, Claude-Opus-4.8, DeepSeek-V4-Flash, Qwen3.5-Flash. 모든 조건이 같은 ReAct 스캐폴드·원시 데이터 도구·디코딩 설정·상호작용 예산을 쓴다. 기준선은 둘이다. Baseline은 온톨로지 없는 ReAct이고, Baseline + SL은 빌더가 만든 시맨틱 레이어를 정적 프롬프트 조각으로 맥락에 앞세운다.
평가 설계는 상호 2-폴드다. 각 벤치마크를 겹치지 않는 폴드 A와 B로 나누고, A→B 실행에서 A의 70%를 온톨로지 구축·궤적 분석·후보 생성에, 나머지 30%를 짝 검증에 쓴 뒤 선택된 온톨로지를 동결하고 B에서 시험한다. 폴드를 바꿔 반복하고 두 방향의 평균을 보고한다. 동결 이후 held-out 폴드의 정답과 평가자 피드백은 온톨로지 구축·진화·후보 선택에 쓰이지 않는다고 명시한다. 논문 §Experiments
DDR-Bench. Trajectory-Wise가 여섯 백본 모두에서 오르고 기준선 대비 평균 +17.8점이다. 폭은 Qwen3.5-Flash의 +4.8부터 GPT-5.5의 +26.7까지다. 여섯 값을 평균하면 17.77이다. 반면 Baseline + SL은 일관되게 개선하지 못하고 Claude-Sonnet-5에서 −15.0으로 떨어진다. 논문은 정적 프롬프트 조각이 다른 지시와 경쟁하고 턴마다 걷어낼 수 없는 반면, MCP 도구는 현재 단계에 필요한 항목만 꺼내 온다고 설명한다. 다만 정적 조각의 실제 투입량이 명시되지 않아 접근 방식만의 효과를 분리한 비교로 읽기는 어렵다.
과거 궤적을 에피소드로 저장해 상위 k개를 프롬프트에 넣는 ReAct + Memory와의 비교도 있다. 네 백본 평균에서 Trajectory-Wise가 69.5에서 75.8로 오르지만 EvoOntology의 89.5에는 13.7점 못 미친다. 이 가운데 69.5와 89.5는 Table 1의 네 백본 값에서 그대로 재현되지만(69.55와 89.5), ReAct + Memory의 75.8은 백본별 값이 논문 어디에도 없어 확인할 수 없다. 격차 13.7과 증분 +6.3·+20.0은 세 집계값끼리 맞아떨어진다. 논문의 설명은 에피소드 기억이 "한 일을 되풀이할 뿐 타입이 있고 조합 가능한 구조를 노출하지 않는다"는 것이다.
BIRD. EX와 VES가 여섯 백본 모두에서 오르고 평균 +7.4와 +8.6이다. Baseline + SL은 갈린다. VES는 전 백본에서 오르지만 EX는 GPT-5.5에서 −5.6까지 떨어진다. 논문은 정적 시맨틱 레이어가 SQL의 형식 적합성은 높이되 올바른 질의를 만드는 데서 주의를 분산시킨다고 읽는다. 논문 Table 4
InsightBench. 이득이 훨씬 작다. Overall 평균 +1.9이고 가장 큰 개선이 DeepSeek-V4-Flash의 +6.1이다. 논문은 Insight가 짧은 참조형 발견으로 채점돼 답이 참조와 맞는 순간 포화한다고 설명한다. 여섯 백본의 Overall 증분을 평균하면 1.93으로 보고값과 맞는다.
InsightBench 표에는 재현할 때 확인할 점이 있다. EvoOntology의 두 행이 Baseline + SL의 두 행과 세 지표 모두 소수점 한 자리까지 같다. GPT-5.5는 양쪽 모두 53.4 (+0.5) / 48.6 (+1.0) / 51.0 (+0.8)이고, Claude-Opus-4.8은 양쪽 모두 55.8 (+0.9) / 50.5 (+0.6) / 53.2 (+0.8)이다. 괄호 안의 기준선 대비 증분도 같다. 공개된 표에서 관찰되는 값이다. 반올림된 독립 결과가 같을 수도 있으므로 표 오류의 증거로 삼을 수는 없다. 논문도 InsightBench에서 정적 레이어가 Insight 이득의 대부분을 회복한다고 설명한다. 논문 Table 3
세 주 결과 표의 맨 위에는 선행 결과도 실린다. Table 1은 "Reported ReAct"라는 블록 라벨 아래 Claude-Sonnet-4.5·DeepSeek-V3.2·GLM-4.6·GPT-5.2·GPT-5-mini·Kimi-K2·GPT-5.1·Gemini-3-Flash 여덟 행을 싣는다. Table 3은 Pandas Agent와 AgentPoirot을 GPT-4o·GPT-3.5-turbo·GPT-4-turbo·Llama-3-70B에서 다섯 행으로, Table 4는 GPT-4 단독 행에 더해 DIN-SQL·DAIL-SQL·TA-SQL·MAC-SQL·MCS-SQL·CHESS까지 일곱 행을 GPT-4와 GPT-4o에서 싣되 별도 블록 라벨은 붙이지 않는다. 어느 쪽도 이 논문 자신의 Baseline 행과 백본이 겹치지 않는다. 그런데 BIRD 문단은 EvoOntology가 "두 기준선과 선행 text-to-SQL 시스템 모두에 대해 백본별로 안정적인 개선을 낸다"며 DIN-SQL·MAC-SQL·CHESS를 괄호에 단다. 백본이 겹치지 않는 값과의 비교를 논문이 한 문장으로 수행하는 셈이다. 논문 Tables 1·3·4
6. 초기 온톨로지와 진화의 몫
빌더가 만든 온톨로지의 기여와 자기진화가 더한 몫을 가르려고 세 조건을 비교한다. Baseline(온톨로지 없음), Initial(진화 전 빌더 산출물), Evolved(자기진화 후 최종본)다.
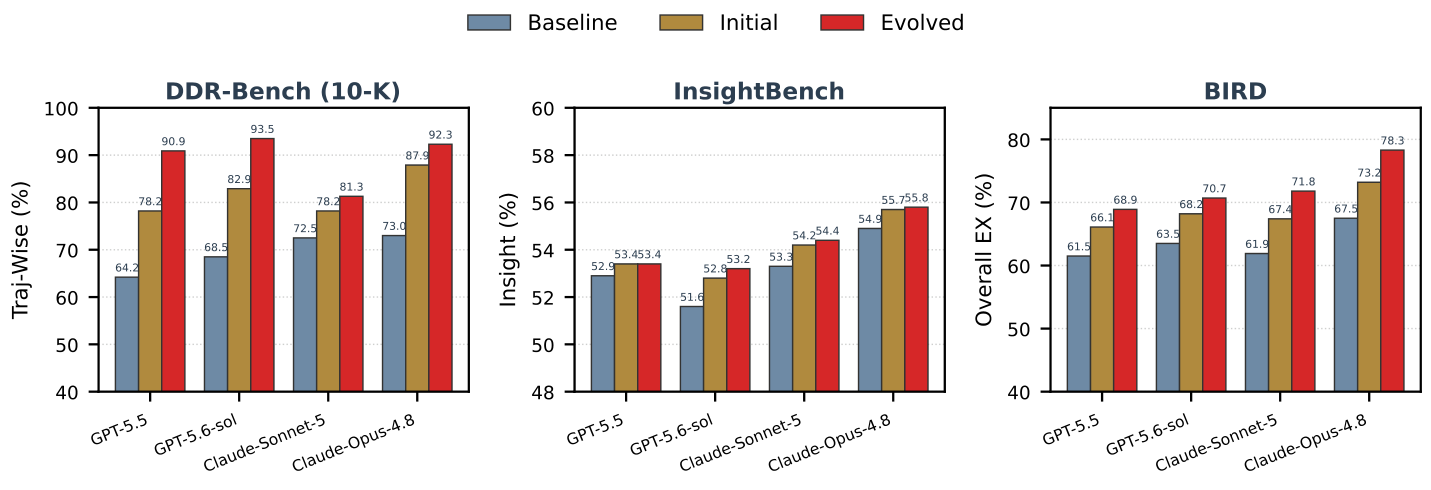
Figure 3. DDR-Bench·InsightBench·BIRD에서 네 백본의 Baseline·Initial·Evolved를 비교한다. 세로축은 모두 0에서 시작하지 않는다. 논문 v1, 6쪽 Figure 3에서 인용.
네 백본 평균으로 보면 이렇다. DDR-Bench는 Baseline에서 Initial로 12.3점, Initial에서 Evolved로 다시 7.7점 오른다. BIRD는 각각 5.1점과 3.7점이다. 네 값 모두 도판의 수치를 평균하면 그대로 나온다.
InsightBench는 다르다. 같은 계산에서 Baseline→Initial이 0.8점, Initial→Evolved가 0.2점이다. 네 백본 Insight 평균이 53.18 → 54.03 → 54.20으로 움직인다. 그런데 논문은 이 문단을 "빌더가 만든 온톨로지가 효과적인 출발점을 제공하는 반면, 자기진화 루프는 완전한 성능 이득을 실현하는 데 필수적이며 초기 상태를 일관되게 개선한다"로 맺고, 같은 문단 첫 문장에서 그 개선이 "세 벤치마크에 걸친다"고 적는다. 세 벤치마크 가운데 하나에서 진화의 몫이 0.2점이고 그 안의 한 백본(GPT-5.5)에서는 표시된 차이가 0.0이다. 반올림 전 값과 반복 실행의 불확실성이 제시되지 않아 작은 차이의 유의성을 판단할 수는 없다. "일관되게 개선한다"는 부호로는 맞지만 폭까지 함께 읽어야 한다. 논문 §Effect of Ontology Layer
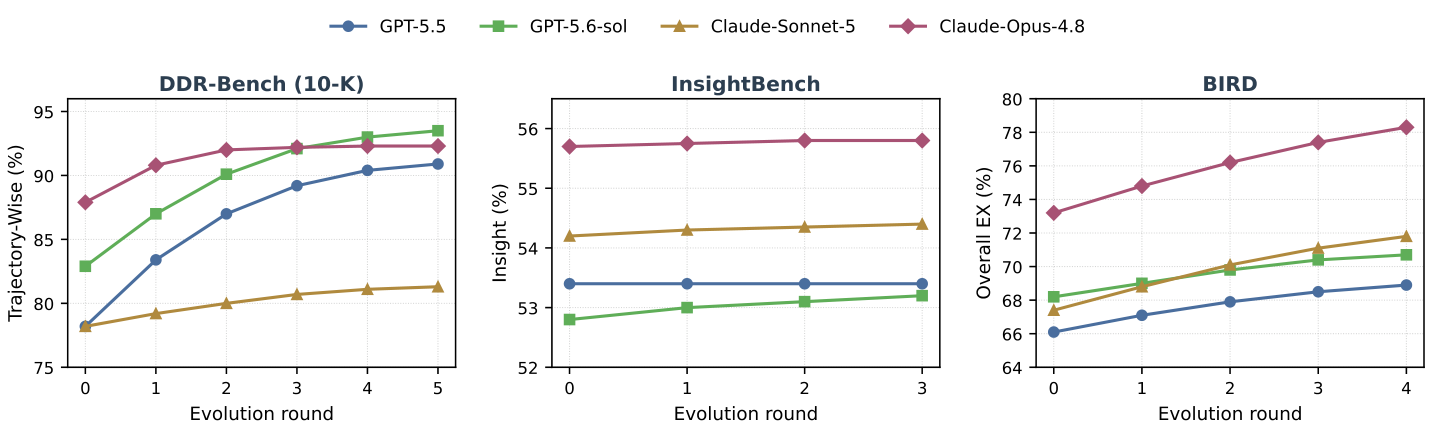
Figure 4. 세 과제에서 채택 라운드별 배포 에이전트 점수를 보여 준다. 이 점수가 채택 게이트의 검증 점수인지는 명시되지 않았다. 논문 v1, 6쪽 Figure 4에서 인용.
Figure 4의 DDR-Bench 곡선은 전반적으로 상승하고 Claude-Opus-4.8은 뒤쪽에서 완만해진다. 도판에서 읽은 중간 점수는 근사치이며, 소수점 한 자리에서 같은 높이로 보이는 구간도 있다. 그림은 배포 에이전트의 주 지표를 표시하지만 식 (2)의 30% 검증 점수라고 명시하지 않는다. 따라서 평평한 구간으로 채택 게이트 위반을 추론할 수 없다. 본문의 부모 곡선 설명과 그림의 관계도 충분히 제시되지 않아 각 채택 라운드의 점수를 재구성하기는 어렵다. 논문 Figure 4·§Effect of Iterative Evolution
7. 무엇이 실제로 일을 하는가
절제는 세 축으로 이루어진다.
진화 루프의 네 단계. 각 단계를 하나씩 끄고 DDR-Bench의 최종 Evolved 점수를 네 백본 평균으로 비교한다. 게이트를 빼면 −11.2로 가장 크게 떨어진다. 걸러지지 않은 후보가, 다음 라운드가 늘 되돌릴 수 있는 것은 아닌 퇴보를 들여오기 때문이라고 적는다. 귀속을 빼면 −6.3인데, 층 태그가 없으면 매니페스트 문제인데 콘텐츠를 고치는 식의 엇갈림이 생긴다고 설명한다. 진단을 빼면 −4.8, 유형이 지정된 패치를 자유 형식 재작성으로 바꾸면 −1.7이다. 논문의 결론은 게이트와 귀속이 지탱하는 두 부분이라는 것이다.
세 편집 층. 한 번에 한 층만 진화시키고 전체와 비교한다. 도구만 진화시킨 경우가 기준선 대비 +13.2로 단독 최대이고, 콘텐츠만은 +8.7, 스키마만은 +3.6이다. 어느 것도 전체 3층의 +20.0에 이르지 못한다.
콘텐츠 객체군. 최종 Evolved 온톨로지에서 제거 가능한 객체군을 하나씩 가린다. Mapping을 가리면 −13.4로 가장 크게 떨어지는데, Term을 실제 열과 조인 경로에 접지하는 유일한 객체라는 역할과 맞는다. Evidence를 가리면 −8.7이다. 탐침 질의가 없으면 후보 SQL 조각을 실제 값 분포에 비추어 확인할 수 없기 때문이다. Constraint와 Relation은 −3.5와 −2.1로 작고 Term은 다른 모든 군이 참조하므로 단독으로 가릴 수 없어 제외된다. 논문 Tables 5–7
절제 결과를 설명하는 표기에도 어긋남이 있다. Table 7의 캡션은 "콘텐츠 층의 다섯 객체군에 대한 절제"라 적는다. 그런데 2절에서 콘텐츠 층은 노드 네 종류와 엣지 두 종류, 곧 여섯 군으로 정의된다. 표에 실린 것은 Mapping·Evidence·Constraint·Relation 넷이고 Term이 제외돼 다섯이 되는데, 나머지 엣지 군인 Structural Reference는 절제에도 캡션의 셈에도 나타나지 않는다. 결과를 바꾸지는 않지만 객체군을 셀 때 확인해야 할 지점이다.
8. 백본마다 다른 온톨로지가 자란다
서로 다른 백본이 비슷한 온톨로지로 수렴하는지 따로 자라는지를 두 방식으로 본다.
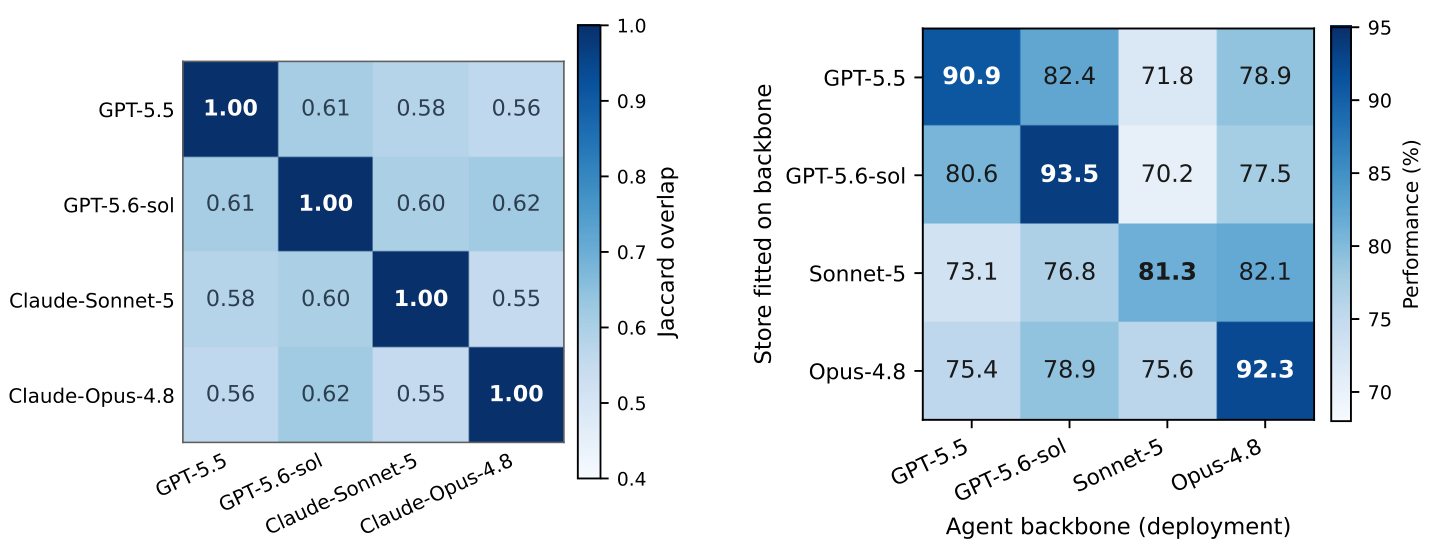
Figure 5. 네 백본의 Term 식별자 중첩과, 학습 백본별 저장소를 배포 백본에 교차 적용한 결과다. 논문 v1, 7쪽 Figure 5에서 인용.
중첩 쪽 서술은 도판과 맞는다. 어느 쌍도 0.62를 넘지 않고 두 Claude 백본이 서로 공유하는 정도(0.55)가 두 GPT 백본(0.61)보다 낮다. 논문은 식별자 중첩만으로는 의미적 동등성을 판정할 수 없다는 단서를 스스로 붙인다.
전이 결과에 관한 세 진술은 각각 따져야 한다.
첫째, "대각이 각 열에서 한결같이 최댓값"은 맞다. 네 열 모두에서 그 열의 백본에 맞춰 적합시킨 저장소가 가장 높다.
둘째, "모든 비대각이 같은 백본 저장소 대비 최소 6.6점 떨어진다"는 성립하지 않는다. 열 기준 하락폭을 모두 계산하면 GPT-5.5 열이 10.3·15.5·17.8, GPT-5.6-sol 열이 11.1·14.6·16.7, Sonnet-5 열이 5.7·9.5·11.1, Opus-4.8 열이 10.2·13.4·14.8이다. 최소값은 5.7이고 Opus-4.8에 맞춘 저장소를 Sonnet-5에 배포한 칸(81.3 대 75.6)에서 나온다. 6.6이라는 하한을 밑돈다.
셋째, "열별 평균 하락폭이 −6.6(Sonnet-5)에서 −10.9(GPT-5.5)까지"도 재현되지 않는다. 열 기준 평균은 Sonnet-5 8.77, Opus-4.8 12.80, GPT-5.6-sol 14.13, GPT-5.5 14.53이다. 행 기준으로 바꿔 계산해도 Sonnet-5 3.97에서 GPT-5.6-sol 17.40까지로 범위가 다르다. 어느 읽기로도 −6.6과 −10.9는 나오지 않는다.
행 방향으로 읽으면 Sonnet-5에 맞춘 저장소는 Sonnet-5에서 81.3, Opus-4.8에서 82.1이다. 배포 백본까지 바뀌므로 이 차이를 저장소 맞춤의 효과로 해석할 수 없다. 맞춤 저장소와 전이 저장소를 비교하려면 논문처럼 배포 백본을 고정한 열 안에서 읽어야 한다. 논문 §Divergence across Backbones
9. 토큰 사용량과 성장
부록은 두 가지를 더 잰다.
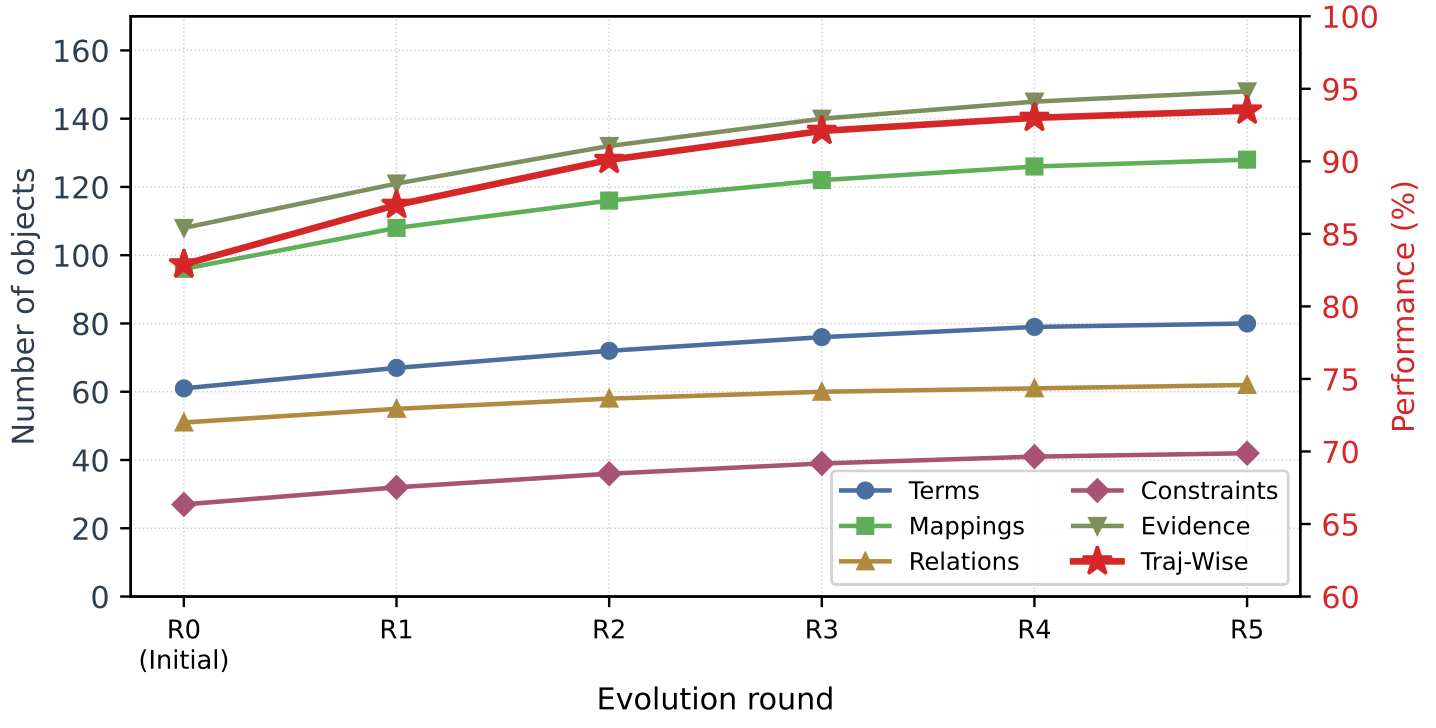
Figure 6. GPT-5.6-sol의 DDR-Bench에서 콘텐츠 객체 수와 점수가 라운드별로 증가한다. 도판에서 읽은 중간값은 근사치다. 논문 v1, 10쪽 Figure 6에서 인용.
논문은 Terms가 초기 61에서 다섯 라운드 뒤 80으로 늘고 3라운드 이후 추적한 요소의 라운드별 증가가 5% 아래라고 설명한다. 첫 값은 그림의 끝점과 일치한다. 중간 객체 수는 표가 아니라 그림에서 읽은 근사치이므로 5% 경계를 정밀하게 검증할 수는 없다. 그림이 뒷받침하는 것은 성장과 성능 향상이 뒤쪽 라운드에서 완만해진다는 경향이다.
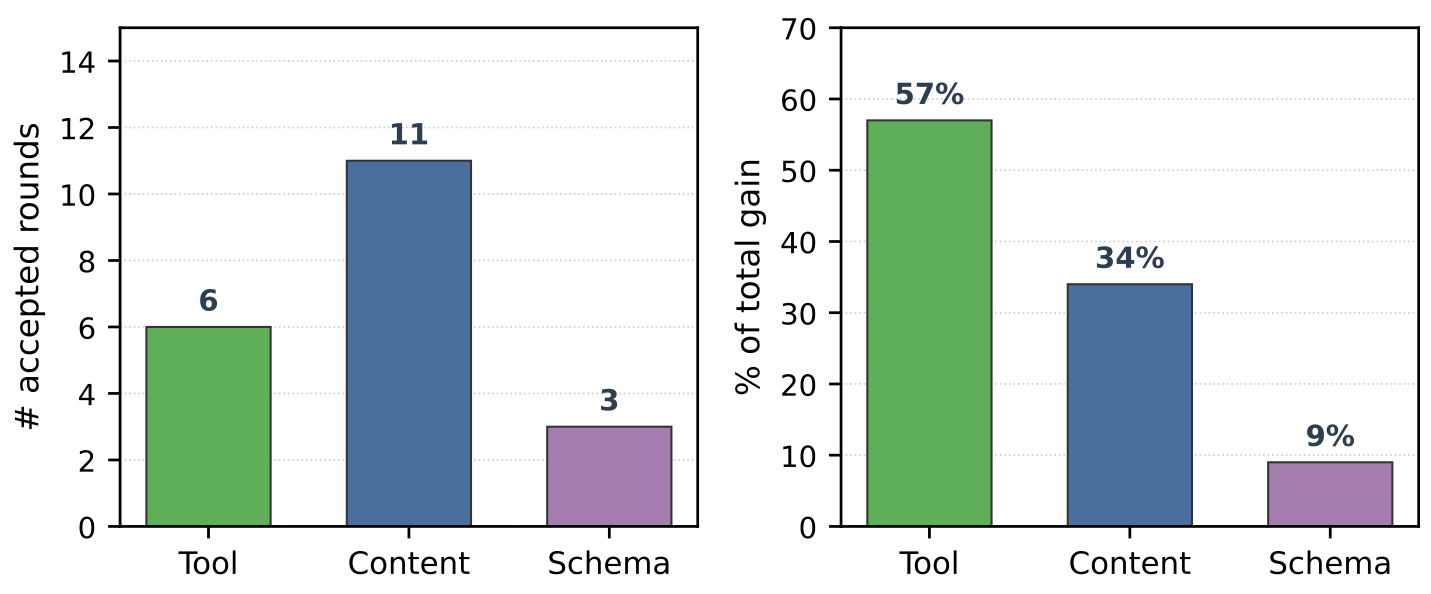
Figure 7. 채택 라운드 수는 Content가 가장 많고 누적 이득 비율은 Tool이 가장 크다. 논문 v1, 10쪽 Figure 7에서 인용.
층별 귀속은 본문과 도판이 맞아떨어진다. 도구 편집이 여섯 라운드에서 누적 이득의 57%, 콘텐츠 편집이 열한 라운드에서 34%, 스키마 편집이 세 라운드에서 9%다. 콘텐츠 편집이 더 잦은데도 도구 편집이 이득의 가장 큰 몫을 낸다. 이 차이는 7절의 도구 단독 진화 결과(+13.2)와 이어진다.
Figure 7의 채택 라운드 수를 합하면 20이다. Figure 4의 축·본문 설명과 이 합계를 어떻게 대응해야 하는지, 특히 부모 곡선이라는 설명이 무엇을 가리키는지는 충분히 문서화돼 있지 않다. Figure 4의 값이 식 (2)의 짝 검증 점수라는 표시가 없고 도판 값은 반올림됐을 수 있으므로, 이 차이를 게이트 위반으로 해석하지 않는다. 논문 Figure 4 · Figure 7
토큰 사용량. 온톨로지 층은 매니페스트를 초기 맥락에 넣고 상세 레코드는 도구로 꺼낸다. DDR-Bench의 네 백본 분석 부분집합 평균에서 턴당 입력 토큰은 Baseline 3.2K에서 Initial 4.1K, Evolved 4.6K로 늘지만, 과제당 턴 수는 14.6에서 11.2를 거쳐 8.4로 줄어든다. 그 결과 과제당 총 토큰은 52.6K → 50.4K → 42.0K로, Baseline 대비 약 20% 낮다. 출력 토큰은 세 조건 모두 턴당 0.4K로 보고된다. 반올림된 (입력+출력)×턴 수는 총 토큰 수와 대체로 일치한다. 같은 비교에서 Trajectory-Wise는 69.5 → 81.8 → 89.5로 오른다. Table 8은 토큰과 턴 수를 보고할 뿐, 온톨로지 구축·진화·도구 운영의 자원이나 가격·지연 시간을 합산하지 않는다. 논문 Table 8
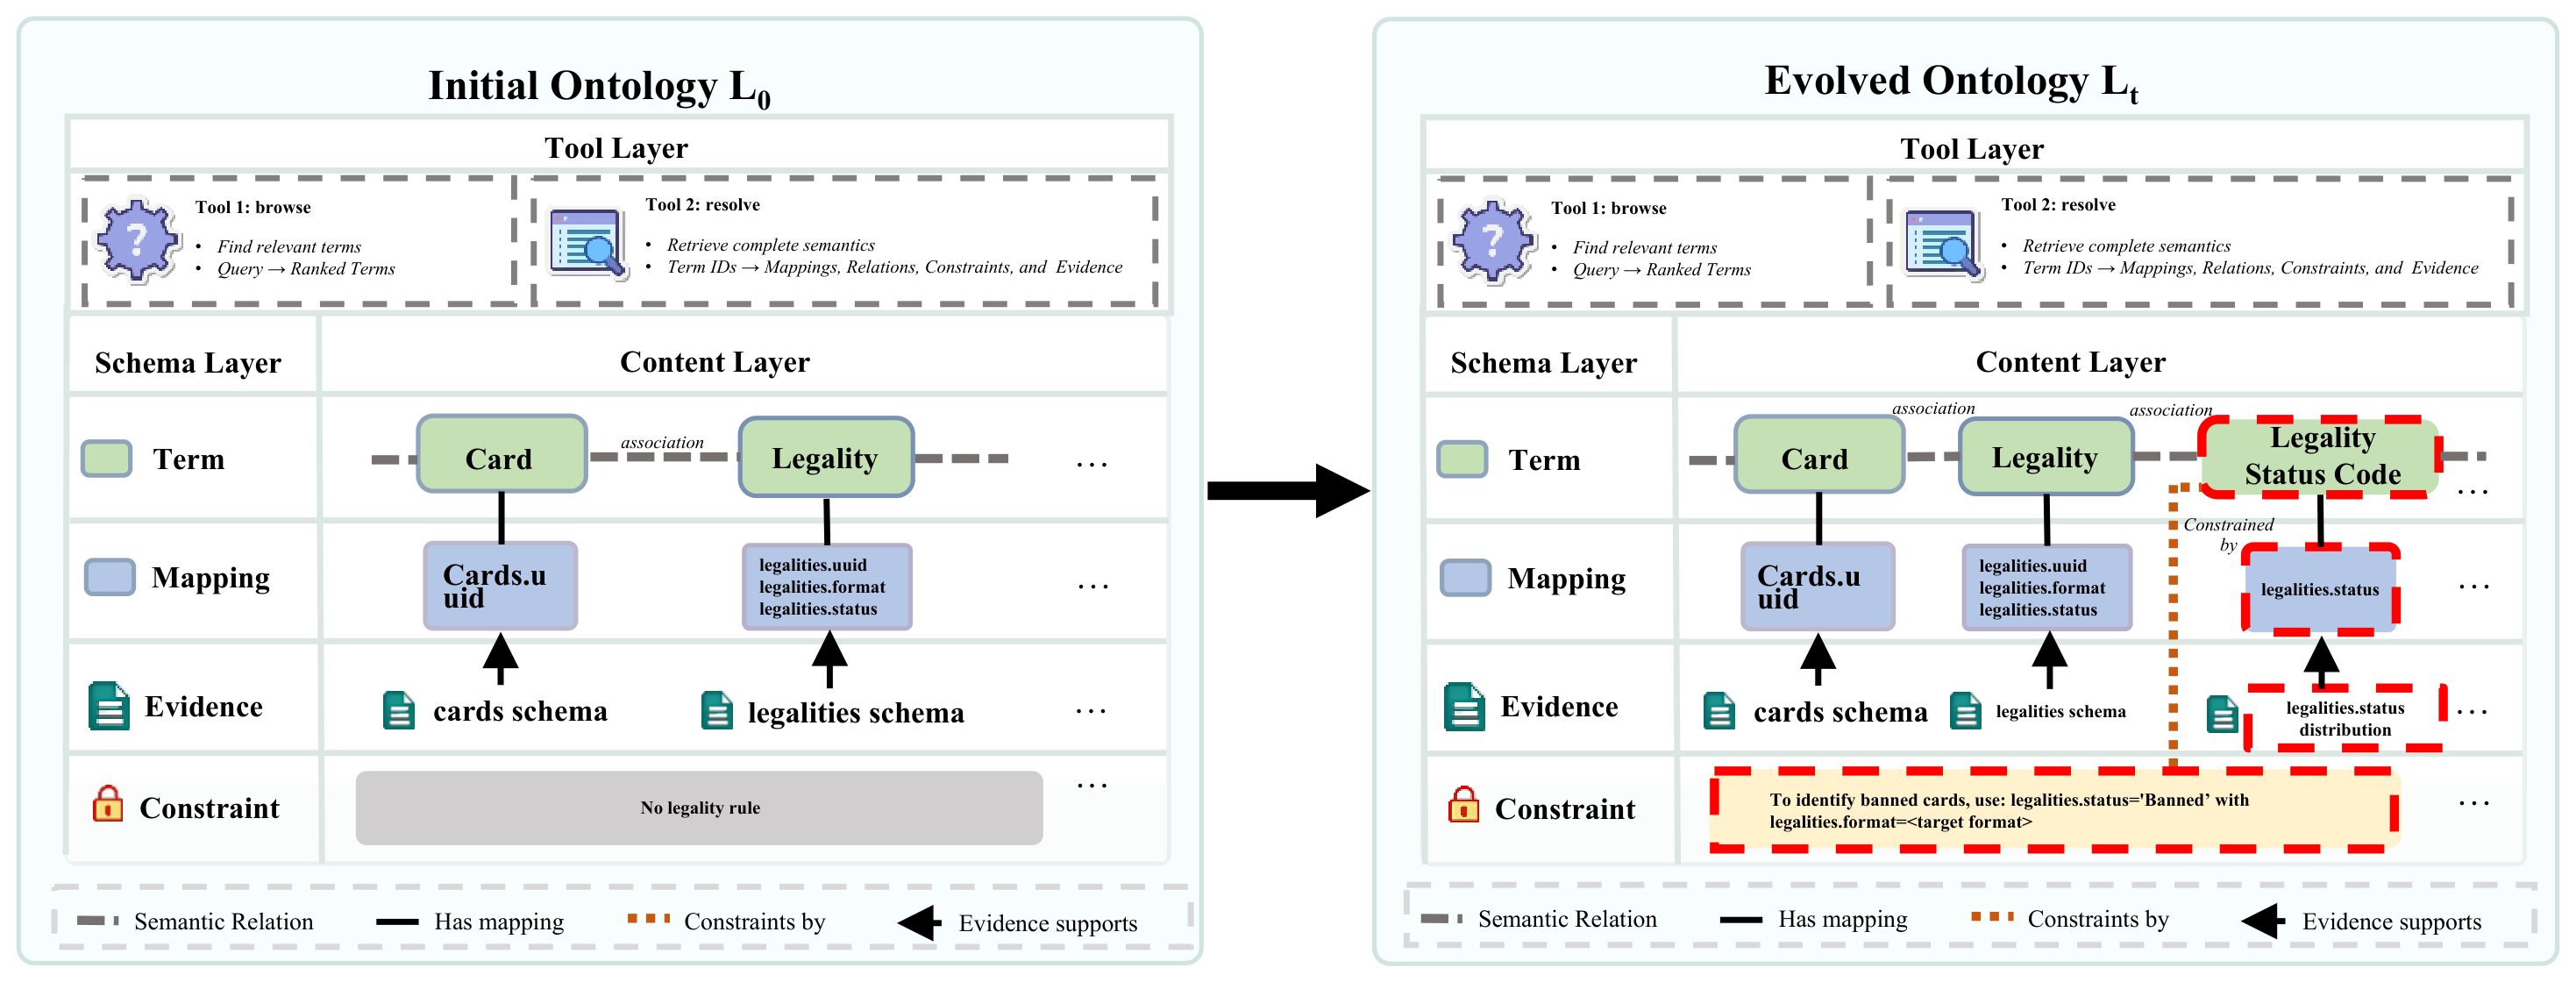
Figure 8. 카드 금지 판정에 필요한 용어·매핑·근거·제약이 콘텐츠 층에 추가되고 도구 층은 그대로다. 논문 v1, 11쪽 Figure 8에서 인용.
사례 연구를 보면 콘텐츠 층 단독 개입이 어떤 모습인지 알 수 있다. 초기 온톨로지는 관련 표를 찾게 해 주지만 legalities.status 값을 어떻게 해석할지, 적법성이 특정 게임 포맷에 상대적이라는 것을 말해 주지 않는다. 진화 에이전트는 이 결함을 콘텐츠 층에 귀속한다. browse와 resolve는 이미 관련 객체를 꺼낼 수 있고 스키마 층도 필요한 지식을 표현할 수 있으므로, 빠진 것은 재사용 가능한 의미 서술이라는 것이다. 후보는 Term 하나와 그 Mapping·Evidence·Constraint를 더할 뿐 도구나 스키마를 건드리지 않는다. 도판에서 두 Tool Layer가 동일한 것이 그 서술과 맞는다.
10. 한계, 재현 조건과 결론
10.1 논문이 스스로 밝힌 한계
논문이 본문과 캡션에 직접 밝힌 한계부터 보자. 다음 절에서는 표·도판과 보고된 재현 조건을 함께 살핀다.
- InsightBench의 이득이 DDR-Bench보다 작은 이유를 스스로 설명한다. Insight가 짧은 참조형 발견으로 채점돼 답이 참조와 맞는 순간 포화한다는 것이다. 논문 §Main Results
- 식별자 중첩만으로는 의미적 동등성을 판정할 수 없으며 서로 다른 식별자가 비슷한 개념을 담을 수 있다고 적는다. 논문 §Divergence across Backbones
- Term은 단독으로 가릴 수 없어 절제에서 제외했다고 Table 7 캡션이 밝히고 다른 모든 객체군이 그것을 참조하기 때문이라는 이유는 본문이 적는다. 논문 Table 7·§Ablation
- 사례 연구에서 필터를 적용하고 반환 레코드를 확인하는 일은 여전히 네이티브 SQL 실행의 몫이라고 적는다. 논문 §Case Study
- 초기 온톨로지가 턴당 입력 토큰을 3.2K에서 4.1K로 늘린다는 것을 표로 밝히고 과제당 총 토큰 감소가 턴 수 감소에서 온다는 것을 함께 적는다. 이 수치는 DDR-Bench 네 백본 분석 부분집합에 한정된다. 논문 Table 8
- 기각된 후보는 배포되지 않으며 그 신호·개입·평가 결과를 기록해 같은 무용한 갱신이 반복되지 않게 한다고 적는다. 논문 §Method
- 별도 언급이 없는 한 Analyses 절의 분석은 DDR-Bench와 네 백본(GPT-5.5·GPT-5.6-sol·Claude-Sonnet-5·Claude-Opus-4.8)에서 이루어진다. 절제·전이·성장·귀속과 Table 8의 토큰 측정값을 세 벤치마크 전체로 일반화할 수 없다. 논문 §Analyses
- InsightBench에서는 정적 시맨틱 레이어가 Insight 이득의 대부분을 회복한다고 스스로 적는다. 곧 이 벤치마크에서 두 방식의 거리가 가깝다는 것을 논문이 먼저 밝힌다. 논문 §Main Results
- 백본들이 같은 초기 상태에서 독립적으로 진화하는 설계가 백본별 패턴의 반영을 "가능하게 한다"고 적어, 반영이 실제로 일어났다는 단정과 구분한다. 논문 §Method
10.2 표·도판과 재현 조건
- 백본 수가 초록과 본문에서 다르다. 초록은 "세 벤치마크와 네 LLM 백본"이라 적고 기여 3도 "네 LLM 백본"이라 적는다. 그런데 실험 설정은 "여섯 LLM 백본에서 평가한다"로 시작하고, 세 주 결과 문단이 모두 "여섯 백본"이라 적으며, 결론도 "여섯 LLM 백본"이라 적는다. Table 1·3·4에 실린 행도 여섯이다. 네 백본은 분석·절제·Table 2에 쓰인 부분집합이고 논문이 그 사실을 §Analyses 첫 문단에서 명시한다(논문 §Analyses). 곧 부분집합의 존재가 문제가 아니라, 논문의 얼굴인 초록과 기여 목록이 주 실험의 규모를 실제보다 작게 적는다는 것이 문제다. InsightBench 문단의 "네 백본 모두에서 개선한다"도 같은 표에서 여섯이 모두 개선하므로 과소 서술이다.
- InsightBench 표의 두 행이 정적 프롬프트 기준선과 같다. GPT-5.5와 Claude-Opus-4.8에서 EvoOntology와 Baseline + SL의 Insight·Summary·Overall이 소수점 한 자리까지, 괄호 안 증분까지 일치한다. 이는 재현 시 확인할 관찰값이며, 반올림된 독립 결과의 일치만으로 표 오류를 단정할 수 없다.
- 교차 백본 전이의 두 수치가 도판에서 재현되지 않는다. "모든 비대각이 최소 6.6점 하락"은 최소 하락폭이 5.7이므로 성립하지 않고, "열별 평균 하락폭 −6.6–−10.9"는 열 기준 8.77–14.53, 행 기준 3.97–17.40으로 어느 쪽과도 맞지 않는다. 같은 문단의 "대각이 각 열의 최댓값"은 정확하므로, 결론 자체가 무너지지는 않고 두 보조 수치가 어긋난다.
- Baseline + SL에 시맨틱 레이어가 얼마나 들어갔는지 밝히지 않는다. 비교군은 빌더의 시맨틱 레이어를 정적 프롬프트 조각으로 앞세운다고만 정의된다. 논문은 동적 도구 방식과 정적 프롬프트 방식에 같은 내용을 제공한다고 설명하지만, 실제 프롬프트 조각의 크기와 선택 기준이 없으므로 접근 방식의 순수한 효과를 분리하기 어렵다. 논문 §Baselines
- 채택 마진 τ의 값이 없다. 게이트는 절제에서 가장 큰 효과(−11.2)를 내는 구성요소이고 논문의 방법론적 주장이 걸린 자리인데, 식 (2)에 기호로만 등장하고 수치가 제시되지 않는다. 검증 집합 크기(폴드의 30%)는 밝히면서 문턱값은 밝히지 않으므로, 이 게이트가 얼마나 보수적인지는 논문만으로 판단할 수 없다.
- 진화의 몫이 벤치마크마다 다르다. 네 백본 부분집합의 Initial→Evolved 증분은 DDR-Bench 7.7점, BIRD 3.7점, InsightBench 0.2점이다. InsightBench의 한 백본에서는 소수점 한 자리 기준 0이다. 논문의 “완전한 성능 이득”이라는 표현은 이 작은 폭을 함께 놓고 읽어야 한다.
- Table 7 캡션의 객체군 수가 본문 정의와 다르다. 캡션은 다섯 군이라 적지만 2절의 콘텐츠 층 정의는 노드 넷과 엣지 둘로 여섯이다. 절제된 것은 넷이고 Term이 제외돼 다섯이 되는데, Structural Reference는 셈에도 절제에도 없다.
- Figure 6의 성장률은 도판에서 정밀하게 검증할 수 없다. 논문은 3라운드 이후 증가가 5% 미만이라고 적지만 중간 객체 수는 표가 아니라 그림에서 읽어야 한다. 근삿값으로 경계 초과를 단정하지 않는다.
- Figure 4와 Figure 7의 관계 설명이 부족하다. Figure 7의 층별 라운드 합은 20이고 Figure 4는 라운드별 배포 점수를 그린다. 도판과 본문은 부모 곡선 및 검증 점수와의 대응을 충분히 설명하지 않는다. 표시된 값의 반올림과 평가 분할의 차이도 가능하므로 채택 게이트 위반을 주장할 근거는 없다.
- "Reported" 블록은 이 논문의 기준선과 백본이 겹치지 않는다. Table 1의 위쪽 여덟 행, Table 3의 위쪽 다섯 행, Table 4의 위쪽 일곱 행은 모두 다른 모델에서 나온 값이다. 표 하나에 나란히 놓이지만 이 논문의 Baseline 행과 백본이 겹치지 않는다. Table 1과 Table 3에 대해서는 논문도 비교하지 않지만, BIRD 문단은 "선행 text-to-SQL 시스템"보다 낫다고 적어 그 비교를 수행한다. 그 선행 값들은 GPT-4·GPT-4o에서 나온 것이고 이 논문의 백본은 그보다 뒤 세대이므로, 이 한 문장은 표가 뒷받침하는 것보다 넓다.
- 세 도판 모두 세로축이 잘려 있다. Figure 3의 InsightBench 패널은 차이가 1점 미만인데 축이 48–60이다. 막대 높이의 시각적 차이가 실제 점수 차이보다 크게 보인다. 본문이 폭을 숫자로 적으므로 서술은 정확하지만 도판만 보면 인상이 달라진다.
10.3 공개된 것과 확인하지 못한 것
논문 첫 쪽에 코드 저장소가 명시돼 있다. 이 판본에는 체크포인트나 진화된 온톨로지 저장소 자체의 공개에 대한 언급은 없다.
이 검토에서 확인하지 못한 것은 다음과 같다. 채택 마진 τ의 값, 각 벤치마크의 폴드 크기와 실제 문항 수, DDR-Bench 10-K 시나리오의 구성, 백본별 디코딩 설정과 상호작용 예산의 구체값, 여섯 백본 각각의 채택 라운드 수, browse의 k·n 기본값, 진화 루프를 몇 라운드까지 돌렸는지의 중단 규칙, 그리고 "Reported" 블록 수치들의 원 출처 대조다. 이 검토는 모델을 돌리거나 벤치마크를 재현하지 않았고 표와 도판에 실린 값을 원문에서 복원해 서술과 대조하는 데 그친다.
10.4 적용을 검토할 때 확인할 것
- 이득의 폭이 과제 성격에 크게 의존한다. 개방형 데이터 리서치(DDR-Bench)에서 +17.8이고 텍스트-투-SQL(BIRD)에서 +7.4인 반면, 짧은 참조형 채점(InsightBench)에서는 +1.9다. 도입을 검토한다면 자기 과제가 어느 쪽에 가까운지를 먼저 봐야 한다.
- 정적 프롬프트 기준선과 결과가 다르다. Baseline + SL은 일관되게 개선하지 않고 어떤 백본에서는 크게 떨어진다. 논문은 필요한 의미만 꺼내 쓰는 방식으로 차이를 설명한다. 그러나 정적 조각의 투입량이 없어 이 비교만으로 동적 접근 방식의 독립 효과를 확정할 수 없다.
- DDR 네 백본에서는 과제당 총 토큰이 줄었다. 턴당 맥락은 늘지만 궤적이 짧아져 Baseline 대비 약 20% 감소했다. 가격·지연 시간·온톨로지 구축과 진화의 자원은 별도로 측정해야 한다.
- 백본 변경 시 기존 저장소의 성능을 다시 평가할 필요가 있다. 교차 배포 행렬에서는 각 배포 열의 최고점이 해당 백본에 맞춘 저장소다. 다만 다른 저장소도 일정 성능을 내므로 매번 다시 진화해야 한다는 보편 규칙은 아니다.
- 게이트를 설계에 포함할 근거가 있다. DDR 네 백본 절제에서 게이트를 뺀 경우가 −11.2로 가장 크게 떨어진다. 논문의 마진값은 공개되지 않았으므로 실제 설정은 별도 검증이 필요하다.
10.5 결론
이 논문의 값어치는 중간 층을 프롬프트에 넣는 자료에서 에이전트가 질의하는 서비스로 옮기고, 그 층을 실행 기록으로 고치는 루프를 붙인 데 있다. 설계에서는 세 가지가 눈에 띈다. 프롬프트에 놓이는 것을 매니페스트 하나로 제한하고 나머지는 요청 시 꺼내게 한 것, 편집을 콘텐츠·도구·스키마 중 한 층으로 강제해 가설과 결과를 대응시킨 것, 그리고 부모 대 후보를 같은 검증 집합에서 견주는 게이트를 둔 것이다. 절제가 이 셋을 각각 지지한다. 게이트가 가장 크게 지탱하고, 층을 나눈 편집이 단독 층보다 낫고, 탐침에 접지된 Mapping과 Evidence가 콘텐츠의 무게를 진다.
토큰 사용량 결과도 유용하다. DDR-Bench 네 백본 부분집합에서 턴당 입력은 늘지만 턴 수가 줄어 과제당 총 토큰은 약 20% 감소하고 Trajectory-Wise는 69.5에서 89.5로 오른다. 구축·진화·운영 자원을 포함한 전체 비용이나 지연 시간에 관한 결론은 이 표에서 낼 수 없다.
재현에는 설명이 더 필요하다. 초록과 기여 목록의 백본 수가 주 실험 표와 다르고, InsightBench의 두 행은 정적 프롬프트 기준선과 소수점 한 자리까지 같으며, 교차 백본 전이의 두 보조 수치는 도판에서 재현되지 않는다. 행의 일치는 오류를 뜻하지 않는다. DDR-Bench와 BIRD의 이득, DDR 네 백본 절제의 방향, 토큰 사용량 감소는 원문 표와 도판에서 확인된다. 핵심 게이트의 마진값 τ와 정적 프롬프트 기준선의 투입량이 제시되면 방법을 더 정확히 재현하고 효과를 분리해 해석할 수 있다.
References
Chong, M., Zhang, S., Fan, J., & Du, X. (2026). EvoOntology: A self-evolving ontology layer for data agents (arXiv:2609.15779v1). arXiv. https://arxiv.org/abs/2609.15779