The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement
AI가 AI를 고친다는 말, 어디까지가 재귀적 자기개선일까 — 쉽게 읽는 RSI 로드맵
이 서베이는 AI가 AI 개발에 쓰인다는 사실보다, 다음 개선 결정을 누가 맡고 무엇이 다음 세대로 남는지를 묻는다. 기준점 B0와 L1–L5의 다섯 수준은 성능 순위가 아니라 개선 권한의 지도이며, 진짜 재귀적 향상은 아직 검증 과제로 남아 있다.
Paper: Yi Duan; Ying Liu; Zirui Tang; Haodong Chen; Jun Zhou; 외 28인 (2026). "The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement" (arXiv:2609.11873v1). arXiv · PDF · 프로젝트 페이지
“AI가 자기 자신을 개선한다”는 말은 멋있지만 너무 넓다. 답안을 스스로 고쳐 쓰는 챗봇, 오류 로그를 읽고 프롬프트를 고치는 에이전트, 새 데이터를 만들어 모델을 재학습하는 시스템을 모두 같은 말로 부르면 중요한 차이가 사라진다. 이 논문은 그 차이를 개선 루프라는 관점으로 정리한다.
분류 기준은 AI의 성능이 아니라 개선 권한의 위치다. 다음 개선을 결정하는 권한이 사람에게 남아 있는가, 아니면 AI에게 넘어갔는가? 바뀐 것이 다음 개선에도 실제로 쓰이는가? 이 두 질문으로 보면, 같은 시스템도 어떤 기능을 보느냐에 따라 다른 단계에 놓일 수 있다. 이 글은 다섯 수준을 성능 등급이 아니라, 개선 책임이 이동하는 지도로 읽는다.
개선 루프를 먼저 그려 보자
어떤 AI 시스템이 코드 문제를 푼다고 해 보자. 시스템이 실패 사례를 모으고 원인을 찾아 프롬프트를 바꾸고 테스트를 통과하면 새 프롬프트를 저장해 다음 문제에서 다시 쓴다. 여기에는 적어도 대상 시스템, 실패 경험, 개선을 제안하는 주체, 검증자, 보존된 변경, 그리고 그 변경을 물려받는 다음 회차가 있다.
논문은 이 묶음을 개선 루프라고 부른다. 그래서 “모델이 새 답을 냈다”만으로는 자기개선이라고 부르지 않는다. 새 답이 다음 회차의 행동을 바꾸는지, 그 변경을 누가 제안하고 채택하는지, 검증 기준은 누가 고정하는지를 함께 본다. 이 관점의 장점은 화려한 이름보다 시스템의 실제 책임 구조를 묻는다는 데 있다. 논문 §1.7, §2.2
가령 사람이 목표·평가 기준·수정 절차를 전부 정하고 AI가 그 절차를 실행한다면, 자동화는 많이 되어도 AI가 다음 개선의 방향을 고른 것은 아니다. 반대로 AI가 다음에 어떤 실험을 할지 정하더라도, 사람이 목표와 통과 기준을 고정할 수 있다. 이 둘은 같은 “자율”이 아니다.
B0부터 L5까지: 성능표가 아니라 권한표
논문은 과제 안에서만 반복하는 B0을 기준점으로 두고, 그 뒤를 다섯 수준으로 나눈다. 각 수준은 이전 수준보다 모델이 더 똑똑하다는 뜻이 아니라, 개선 루프의 한 결정이 추가로 AI에게 넘어갔다는 뜻이다. 논문 §3, Figure 1–2
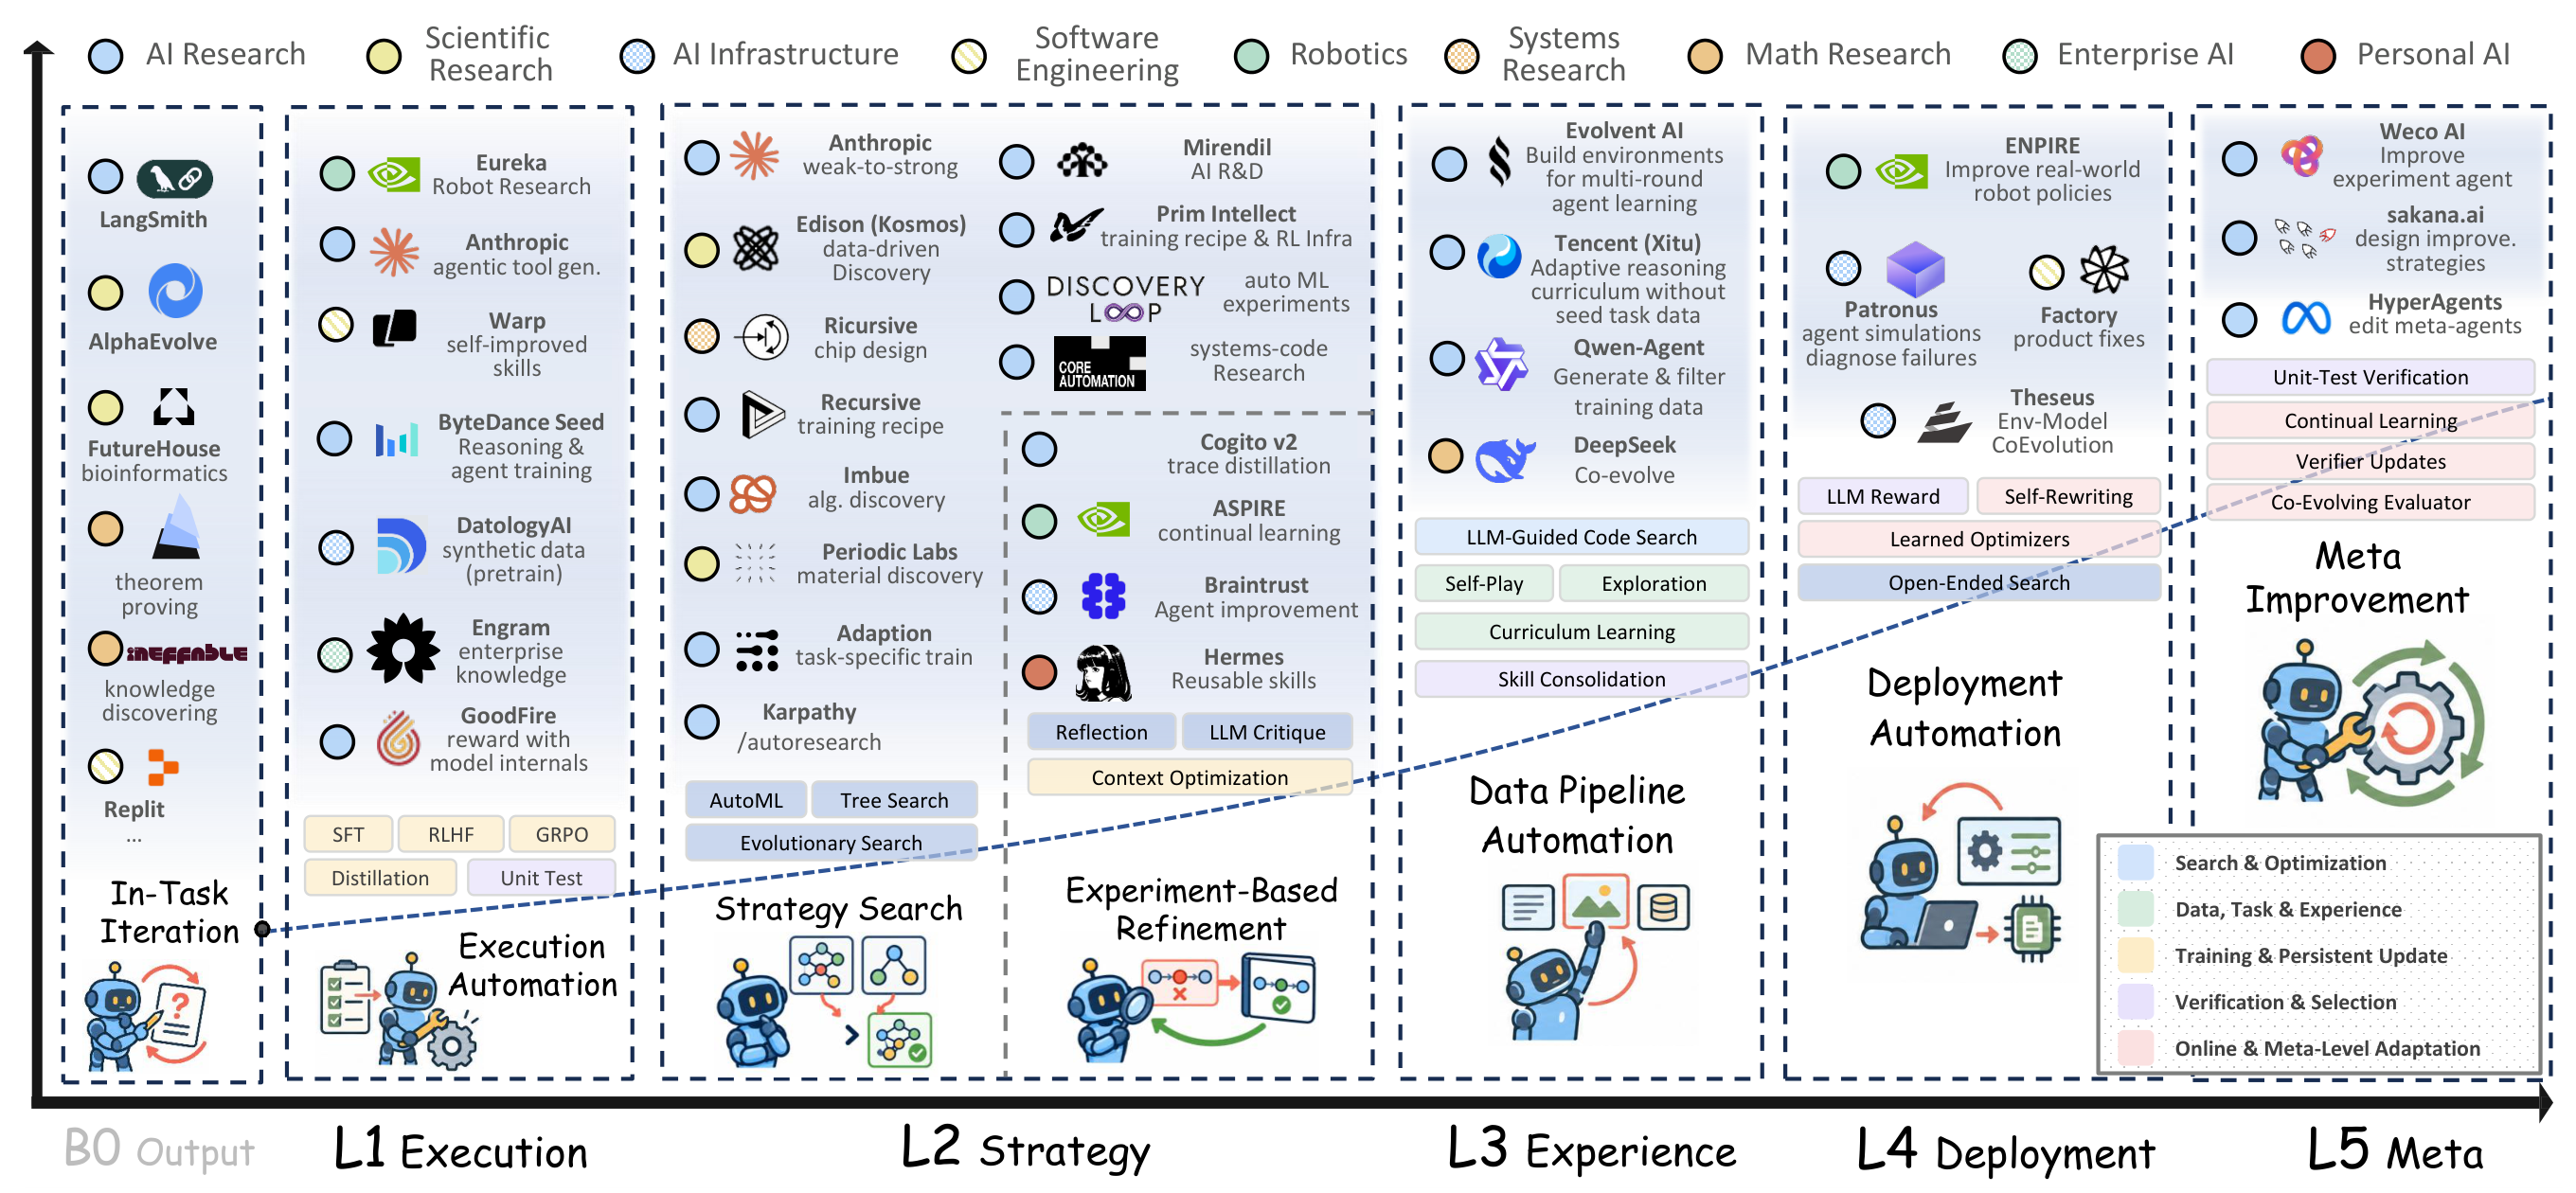
오른쪽으로 갈수록 다음 개선을 결정하는 권한을 AI가 더 많이 맡는다. 시스템·기업의 위치는 저자들의 분류이며, 오른쪽에 있다는 이유만으로 성능이 더 높거나 재귀적 향상이 입증됐다는 뜻은 아니다. 원논문 Figure 1, p. 1을 그대로 인용했다(arXiv:2609.11873v1).
| 수준 | AI가 맡는 일 | 아직 외부에 남는 것 |
|---|---|---|
| B0 | 현재 과제의 답을 반복 수정 | 변경은 다음 과제에 남지 않음 |
| L1 | 사람이 정한 개선 절차를 실행하고 결과를 보존 | 목표·절차·수용 기준 |
| L2 | 평가를 보고 다음 개선 전략을 선택 | 목표와 평가 규칙 |
| L3 | 다음에 어떤 경험·데이터를 얻을지 결정 | 안전 경계와 큰 학습 틀 |
| L4 | 배포·환경 피드백으로 지속 적응 | 접근 권한·출시·최종 책임 |
| L5 | 후속 개선을 만드는 기구 자체를 바꾸고 계승 | 임무·보호 평가·자원 권한 |
B0을 따로 두는 이유가 중요하다. 한 세션 안에서 답을 여러 번 비판하고 고쳐도, 그 과정이 다음 과제의 시스템을 바꾸지 않으면 논문 기준에서는 RSI가 아니다. 반대로 L1은 바뀐 지식·스킬·설정이 다음 과제에도 남는다. L2는 “무엇을 바꿀지”까지 시스템이 고른다. L3는 시스템의 현재 상태를 보고 다음 학습 경험을 골라온다.
L4부터는 실제 환경에서 생기는 피드백을 이어 간다. 하지만 고객·환자·로봇 환경에서의 결과는 되돌리기 어렵고, 좋은 점수 하나가 안전한 적응을 뜻하지 않는다. 그래서 논문은 배포 권한, 보호된 평가, 최종 수용을 외부 제약으로 계속 남겨 둔다. 논문 §3.5–3.6
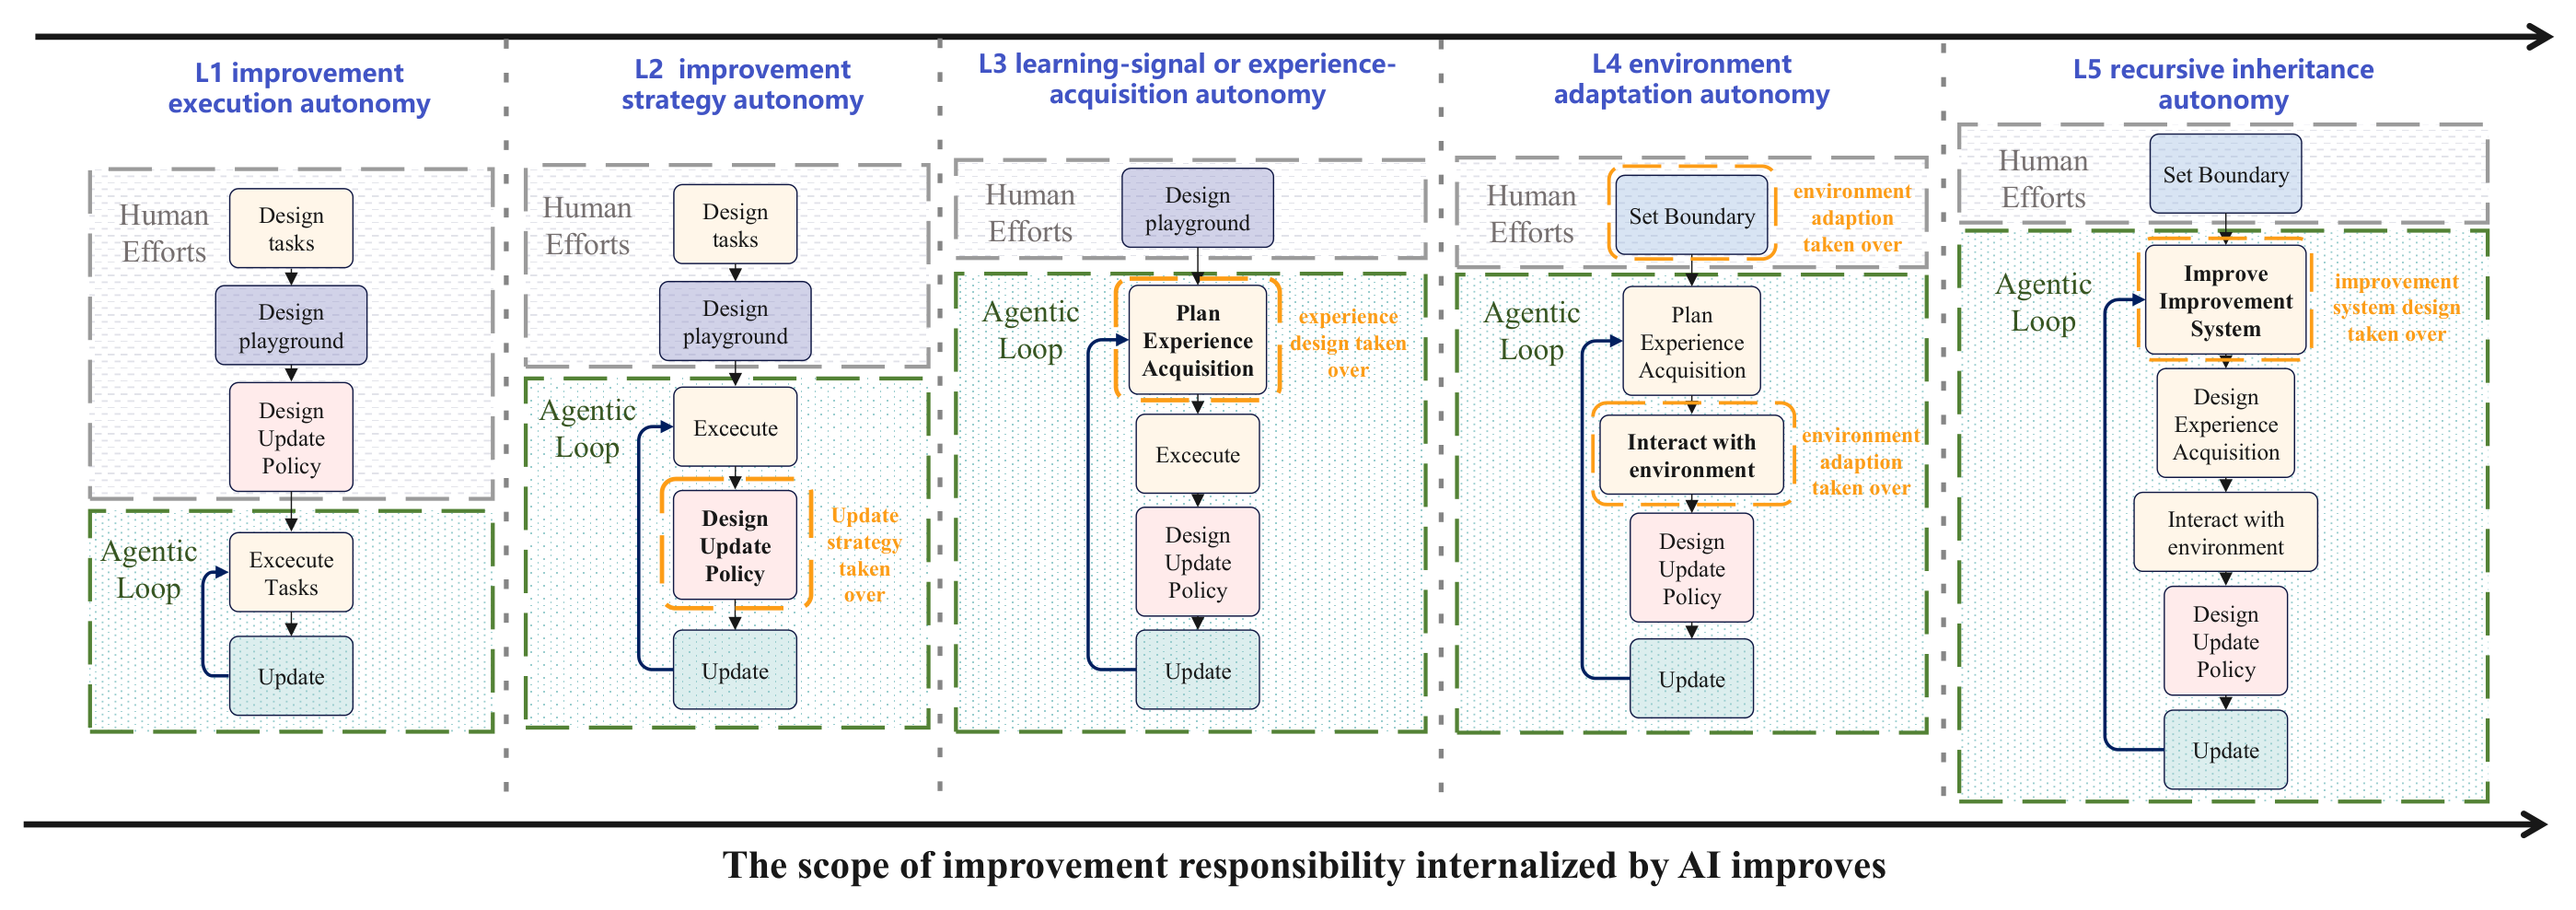
회색 사람 영역과 초록색 에이전트 루프 사이에서 어떤 결정이 이동하는지 따라가면 각 수준의 차이가 보인다. 높은 수준에서도 임무·안전 경계·최종 수용 권한이 모두 AI로 넘어가는 것은 아니다. 원논문 Figure 2, p. 5을 그대로 인용했다(arXiv:2609.11873v1).
L5는 “스스로 고친다”보다 더 엄격하다
AI가 도구나 답을 고치는 경우만으로는 가장 높은 L5에 이르지 못한다. 다음 개선을 만들어 내는 절차 자체를 바꾸고, 그 바뀐 절차가 다음 회차의 후보 생성·평가·선택을 실제로 이끌어야 한다. 예를 들어 실패를 분류하는 평가기, 다음 실험을 정하는 연구 정책, 후속 에이전트를 만드는 방식이 바뀌고 그 변경이 다음 세대에 남아 쓰이는 경우다.
논문은 여기서 두 증거를 분리한다. 구조적 재귀는 바뀐 개선 기구가 다음 회차에 보존·재사용됐다는 증거다. 실효적 재귀는 그 기구가 비슷한 예산 아래 독립 평가에서 더 나은 후속 개선을 만들었다는 증거다. 첫 번째는 “루프가 닫혔다”를, 두 번째는 “그 루프가 실제로 더 나아졌다”를 뜻한다. 구조적 재귀만으로 성능 향상까지 결론 내릴 수 없다는 구분이 이 논문의 가장 유용한 안전장치다. 논문 §3.6, Table 8
L5에서도 인간의 역할은 남는다. 논문은 임무, 안전 경계, 보호된 평가, 최종 수용 권한이 남아야 한다고 반복해서 쓴다. L5는 개선 기구의 일부가 다음 개선까지 이어지는지를 검사하는 분류다. 시스템이 모든 것을 결정한다는 선언은 아니다.
논문이 보여 주는 현재 위치
저자들은 2023년부터 2026년 9월까지의 model–benchmark 관측 393건을 10개 능력 영역에서 HCI(Headroom-Closed Index)로 정규화했다. HCI는 각 벤치마크가 데이터셋에 처음 들어온 해의 상위권 점수를 0, 완벽한 점수를 100으로 두고 “남은 여지를 얼마나 닫았는가”를 나타낸다. 원점이 벤치마크마다 다르므로 다른 영역의 HCI를 정밀한 절대 능력 비교로 읽어서는 안 된다. 논문 §2.1, Figure 3
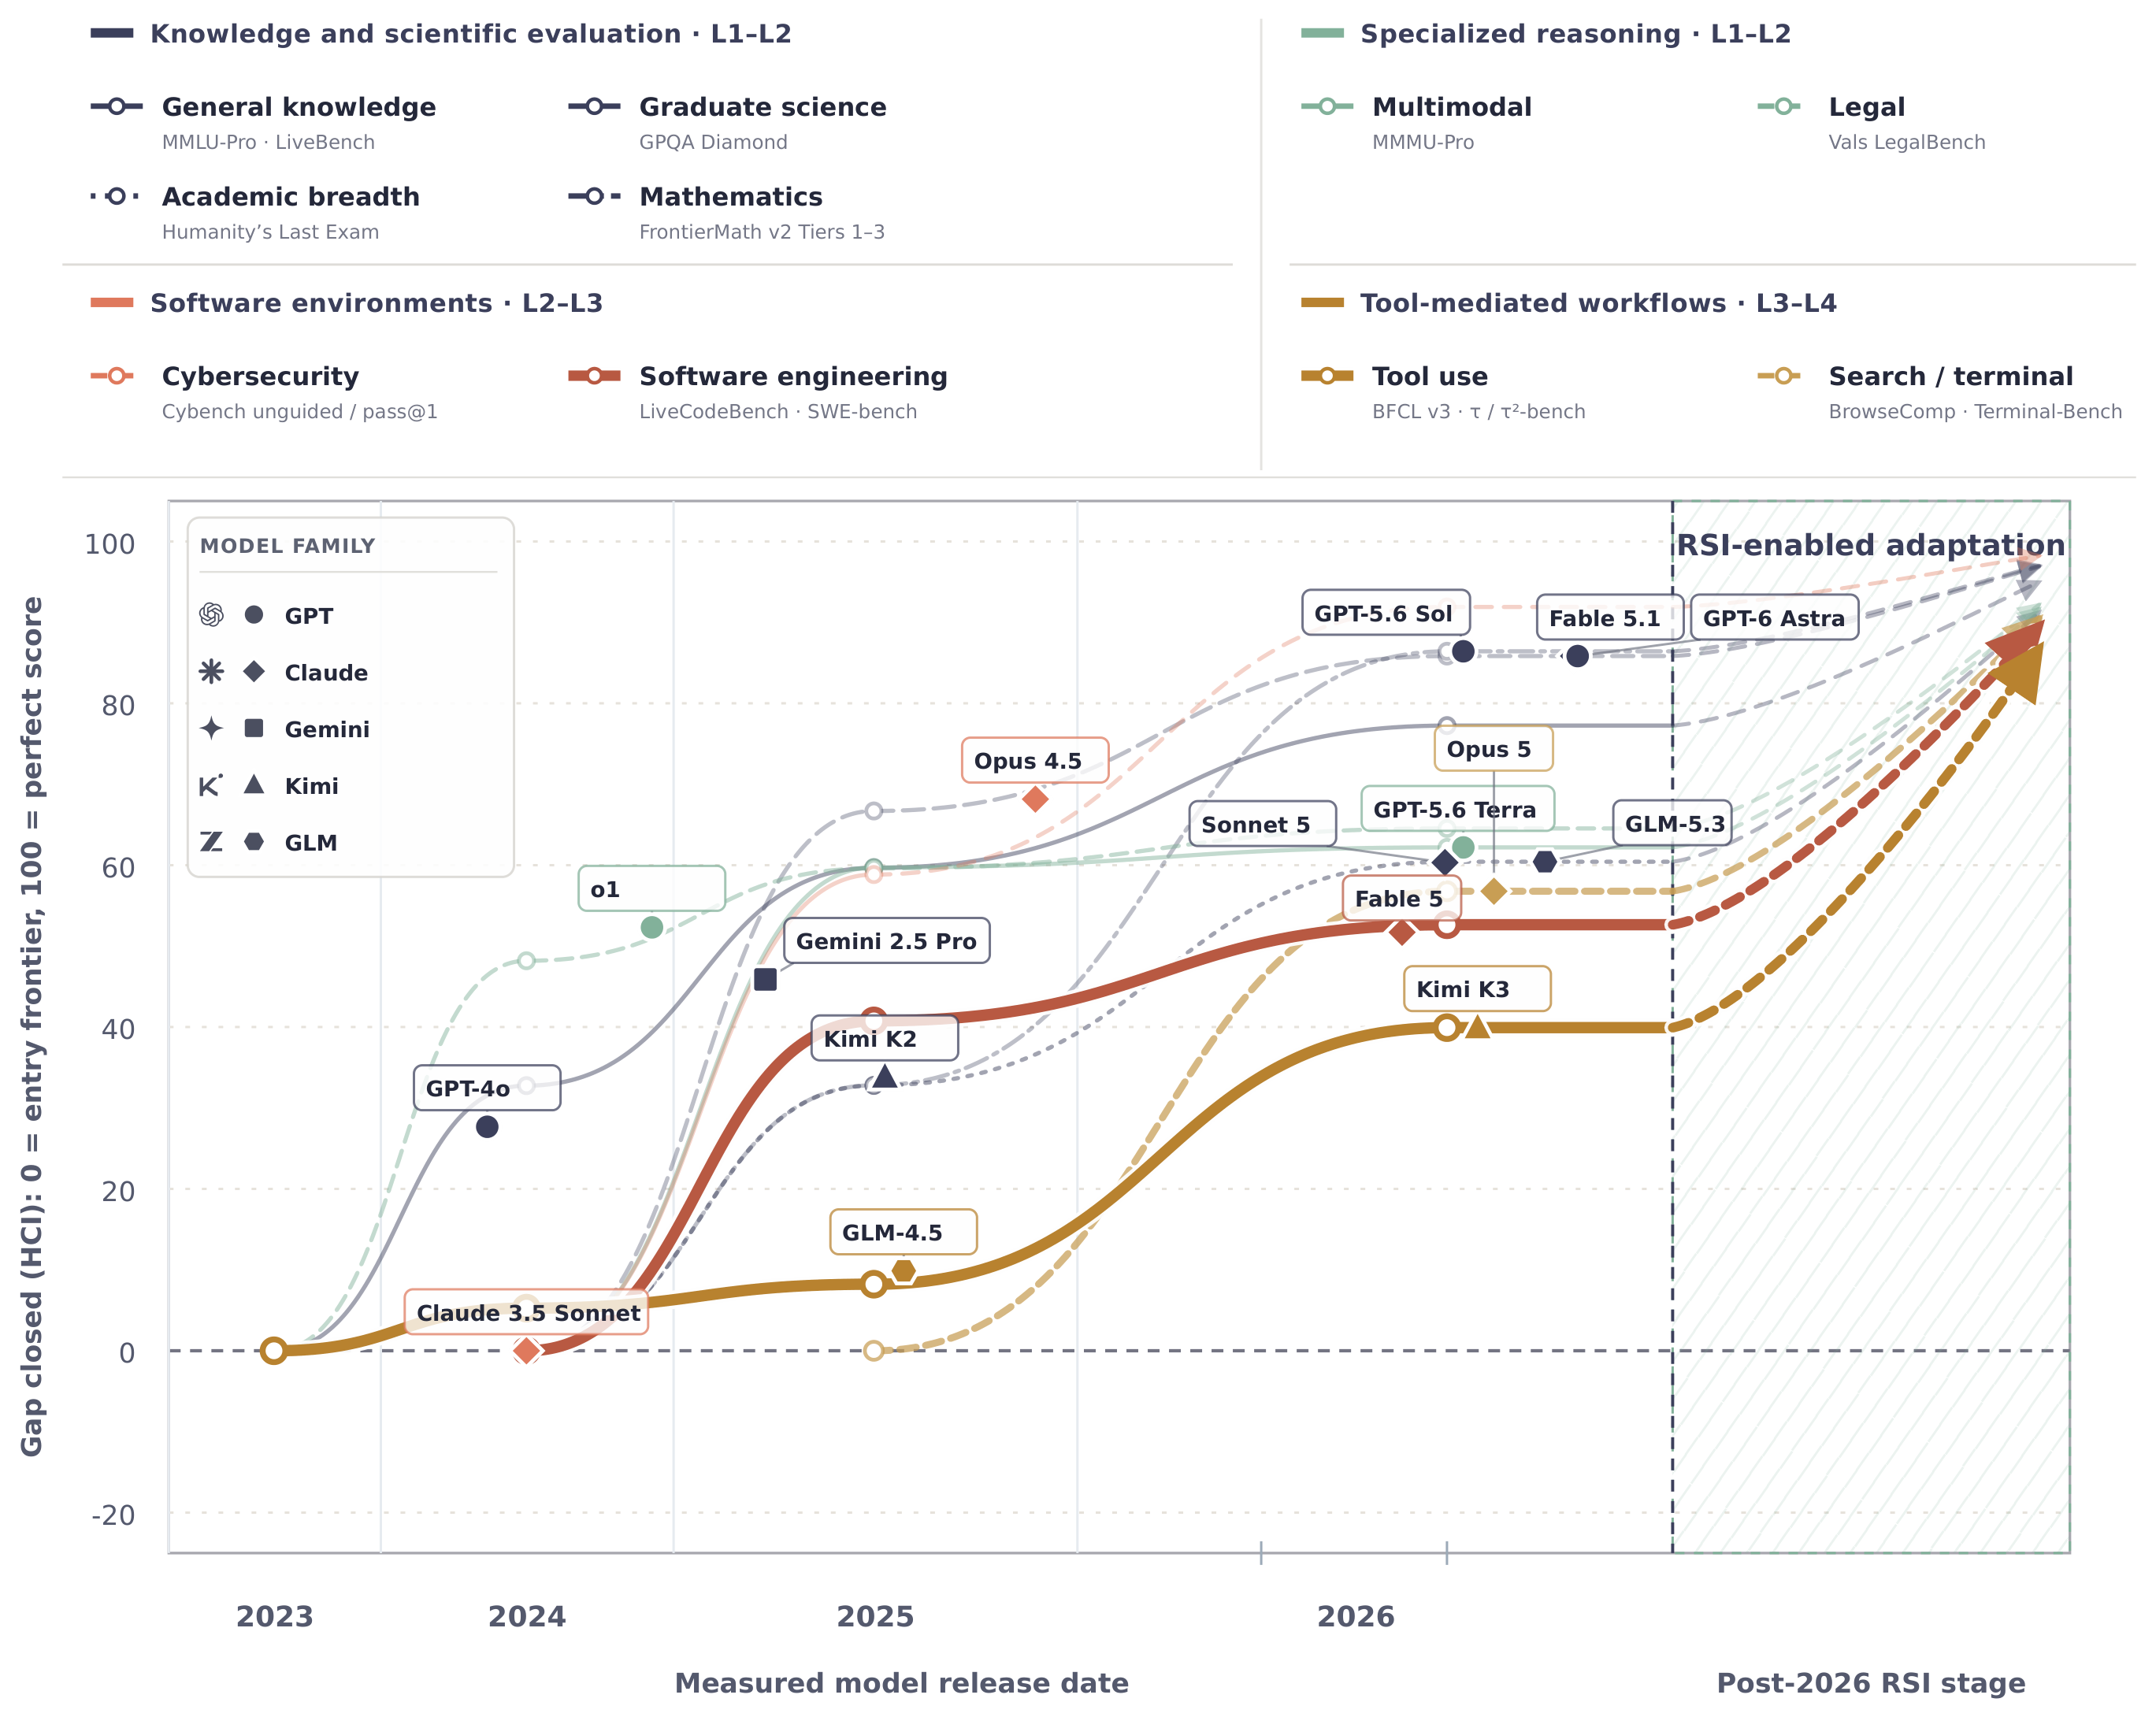
빗금 영역 왼쪽은 관측한 HCI 궤적이다. 벤치마크마다 기준점이 달라 선의 높이를 절대 능력처럼 비교해서는 안 되며, 오른쪽 연장선은 측정이나 예측이 아닌 저자들의 예시다. 원논문 Figure 3, p. 8을 그대로 인용했다(arXiv:2609.11873v1).
저자 보고 기준으로 2026년 고급 수학과 대학원 과학은 각각 86.4, 85.8이지만, 소프트웨어 공학은 52.6, 검색·터미널 에이전트는 56.8, 도구 사용은 39.9였다. 이 숫자가 곧 RSI의 성능을 뜻하는 것은 아니다. 논문이 말하고 싶은 것은 상호작용·도구·환경 피드백이 필요한 일에는 아직 검증하기 어려운 빈틈이 많고, 그래서 지속적인 개선 루프가 특히 중요해질 수 있다는 점이다.
그림의 2026년 이후 연장선도 주의해서 봐야 한다. 저자들은 그것을 RSI의 도움을 받는 예시적 확장이라고 명시한다. 측정된 성장률이나 미래 예측이 아니다. 숫자로 된 선이 있다고 해서 로드맵이 이미 현실에서 입증됐다고 읽으면 안 된다. Figure 3 caption
실제 적용에서는 무엇을 확인해야 하나
논문은 과학, 체화 지능, 소프트웨어 공학, 의료를 따로 다룬다. 네 분야는 같은 수준표를 쓰더라도 검증 비용이 다르다. 소프트웨어는 테스트와 샌드박스로 빠르게 후보를 걸러볼 수 있지만, 테스트 범위 밖 오류는 남는다. 과학은 실험 장비·재료·가설의 불확실성이, 로봇은 물리 세계의 비용과 위험이, 의료는 지연된 결과와 집단 차이가 큰 제약이 된다. 논문 §4, §6
따라서 “우리 시스템은 L3/L4다”보다 다음 질문이 실용적이다. 변경된 것은 무엇인가? 그 변경이 다음 회차에서 실제로 검색·실행됐는가? 새 평가기가 점수를 좋게 만든 것인지, 문제를 더 잘 풀게 한 것인지 어떻게 분리했는가? 실패·퇴행·비용·사람의 검토 시간까지 기록했는가? 논문은 L5 평가에 학습 궤적, 보존, 전이, 비용, 안정성, 개선 기구 재사용을 함께 보라고 제안한다. 이는 현재 RSI를 주장하는 시스템을 읽는 점검표로도 쓸 만하다.
로드맵을 할인해서 읽는 법
이 논문은 RSI가 임박했다고 증명하지 않는다. 저자들 자신도 세대를 가로지르는 통계적으로 신뢰할 만한 누적 개선은 아직 열린 문제라고 적는다. 산업 사례와 초보적 실험은 가능성을 보여 주는 자료지만, 같은 예산과 독립 평가 아래 후계자가 계속 좋아진다는 증거와는 다르다. 논문 §3.6.5, §6–7
마무리. 이 서베이는 RSI를 신비한 미래상에서 꺼내, 확인 가능한 질문으로 바꾼다. “무엇이 바뀌었나?”, “누가 다음 개선을 결정했나?”, “그 변경이 다음 회차를 이끌었나?”, “비슷한 비용에서 정말 더 나은 후계자를 만들었나?” 이 질문을 통과해야 재귀적 개선이라는 말이 구체성을 갖는다.
다섯 수준은 미래를 예언하거나 AI의 성적을 매기지 않는다. 개선 루프에서 책임과 검증이 어디에 놓였는지 보여 주는 지도다. 그 지도를 쓰면 강한 데모를 보더라도 자동화된 현재 성과와 다음 세대의 개선 능력을 섞지 않고 읽을 수 있다.
정의, HCI 계산, 산업 사례와 근거의 한계는 상세 읽기에서 이어집니다.
References
Duan, Y., Liu, Y., Tang, Z., Chen, H., Zhou, J., et al. (2026). The last AI built by humans: Toward genuine recursive self-improvement (arXiv:2609.11873v1). arXiv. https://arxiv.org/abs/2609.11873v1