TTPO: Test-Time Policy Optimization
다수결이 틀려도 배울 수 있을까 — TTPO 쉽게 읽기
TTPO는 정답 없는 시험 문제에서 여러 풀이의 다수 답을 임시 기준으로 삼되, 동의한 풀이와 불일치한 풀이를 다르게 학습한다. 수학 추론 점수를 높였지만, 틀린 다수가 소수 정답을 벌할 위험까지 없애지는 못한다.
Paper: Aozhe Wang; Zhengxi Lu; Jianze Wang; Shangke Lv; Ying Liu; Weiming Lu; Jun Xiao; Yueting Zhuang; Hua Yang; Qianglong Chen; Yongliang Shen (2026). "TTPO: Test-Time Policy Optimization" (arXiv:2608.27448v1, 2026-08-27). 논문 · PDF · 공식 코드
한눈에 보기: 풀이는 여럿인데 정답지는 없는 수학 문제를 모델에게 맡겼다고 해 보자. 답이 가장 많이 나온 쪽을 임시 정답으로 쓰는 방법은 간단하지만, 어려운 문제에서는 다수가 함께 틀릴 수 있다. TTPO는 이 위험을 없애겠다고 하지 않는다. 대신 다수와 같은 답을 낸 풀이와 다른 답을 낸 풀이를 같은 방식으로 가르치지 않는다. 전자는 그 풀이의 추론을 더 촘촘히 옮기고, 후자는 다수 답의 내용을 베끼게 하지 않은 채 일부 이상한 선택만 줄인다. 논문은 라벨 없이도 경쟁 수학 벤치마크에서 개선을 보고했지만, 소수의 정답 풀이가 벌점을 받을 가능성은 남는다.
1. 정답지가 없는 시험장에서 무엇을 배울까
모델이 이미 받은 시험 문제를 다시 풀면서 스스로 개선하려면 보통 정답이 필요하다. 정답과 맞으면 보상하고, 틀리면 고치는 방식이다. 하지만 시험 시점 학습(test-time training)은 바로 그 문제에 정답지가 없다는 상황을 다룬다. 새 문제를 풀면서 배워야 하지만, 사람 채점자는 오지 않는다.
여기서 자연스럽게 떠오르는 방법이 다수결이다. 같은 문제에 대해 모델이 여러 개의 풀이를 만들고, 가장 많이 나온 최종 답을 **유사라벨(pseudo-label)**로 삼는다. 예를 들어 열두 번의 풀이 중 일곱 번이 답 A, 세 번이 B, 두 번이 C라면 A를 임시 기준으로 잡는다.
어려운 경쟁 수학에서는 이 기준이 꽤 자주 틀린다. 논문은 Qwen3-1.7B를 AIME 2026 문제에서 시험 시점 학습할 때, 다수 답이 틀린 문제의 비율이 약 85%였다고 보고한다. 이 숫자를 다른 모델이나 분야의 일반 비율로 읽을 수는 없다. TTPO는 다수 답 자체를 정답처럼 믿지 말고, 다수에 동의한 풀이와 동의하지 않은 풀이에서 어떤 신호가 덜 위험한가를 따져 보자는 쪽으로 질문을 바꾼다. 논문 §1, Figure 1
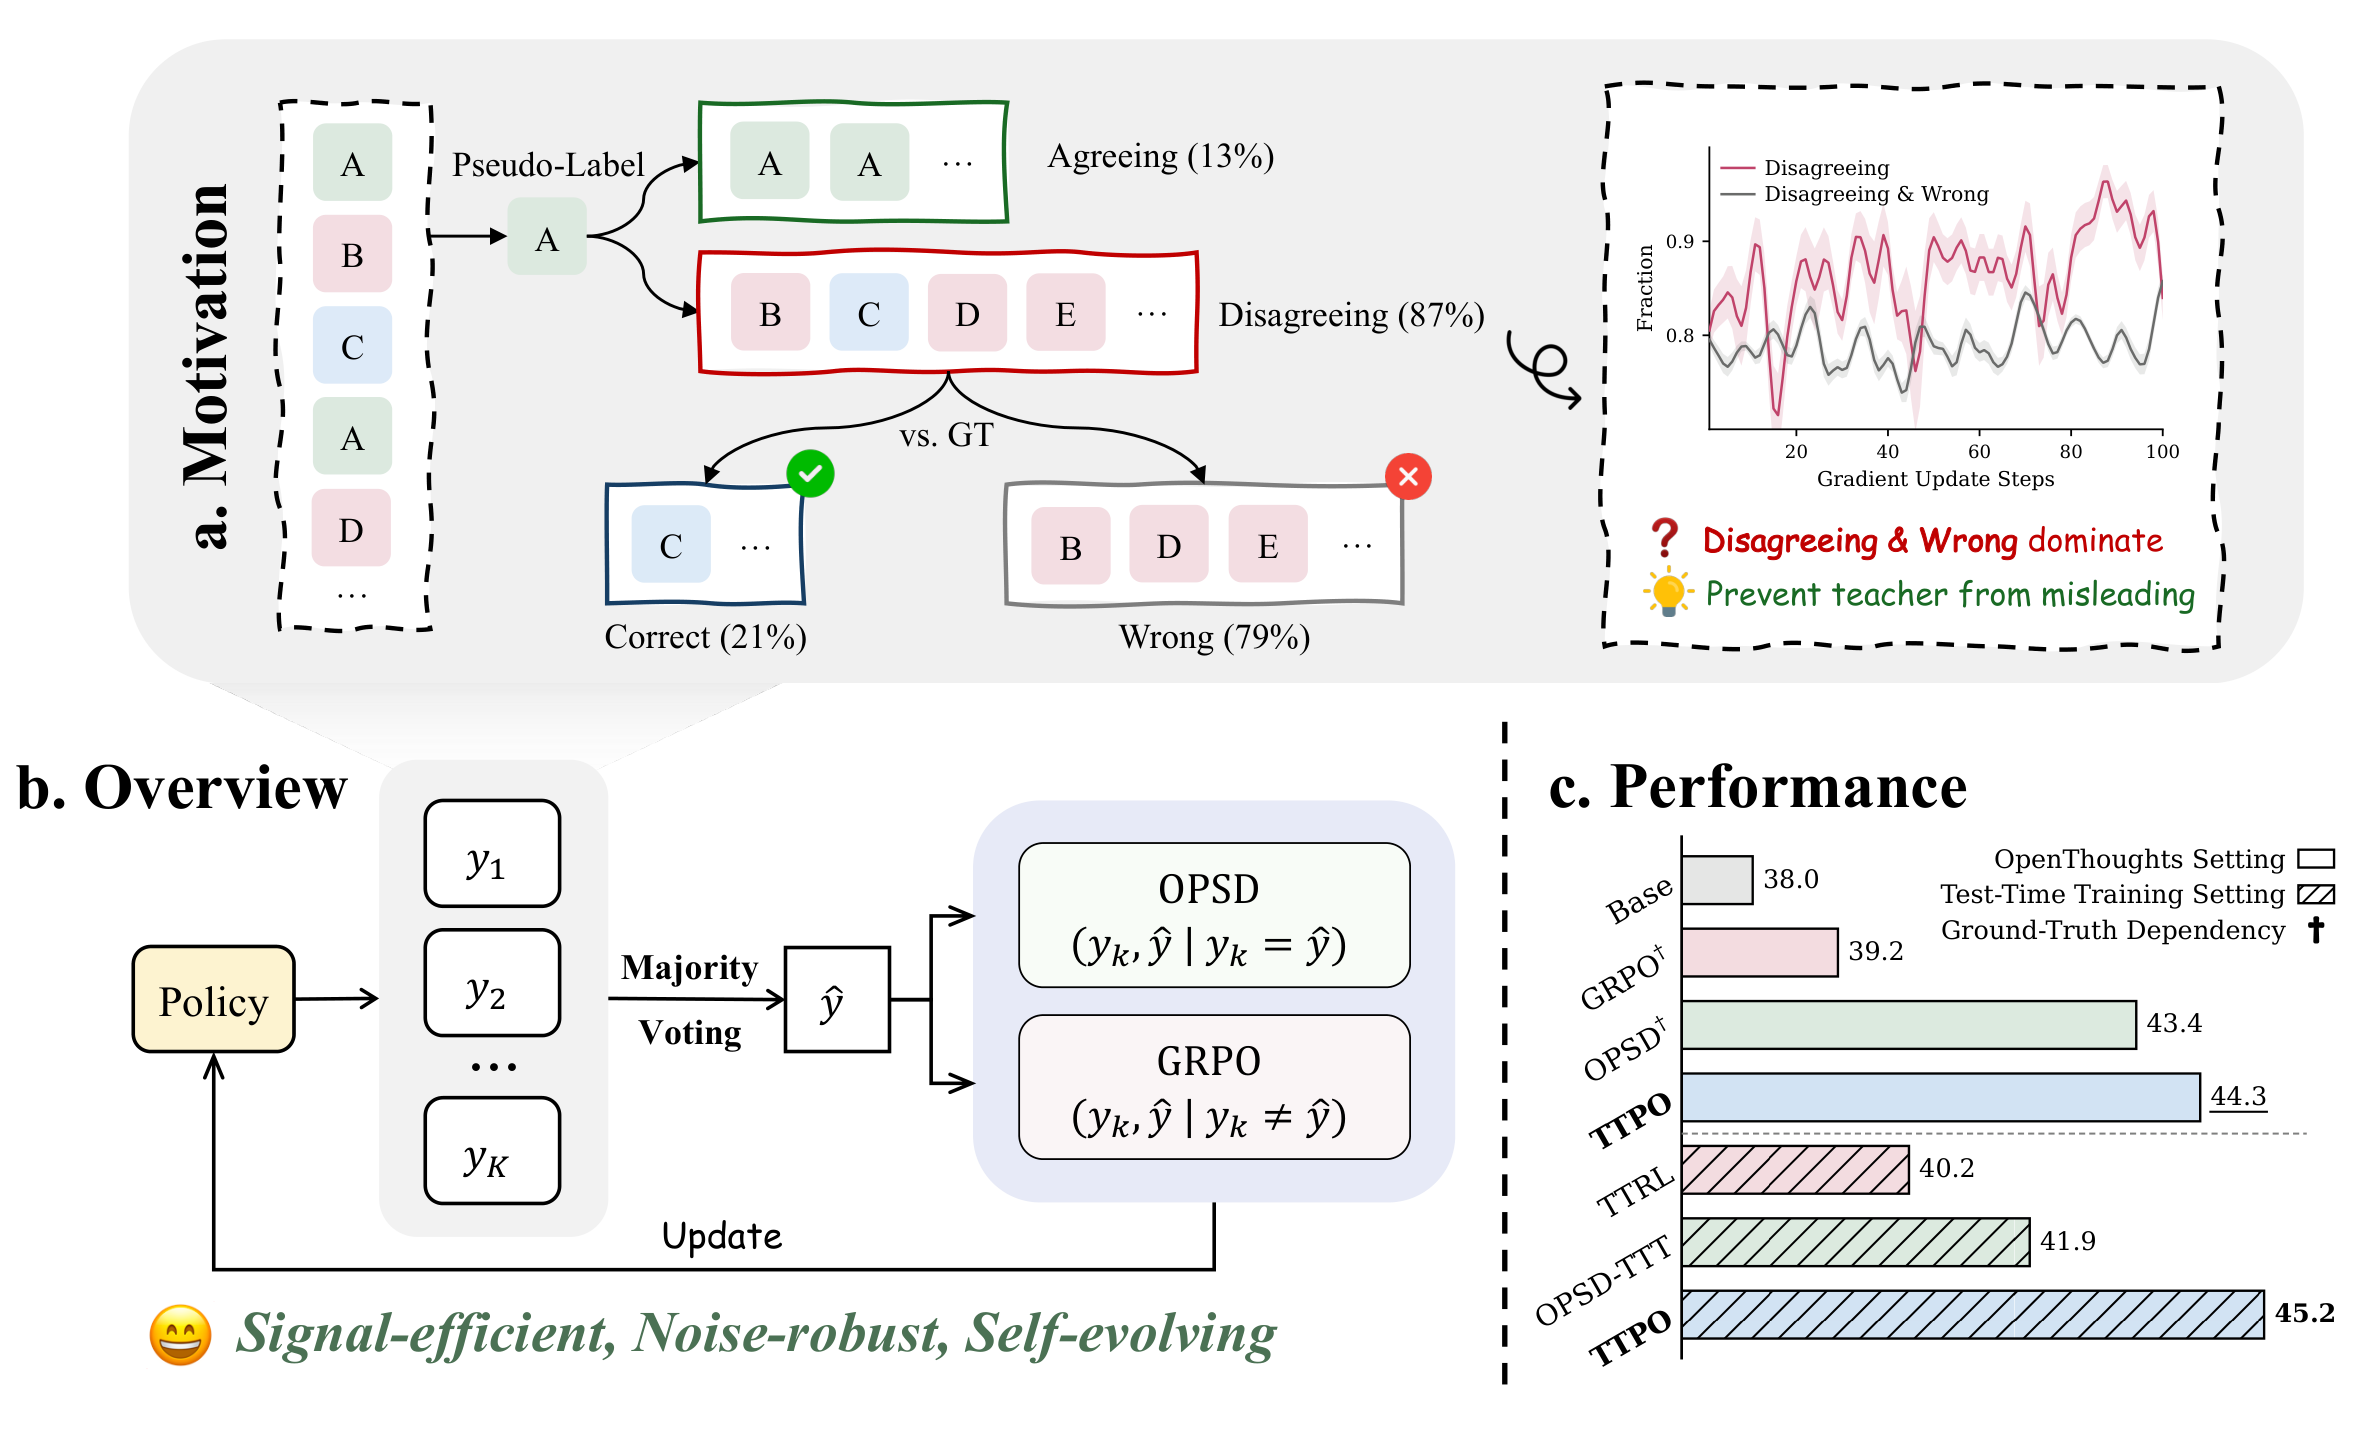
동의·불일치는 다수 답과의 관계를 뜻하며 정답·오답 구분과 같지 않다. 도판의 표본 비율과 본문에서 말한 문항 단위의 약 85%는 같은 분모가 아니므로 합쳐 읽지 않는다. 원논문 Figure 1, p. 1을 그대로 인용했다(arXiv:2608.27448v1).
2. 두 종류의 풀이를 갈라 다룬다
TTPO의 흐름은 다음과 같다. 먼저 여러 풀이의 최종 답을 같은 값끼리 묶는다. 가장 큰 묶음이 임시 기준이고, 그 답과 같은 풀이를 ‘동의 풀이’, 다른 답을 낸 풀이를 ‘불일치 풀이’로 나눈다.
모델은 문장을 토큰이라는 작은 조각으로 나눠 처리한다. 동의 풀이에는 이 토큰 단위의 **자기증류(self-distillation)**를 쓴다. 여기서 증류는 교사가 각 다음 토큰에 부여하는 확률 분포를 학생이 참고하게 하는 학습이다. 다수 답 A와 같은 답을 낸 한 풀이를 생각해 보자. TTPO는 A를 단서로 준 교사가 그 풀이의 각 다음 토큰을 어떻게 볼지를 참고하게 한다. A가 실제로 오답이어도 이 갈래는 ‘전혀 다른 답 B를 A로 바꾸라’고 직접 밀어붙이지 않는다. 동의 풀이가 이미 A를 냈기 때문이다. 논문은 이를 사고 모드에서 나온 추론을 더 짧은 생성 방식으로 옮기는 신호로 해석한다. 논문 §3.1–3.3
불일치 풀이에는 반대 방향의 신호를 쓴다. 다수와 다르다는 이유만으로 답 A의 풀이를 그대로 베끼게 하는 대신, 그 풀이에서 모델의 예측 분포는 한쪽으로 뚜렷한데 실제로 뽑힌 토큰의 확률은 낮았던 위치에 선택적으로 벌점을 준다. 이를 이상 신호로 삼는다. GRPO는 같은 문제에서 나온 풀이들을 묶어 상대 보상을 계산하는 강화학습 방식이다. TTPO의 GRPO 갈래는 ‘다수 답의 내용’보다 ‘가장 큰 답 묶음 밖에 있다’는 사실을 이용한다. 그래서 틀린 다수 답을 정답 문장처럼 모든 토큰에 퍼뜨리는 위험을 줄이려는 것이다. 논문 §3.4
| 갈래 | 모델이 받는 신호 | 막으려는 실패 |
|---|---|---|
| 다수와 같은 답 | 그 풀이를 따라가는 토큰별 증류 | 이미 잘 아는 토큰까지 똑같이 반복 학습하는 낭비 |
| 다수와 다른 답 | 확신한 이상 토큰에 한정한 벌점 | 소수 풀이 전체를 한꺼번에 오답으로 몰아가는 손상 |
두 갈래 모두 토큰을 골라 쓴다. 증류 갈래에서는 학생이 이미 확신하고 교사와도 맞는 부분의 비중을 낮춘다. 벌점 갈래에서는 풀이 전체가 아니라 예측 분포의 확신도와 실제 선택 토큰의 낮은 확률을 함께 반영한 이상 점수가 높은 절반의 토큰만 벌한다. 이는 ‘불일치 풀이가 틀렸다’는 판정기가 아니라, 잘못된 벌점이 풀이 전체에 번지는 피해를 줄이는 장치다. 논문 §3.3–3.4
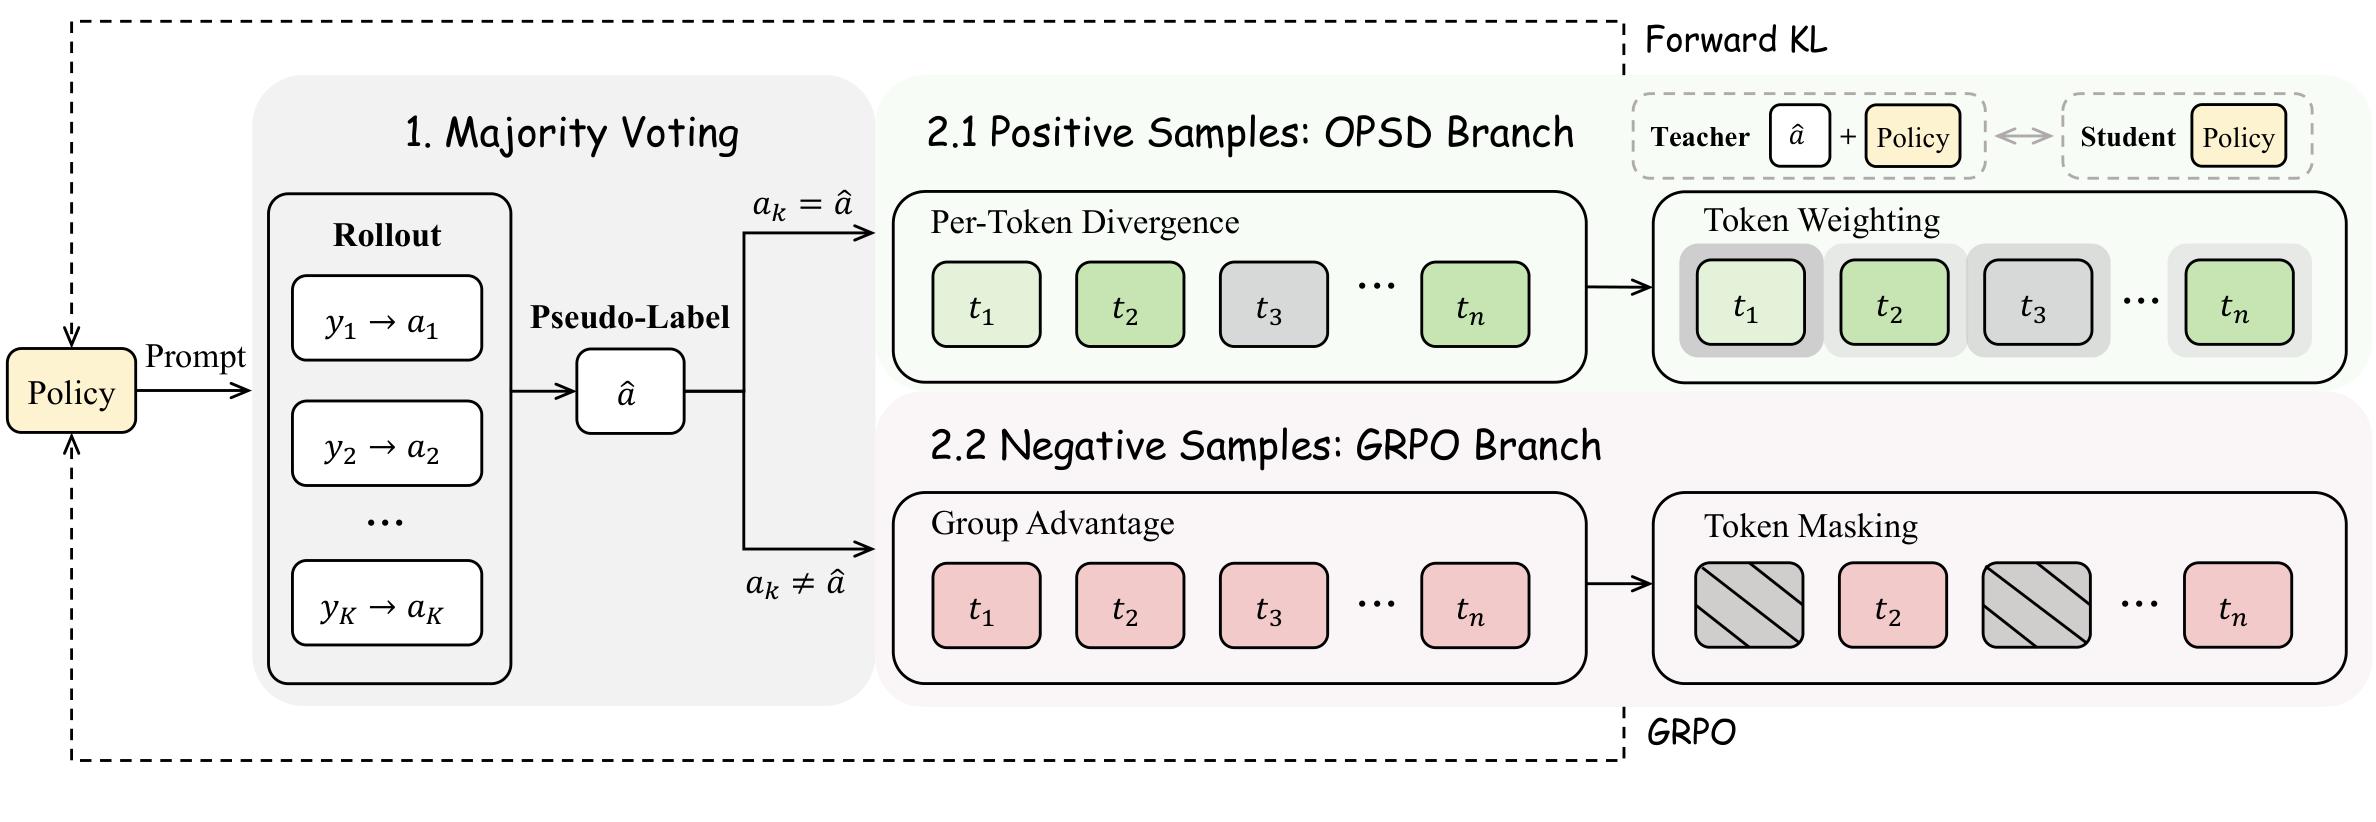
동의 풀이 쪽은 교사의 토큰 분포를 배우고, 불일치 풀이 쪽은 고른 위치에만 벌점을 준다. 이 분리는 다수 답을 그대로 베끼는 위험을 줄이려는 장치이며 소수 정답을 알아보는 판별기는 아니다. 원논문 Figure 2, p. 4을 그대로 인용했다(arXiv:2608.27448v1).
3. 왜 이 분리가 다수결 오류에 조금 더 견디는가
TTPO가 의지하는 관찰은 비대칭이다. 논문은 다수 답이 틀렸을 때에도 그 답과 다른 풀이 중 상당수가 여전히 틀렸다고 보고한다. 따라서 불일치 풀이를 약하게 누르는 신호는, 다수 답의 구체적 내용을 교사에게 넣어 모든 토큰을 지도하는 것보다 덜 취약할 수 있다.
하지만 여기에는 분명한 선이 있다. 다수에 반대한 풀이 중에는 실제 정답도 있을 수 있다. 그런 소수 정답은 불일치 갈래에 들어가 벌점을 받을 수 있다. 토큰 마스킹은 그 풀이 안의 모든 단어를 똑같이 누르지 않게 할 뿐, 최종 답이 소수였다는 사실을 알아내 구제하지는 못한다.
그래서 TTPO를 ‘다수결이 틀려도 정답을 찾아내는 방법’으로 읽으면 안 된다. 더 정확한 설명은 이렇다. 불완전한 자기 신호를 그대로 확신하지 않고, 어떤 종류의 갱신이 특히 위험한지를 나눠 피해를 줄이는 방법이다. 이 설계만으로 다수 답의 품질이 낮은 새 분야에서도 안전하게 학습한다고 보장할 수는 없다.
4. 논문이 실제로 보인 수치
논문은 Qwen3 1.7B·4B·8B 모델을 두 방식으로 평가했다. 하나는 라벨이 있는 OpenThoughts 데이터에서 TTPO만 라벨을 보지 않게 하는 비교이고, 다른 하나는 문제 자체를 학습과 평가에 쓰는 순수 시험 시점 학습이다.
순수 시험 시점 학습은 AIME 2026·HMMT 2026·BRUMO 2025의 세 벤치마크에서 평가했다. Qwen3-1.7B의 평균은 38.0%에서 45.2%로, 4B는 57.4%에서 61.1%로, 8B는 60.7%에서 65.3%로 보고됐다. 별도로 다섯 벤치마크에서 평가한 OpenThoughts 비교에서는 TTPO의 평균이 1.7B·4B·8B에서 40.1·58.6·62.6이었고, 라벨을 쓰는 OPSD의 39.7·58.4·61.7과 비슷하거나 높았다. 두 실험은 평가 과제 수가 다르므로 서로의 평균을 직접 비교해서는 안 된다. 논문 Tables 1–2
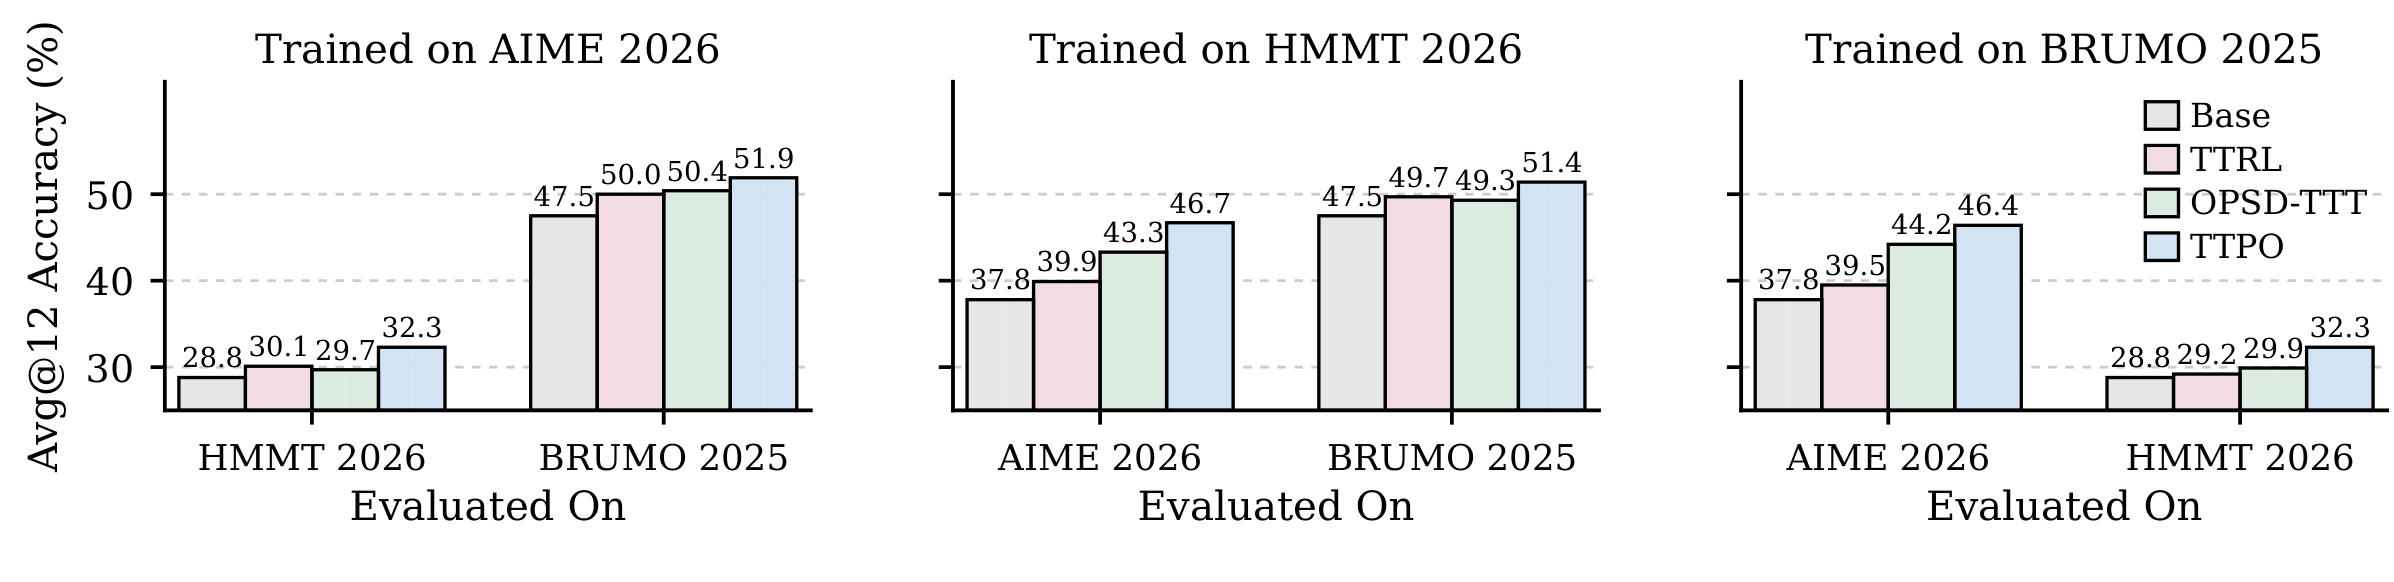
각 패널은 학습에 사용한 수학 과제 하나를 나타내고, 막대는 다른 두 과제로 옮겼을 때의 점수다. 기반 모델보다 높은 결과가 나왔지만, 이 도판이 보여 주는 전이는 세 경쟁 수학 벤치마크 안에 한정된다. 원논문 Figure 4, p. 8을 그대로 인용했다(arXiv:2608.27448v1).
이 수치는 TTPO가 무라벨 설정에서 작동할 가능성을 보여 준다. 다만 결과는 논문이 정한 경쟁 수학 과제, 표본·답 동치 판정, LoRA 미세조정, 그리고 각 방법에서 고른 최고 체크포인트에 묶여 있다. 보고값에 반복 실험의 산포나 유의성 검정은 붙지 않았다. 따라서 38.0에서 45.2로의 변화는 ‘이 설정에서 저자가 보고한 개선’이지, 어떤 정답 없는 업무에도 같은 폭으로 적용된다는 약속은 아니다.
5. 언제 이 아이디어가 쓸모 있는가
TTPO의 실험은 정답 검증 비용이 높고, 같은 입력에서 여러 풀이를 생성할 수 있으며, 수학적 동치로 최종 답을 군집화할 수 있는 경쟁 수학 문제에 놓여 있다. 답을 묶는 규칙 자체가 흔들리거나, 다수의 오류가 체계적으로 같은 방향을 가리키는 영역에서의 효과는 이 논문이 직접 평가하지 않았다.
실무에서 비슷한 방식을 검토한다면 세 가지를 따로 측정해야 한다. 첫째, 다수 답이 실제로 얼마나 정확한가. 둘째, 다수와 다른 답 중 정답이 얼마나 자주 섞이는가. 셋째, ‘이상 토큰’으로 고른 위치가 진짜 오류와 얼마나 겹치는가. 이 셋을 확인하지 않고 TTPO의 수학 벤치마크 성과만 옮겨 오면, 안전장치가 필요한 이유를 잊게 된다.
6. 기억할 한 문장
TTPO는 다수결이 틀릴 수 있다는 사실에서 출발해 신호를 분리한다. 동의 풀이에는 촘촘한 학습을, 불일치 풀이에는 제한된 벌점을 쓴다. 그 분리는 실험에서 점수 개선과 연결됐지만, 소수 정답을 완전히 보호하지는 못한다. 이 방법은 불완전한 자기 지도에서 무엇을 조심해야 하는지 보여 주는 설계다. ‘라벨 없는 학습의 해답’으로 볼 수는 없다.
더 긴 방법·절제 실험·평가 설계 검토는 상세 읽기에서 이어집니다.
References
Wang, A., Lu, Z., Wang, J., Lv, S., Liu, Y., Lu, W., Xiao, J., Zhuang, Y., Yang, H., Chen, Q., & Shen, Y. (2026). TTPO: Test-Time Policy Optimization (arXiv:2608.27448v1). arXiv. https://arxiv.org/abs/2608.27448v1