Better & Faster Large Language Models via Multi-token Prediction
다음 토큰 하나 대신 여러 개를 함께 — 쉽게 읽는 멀티토큰 예측
다중 토큰 예측은 같은 문맥에서 여러 미래 토큰을 함께 학습하고, 추가 예측기를 생성 가속에도 쓰는 방법이다. 코드 실험에서 성능과 속도 개선을 보였지만, 모델 크기와 학습량에 따라 이득이 달라졌다.
Paper: Fabian Gloeckle; Badr Youbi Idrissi; Baptiste Rozière; David Lopez-Paz; Gabriel Synnaeve (2024). "Better & Faster Large Language Models via Multi-token Prediction". https://arxiv.org/abs/2404.19737v1 · arXiv:2404.19737v1. 이 글은 2024년 4월 30일 공개된 판본을 수식 없이 설명한다.
아이디어는 간단하다. 언어모델에게 바로 다음 토큰뿐 아니라, 그 뒤에 올 토큰도 함께 맞히도록 학습시키자. 저자들은 큰 코드 모델의 정답률을 높였고, 추가 예측기를 생성 가속에도 활용했다. 다만 작은 모델에서는 성능이 낮아지기도 했다.
토큰은 모델이 글을 처리하는 단위다. 단어 하나가 토큰 하나일 수도 있지만 여러 조각으로 나뉘기도 한다. ‘네 토큰을 예측한다’는 말을 ‘네 단어를 예측한다’와 같은 뜻으로 쓰면 안 된다.
1. 바로 다음뿐 아니라 그다음도 묻는다
보통의 언어모델 학습에서는 앞부분의 글을 보여주고 바로 다음 토큰을 맞히게 한다. 정답 토큰에 더 높은 확률을 주도록 가중치를 조정하는 과정을 많은 문장에서 반복한다. 한 번 맞히면 그대로 두고 틀릴 때만 수정하는 단순한 채점 방식은 아니다.
이 논문은 같은 문맥에서 다음 두 번째·세 번째·네 번째 토큰에도 학습 목표를 준다. 두 번째 토큰을 맞힐 때 정답인 첫 번째 토큰을 새로 알려주는 것이 아니다. 아직 보지 않은 중간 내용을 건너서 더 먼 위치도 예측해야 한다. 문맥을 표현하는 모델 본체에 더 넓은 정보를 담으라고 요구하는 셈이다. 논문 §2
저자들은 이 과제가 중요한 선택과 그 뒤의 전개를 더 잘 배우게 할 수 있다고 설명한다. 코드에서 어떤 함수를 선택하느냐는 뒤에 올 인자에도 영향을 준다. 다만 이것은 논문이 제안하는 설명 가설이며, 실제 효과와 구분해서 읽어야 한다.
2. 본체는 공유하고 예측 역할을 나눈다
하나의 공유 본체가 글을 읽고 표현을 만들면, 여러 출력 헤드가 그 표현을 받아 서로 다른 미래 위치를 예측한다. 네 헤드를 쓰면 첫째가 바로 다음 토큰, 둘째가 그다음 토큰을 맡는 식이다.
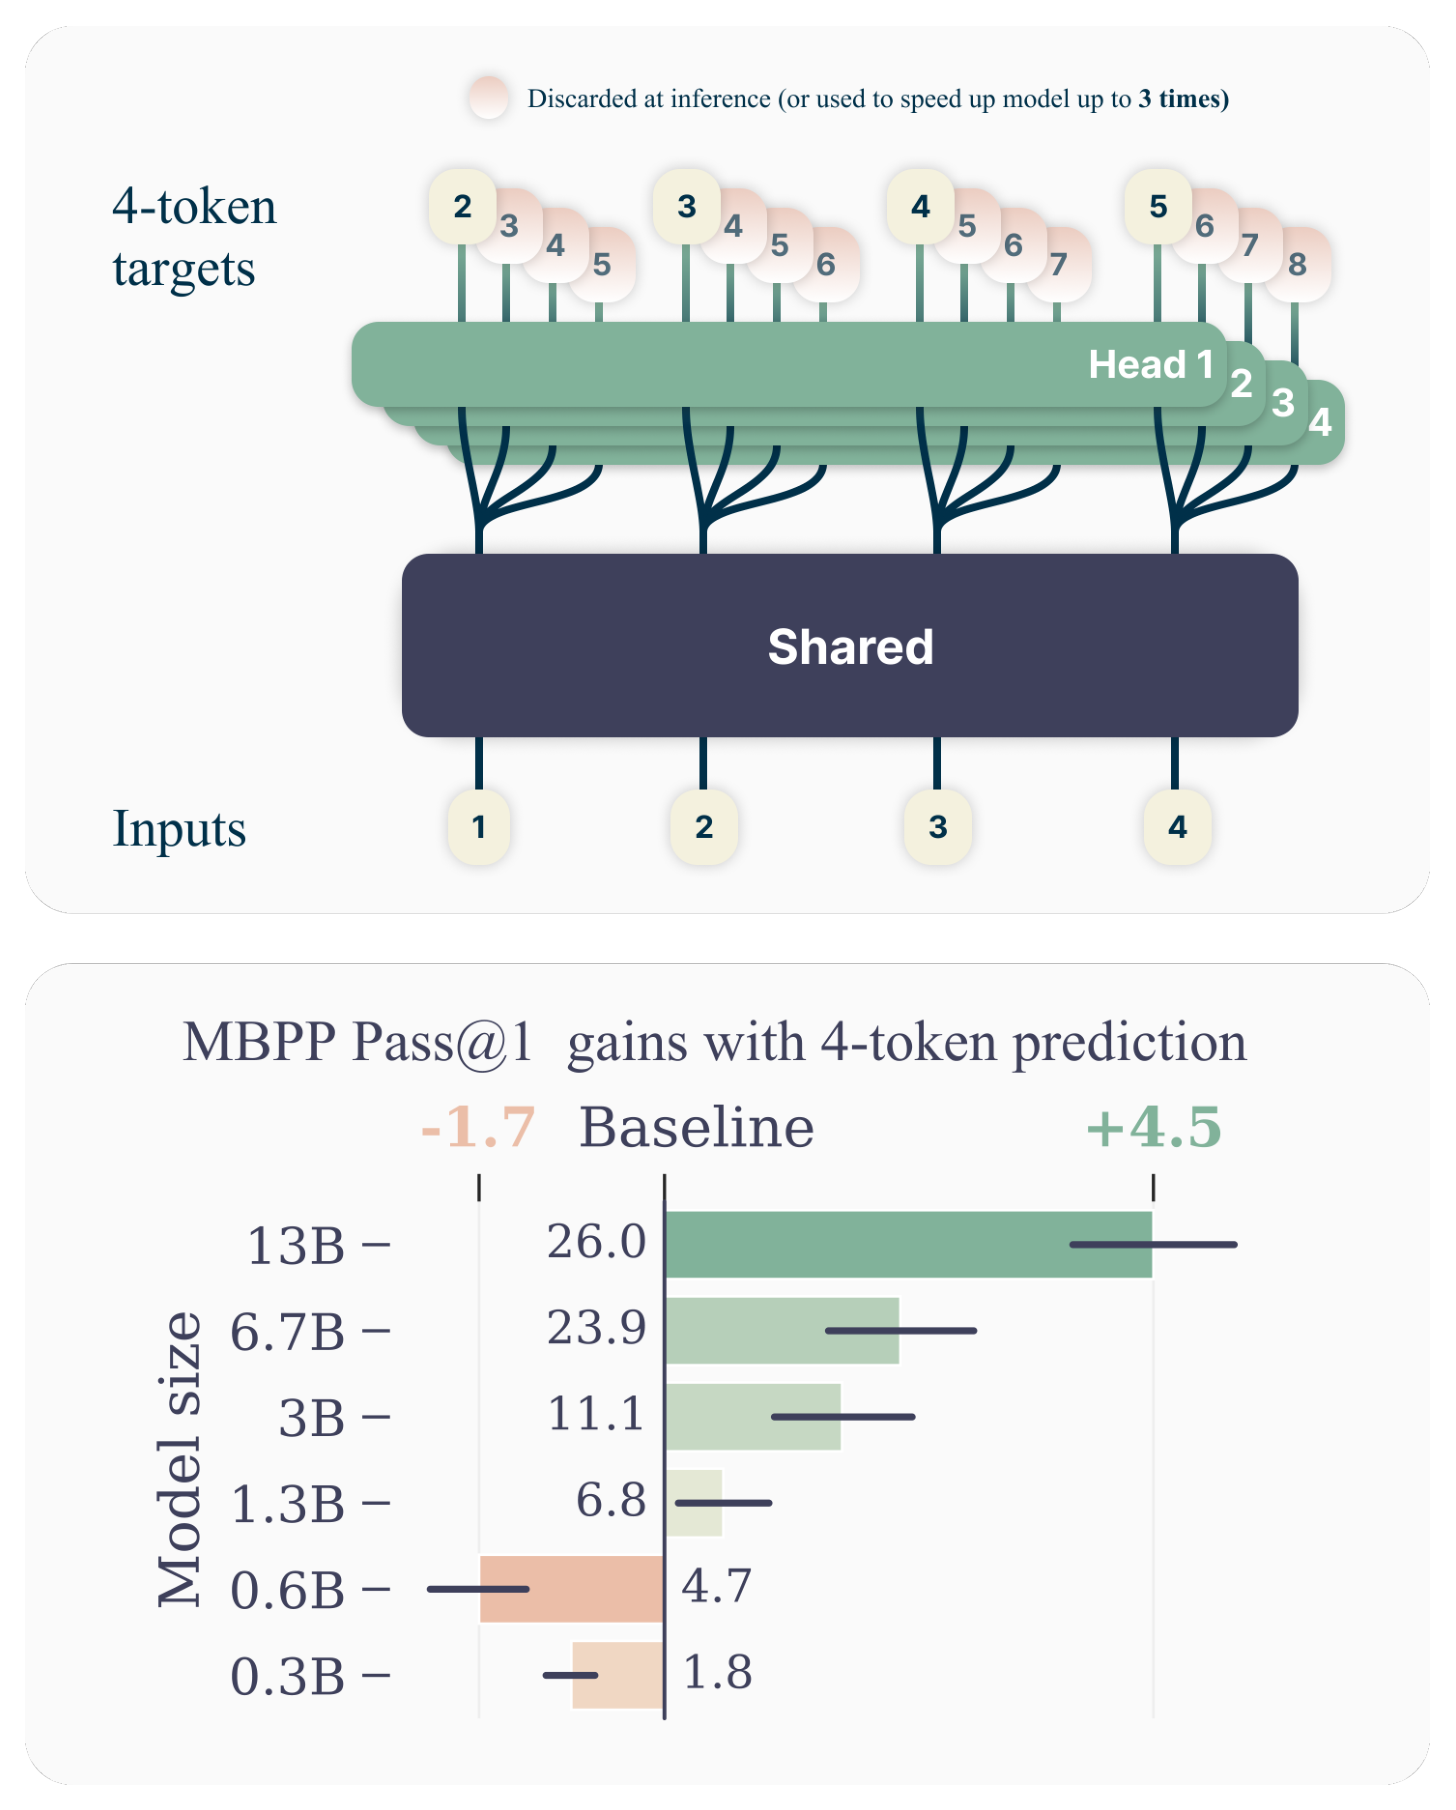
그림 1. 원논문 Figure 1. 위는 본체를 공유하는 네 예측 헤드, 아래는 모델 크기별 MBPP pass@1 변화다. 작은 두 모델의 성능 저하와 큰 모델의 개선이 함께 나타난다. Gloeckle et al. (2024), PDF p. 1. 제공된 원도판을 그대로 사용했다.
예측기를 늘린 만큼 모델이 커진 효과만은 아닐까? 이를 통제하려고 같은 규모의 비교에서는 추가 헤드 세 층만큼 본체의 층을 줄인다. 전체 파라미터 수를 맞춘 비교다. 본체 구조가 완전히 그대로인 것은 아니지만, 단순히 더 큰 모델을 만든 결과로 설명할 수도 없다.
학습할 때는 헤드별 계산과 역전파를 차례로 끝낸다. 그러면 큰 어휘별 점수와 그 기울기를 모든 헤드에 대해 동시에 보관할 필요가 없다. 이는 특정 중간 텐서의 메모리 부담을 줄이는 기법이다. 전체 GPU 메모리가 헤드 수와 무관해진다는 뜻은 아니며, 이 판본에는 실제 최대 메모리 사용량의 비교 수치가 없다. 논문 §2, Figure 2
3. 큰 코드 모델의 점수는 얼마나 올랐나
저자들은 0.3B부터 13B까지 여섯 크기를 평가했다. B는 십억 단위의 파라미터 수다. 다음 토큰 하나를 예측하는 기준선과 여러 토큰을 예측하도록 학습한 모델을 비교한다.
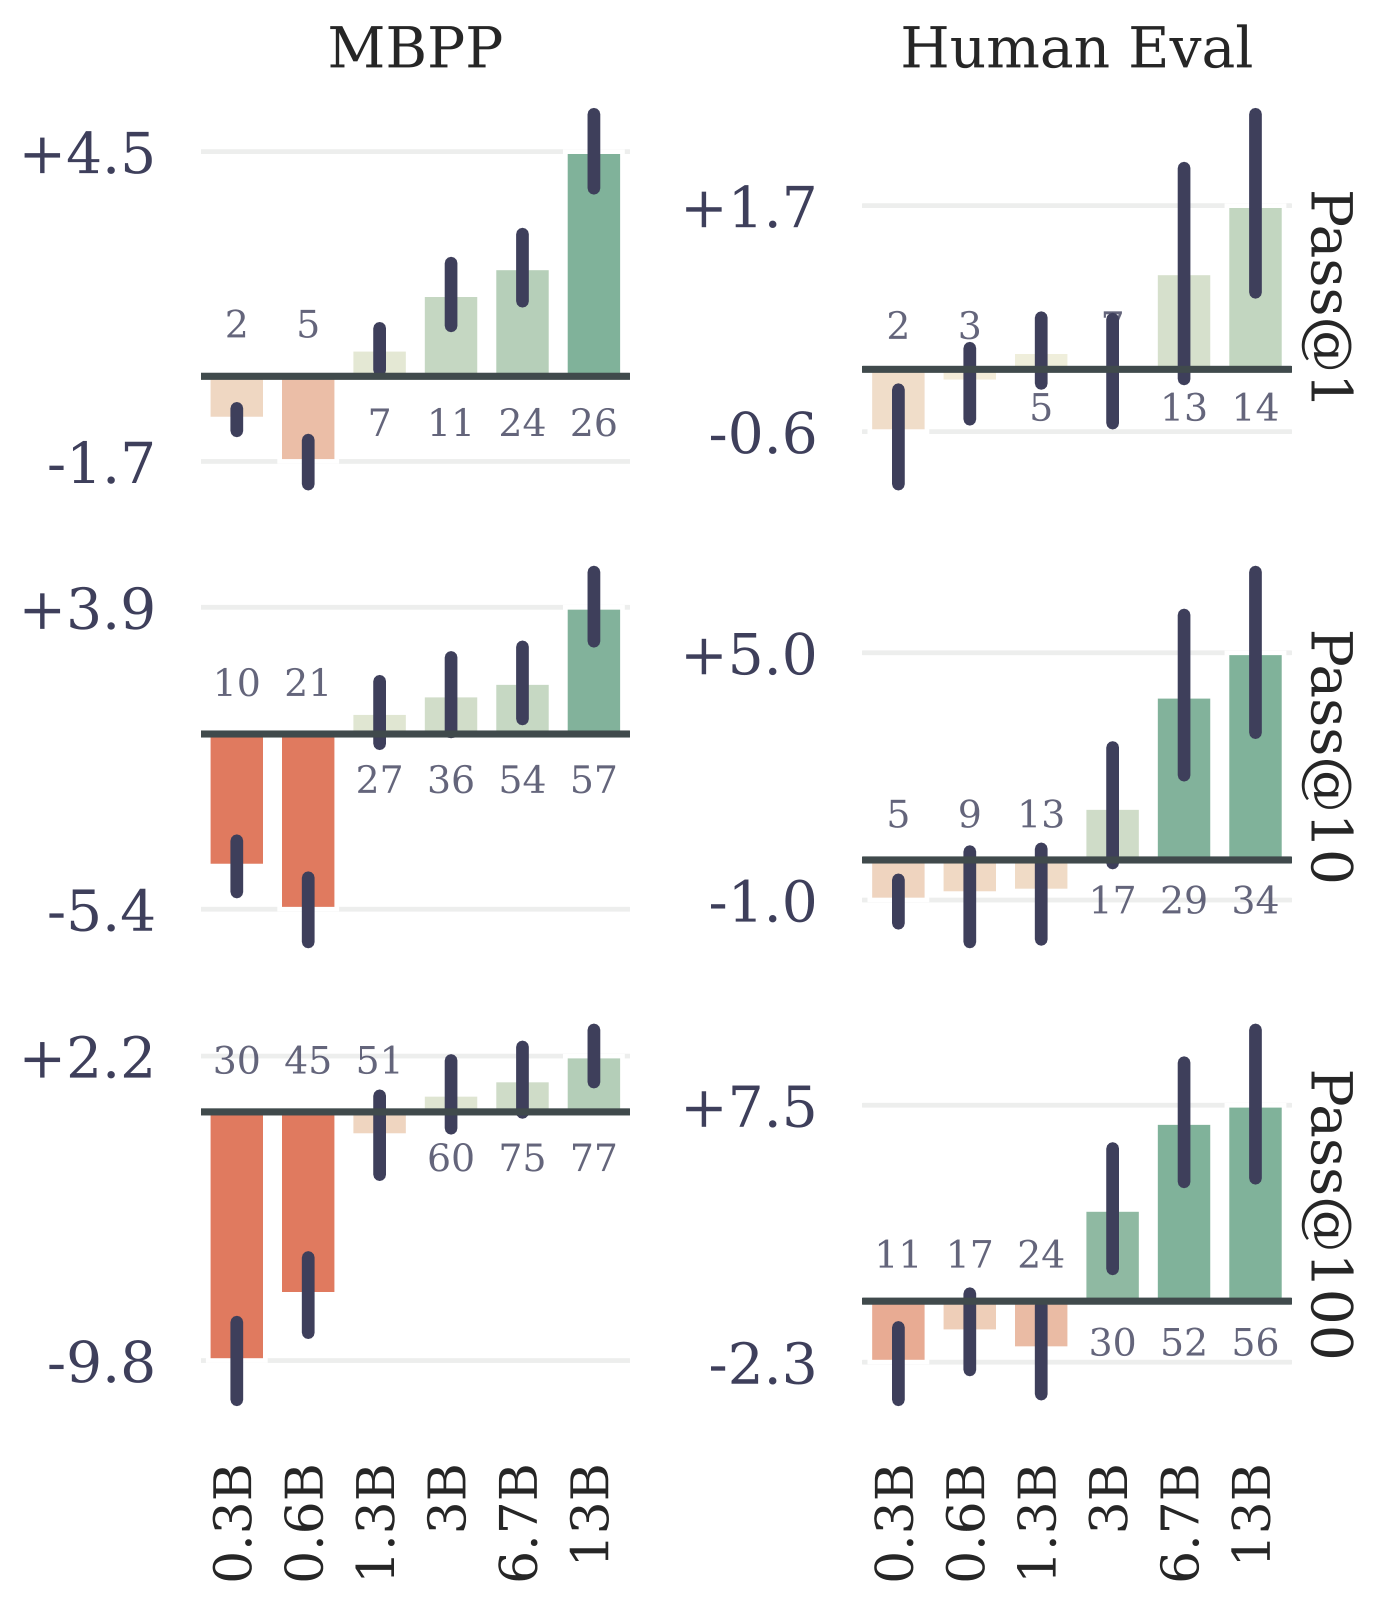
그림 2. 원논문 Figure 3. 막대는 4-token 모델에서 같은 규모의 기준선을 뺀 차이다. 지표와 모델 크기에 따라 개선·퇴보·동률이 달라지며 패널마다 축 범위도 다르다. Gloeckle et al. (2024), PDF p. 3. 제공된 원도판을 그대로 사용했다.
가장 작은 0.3B·0.6B의 4-token 모델은 여섯 지표 모두에서 기준선보다 낮았다. 1.3B에서는 증가와 감소가 섞였고, 3B는 HumanEval pass@1에서 동률이었다. 13B에서는 여섯 지표가 모두 높았다. 모든 지표에 통하는 하나의 성공 경계가 확인된 것은 아니다.
13B의 대표 결과를 보면 초록의 ‘17% 향상’이 무엇을 뜻하는지 알 수 있다. pass@1은 한 번 생성한 코드가 문제를 해결할 성능을 나타내는 지표다.
| 코드 평가 | 다음 토큰 기준선 | 4-token 모델 | 점수 차이 |
|---|---|---|---|
| MBPP pass@1 | 26.0 | 30.5 | +4.5점 |
| HumanEval pass@1 | 14.1 | 15.8 | +1.7점 |
MBPP의 4.5점을 기준선 26.0으로 나누면 약 17%다. 즉 17점 상승이 아니라 기준선에 대한 상대 증가율이다. 논문 Table S7
같은 크기 안의 두 모델은 학습량도 맞췄다. 다만 작은 네 모델은 각각 91.0B 토큰, 큰 두 모델은 각각 209.7B 토큰을 학습했다. 규모가 커질수록 이득이 커지는 모양을 모델 크기만의 효과로 분리할 수는 없다. 논문 Table S13
4. 추가 헤드를 쓰면 생성도 빨라진다
학습 후에는 첫 헤드만 써서 토큰을 하나씩 생성해도 된다. 나머지 헤드를 함께 쓰면 여러 미래 토큰의 초안을 만들 수 있다. 이것이 자기 추측 디코딩이다.
- 추가 헤드들이 앞으로 나올 토큰을 제안한다.
- 같은 모델의 첫 헤드가 그 제안을 자기회귀 방식으로 검증한다.
- 검증을 통과한 연속 구간을 받아들이고, 어긋난 부분부터 다시 생성한다.
논문은 매번 가장 확률이 높은 토큰을 고르는 탐욕 디코딩으로 속도를 측정했다. 이 검증 절차는 같은 모델을 첫 헤드만으로 탐욕적으로 실행했을 때의 출력을 보존한다. 별도로 학습한 기준선과 같은 답을 낸다거나 임의의 샘플링 설정에서도 그대로 적용된다는 뜻은 아니다.
7B 코드 모델에서 네 헤드를 쓴 경우, 배치 크기 42에서 첫 헤드만 쓴 실행보다 3.05배 빨랐다. 한 번의 순전파에서 얻는 토큰은 평균 3.50개였다. 위의 13B 정답률 개선과는 모델 크기·학습량·비교 대상이 다른 실험이다. 논문 Table S2
5. 잘 안 되는 조건과 추가 비용도 있다
코드에서 얻은 이득이 모든 과제로 이어지는 것은 아니다. 자연어 벤치마크의 평균 정확도에서는 4-token 모델이 기준선보다 낮게 끝났다. 같은 데이터를 여러 번 학습한 코드 실험에서도 일부 지표는 순위가 뒤집혔다.
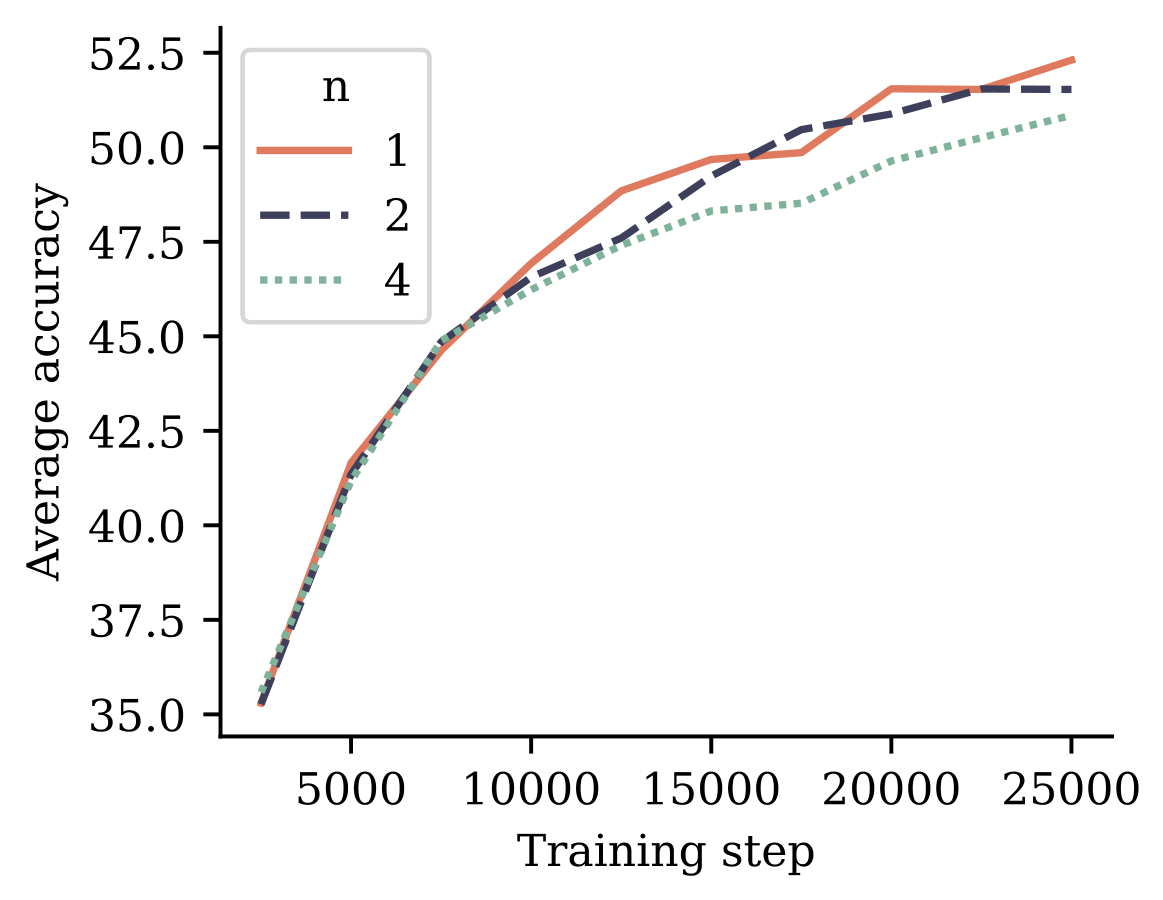
그림 3. 원논문 Figure 5. 자연어 평가의 평균에서는 다음 토큰 기준선이 4-token 모델보다 높게 끝난다. 평가 대상 수는 본문·부록에서 표기가 달라, 모든 언어 능력의 종합 점수로 읽지 않는다. Gloeckle et al. (2024), PDF p. 5. 제공된 원도판을 그대로 사용했다.
단순한 패턴 학습과 수학 과제에서도 조건에 따라 우위가 사라졌다. 이를 ‘어떤 능력이 생기면 다중 토큰 예측은 항상 해롭다’는 법칙으로 일반화할 수는 없다. 제한된 과제의 관측이며 코드 모델의 규모 실험과도 평가 축이 다르다.
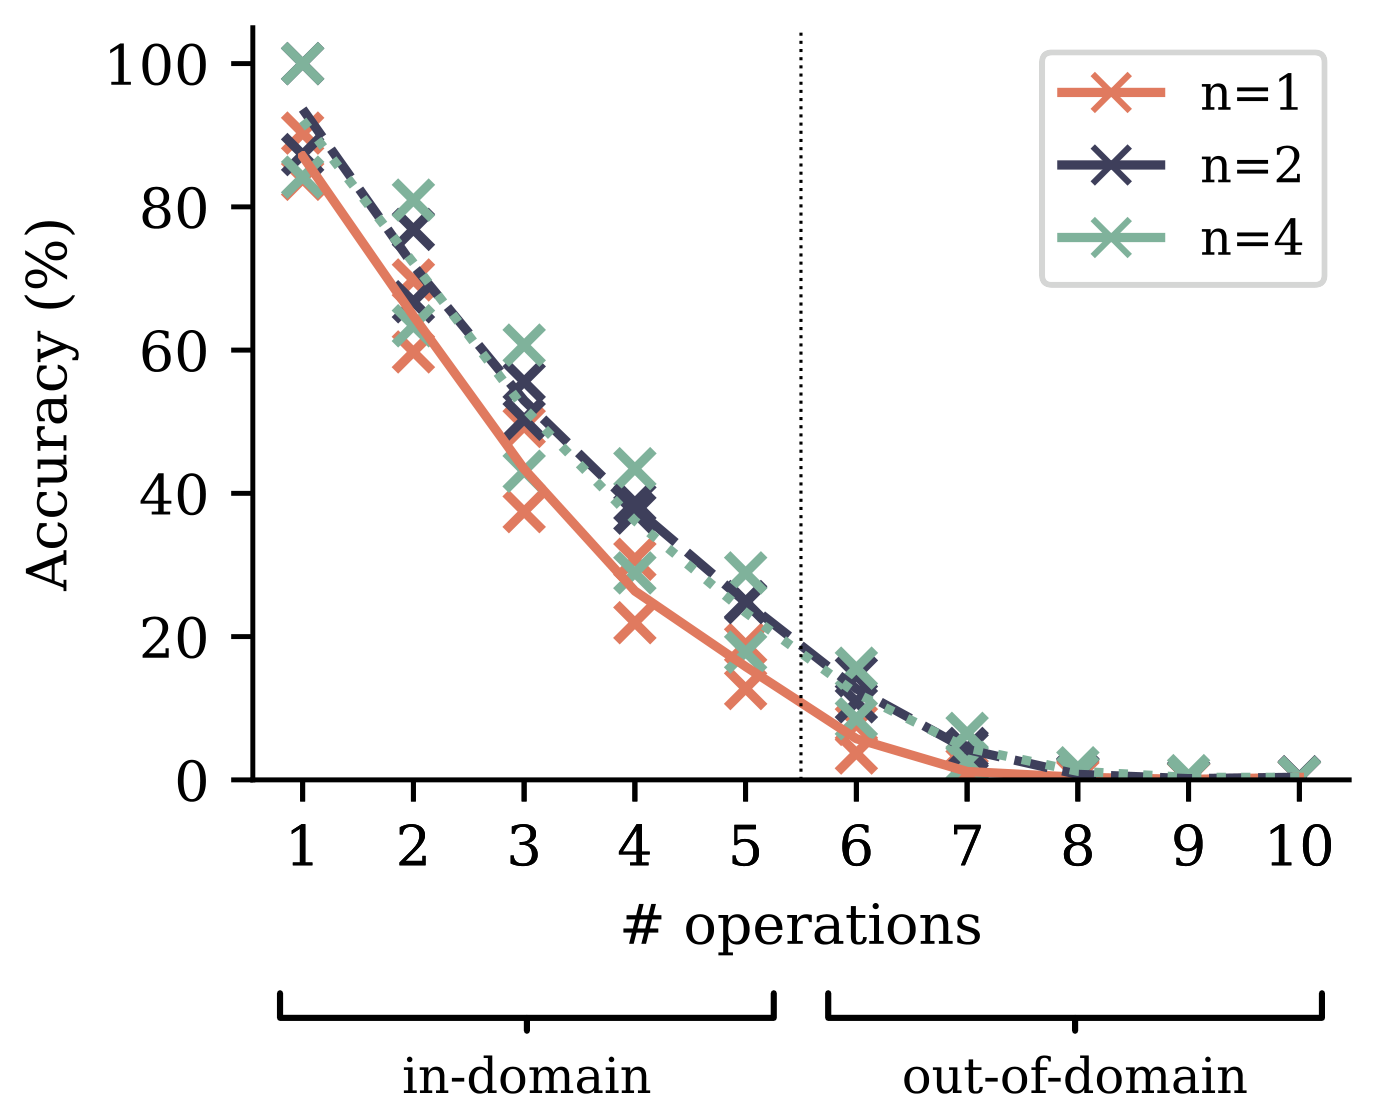
그림 4. 원논문 Figure 8. 합성 산술 과제에서 다중 토큰 조건이 일부 앞서지만, 연산 수가 커지면 모든 조건의 정답률이 낮아진다. 상대적 개선과 충분히 높은 정확도는 구분해야 한다. Gloeckle et al. (2024), PDF p. 7. 제공된 원도판을 그대로 사용했다.
학습 시간도 따로 봐야 한다. 논문은 오버헤드가 없다고 설명하지만, 실제 표에서 4-token 모델의 학습 시간은 기준선보다 7~22% 길었다. 저자들은 분산 학습 구현에서 통신과 연산을 충분히 겹치지 못한 탓이며 개선할 수 있다고 설명한다. 측정된 추가 비용과 향후 구현 개선 가능성은 별개의 사실이다. 논문 Table S5
6. 이 논문에서 가져갈 것
이 연구는 학습 목표를 바꾸는 방법과, 그때 얻은 추가 헤드를 추론에 다시 쓰는 방법을 연결한다. 같은 문맥을 여러 미래 위치의 예측에 활용하도록 학습시키면 더 유용한 표현을 얻을 수 있다는 가능성을 보여 준다.
- 방법: 여러 미래 토큰을 함께 학습하며, 같은 규모의 비교에서는 파라미터 예산을 맞춘다.
- 결과: 큰 코드 모델의 정답률과 별도 탐욕 디코딩 실험의 속도에서 개선을 확인했다.
- 조건: 작은 모델의 퇴보와 학습 비용 증가도 있었으므로 자신의 모델·데이터·실행 환경에서 다시 평가해야 한다.
손실 함수, 메모리 구현, 자연어·미세조정 결과와 평가 조건은 상세 읽기에서 이어 볼 수 있다. 원문 PDF도 함께 제공한다.
References
Gloeckle, F., Youbi Idrissi, B., Rozière, B., Lopez-Paz, D., & Synnaeve, G. (2024). Better & faster large language models via multi-token prediction (arXiv:2404.19737v1). arXiv. https://arxiv.org/abs/2404.19737v1