Better & Faster Large Language Models via Multi-token Prediction
다중 토큰 예측은 같은 문맥에서 여러 미래 토큰을 함께 학습하고, 추가 예측기를 생성 가속에도 쓰는 방법이다. 코드 실험에서 성능과 속도 개선을 보였지만, 모델 크기와 학습량에 따라 이득이 달라졌다.
Paper: Fabian Gloeckle; Badr Youbi Idrissi; Baptiste Rozière; David Lopez-Paz; Gabriel Synnaeve (2024). "Better & Faster Large Language Models via Multi-token Prediction". https://arxiv.org/abs/2404.19737v1 · arXiv:2404.19737v1. 기술 분석·수치·도판은 2024년 4월 30일 공개된 29쪽의 v1을 기준으로 한다. PDF · ICML 2024 출판 정보.
Abstract: 다음 토큰 하나를 맞히는 대신 여러 미래 토큰을 함께 학습하면 어떤 표현을 얻을 수 있을까? 이 논문은 공유 트랜스포머 위에 독립적인 출력 헤드를 두어 각 미래 위치에 학습 신호를 부여한다. 추가 헤드는 학습 후 버릴 수도 있고, 같은 모델의 첫 헤드가 검증하는 초안 토큰을 만들어 생성 속도를 높이는 데 쓸 수도 있다. 저자들의 코드 실험에서 13B 모델은 MBPP·HumanEval pass@1이 기준선보다 각각 상대 17%·12% 높았다. 별도의 7B 탐욕 디코딩 실험에서는 같은 모델의 단일 헤드 실행 대비 3.05배 가속을 보고했다. 다만 4-token 조건의 가장 작은 0.3B·0.6B 모델에서는 성능이 낮아졌고, 1.3B에서는 지표별 결과가 섞였다. 이 글은 다중 위치의 학습 신호와 메모리 절약 구현을 설명하고, 성능·속도·학습 비용이 각각 어떤 조건에서 측정됐는지 살핀다. 논문 §§2–3, Tables S2·S5·S7
Executive Summary
| 항목 | 설명 |
|---|---|
| 연구 질문 | 같은 규모의 모델에 여러 미래 위치의 학습 신호를 주면 코드 생성 성능과 표본 효율이 개선되는가? |
| 방법 | 공유 트렁크, 독립 출력 헤드 n개, 공유 언임베딩으로 미래 토큰을 예측한다. 같은 규모의 비교에서는 추가 헤드만큼 트렁크 층을 줄여 파라미터 수를 맞춘다. |
| 메모리 구현 | 각 헤드의 순전파·역전파를 차례로 실행해 큰 어휘 로짓을 동시에 보관하지 않는다. 논문의 O(nV+d)\to O(V+d) 설명은 해당 텐서의 점근적 비용이며 GPU 메모리 실측값은 아니다. |
| 코드 결과 | 13B에서 MBPP pass@1은 26.0→30.5, HumanEval은 14.1→15.8이다. 상대 증가율과 percentage-point 차이를 구분해야 한다. |
| 적용 범위 | 4-token 조건의 0.3B·0.6B에서는 손해가, 1.3B에서는 혼합 결과가 나타난다. 자연어 과제와 반복 학습에서도 이득이 일정하지 않다. |
| 추론 가속 | 7B 코드 모델의 4-head 탐욕 디코딩은 batch 42에서 같은 모델의 1-head 실행보다 3.05배 빠르다. 품질 개선 실험과는 별도 조건이다. |
| 비용·평가의 경계 | Table S5의 n=4 학습 시간은 기준선의 1.07~1.22배다. 예측 창 비교에는 시험 점수로 온도를 선택한 조건이 포함된다. |
목차
- 다음 토큰 하나라는 과제의 한계
- 구조와 메모리 기법
- 모델 규모에 따라 달라지는 코드 성능
- n은 몇이어야 하는가
- 사전학습의 이득은 미세조정으로 넘어간다
- 추론은 실제로 빨라진다
- 자연어에서는 그림이 갈린다
- 합성 과제가 보여 주는 기제
- 왜 되는가에 대한 논문의 설명
- 한계, 재현 조건과 결론
1. 다음 토큰 하나라는 과제의 한계
같은 문장을 학습하더라도 어떤 토큰을 목표로 삼는지에 따라 표현에 요구되는 정보가 달라진다. 보통의 다음 토큰 예측은 현재 문맥에서 바로 다음 위치를 맞히면 된다. 다중 토큰 예측은 아직 관측하지 않은 중간 토큰을 건너서 그다음 위치도 맞혀야 하므로, 공유 표현이 더 긴 범위의 선택을 뒷받침하도록 학습 신호를 준다. 논문 §§1–2
이 연구의 기여는 학습 목표·메모리 구현·추론 활용을 연결한 것이다. 여러 미래 위치에 손실을 주고, 헤드를 순차 처리해 메모리를 절약하며, 학습된 추가 헤드를 추론 초안으로 재사용한다. 다중 토큰 예측 자체에는 ProphetNet(Qi et al., 2020) 같은 선행연구가 있다. 따라서 새로 볼 부분은 아이디어의 이름보다, 큰 자기회귀 모델에서 어떻게 구성하고 어느 조건에서 효과를 확인했는가다.
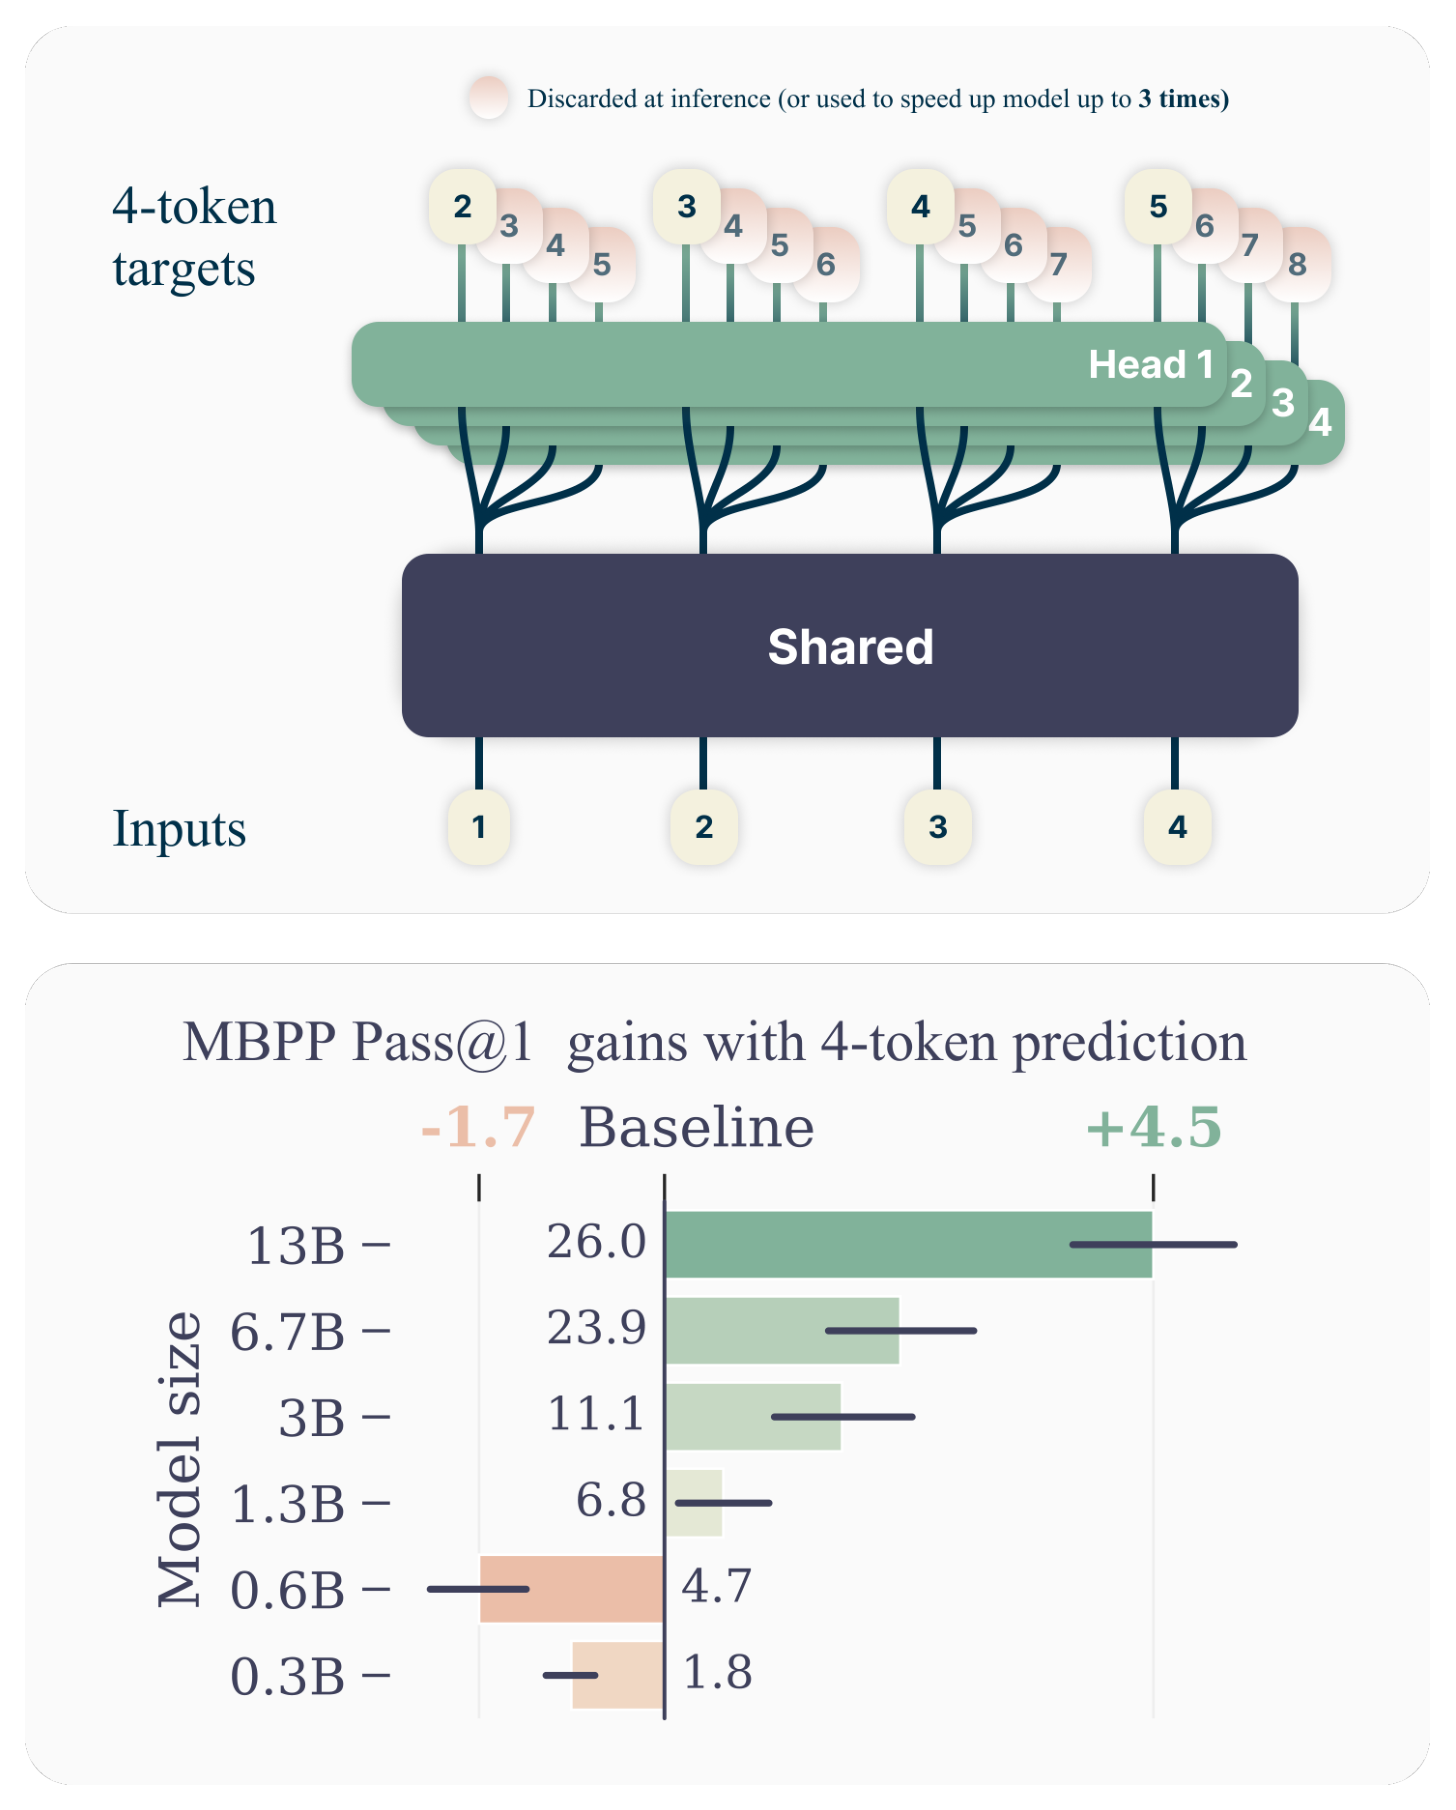
그림 1. 원논문 Figure 1. 위는 공유 트렁크와 여러 미래 위치를 예측하는 헤드, 아래는 4-token prediction의 MBPP pass@1 차이다. 이 지표에서는 0.3B·0.6B의 손해와 더 큰 모델의 이득이 함께 나타난다. 오차막대는 데이터셋 표본 bootstrap 90% 신뢰구간이다. Gloeckle et al. (2024), PDF p. 1. 원본 도판 영역을 직접 추출했다.
2. 구조와 메모리 기법
2.1 같은 문맥으로 서로 다른 미래 위치를 예측한다
위치 t까지의 토큰을 x_{\le t}라 하자. 공유 트렁크 f_s는 이 문맥을 표현 z_t로 바꾸고, 헤드 f_{h_i}는 i칸 뒤의 토큰을 예측한다. 언임베딩 f_u는 헤드의 출력을 어휘별 점수로 바꾸는 공통 행렬이다.
z_t=f_s(x_{\le t}),\qquad
p_{\theta,i}(\cdot\mid x_{\le t})
=\operatorname{softmax}\!\left(f_u(f_{h_i}(z_t))\right).
실제 학습 목적을 헤드별 교차 엔트로피의 합으로 쓰면 다음과 같다. 아래는 논문 §2의 구현을 설명하기 위한 표기이며, 원문의 중간 인수분해 표기를 그대로 복사한 식은 아니다.
\mathcal L_n(\theta)
=-\sum_t\sum_{i=1}^{n}
\log p_{\theta,i}(x_{t+i}\mid x_{\le t}).n=1이면 보통의 다음 토큰 손실이다. n=4이면 같은 문맥에서 다음 위치부터 네 번째 위치까지 각각 맞힌다. 헤드 2는 정답인 다음 토큰을 새 입력으로 받은 뒤 그다음을 맞히는 것이 아니다. 네 헤드가 같은 관측 문맥을 바탕으로 서로 다른 미래 위치를 예측한다. 이 추가 과제가 공유 표현에 더 긴 범위의 정보를 담도록 요구한다. 논문 §2
2.2 헤드를 늘리되 같은 규모의 파라미터 예산은 맞춘다
각 헤드는 트랜스포머 층 하나로 구현된다. 같은 규모에서 n을 비교할 때는 헤드 층을 n-1개 더하는 대신 트렁크 층을 그만큼 줄인다. 따라서 단순히 파라미터를 추가한 모델과 기존 모델을 비교한 결과는 아니다. 다만 파라미터 수가 같다는 사실만으로 학습 시간과 통신 비용까지 같아지는 것은 아니다. 논문 §3
2.3 헤드별 역전파를 먼저 끝내는 이유
어휘 크기를 V, 공유 표현의 차원을 d라 하면, 큰 어휘 로짓과 그 기울기를 모든 헤드에 대해 동시에 보관하는 것이 메모리 병목이 된다. 논문은 헤드별 순전파·역전파를 차례로 끝내고, 공유 표현으로 전달할 기울기만 누적한다.
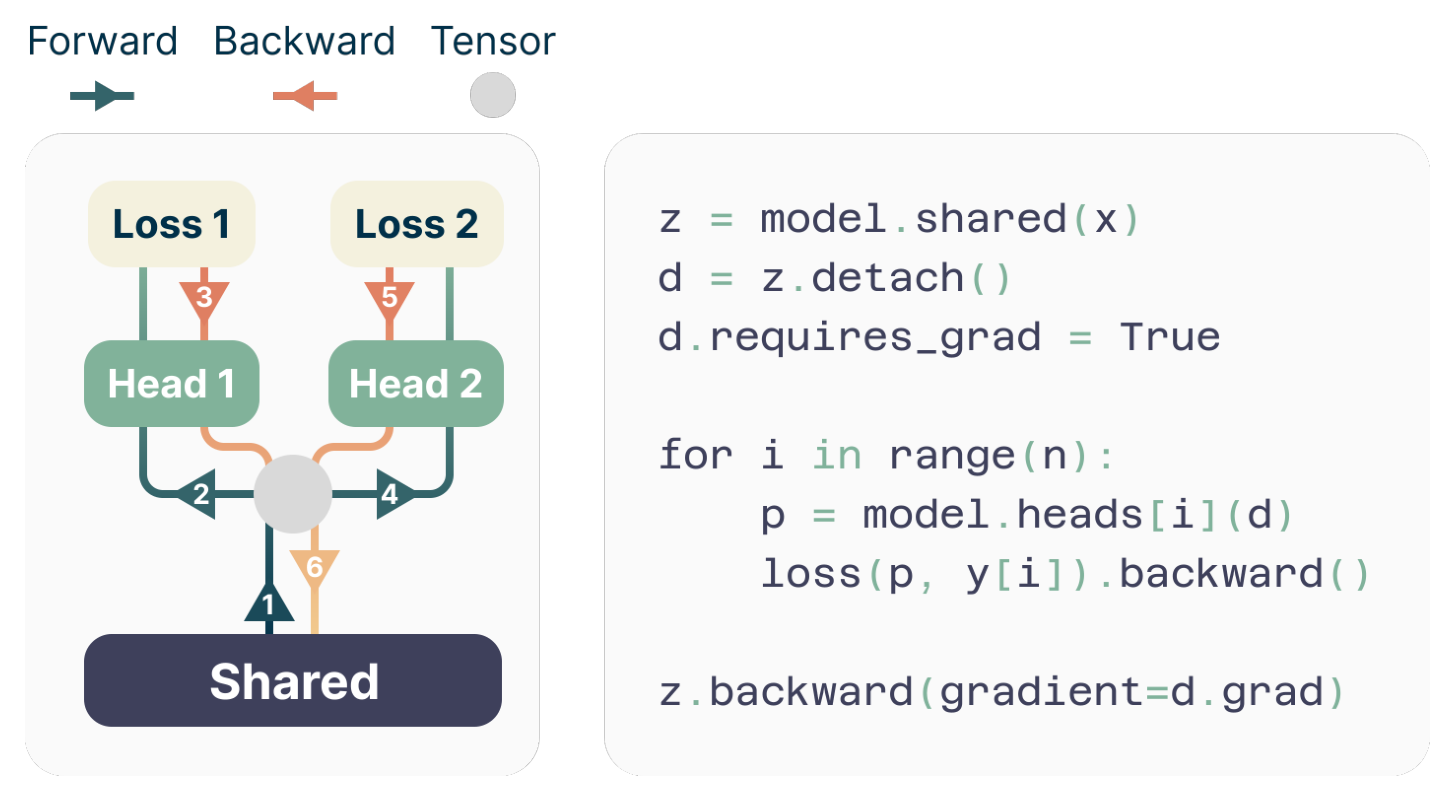
그림 2. 원논문 Figure 2. 공유 트렁크를 한 번 실행한 뒤 각 헤드의 순전파·역전파를 순차 처리하고, 마지막에 누적된 기울기를 트렁크로 전달한다. Gloeckle et al. (2024), PDF p. 3. 원본 도판 영역을 직접 추출했다.
다음은 Figure 2의 실행 순서를 설명하기 위해 재구성한 의사코드다. heads[i]는 해당 헤드와 출력 분포 계산을 포함한다고 놓는다.
z = shared_trunk(tokens)
d = z.detach().requires_grad_(True)

for i in range(n):
    loss_i = cross_entropy(heads[i](d), targets[i])
    loss_i.backward()  # d.grad에 각 헤드의 기울기가 누적된다.

z.backward(gradient=d.grad)
헤드가 하나 끝나면 그 로짓을 다음 헤드까지 보관할 필요가 없다. 이 방식으로 논문이 제시하는 비용은 O(nV+d)에서 O(V+d)로 줄어든다. 이 표기는 로짓과 공유 표현의 지배적인 항을 비교한 것으로, 모델 파라미터·옵티마이저 상태를 포함한 전체 GPU 메모리 실측치와는 구분해야 한다. 공개 v1에는 실제 최대 메모리 사용량을 비교한 수치 표가 없다.
3. 모델 규모에 따라 달라지는 코드 성능
주 실험은 300M부터 13B까지 여섯 규모를 처음부터 학습하고, MBPP와 HumanEval을 문제당 1000샘플로 pass@1/10/100 평가한다.
본문은 학습량을 "최소 91B 토큰"이라는 하한으로만 적지만 부록의 하이퍼파라미터 표에 규모별 값이 실려 있다. 0.3B·0.6B·1.3B·3B는 각 91.0B 토큰(10,850 스텝)이고 6.7B·13B는 각 209.7B 토큰(25,000 스텝)이다. 곧 큰 두 모델은 작은 네 모델보다 2.3배 많은 데이터를 본다. 각 규모 안의 기준선과 다중 토큰 모델은 같은 학습량으로 비교된다. 반면 규모 사이에서는 토큰 수가 달라지므로, Figure 3의 규모별 이득 차이를 모델 크기 하나의 효과로 분리할 수는 없다. 논문 부록 M, Table S13
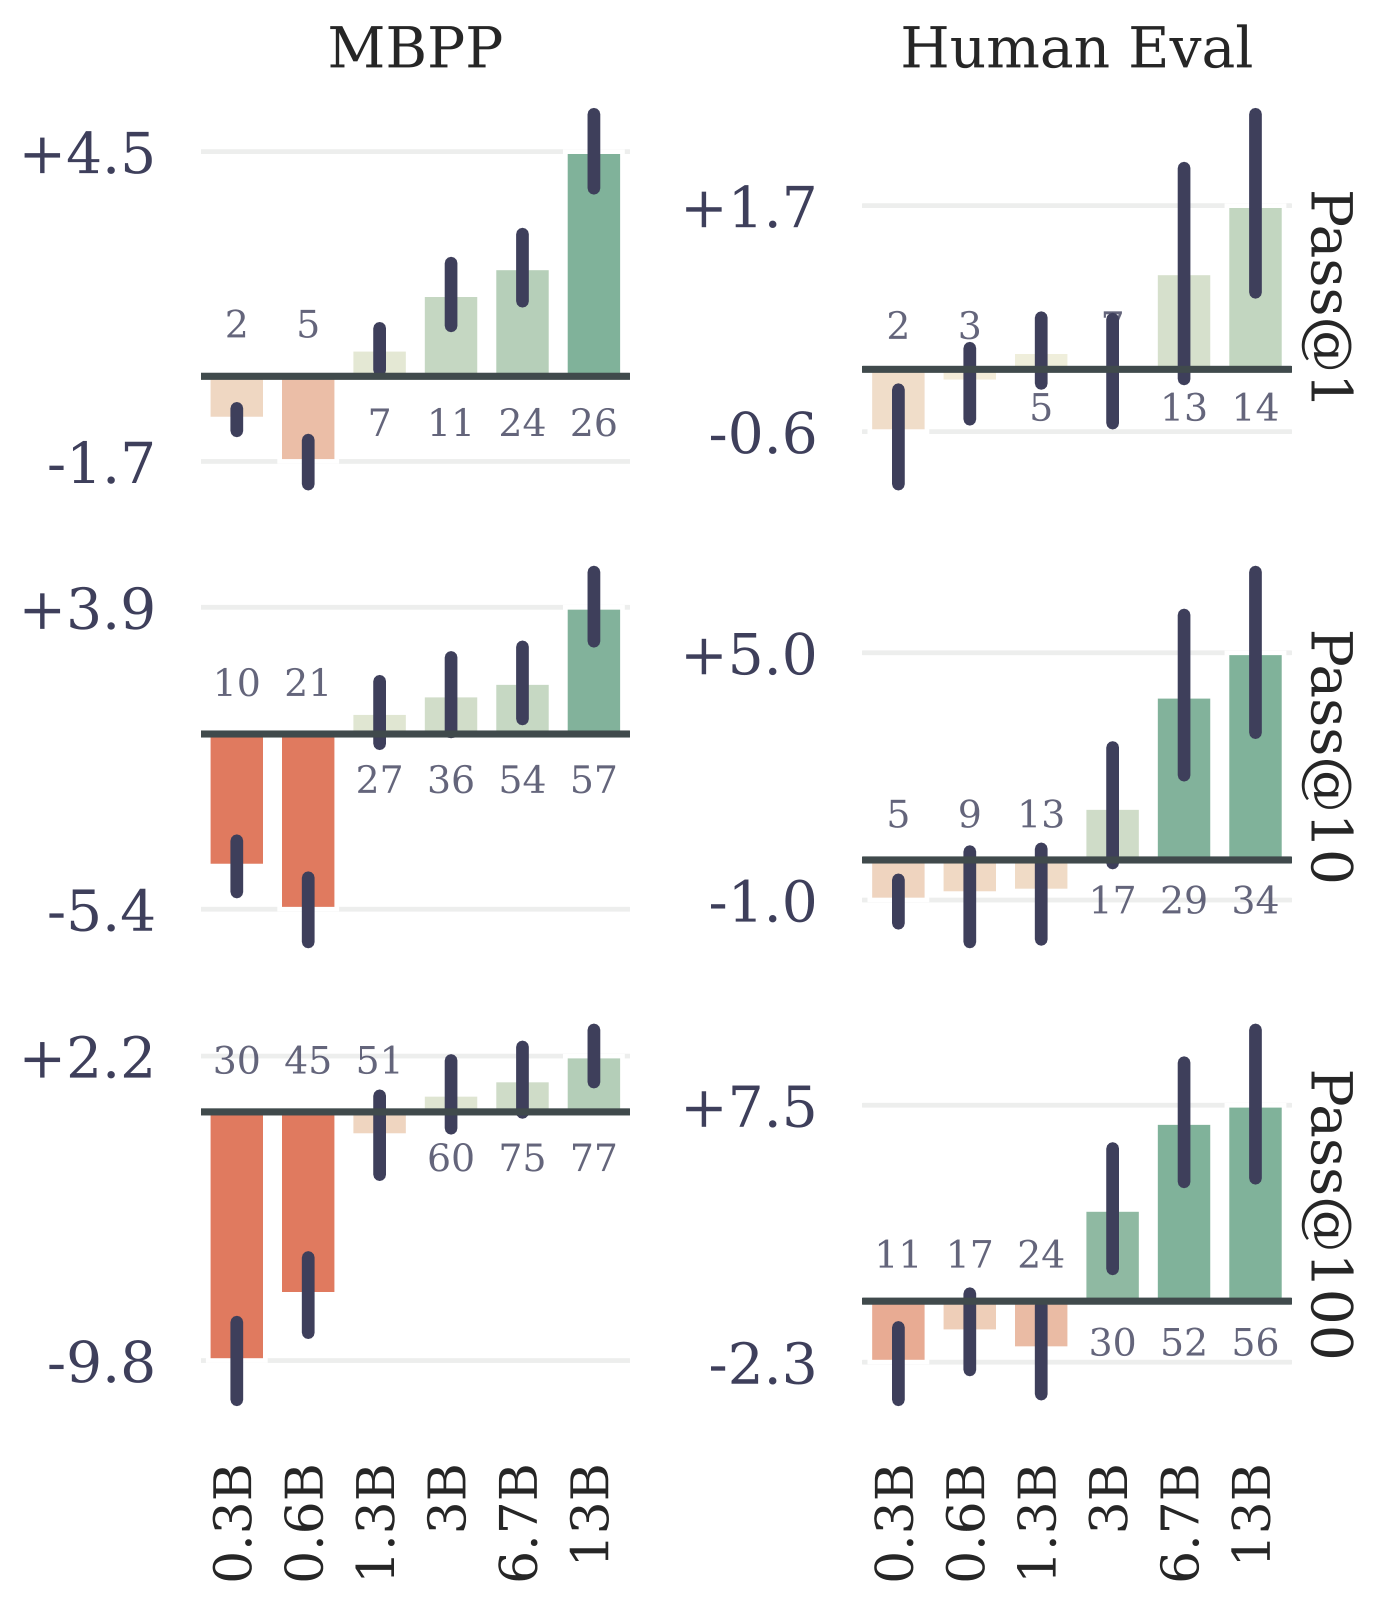
그림 3. 원논문 Figure 3. 여섯 모델 규모에서 MBPP·HumanEval의 pass@1/10/100 차이를 비교한다. 막대는 4-token 모델에서 같은 규모의 기준선을 뺀 값이다. 작은 규모의 손해와 큰 규모의 이득을 함께 읽어야 하며, 패널마다 축 범위가 다르다. 오차막대는 bootstrap 90% 신뢰구간이다. Gloeckle et al. (2024), PDF p. 3. 원본 도판 영역을 직접 추출했다.
Figure 3은 가장 작은 0.3B·0.6B에서 손해가 나타나고, 더 큰 규모에서 이득이 강해지는 경향을 보여준다. 1.3B에는 지표별 증가와 감소가 섞여 있고, 3B의 4-token 모델은 HumanEval pass@1에서 기준선과 동률이다. 따라서 하나의 크기를 모든 지표의 보편적인 성공 경계로 정할 수는 없다. 같은 규모 안의 비교가 학습 목표의 유용성을 지지한다면, 규모 간 곡선은 그 유용성이 학습량과 모델 용량에 함께 의존할 수 있음을 보여 준다. 논문 §3.1, Figure 3 및 Table S7
여기서 두 가지를 정확히 해 둘 필요가 있다.
첫째, 초록의 12%와 17%는 퍼센트 포인트가 아니라 상대 비율이다. Table S7의 13B HumanEval pass@1은 14.1에서 15.8로 +1.7점이며 상대 약 12.1%다. MBPP pass@1의 기준선은 26점, 이득은 +4.5점이고 4.5/26 = 17.3%다. 초록의 "12% more problems on HumanEval and 17% more on MBPP"는 푼 문제 수의 상대 증가라는 뜻에서 문자 그대로 옳다. 다만 절대 폭은 1.7점과 4.5점이다.
둘째, 작은 규모에서의 손해가 큰 규모에서의 이득보다 크다. MBPP pass@100 패널에서 0.3B는 −9.8점이고 13B는 +2.2점이다. 기준선이 30점인 0.3B에서 −9.8점은 상대 33% 저하다. 같은 패널의 최대 이득은 77점 기준 +2.2점, 상대 2.9%다. 여섯 패널의 세로축 범위가 각각 다르게 잡혀 있어 이 비대칭은 도판에서 한눈에 들어오지 않는다. 초록은 "모델 크기가 커질수록 유용해진다"고만 적고 작은 규모에서 나빠진다는 것은 적지 않는데, Figure 3의 캡션과 본문은 그것을 분명히 적는다.
4. n은 몇이어야 하는가
7B 모델을 200B 코드 토큰으로 학습하며 n = 1, 2, 4, 6, 8을 비교한다. 결과는 Table 1에 있고, 같은 표가 바이트 수준(313B 바이트, n = 1, 8, 16, 32)과 4에폭(1T 토큰, n = 1, 4) 설정도 함께 싣는다.
논문이 §3.4에서 보고하는 n=4 대 n=1의 차이는 표에서 그대로 재현된다. MBPP는 +3.8·+2.1·+3.2점, HumanEval은 +1.2·+3.7·+4.1점이고, 여섯 값 모두 표의 두 행을 빼면 정확히 나온다. APPS/Intro에서는 n=6이 앞서 +0.7·+3.0·+5.3점인데 이 세 값도 정확하다. 최적 창 크기가 입력 데이터 분포에 의존할 가능성이 크다는 논문의 해석은 표와 맞는다. 논문 §3.4, Table 1
다만 표기에 걸리는 점이 하나 있다. §3.4의 "+3.8%, +2.1% ..."는 퍼센트 포인트다. 상대로 바꾸면 +3.8점은 30.0 기준 +12.7%가 된다. 같은 논문의 초록이 쓰는 "12% more"와 §3.3이 쓰는 "67% more"는 상대 비율이다. 같은 % 기호가 두 문단 사이에서 다른 뜻으로 쓰인다.
바이트 수준이 가장 크게 이긴다
토큰화 방식에 따라 효과가 어떻게 달라지는지도 평가한다. 7B 바이트 수준 트랜스포머를 314B 바이트(약 116B 토큰에 해당)로 학습한 것이다. Table 1의 행 이름은 같은 실행을 313B 바이트로 적는다. 8-바이트 예측은 다음 바이트 예측 대비 MBPP pass@1을 19.3에서 32.3으로(상대 +67%), HumanEval pass@1을 18.1에서 21.8로(상대 +20%) 올린다. MBPP pass@1의 상대 이득이 특히 큰 설정이다. 그리고 이 8-바이트 모델은 토큰 기반 모델보다 비교한 토큰 모델의 약 1/1.7에 해당하는 학습 데이터로 학습됐는데도 그 성능에 근접한다고 적는다. 논문 §3.3
다만 이 바이트 모델들은 §2의 메모리 기법을 쓰지 않는다. 부록 Table S13의 캡션이 "바이트 수준 모델은 부록 B의 언임베딩 복제 구조를 쓴다"고 적고, 부록 B는 그 구조가 (d, nV) 모양의 행렬을 요구하므로 "대규모 학습에는 감당할 수 없다"고 적는다. 여러 미래 위치를 학습하는 목적은 같지만, 메모리를 처리하는 구현은 다르다. 따라서 이 결과를 공유 언임베딩 구현의 비용까지 입증한 것으로 볼 수 없다. Table S5에는 바이트 모델의 학습 시간 행이 없다. APPS/Intro 쪽 상대 이득이 특히 커 보이는 것도 기준선이 0.1·0.5·2.4로 바닥에 붙어 있기 때문이므로, 상대 비율보다 절대 폭으로 읽는 편이 안전하다. 논문 부록 B · 부록 Table S13
학습량을 인용할 때에는 단위도 구분해야 한다. Table 1의 토큰 실험은 200B 토큰, 바이트 실험은 행 이름의 313B 바이트와 본문·캡션의 314B 바이트가 혼재한다. 여기서는 원문의 차이를 그대로 명시하며 한 값을 임의로 확정하지 않는다.
에폭을 늘리면 이득이 줄고 일부는 뒤집힌다
1T 토큰(4에폭) 설정에서 논문은 MBPP pass@1 +2.4점, HumanEval pass@100 +3.2점이 남고 "나머지는 비슷한 성능"이라고 적는다. 두 수치는 표에서 정확히 재현된다. 나머지 일곱 지표를 모두 빼 보면 n=4는 HumanEval pass@1에서 −0.1, pass@10에서 −0.3, APPS/Intro 세 지표에서 −1.1·−2.2·−0.4로 아홉 중 다섯에서 기준선보다 낮다. HumanEval 쪽 두 값은 "비슷하다"고 부를 만한 폭이지만 APPS/Intro pass@10의 −2.2점은 17.8점 기준 상대 12% 저하다. 논문은 APPS에 대해 "창 크기 4는 200B 토큰에서도 이미 최적이 아니었다"고 따로 적어 이 방향을 인정한다. 논문 §3.5
한 가지 더. Table 1의 모든 수치는 문제당 200샘플로 추정됐고, 설정마다 시험 점수를 보고 고른 온도에서 나왔다. 캡션이 둘 다 적는다. 선택된 온도 자체는 부록 Table S12에 설정별로 실려 있다. Figure 3의 규모 실험이 1000샘플에 90% 신뢰구간을 붙이는 것과 달리 Table 1에는 오차 표시가 없으므로, n=4와 n=6을 가르는 APPS/Intro pass@1의 1.6 대 3.5 같은 차이를 읽을 때 이 비대칭을 함께 읽어야 한다. 논문 Table 1 · 부록 Table S12
5. 사전학습의 이득은 미세조정으로 넘어간다
사전학습 때 얻은 이득을 다음 토큰 방식의 미세조정으로도 가져갈 수 있는가? 저자들은 CodeContests에서 사전학습 손실과 미세조정 손실을 나누어 비교한다. n은 사전학습의 예측 창, n'는 미세조정의 예측 창이다.
| 조건 | 사전학습 | 미세조정 |
|---|---|---|
| 기준선 | 다음 토큰 예측 | 다음 토큰 예측 |
n=4,n'=4 |
4-token prediction | 추가 헤드를 유지한 4-token prediction |
n=4,n'=1 |
4-token prediction | 추가 헤드를 제거한 다음 토큰 예측 |
§3.6의 모델 출처 절 번호는 인접 설명과 일치하지 않는다. 다만 이어지는 설명과 Figure 4 범례는 위의 세 조건을 명시한다. 여기서는 그 조건을 기준으로 해석한다. 논문 §3.6
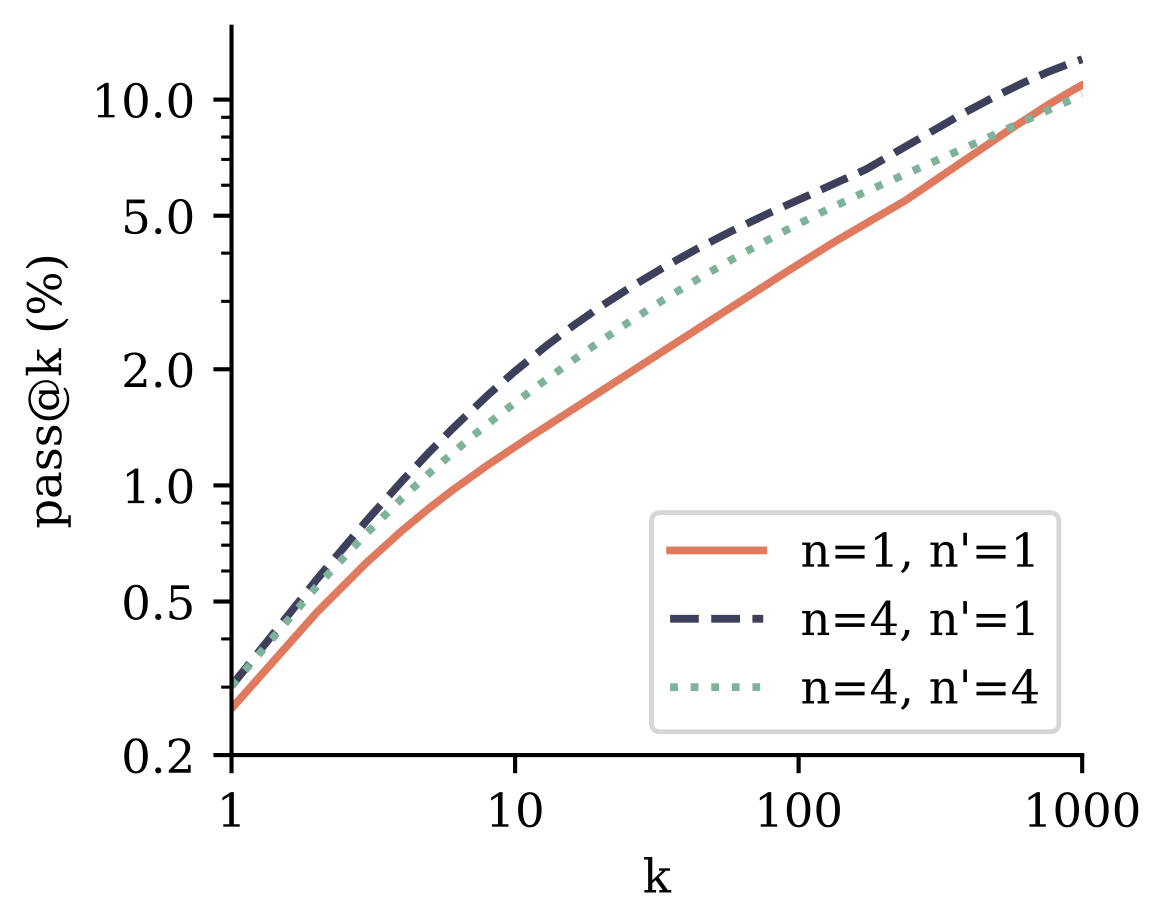
그림 4. 원논문 Figure 4. CodeContests 미세조정에서 추가 헤드를 제거한 다음 토큰 방식이 가장 높은 곡선을 보인다. 그림에서 읽은 k=1000의 근삿값은 해당 조건 12.7%, 기준선 10.9%, 4-token 미세조정 10.3%다. 두 다중 토큰 사전학습 조건이 모든 k에서 기준선을 이기는 것은 아니다. Gloeckle et al. (2024), PDF p. 5. 원본 도판 영역을 직접 추출했다.
논문이 적는 결과는 두 가지다. 4-토큰 사전학습 모델을 미세조정하는 두 방식 모두가 기준선을 pass@k 전 구간에서 이기고, 그중 헤드를 떼고 다음 토큰 손실로 미세조정한 쪽이 전체 최선이라는 것이다. 뒤의 것은 도판과 맞지만 앞의 것은 끝에서 어긋난다. 좌표로 복원하면 n=4·n′=4는 수백 구간에서 기준선에 따라잡혀 k=1000에서 10.3% 대 10.9%로 아래에 놓인다. "전 구간에서"가 성립하는 것은 n′=1 쪽뿐이다. 논문은 이를 보조 과제로 사전학습한 뒤 과제별로 미세조정하는 고전적 틀에 부합한다고 읽는다. 배포 구조를 바꾸지 않고도 사전학습의 이득을 가져갈 수 있다는 뜻이므로, 이 방법을 실제로 쓰려는 쪽에는 §3.1의 규모 곡선만큼 중요한 결과다.
평가 조건은 짚어 둘 필요가 있다. 시험 문제마다 온도 다섯 종에서 1000샘플을 뽑고 k마다 온도에 대한 최댓값을 취한다. 곧 온도 오라클을 한 번 더 허용한 설정이고, 논문은 캡션에 그렇게 적는다. 논문 §3.6 · 부록 F
6. 추론은 실제로 빨라진다
6.1 초안 생성과 검증을 같은 모델이 담당한다
일반적인 추론에서는 첫 헤드만 사용해 토큰을 하나씩 생성한다. Self-speculative decoding에서는 추가 헤드가 여러 미래 토큰을 제안하고, 첫 헤드의 자기회귀 예측으로 그 제안을 검증한다. 탐욕적 예측과 일치하는 연속 구간을 받아들이고, 불일치한 부분은 그대로 출력하지 않는다. 논문은 이 blockwise 절차를 xFormers로 구현했다. 논문 §2, §3.2
이때 출력 일치의 기준은 같은 다중 토큰 모델의 첫 헤드로 수행한 탐욕 디코딩이다. 별도로 학습한 다음 토큰 기준선과 같은 답을 낸다는 뜻은 아니다. 또한 논문이 속도를 측정한 것은 탐욕적 실행이므로, 수치를 임의의 sampling 설정으로 확대하지 않는다.
6.2 속도 수치의 비교 조건
| 평가 데이터 | 사용 헤드 수 | 배치 크기 | 같은 모델의 1-head 실행 대비 가속 | 순전파당 수용 토큰·바이트 |
|---|---|---|---|---|
| 코드 | 4 | 42 | 3.05배 | 3.50토큰 |
| Wikipedia | 4 | 42 | 2.74배 | 3.12토큰 |
| 책 | 4 | 42 | 2.67배 | 3.09토큰 |
| 바이트 수준 코드 | 8 | 16 | 6.39배 | 7.04바이트 |
논문 Tables S2–S3. 모두 7B 모델의 탐욕적 실행 결과다. 코드 모델은 1T 토큰, 자연어 모델은 500B 토큰으로 학습됐다. 부록 A.
코드의 3.50토큰은 첫 헤드의 한 토큰에 추가 제안 세 개 중 평균 2.50개가 수용됐다는 뜻이다. 추가 헤드가 항상 정답을 내는 것은 아니어도, 검증을 통과하는 연속 구간이 길면 큰 공유 트렁크를 실행하는 횟수를 줄일 수 있다.
부록 A의 배치 크기 1~42 실험에서는 4-head 상대 처리량이 약 3.05~3.16으로 거의 일정하다. 이는 평가한 범위의 근거이며 더 큰 배치나 다른 하드웨어의 서빙 성능을 직접 입증하지는 않는다. 32-byte 모델의 32-head 설정에는 10.84배 가속도 보고되지만, 더 큰 예측 창의 속도와 코드 정답률을 별도로 봐야 한다. 논문 Table S3
7. 자연어에서는 그림이 갈린다
7B 모델을 200B 자연어 토큰으로 학습한 결과는 코드 실험과 같지 않다. Figure 5의 평균 정확도 곡선에서는 4-token prediction이 다음 토큰 기준선보다 낮게 끝난다. 다만 평균을 구성하는 벤치마크 수가 본문·부록·캡션에서 6·7·8로 다르게 제시되어, 집계 대상은 추가 확인이 필요하다. 아래 도판은 저자가 보고한 평균의 경향으로 읽는다. 논문 §3.7 · 부록 G
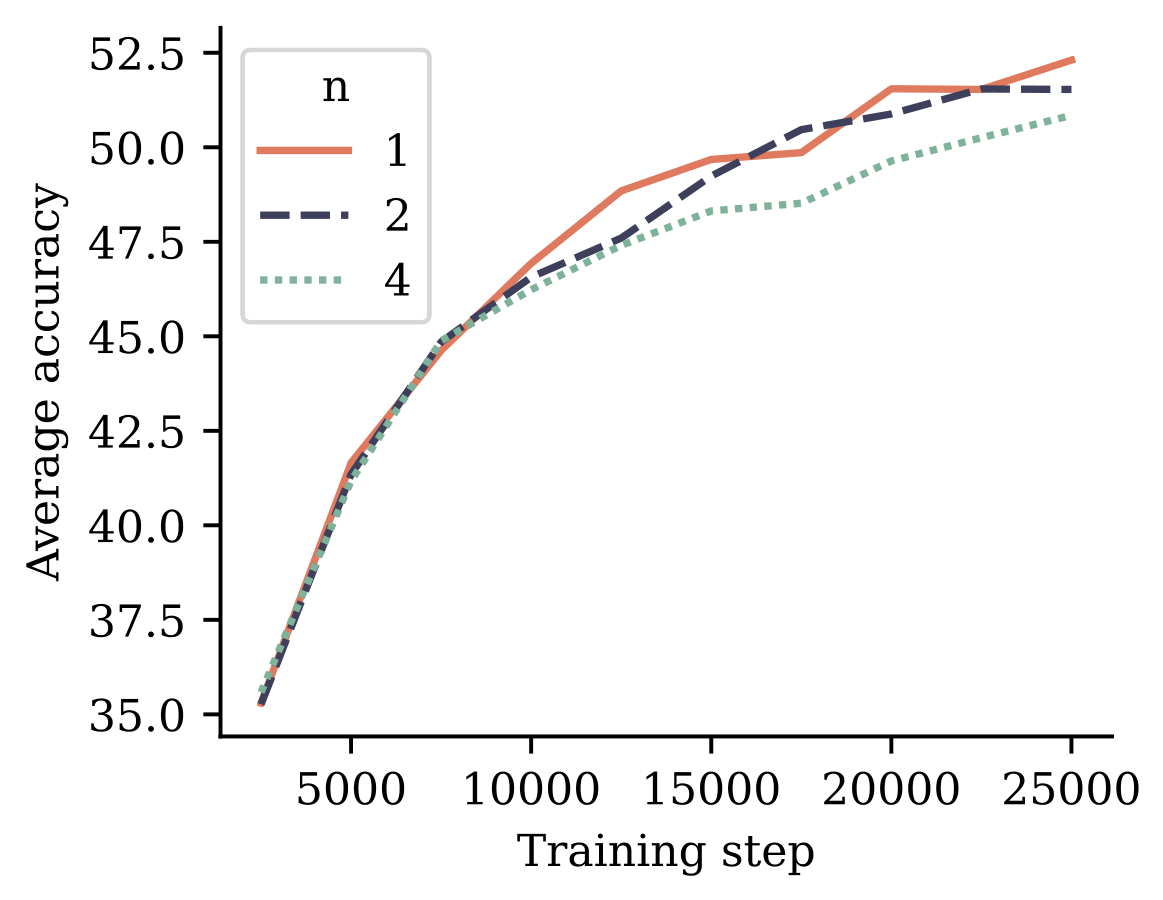
그림 5. 원논문 Figure 5. 자연어 평가에서는 4-token 모델의 평균 정확도가 기준선보다 낮게 끝난다. v1의 본문·부록 사이에 평가 대상 수의 표기 차이가 있어, 평균의 정확한 구성은 확정하지 않는다. Gloeckle et al. (2024), PDF p. 5. 원본 도판 영역을 직접 추출했다.
도판 끝점은 기준선 약 52.3, 2-token 모델 약 51.5, 4-token 모델 약 50.8이다. 그림에서 읽은 근삿값이므로 그 차이만으로 통계적 유의성을 판단할 수는 없다. 저자들은 이런 객관식·우도 기반 평가 외에 생성 능력을 살피기 위해 요약과 수학 과제도 평가한다. 연구를 읽을 때에는 한 종류의 평균을 전체 언어 능력으로 대표시키기보다 과제별 양상을 비교하는 편이 유용하다. 논문 §3.7
요약 실험은 사전학습 모델을 그대로 평가한 zero-shot 비교가 아니다. 각 모델을 여덟 요약 데이터셋의 학습 분할에서 각각 3에폭 미세조정하고 검증 점수가 가장 좋은 체크포인트를 선택한다. 아래 평균은 이 과제별 적응 뒤의 결과다. 논문 Figure 6, 부록 H
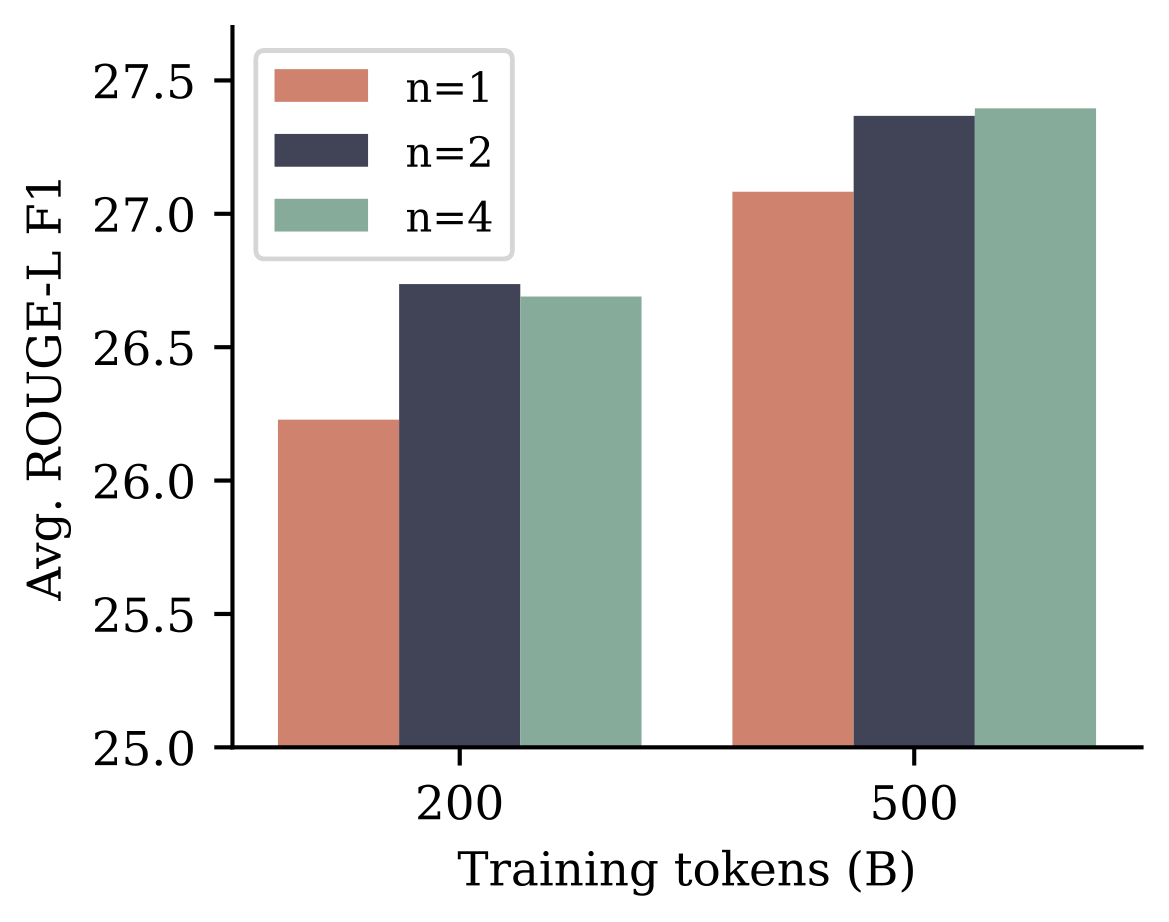
그림 6. 원논문 Figure 6. 여덟 요약 데이터셋의 평균 ROUGE-L F1이다. Table S9 기준으로 다중 토큰 모델이 평균에서 앞서지만, 이득은 약 0.3~0.5점이고 개별 데이터셋에서는 퇴보도 있다. 세로축이 25에서 시작하므로 막대 높이만으로 효과 크기를 판단하지 않는다. Gloeckle et al. (2024), PDF p. 6. 원본 도판 영역을 직접 추출했다.
요약에서는 여덟 데이터셋 평균으로 n=2와 n=4가 둘 다 기준선을 넘고, 논문이 적는 대로 학습 데이터가 커지면 격차가 줄어든다. 절대 폭은 ROUGE-L F1 0.3~0.5점이다. 다만 개별 데이터셋에서는 부호가 갈린다. 부록 Table S9에서 WikiSummary는 200B의 n=4에서 −0.28, 500B에서 n=2 −0.17·n=4 −0.99이고 SAMSum도 500B의 n=2에서 −0.10이다. 이어지는 Table S10은 500B에서 n=4가 재현율 계열에 강하고 정밀도 계열에서는 기준선보다 낮다는 것을 캡션에 따로 적는다. 논문 부록 H, Table S9·S10
수학에서는 방향이 한 번 더 뒤집힌다. GSM8K를 8-shot으로 평가한 부록 I에서, 200B 토큰 시점에는 n=2가 기준선을 뚜렷이 앞서지만 500B 토큰에서는 순서가 뒤집히고 n=4는 전 구간에서 더 나쁘다. 논문은 이를 뒤에 나올 유도 실험과 같은 기제로 읽는다. 이 영역에서 올바른 연쇄 사고 회로가 일단 형성되고 나면 "다중 토큰 예측은 비용이 된다"는 것이다. 논문 §3.7 · 부록 I
8. 합성 과제가 보여 주는 기제
무엇이 이 개선을 만드는지 보려고 논문은 통제된 소규모 실험으로 간다.
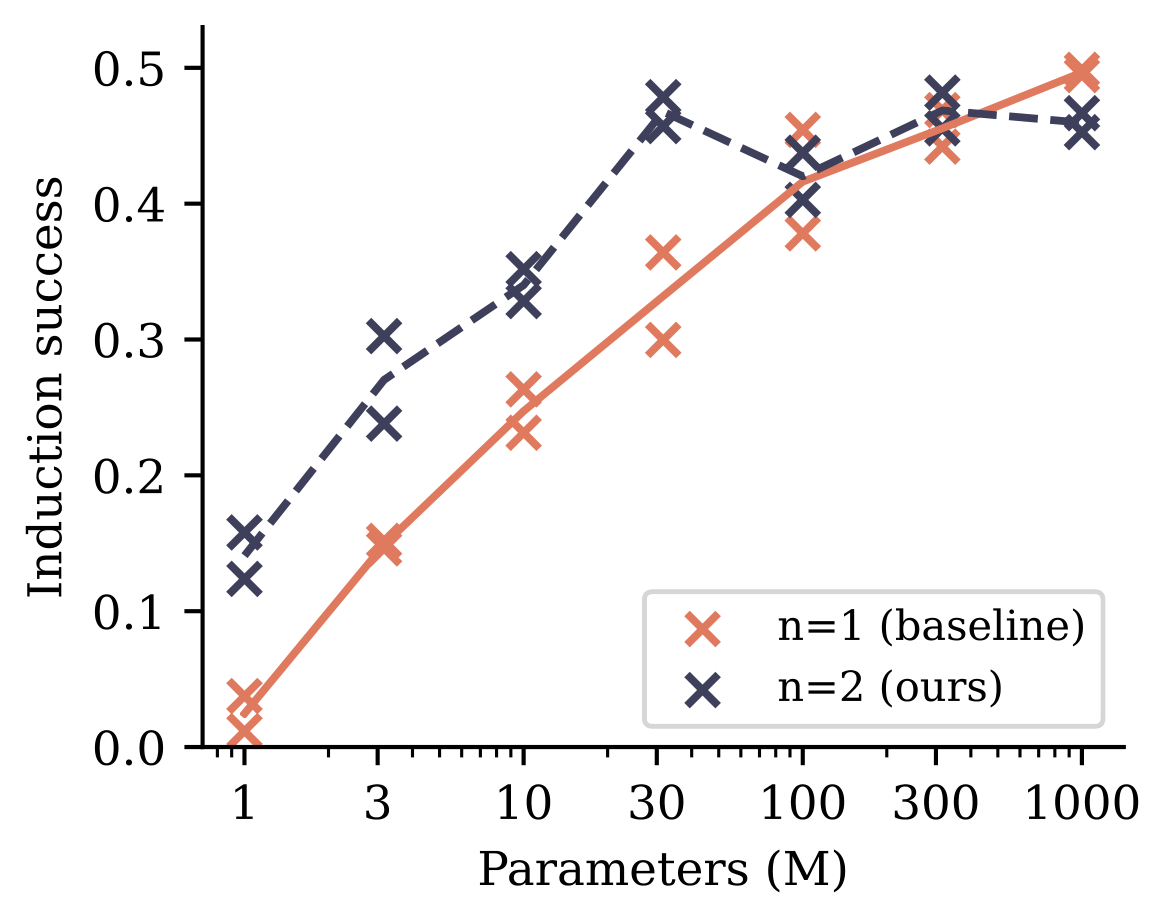
그림 7. 원논문 Figure 7. 작은 모델에서 2-token prediction의 유도 성공률이 높지만, 모델이 커지면 우위가 줄고 가장 큰 설정에서는 역전된다. 표식은 독립적인 두 실행, 선은 그 평균이다. 이 제한된 과제의 결과를 모든 추론 능력으로 일반화하지 않는다. Gloeckle et al. (2024), PDF p. 6. 원본 도판 영역을 직접 추출했다.
유도(induction)는 "AB"가 나온 뒤 "A"가 다시 나오면 "B"를 예측하는 패턴이다. 논문은 동화 데이터셋으로 1M~1B 비임베딩 파라미터 모델을 학습하고, 시험 분할 100개 이야기에서 등장인물 이름을 두 토큰짜리 무작위 이름으로 바꿔 두 번째 토큰의 정확도를 잰다. 결과는 30M 이하에서 2-토큰 예측이 유도 능력 형성을 크게 개선하고, 100M 이상에서는 그 우위가 사라진다는 것이다.
저자들은 이 역전을 다음과 같이 해석한다. 유도 능력이 일단 형성되면 그 특징들이 유도를 현재 토큰에서 국소적으로 풀 수 있는 과제로 바꾸어 놓으며, 그 시점부터 다중 토큰 예측은 이 제한된 벤치마크에서 실제로 해가 된다고 적는다. 그리고 부록에서 책과 동화 데이터를 9:1 비율로 섞은 설정에서는 가장 작은 두 모델을 빼고 다중 토큰 예측의 이점이 사라진다는 것을 보인다. 자기 결과의 범위를 스스로 좁히는 대목이다. 학습은 최대 90에폭까지 돌리고 시험 지표에 대해 조기 종료하는데, 논문은 이를 에폭 오라클을 허용한 것이라고 명시한다. 논문 §4.1
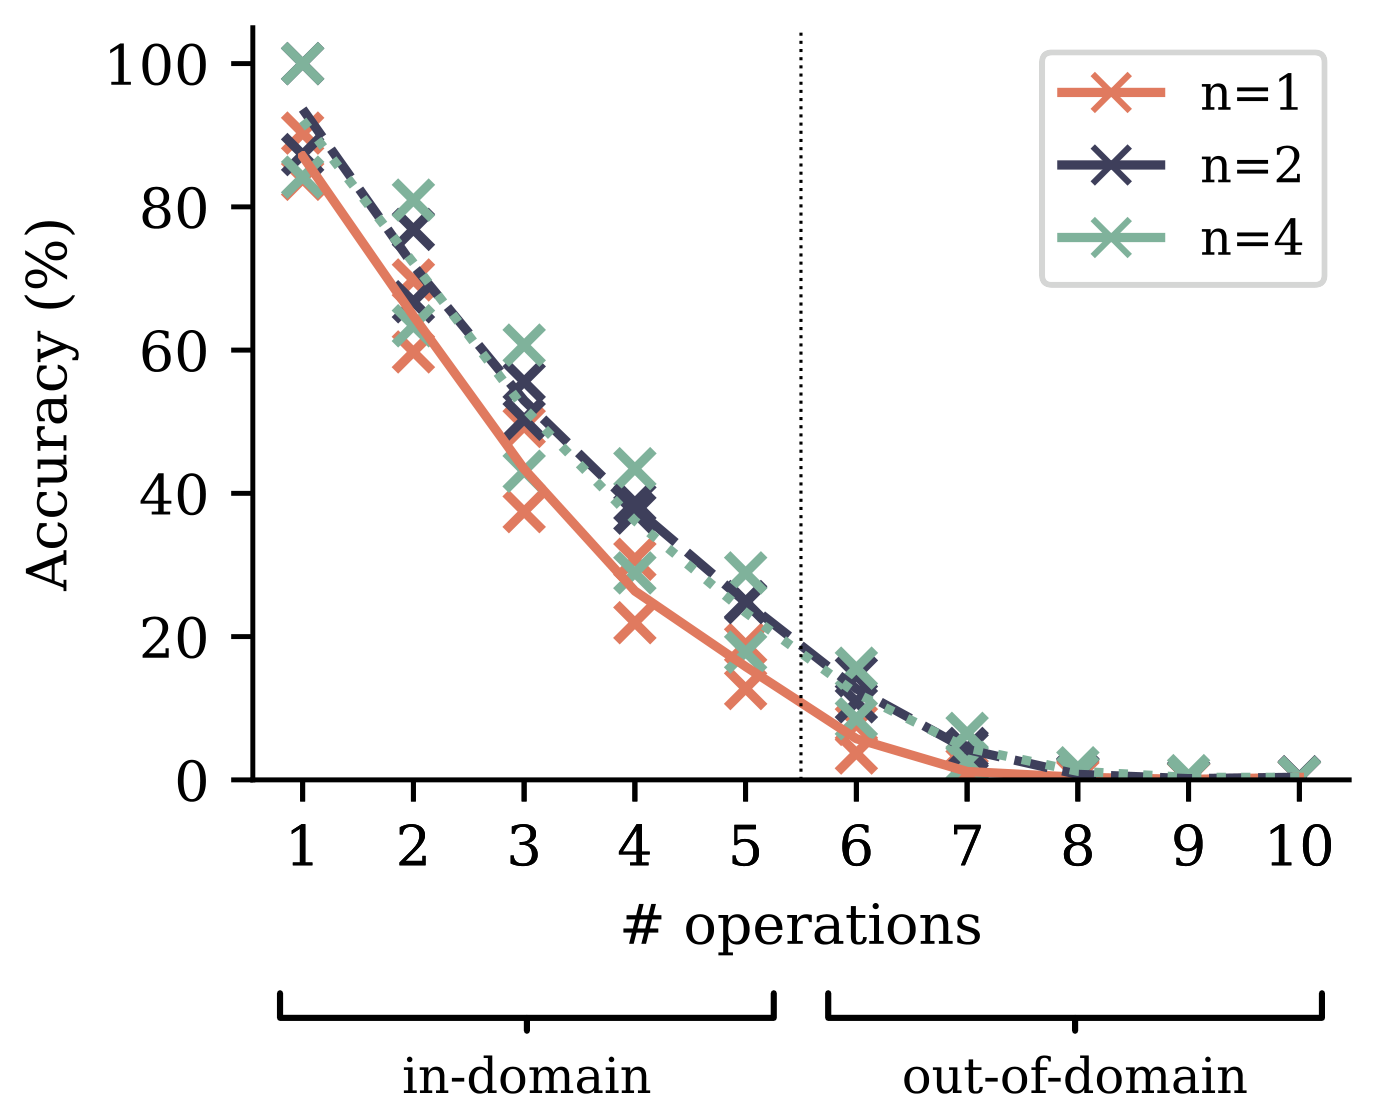
그림 8. 원논문 Figure 8. 100M 모델의 다항식 산술 정확도다. 학습에 포함되지 않은 연산 수 6 이상에서도 다중 토큰 조건이 일부 앞서지만, 연산 수가 더 늘면 세 조건 모두 낮은 정확도로 수렴한다. 각 조건은 두 독립 실행을 포함한다. Gloeckle et al. (2024), PDF p. 7. 원본 도판 영역을 직접 추출했다.
다항식 산술 과제는 \mathbb F_7[X]/(X^5) 환에서 단항 부정·덧셈·곱셈·합성을 섞은 식의 계수를 맞히는 것이다. 학습 때 연산 수는 1~5에서 균등 추출하므로 6 이상이 분포 밖이다. 30M과 100M 두 크기로 학습하는데, 논문은 이것이 대규모 말뭉치로 학습되는 대형 언어모델처럼 파라미터가 부족해 학습 데이터를 통째로 외울 수 없는 조건을 모사한다고 적는다.
결과는 두 갈래다. 다중 토큰 예측이 난이도 전 구간에서 정확도를 올리고, 특히 분포 밖 일반화에서 큰 이득을 낸다. 그리고 모델 크기를 30M에서 100M으로 약 3.3배 키우는 것보다 다음 토큰 예측을 다중 토큰 예측으로 바꾸는 쪽의 효과가 크다. 다만 논문 자신이 "절대 수치가 낮음에도 불구하고"라는 단서를 붙인다. 분포 밖 이득은 6%에서 13%로 가는 종류이고, 연산 8개 이상에서는 세 조건이 모두 0에 붙는다. 논문 §4.2
9. 왜 되는가에 대한 논문의 설명
논문 §5의 제목은 "Why does it work? Some speculation"이다. 저자들이 제안하는 가설을 다루는 절이다. 직관은 하나다. 다중 토큰 예측이 학습 때의 교사 강요와 추론 때의 자기회귀 생성 사이의 분포 불일치를 완화한다는 것이다.
첫째 논거는 선택 지점의 가중치다. 모든 토큰 결정이 똑같이 중요하지는 않다. 어떤 토큰은 문체 변형을 허용하고, 어떤 토큰은 텍스트의 상위 의미를 결정하는 선택 지점이다. 선택 지점 뒤에 오는 무해한 전이들도 미리 예측하기는 어려우므로, 선택 지점은 그 상관물을 통해 손실에 여러 번 나타난다. 논문은 n-토큰 예측이 선택 지점에 n(n+1)/2의 가중치를, 무해한 지점에 n의 가중치를 할당한다고 적는다. 부록의 유도를 보면 n-단계 예측 모델은 그런 선택 지점과 그 결과에 대해 1+…+n = n(n+1)/2개의 손실 항을 받고, 무해한 전이는 n배만큼만 강화되므로, 선택 지점이 평균 (n+1)/2배 더 중요해진다는 계산이다. n=4면 10 대 4, 곧 2.5배다. 논문 §5.1 · 부록 L.3
둘째 논거는 정보이론적 분해다. X를 다음 토큰, Y를 그다음 토큰이라 할 때 다음 토큰 예측은 H(X)를, n=2의 다중 토큰 예측은 H(X)+H(Y)를 겨눈다. 이를 분해하면
H(X)=H(X\mid Y)+I(X;Y),H(X)+H(Y)=H(X\mid Y)+2I(X;Y)+H(Y\mid X).두 식은 엔트로피와 상호정보의 표준 항등식이다. 다음 위치에서 다시 나타나는 조건부 엔트로피 H(Y\mid X)를 제외해 비교하면, 2-토큰 예측이 상호정보 I(X;Y)의 비중을 두 배로 올린다는 결론이 나온다. 곧 이후 텍스트와 관련이 큰 토큰 X를 더 정확히 예측하게 된다는 것이다. 논문 §5.2
셋째 가설은 부록에 따로 있고, 논문은 그것을 확증하지 못했다고 적는다. 다중 토큰 예측이 인접 위치 사이의 정보 공유, 나아가 계산 자원 배분을 더 쉽게 배우게 한다는 계산 공유 가설이다. 논문은 다항식 산술 과제에 일시정지 토큰(Goyal et al., 2023)을 넣어 이를 시험했고, 다중 토큰 모델이 여전히 앞서지만 그 격차가 넓어지지도 좁아지지도 않으므로 "이 실험들로는 계산 공유 가설의 진위를 결론지을 수 없다"고 적는다. HumanEval·MBPP 프롬프트에 공백과 개행을 넣은 표에서도 n=4의 이점은 평균 +0.14점이고 여섯 행 중 셋은 음수다. 논문 부록 K
앞의 두 설명은 단순화된 모형 위의 논거이며, 논문은 절 제목과 본문에서 그 지위를 분명히 한다. 부록 L.3도 "완성형 모델에는 명시적 보상이 없으며 이 논증은 선택 지점이 무엇을 뜻하는지 예시하려는 것일 뿐"이라고 적는다.
10. 한계, 재현 조건과 결론
10.1 학습 시간과 메모리는 별도로 평가해야 한다
추론 가속과 학습 비용은 다른 측정이다. 논문은 초록과 §2에서 학습 시간 오버헤드가 없다고 설명하지만, Table S5의 실제 구현은 모든 설정에서 다음 토큰 기준선보다 느리다.
| 모델 규모 | n=2의 상대 학습 시간 |
n=4의 상대 학습 시간 |
|---|---|---|
| 0.3B | 1.07 | 1.22 |
| 0.6B | 1.05 | 1.13 |
| 1.3B | 1.04 | 1.12 |
| 3B | 1.02 | 1.07 |
| 6.7B | 1.02 | 1.07 |
| 13B | 1.04 | 1.09 |
논문 Table S5. 같은 규모의 다음 토큰 기준선을 1.00으로 둔다. 부록 C.
측정된 증가는 n=2에서 2~7%, n=4에서 7~22%다. 저자들은 파라미터를 여러 장치에 나눠 학습하는 FSDP(Fully Sharded Data Parallel) 구현에서 통신과 연산을 충분히 겹치지 못한 탓이며 재구현으로 제거할 수 있다고 설명한다. 따라서 두 사실을 함께 남겨야 한다. 공개된 실행에는 추가 시간이 있었고, 그 비용이 방법에 필연적으로 내재한다고 입증된 것은 아니다. 구현 개선으로 사라졌다는 후속 측정도 이 판본에는 없다.
메모리의 O(V+d) 설명은 유용한 설계 논증이지만, GPU 메모리 사용량 표를 대신하지는 않는다. 바이트 실험은 언임베딩 복제 구현을 사용하므로 별도의 비용 측정이 필요하다. 논문이 공개한 전체 연구의 약 50만 GPU 시간과 약 50 tCO2eq 배출 추정치는 연구 전체 규모의 정보이며, 개별 설정의 공정한 계산 예산 비교값으로 사용할 수 없다. 논문 Impact Statement
10.2 성능 이득의 조건
| 관측 또는 설정 | 해석 범위 |
|---|---|
| 작은 코드 모델에서 퇴보하고 중간 규모는 혼합 결과 | 다중 토큰 손실을 모든 모델에 유리한 기본값으로 볼 수 없다. |
| 규모별 학습량이 91.0B와 209.7B 토큰으로 다름 | 같은 규모의 MTP/기준선 비교는 유지되지만, 규모 간 이득 차이는 모델 크기만의 효과가 아니다. |
| Table 1은 시험 점수로 온도를 선택 | 최적 예측 창은 해당 평가 프로토콜의 결과다. 별도 검증 집합으로 선택한 배포 정책과 구분한다. |
| CodeContests 미세조정도 온도별 최댓값을 보고 | 높은 pass@k를 실사용 단일 설정의 정답률로 옮기지 않는다. |
| 1T 토큰 반복 학습과 GSM8K에서 일부 순위 역전 | 학습량을 늘려도 이득이 같은 방향으로 누적되지는 않는다. |
| Llama 2에 다중 토큰 손실을 추가한 미세조정에서 유의한 개선을 얻지 못함 | 처음부터 학습한 결과를 기존 체크포인트의 손실 변경에 그대로 적용하기 어렵다. |
위 한정은 원문의 결과·설정에서 나온다. 특히 단순히 ‘최대 3배 빠르고 17% 더 정확하다’고 묶으면, 서로 다른 모델 크기·학습량·비교 기준의 결과를 하나의 실험처럼 보이게 만든다. 품질은 학습 목적을 바꾼 모델끼리, 추론 속도는 같은 모델의 여러 헤드 활용 여부를 바꿔 비교한 결과다. 논문 §§3.1–3.7, 부록 D
10.3 공개 자료와 재현 범위
이 글이 기준으로 삼은 v1에는 코드·체크포인트 공개를 안내하는 문구가 없다. 이는 이후 공개된 자료까지 없다는 주장은 아니다. 분석에는 v1의 본문·부록·제공된 도판을 사용했고 모델을 다시 학습하거나 벤치마크를 재실행하지 않았다.
v1에서 확인하기 어려운 항목은 학습 데이터의 구체적 구성, 실제 최대 GPU 메모리, Table S5의 세부 하드웨어·병렬화·반복 측정 조건, Figure 5 평균의 정확한 벤치마크 구성이다. 반면 규모별 토큰 수와 Table 1의 선택된 온도는 각각 Table S13과 Table S12에 제시되어 있으므로 미공개 항목으로 취급하지 않는다.
10.4 적용을 검토할 때의 질문
- 대상 모델과 데이터에서 예측 창을 늘렸을 때 실제 검증 성능이 개선되는가?
- 비교 모델의 파라미터 수뿐 아니라 학습 토큰·실제 시간·메모리를 함께 기록했는가?
- 예측 창과 온도는 시험 집합과 분리된 데이터에서 선택했는가?
- 추측 디코딩은 같은 첫 헤드의 탐욕적 출력을 보존하며, 목표 하드웨어와 배치에서 실제 가속되는가?
- 추가 헤드를 제거한 다음 토큰 미세조정으로도 사전학습 이득이 유지되는가?
10.5 결론
다중 토큰 예측의 핵심은 현재 문맥이 여러 미래 위치를 설명하도록 학습하고, 그때 얻은 추가 헤드를 추론에도 활용하는 것이다. 공유 트렁크와 헤드별 순차 역전파는 이 목적을 큰 어휘 모델에 적용하기 위한 구현이고, self-speculative decoding은 같은 학습 산출물을 재사용하는 별도 경로다.
저자들의 실험은 큰 코드 모델의 성능 개선과 탐욕적 생성 가속을 보여 준다. 동시에 작은 모델의 퇴보, 자연어 과제의 혼합 결과, 반복 학습에서의 이득 감소도 드러낸다. 따라서 이 연구에서 가져갈 설계는 모든 환경에 공통으로 적용되는 우위가 아니라, 모델 용량·데이터·예측 창에 맞춰 보조 학습 신호와 실행 비용을 함께 평가하는 방법이다.
학습 오버헤드는 별도로 남는 확인 과제다. 논문이 측정한 구현에서는 추가 시간이 있었지만 저자들은 개선 가능성을 제시한다. 기여를 인정하면서도 이 측정과 전망을 나누어 읽을 때, 품질 개선과 추론 가속을 어느 조건에서 기대할 수 있는지가 더 분명해진다.
원논문 Figures 1–8의 제공된 도판 영역을 그대로 사용하고 한국어 해설을 다듬었다. 원본 그래프·축·수치는 변경하지 않았다. 기술적 분석은 arXiv v1을 기준으로 하며, 독립 재실험 결과가 아니다.
References
Gloeckle, F., Youbi Idrissi, B., Rozière, B., Lopez-Paz, D., & Synnaeve, G. (2024). Better & faster large language models via multi-token prediction (arXiv:2404.19737v1). arXiv. https://arxiv.org/abs/2404.19737v1
Austin, J., Odena, A., Nye, M., Bosma, M., Michalewski, H., Dohan, D., Jiang, E., Cai, C., Terry, M., Le, Q., et al. (2021). Program synthesis with large language models. arXiv:2108.07732.
Bachmann, G., & Nagarajan, V. (2024). The pitfalls of next-token prediction.
Cai, T., Li, Y., Geng, Z., Peng, H., Lee, J. D., Chen, D., & Dao, T. (2024). Medusa: Simple LLM inference acceleration framework with multiple decoding heads.
Chen, M., Tworek, J., Jun, H., Yuan, Q., Ponde, H., Kaplan, J., Edwards, H., Burda, Y., Joseph, N., Brockman, G., et al. (2021). Evaluating large language models trained on code. arXiv:2107.03374.
Cobbe, K., Kosaraju, V., Bavarian, M., Chen, M., Jun, H., Kaiser, L., Plappert, M., Tworek, J., Hilton, J., Nakano, R., et al. (2021). Training verifiers to solve math word problems. arXiv:2110.14168.
Frank, M. C. (2023). Bridging the data gap between children and large language models. Trends in Cognitive Sciences.
Goyal, S., Ji, Z., Rawat, A. S., Menon, A. K., Kumar, S., & Nagarajan, V. (2023). Think before you speak: Training language models with pause tokens.
Hendrycks, D., Basart, S., Kadavath, S., Mazeika, M., Arora, A., Guo, E., Burns, C., Puranik, S., He, H., Song, D., et al. (2021). Measuring coding challenge competence with APPS. arXiv:2105.09938.
Koo, R., Lee, M., Raheja, V., Park, J. I., Kim, Z. M., & Kang, D. (2023). Benchmarking cognitive biases in large language models as evaluators. arXiv:2309.17012.
Lefaudeux, B., Massa, F., Liskovich, D., Xiong, W., Caggiano, V., Naren, S., Xu, M., Hu, J., Tintore, M., Zhang, S., Labatut, P., & Haziza, D. (2022). xFormers: A modular and hackable transformer modelling library. https://github.com/facebookresearch/xformers
Leviathan, Y., Kalman, M., & Matias, Y. (2023). Fast inference from transformers via speculative decoding.
Li, Y., Choi, D., Chung, J., Kushman, N., Schrittwieser, J., Leblond, R., Eccles, T., Keeling, J., Gimeno, F., Dal Lago, A., et al. (2022). Competition-level code generation with AlphaCode. Science, 378(6624), 1092–1097.
Lin, C.-Y. (2004). ROUGE: A package for automatic evaluation of summaries. In Text Summarization Branches Out (pp. 74–81). Association for Computational Linguistics.
Olsson, C., Elhage, N., Nanda, N., Joseph, N., DasSarma, N., Henighan, T., Mann, B., Askell, A., Bai, Y., Chen, A., et al. (2022). In-context learning and induction heads. Transformer Circuits Thread.
Qi, W., Yan, Y., Gong, Y., Liu, D., Duan, N., Chen, J., Zhang, R., & Zhou, M. (2020). ProphetNet: Predicting future n-gram for sequence-to-sequence pre-training.
Stern, M., Shazeer, N., & Uszkoreit, J. (2018). Blockwise parallel decoding for deep autoregressive models.