Recurrent Looped Transformer
프롬프트와 응답을 하나의 순환 상태로 잇고 그 전이를 사전학습·SFT·샘플링·RL 재생에서 똑같이 쓰는 RLT의 설계를 따라가며, 이 19쪽 기술 보고서에서 증명된 것·명세된 것·기회로만 제시된 것·검증으로 미룬 것을 갈라 읽는다. 실험이 없는 논문을 어디까지 믿을 수 있는지가 이 글의 질문이다.
Paper: Yifan Zhang (2026). "Recurrent Looped Transformer". Technical report, 2026년 9월 12일, 19쪽. 이 글은 저자 페이지에 공개된 PDF를 기준으로 한다. 이 보고서는 조회 시점(2026년 9월 15일)에 arXiv에 등록되어 있지 않고 발표 venue도 없다. 프로젝트 페이지 주소는 논문 1쪽에 적힌 그대로이며, 주소의 철자 "tranformer"는 원문의 것이다. PDF · 프로젝트 페이지
Abstract: Recurrent Looped Transformer(RLT)는 세 원칙을 내건다. 시간 방향으로 상한이 없는 잠재 추론, 모델–하드웨어 공동설계, 모델–RL 알고리즘 공동설계다. 인과 인코더가 키·값 메모리를 만들고, 순환 디코더가 자신의 최종 은닉 상태와 층별 슬라이딩 윈도 어텐션(SWA) 캐시를 프롬프트와 응답의 모든 토큰에 걸쳐 나른다. 토큰당 블록 수는 고정되지만 상태가 지나온 블록 수는 토큰 수에 비례해 자라고, 사전학습·SFT·샘플링·RL 재생이 같은 전이를 쓰므로 프롬프트 경계에서 정책 정의가 갈라지지 않는다. 이 보고서에는 실험이 없다. 표도, 측정치도, 베이스라인 비교도 없고, 저자 스스로 그 사실을 여러 번 적는다. 이 글은 두 개의 명제와 수식으로 정의된 전이를 따라가면서, 무엇이 증명되었고 무엇이 명세되었으며 무엇이 기회로만 제시되었고 무엇이 검증으로 미뤄졌는지를 나누어 검토한다. 논문 §1
Executive Summary
| 항목 | 설명 |
|---|---|
| 연구 질문 | 프롬프트와 응답을 하나의 순환 상태로 잇고 그 전이를 사전학습·SFT·샘플링·RL 재생에서 동일하게 쓰면, 어떤 계산적 성질이 따라오고 어떤 비용을 치르는가. |
| 핵심 기여 | (1) 인과 인코더가 KV 메모리를 만들고 순환 디코더가 최종 은닉 상태 s_t와 층별 SWA 캐시 C^D_t를 모든 토큰에 걸쳐 나르는 구조. (2) 서빙 분할 불변성(명제 3.1)과 인과성(명제 B.1)의 형식적 진술과 귀납 증명. (3) 파라미터 갱신 뒤 전체 이력을 현재 파라미터로 재구성하는 RL 재생 계약과 그 실행 스케줄(부록 A). |
| 방법적 결과 | 토큰당 블록 수는 L_E + L_D로 고정되고 상태 경로는 tL_D로 자란다. 프리필은 T개의 순차 디코더 전이를 요구하므로 논문은 병렬 프리필 가속을 주장하지 않는다. SFT의 손실 마스크는 상태 갱신을 마스킹하지 않으며, 프롬프트 경계 전용 보정 목적함수가 필요 없다. |
| 실험 결과 | 없다. 표·측정치·베이스라인 비교가 하나도 없다. 도판의 48·96·384는 예시 계산이고 논문은 "측정된 성능이 아니다"라고 적는다. |
| 핵심 한계 | 추론 품질·하드웨어 효율·스케일링을 전부 "향후 검증"으로 넘긴다. 상태 경로의 야코비안 곱을 정규화만으로 묶을 수 없다고 부록에 적으면서, 병합의 게이트·정규화가 그 곱을 묶는다는 논증은 하지 않는다. 관련 연구 절에서 인용한 T2MLR의 "국소 중간층 순환이 전체 순환을 능가할 수 있다"는 결과에 대한 반박이 없다. 코드·하이퍼파라미터·모델 크기가 없다. |
목차
- 세 원칙과 문서의 성격
- 상태와 메모리: 무엇이 나르고 무엇이 남는가
- 모든 토큰에 대한 하나의 전이
- 계산적 성질: 증명된 것과 세어진 것
- 모델–하드웨어 공동설계: 기회와 미측정
- 학습 목적과 RL 재생 계약
- 기존 방법과의 관계
- 방법적 한계와 확장
- 결론
1. 세 원칙과 문서의 성격
1.1 논문이 내건 것
RLT는 세 목표로 조직된다. 무한 깊이의 잠재 추론, 효율적 학습·추론을 위한 모델–하드웨어 공동설계, 일관된 학습·샘플링을 위한 모델–RL 알고리즘 공동설계다. "무한 깊이"는 토큰을 더 처리할수록 시간 방향 계산에 고정된 구조적 상한이 없다는 뜻이고, 유한한 시퀀스는 여전히 유한한 계산을 실행한다. 논문 §1
구조는 두 부분이다. 인과 인코더가 문맥 메모리를 만들고, 깊은 순환 디코더가 각 토큰의 인코더 표현을 직전 디코더 출력과 병합한다. 상태는 관측된 프롬프트와 생성된 응답 위를 경계에서 재시작하지 않고 진행한다. 48층 인코더와 48층 디코더라면 모든 토큰이 h^{48}t에서 시작하는 계산에 h^{96}{t-1}을 넣는다. 호환 가중치를 두 스택이 공유할 수 있어, 하나의 백본을 두 번 논리적으로 통과하고 토큰당 96번의 논리적 블록 평가가 일어난다. 논문 §1
1.2 논문이 내걸지 않은 것
서론의 마지막 문장이 이 문서의 성격을 정한다. "이 보고서는 이 메커니즘들을 전개한다. 측정된 효율이나 스케일링 결과는 보고하지 않는다." 같은 자기 한정이 본문 곳곳에 반복된다. 구조가 경로를 만들 뿐 그 경로를 따라 유용한 추론을 학습하는 것은 별개의 질문이라는 것, 하드웨어 최적화 기회는 노출된 것이지 완성된 커널이 아니라는 것, 수치적 불일치와 통상적 정책 지연은 별개의 관심사라는 것이 모두 서론에서 미리 선을 긋는다. 논문 §1
그래서 이 글은 결과를 검산하는 대신 주장을 네 층위로 나눈다.
| 층위 | 내용 | 이 글의 처리 |
|---|---|---|
| 증명된 것 | 명제 3.1(서빙 분할 불변성), 명제 B.1(인과성) | 진술과 증명의 범위를 §4.1에서 확인한다 |
| 명세된 것 | 전이 식 (2.3)–(2.16), 손실 (5.1)–(5.2), 재생 계약 (5.5), 실행 스케줄 A.1–A.4, 캐시 정확성 조건 C | 무엇이 반드시 재계산되어야 하는지를 §3, §6에서 따라간다 |
| 기회로 제시된 것 | 시퀀스 간 배치, 메모리 재사용, 체크포인팅 | 논문의 표현대로 "구현 목표"로 §5에서 다룬다 |
| 검증으로 미룬 것 | 추론 품질, 하드웨어 효율, 스케일링, 안정성 | §8에서 논문의 인정과 해설자의 추가 지적을 분리한다 |
1.3 연구 질문
| 질문 | 내용 |
|---|---|
| Q1 | 프롬프트와 응답에 같은 전이를 쓰면 서빙 분할 위치와 무관하게 같은 조건부 분포가 나오는가. |
| Q2 | 토큰당 계산을 고정한 채 상태가 지나온 계산 깊이를 시퀀스 길이에 비례해 늘릴 수 있는가. 그 대가는 무엇인가. |
| Q3 | 순환 상태를 가진 모델에서 RL 재생이 현재 정책의 로그확률과 기울기를 정확히 재현하려면 무엇을 다시 계산해야 하는가. |
2. 상태와 메모리: 무엇이 나르고 무엇이 남는가
논문의 표기는 열벡터이며 잔차 폭은 d, 인코더·디코더 깊이는 L_E, L_D다. 인코더 표현 e_t \in \mathbb{R}^d와 순환 출력 s_t \in \mathbb{R}^d가 있고, 학습되는 초기 상태 s_\star를 포함한 모든 파라미터가 \Theta에 모인다. 논문 §2.1
완전 디코더 상태 (논문 §2.1의 서술).
H_t = (s_t, C^D_t).s_t는 시각t의 최종 디코더 출력이고,C^D_t는 모든 디코더 SWA 층에 보존된 키·값 투영이다. 윈도 크기W \ge 1은 현재 토큰을 포함하며, 갱신 뒤 캐시는 다음 갱신을 위해 층당 최대W-1개 위치를 보존한다.
인코더 유도 메모리 (논문 §2.2, 식 2.1–2.2). 관측 접두부에 대해
e_{1:T} = E_\theta(x_{1:T})를 계산하고, 디코더 메모리 그룹g \in {1,\dots,G}마다k^g_t = P^g_K(e_t, t),v^g_t = W^g_V,\mathrm{RMSNorm}E(e_t),M^g{\le t} = {(k^g_j, v^g_j)}_{j=1}^t를 만든다. 디코더 층\ell은 그룹g(\ell)을 읽는다.G = 1이면 모든 층이 메모리를 공유하고G = L_D이면 층별 투영이 허용된다.
두 저장소의 역할이 다르다는 것이 설계의 축이다. M_{\le t}는 인코더 표현에서만 만들어지므로 디코더 상태에 의존하지 않는 전역 문맥이고, C^D_t는 디코더 활성에서 나온 유계 윈도의 국소 KV다. 참조 디코더는 앞의 것에 대한 교차 어텐션과 뒤의 것에 대한 인과 SWA를 결합한다. 논문 §2.2
표기
E_\theta,D_\phi: 인코더와 디코더. 참조 구성에서는 호환 가중치를 공유한다.M_{\le t}: 접두부x_{1:t}까지의 인코더 유도 메모리. 파라미터와 토큰 접두부가 고정되면 불변이다.C^D_t: 층별 디코더 SWA 캐시. 매 토큰 갱신된다.C^E_t: 증분 인코딩을 위한 인코더 캐시.F_t(H) = D_\phi(\mathrm{Merge}(e_t, s); M_{\le t}, C^D, t): 시각t의 전이.
직관적 예시
                인코더 (병렬, 인과)              디코더 (순차, 매 토큰)
  x_1 ... x_T ─▶ e_1 ... e_T ─▶ M_{≤t}  ──┐
                                            ▼
  H_0=(s_★,∅) ─▶ F_1 ─▶ H_1 ─▶ F_2 ─▶ H_2 ─▶ ... ─▶ F_T ─▶ H_T ─▶ F_{T+1} ─▶ ...
                 (프롬프트 토큰)                    (경계, 재시작 없음)  (응답 토큰)
프롬프트의 마지막 토큰 T와 응답의 첫 토큰 T+1 사이에 어떤 특별한 연산도 없다. 이것이 §4.1의 명제가 성립하는 이유이자, §6에서 재생이 프롬프트 처음부터 다시 시작해야 하는 이유다.
3. 모든 토큰에 대한 하나의 전이
3.1 전이의 정의
BOS 이전에 한 번 초기화한다. H_0 = (s_\star, \emptyset). 관측된 토큰이든 샘플된 토큰이든 모든 토큰에 대해
u_t = \mathrm{Merge}(e_t, s_{t-1}), \qquad H_t = (s_t, C^D_t) = D_\phi(u_t; M_{\le t}, C^D_{t-1}, t), \qquad p_\Theta(x_{t+1} \mid x_{1:t}) = \mathrm{softmax}\big(W_o\,\mathrm{RMSNorm}_o(s_t)\big)_{x_{t+1}}를 적용한다(식 2.4–2.6). 고정된 토큰 시퀀스에서 인코더 특징은 디코더 상태에 직접 의존하지 않지만, 첫 응답 토큰을 예측하는 데 쓰이는 완전 상태는 모든 프롬프트 전이를 포함한다. H_T = F_T \circ F_{T-1} \circ \cdots \circ F_1(H_0) (식 2.7). 생성은 H_T에서 이어지며, H_T의 어느 성분도 서빙 경계에서 재설정되지 않는다. 논문 §2.3
3.2 프리필과 증분 디코딩은 같은 계산의 두 스케줄이다
프리필은 프롬프트의 인코더 표현과 메모리를 먼저 계산한 뒤 H_1, \dots, H_T를 순서대로 평가한다. 위치 t에서 어텐션은 전체 프롬프트 메모리가 있더라도 M_{\le t}로 제한된다. 생성은 인코더 캐시를 쓰는 증분 인코딩 (e_t, C^E_t) = E^{\mathrm{step}}\theta(x_t, C^E{t-1}) 뒤에 메모리 추가와 같은 디코더 전이를 따른다. 논문은 여기서 두 가지를 못 박는다. 병렬 인코더 처리와 순환 인코더 스테핑은 같은 인과 계산의 실행 스케줄일 뿐이라는 것, 그리고 비선형 디코더 순환에는 그에 대응하는 완전 병렬 스케줄이 가정되지 않는다는 것이다. 과거 디코더 KV는 선행 순환 갱신이 만들어야 하므로 표준 병렬 SWA 디코더 패스는 일반적으로 동치가 아니다. 논문 §2.4
3.3 병합 게이트와 블록 순서
구체적 게이트 병합은
r_{t-1} = \mathrm{RMSNorm}_s(s_{t-1}), \quad g_t = \sigma\big(W_g [e_t; r_{t-1}] + b_g\big), \quad u_t = e_t + \alpha\, g_t \odot W_s r_{t-1}이다(식 2.9–2.11). W_g \in \mathbb{R}^{d \times 2d}, W_s \in \mathbb{R}^{d \times d}이고 \alpha가 되먹임 크기를 조절한다. 논문은 이 \alpha에 대해 "적당한 0이 아닌 초기 되먹임 크기는 후보 초기화이지 확립된 안정성 처방이 아니다"라고 적는다. 스칼라 게이팅이나 저랭크 W_s로 오버헤드를 줄일 수 있다. 논문 §2.5
디코더 블록은 z^0_t = u_t에서 시작해 인과 SWA, 인코더 메모리 교차 어텐션, FFN 순으로 진행한다(식 2.12–2.16). 각 층에서 현재 KV는 SWA 전에 층 입력으로 만들어지므로 현재 위치 어텐션에 순환 의존이 생기지 않고, 과거 디코더 KV는 C^D_{t-1}에서 온다. 갱신 뒤 위치 \max(1, t-W+2), \dots, t를 C^D_t에 보존하며 W = 1이면 이 집합은 비어 있다. 논문은 다른 서브층 순서가 다른 변형을 정의하며 모든 실행 모드에서 일관되게 써야 한다고 명시한다. 논문 §2.5
3.4 무엇이 "looped"인가
참조 묶음 구성은 L_E = L_D = L로 두고, 층 \ell의 인코더 자기 어텐션과 디코더 SWA가 호환되는 쿼리·키·값·출력 투영을 공유하며 FFN도 공유한다. 인코더는 자기 인과 문맥을 쓰고 디코더 SWA는 윈도 안의 디코더 활성을 쓴다. 교차 어텐션의 쿼리·출력 투영과 식 (2.2)의 메모리 투영은 별도이고, 단계별 정규화·병합·판독도 명시적 모듈로 남는다. 논문은 두 가지 오해를 미리 막는다. 디코더 블록이 재사용된 어텐션·FFN 코어에 교차 어텐션을 더하므로 두 논리적 패스가 블록당 같은 FLOPs를 뜻하지는 않는다는 것, 그리고 이것은 어텐션 배선이 다른 파라미터 재사용이지 활성 복사가 아니라는 것이다. 어떤 디코더 출력도 인코더 출력과 동일시되지 않는다. 논문 §2.6
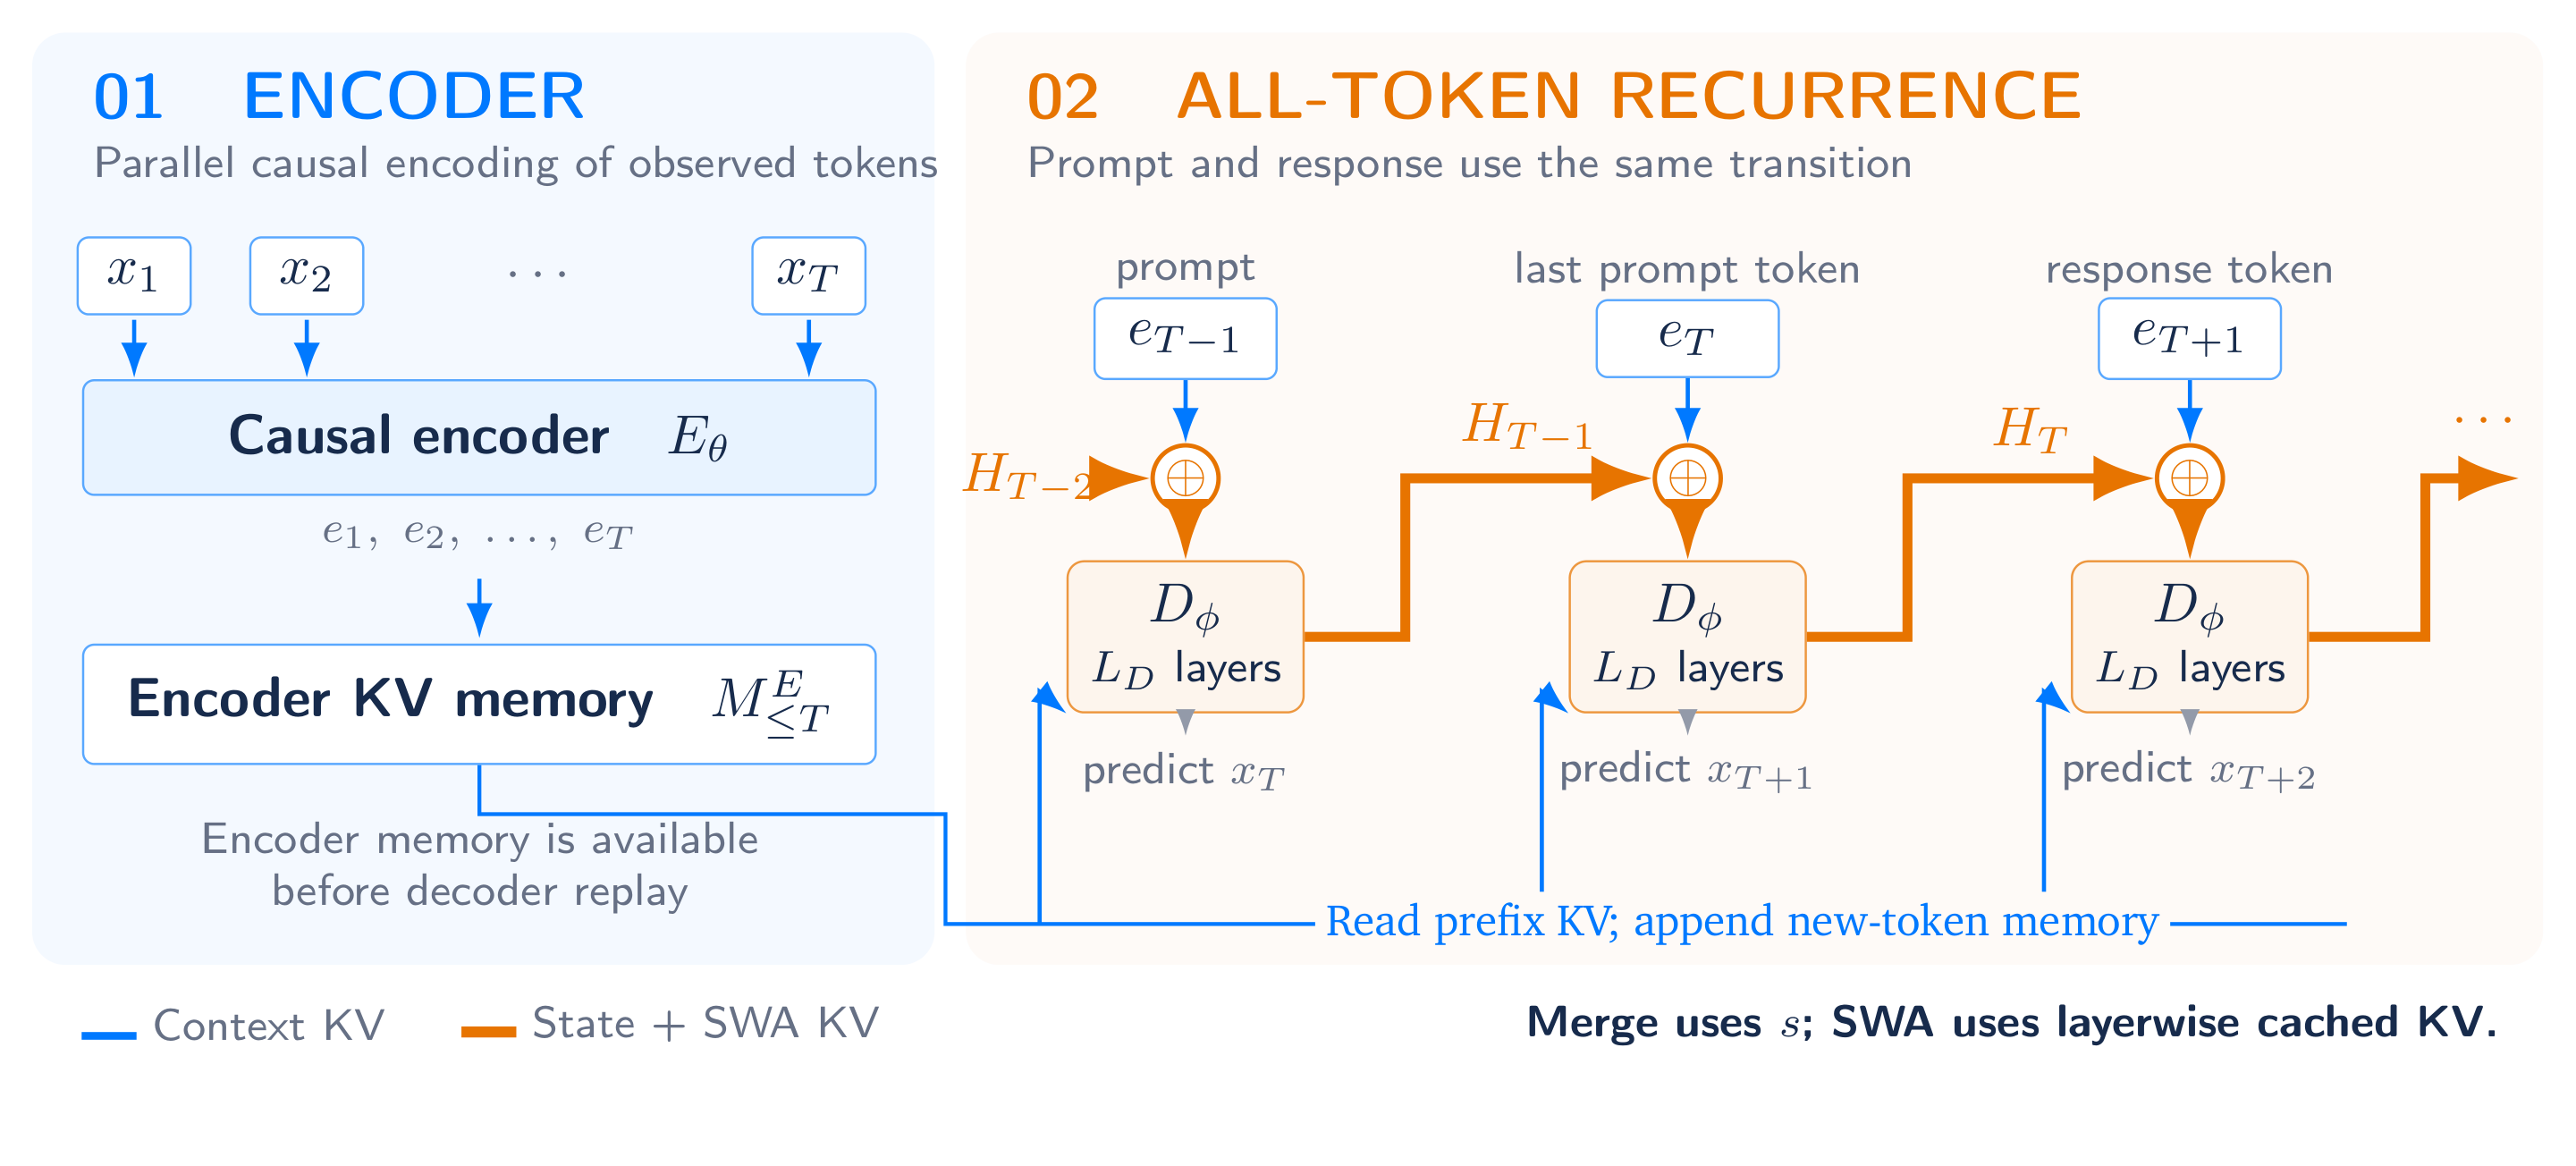
원논문 Figure 1. 왼쪽 패널은 인코더 E_\theta가 x_1, \dots, x_T를 병렬로 인과 인코딩해 e_1, \dots, e_T와 인코더 KV 메모리 M^E_{\le T}를 만드는 과정이고, 오른쪽 패널은 프롬프트 토큰·마지막 프롬프트 토큰·응답 토큰이 모두 같은 D_\phi(L_D층) 전이를 통과하며 H_{T-2} \to H_{T-1} \to H_T를 나르는 순환이다. 파란 선은 문맥 KV, 주황 선은 상태와 SWA KV이고, 하단에 "병합은 s를 쓰고 SWA는 층별 캐시 KV를 쓴다"고 적혀 있다. 인코더 메모리는 디코더 재생 전에 준비된다. Zhang (2026), PDF p. 1. 원본 도판 영역 직접 추출.
4. 계산적 성질: 증명된 것과 세어진 것
4.1 명제 3.1: 서빙 분할 불변성
명제 3.1 (서빙 분할 불변성). 파라미터, 토큰 시퀀스, 위치 규약, 독립 시퀀스 시작 상태를 고정한다. 수학적으로 동치인 인과 인코더 실행, 동일한 SWA 윈도와 캐시 갱신, 결정론적 디코더 연산을 가정한다. 어떤 접두부를 배치 인코더 프리필 뒤 순환 디코더 갱신으로 처리하든 증분으로 처리하든 같은 상태와 다음 토큰 분포가 나온다. 프롬프트–응답 분할을 옮겨도 고정된 토큰 이력에 대한 조건부 분포는 바뀌지 않는다.
증명 스케치. 인과 인코더 동치성이 두 스케줄에서 같은 e_t와 M_{\le t}를 준다. 둘 다 H_0 = (s_\star, \emptyset)로 초기화한다. t-1에서 상태가 같으면 식 (2.5)가 t에서 같은 입력에 같은 연산을 적용하므로 상태가 같다. 귀납으로 결과가 따른다. 서빙 분할은 전이에 등장하지 않는다. 논문 §3.1
논문은 이것이 수학적 동치이며 커널과 정밀도 선택은 여전히 수치적 불일치를 낼 수 있다고, 또 동일한 토크나이제이션과 문맥, 한쪽 실행에서 토큰 누락·재설정·오래된 상태 삽입이 없다는 가정을 함께 적는다. 증명 자체는 짧고 옳다. 전이에 분할 위치가 변수로 들어가지 않는다는 구조적 사실의 재진술이며, 그 사실은 §3.1의 정의에서 곧바로 읽힌다. 이 명제가 하는 일은 새로운 성질을 끌어내는 것이 아니라, 표준 디코더 전용 모델에서 프롬프트와 응답이 서로 다른 계산을 타면서 생기는 구조적 갈라짐이 이 구조에는 정의상 없음을 못 박는 것이다. 커널 수준의 갈라짐은 이 명제가 다루지 않는다. 그 갈라짐 자체는 저자의 앞선 보고서가 다룬 문제다(Zhang et al., 2026).
부록 B의 명제 B.1은 같은 귀납으로 인과성을 진술한다. 인과 인코더, 접두부 제한 인코더 메모리, 인과 디코더 SWA 아래에서 H_t는 결정론적 실행 시 x_{1:t}와 파라미터에만 의존한다. 현재 KV를 추가하고 오래된 항목을 축출하는 것은 미래 정보를 들이지 않는다. 논문 Appendix B
4.2 프리필 비용과 순차 깊이
C^{\mathrm{pf}}_E(T)를 인코더 프리필 작업, C_M(T)를 메모리 투영 작업, C^{\mathrm{step}}D(t)를 t개 인코더 메모리 항목과 층당 최대 W개 디코더 위치에 대한 디코더 평가라 하면 C{\mathrm{prefill}}(T) = C^{\mathrm{pf}}E(T) + C_M(T) + \sum{t=1}^{T} C^{\mathrm{step}}_D(t)이고(식 3.1), 밀집 어텐션과 폭에 비례하는 KV에서 거친 산술 추정은
O\big((L_E + L_D)(Td^2 + T^2 d) + GTd^2 + L_D T \min(W, T)\, d\big)이다(식 3.2). 논문 §3.2
산술 총량은 통상적 밀집 Transformer와 같은 차수다. 갈라지는 것은 순서다. T개 전이를 지나는 순차 디코더 경로가 있고 각 전이는 L_D개 블록을 담으므로, 인코더 병렬성이 완전 병렬 모델 프리필을 뜻하지 않는다. 논문은 이를 "상태 순환은 산술 순서가 통상적 밀집 Transformer와 같더라도 하드웨어 이용률을 낮출 수 있다. 전체 프롬프트 계산을 보존하기 위해 이 비용을 받아들인다. 프리필 축소 가속은 주장하지 않는다"로 적는다. 토큰당 L_E + L_D개 블록에 병합과 메모리 투영이 더해지고, 어텐션 작업은 여전히 문맥 길이에 따라 커진다. 추론 캐시 저장량은 근사적으로 O((L_E + G),t,d_{KV} + L_D \min(t, W-1), d^D_{KV} + d)이다(식 3.3). 파라미터 묶기는 저장 가중치를 줄이지만 두 번째 논리적 패스도 어느 캐시 역할도 없애지 않는다. 논문 §3.2
이 대목은 논문이 가장 분명하게 인정하는 비용이다. 표준 디코더 전용 모델은 길이 T의 프롬프트를 깊이 L의 한 번의 병렬 패스로 처리한다. RLT의 참조 계산은 같은 프롬프트에 T번의 순차 전이를 요구하고 각 전이가 L_D개 블록이다. 순차 깊이가 L에서 T \cdot L_D로 늘어나는 셈이며, 이것이 §5의 "시퀀스 간 배치"가 시퀀스 안의 지연을 줄여 주지는 못하는 이유다. 논문은 이 비용의 크기를 재지 않는다.
4.3 무한 시간 깊이가 세는 것
위치 t까지의 상태 경로는 t개 디코더 전이를 합성하며 시퀀스 시작부터 tL_D개 디코더 블록을 지난다. 길이 T의 프롬프트 뒤에 n개 토큰이 이어지면 경로는 (T+n)L_D개 블록을 담는다. 이 깊이는 프롬프트를 포함하고 처리된 이력과 함께 자라며, 토큰당 블록 수는 고정된다. 논문은 곧바로 단서를 단다. "게이트, 수축, 학습된 투영이 긴 경로의 실제 기여를 억제할 수 있다. 구조적 깊이만으로는 추론을 보장하지 않는다." 논문 §3.3
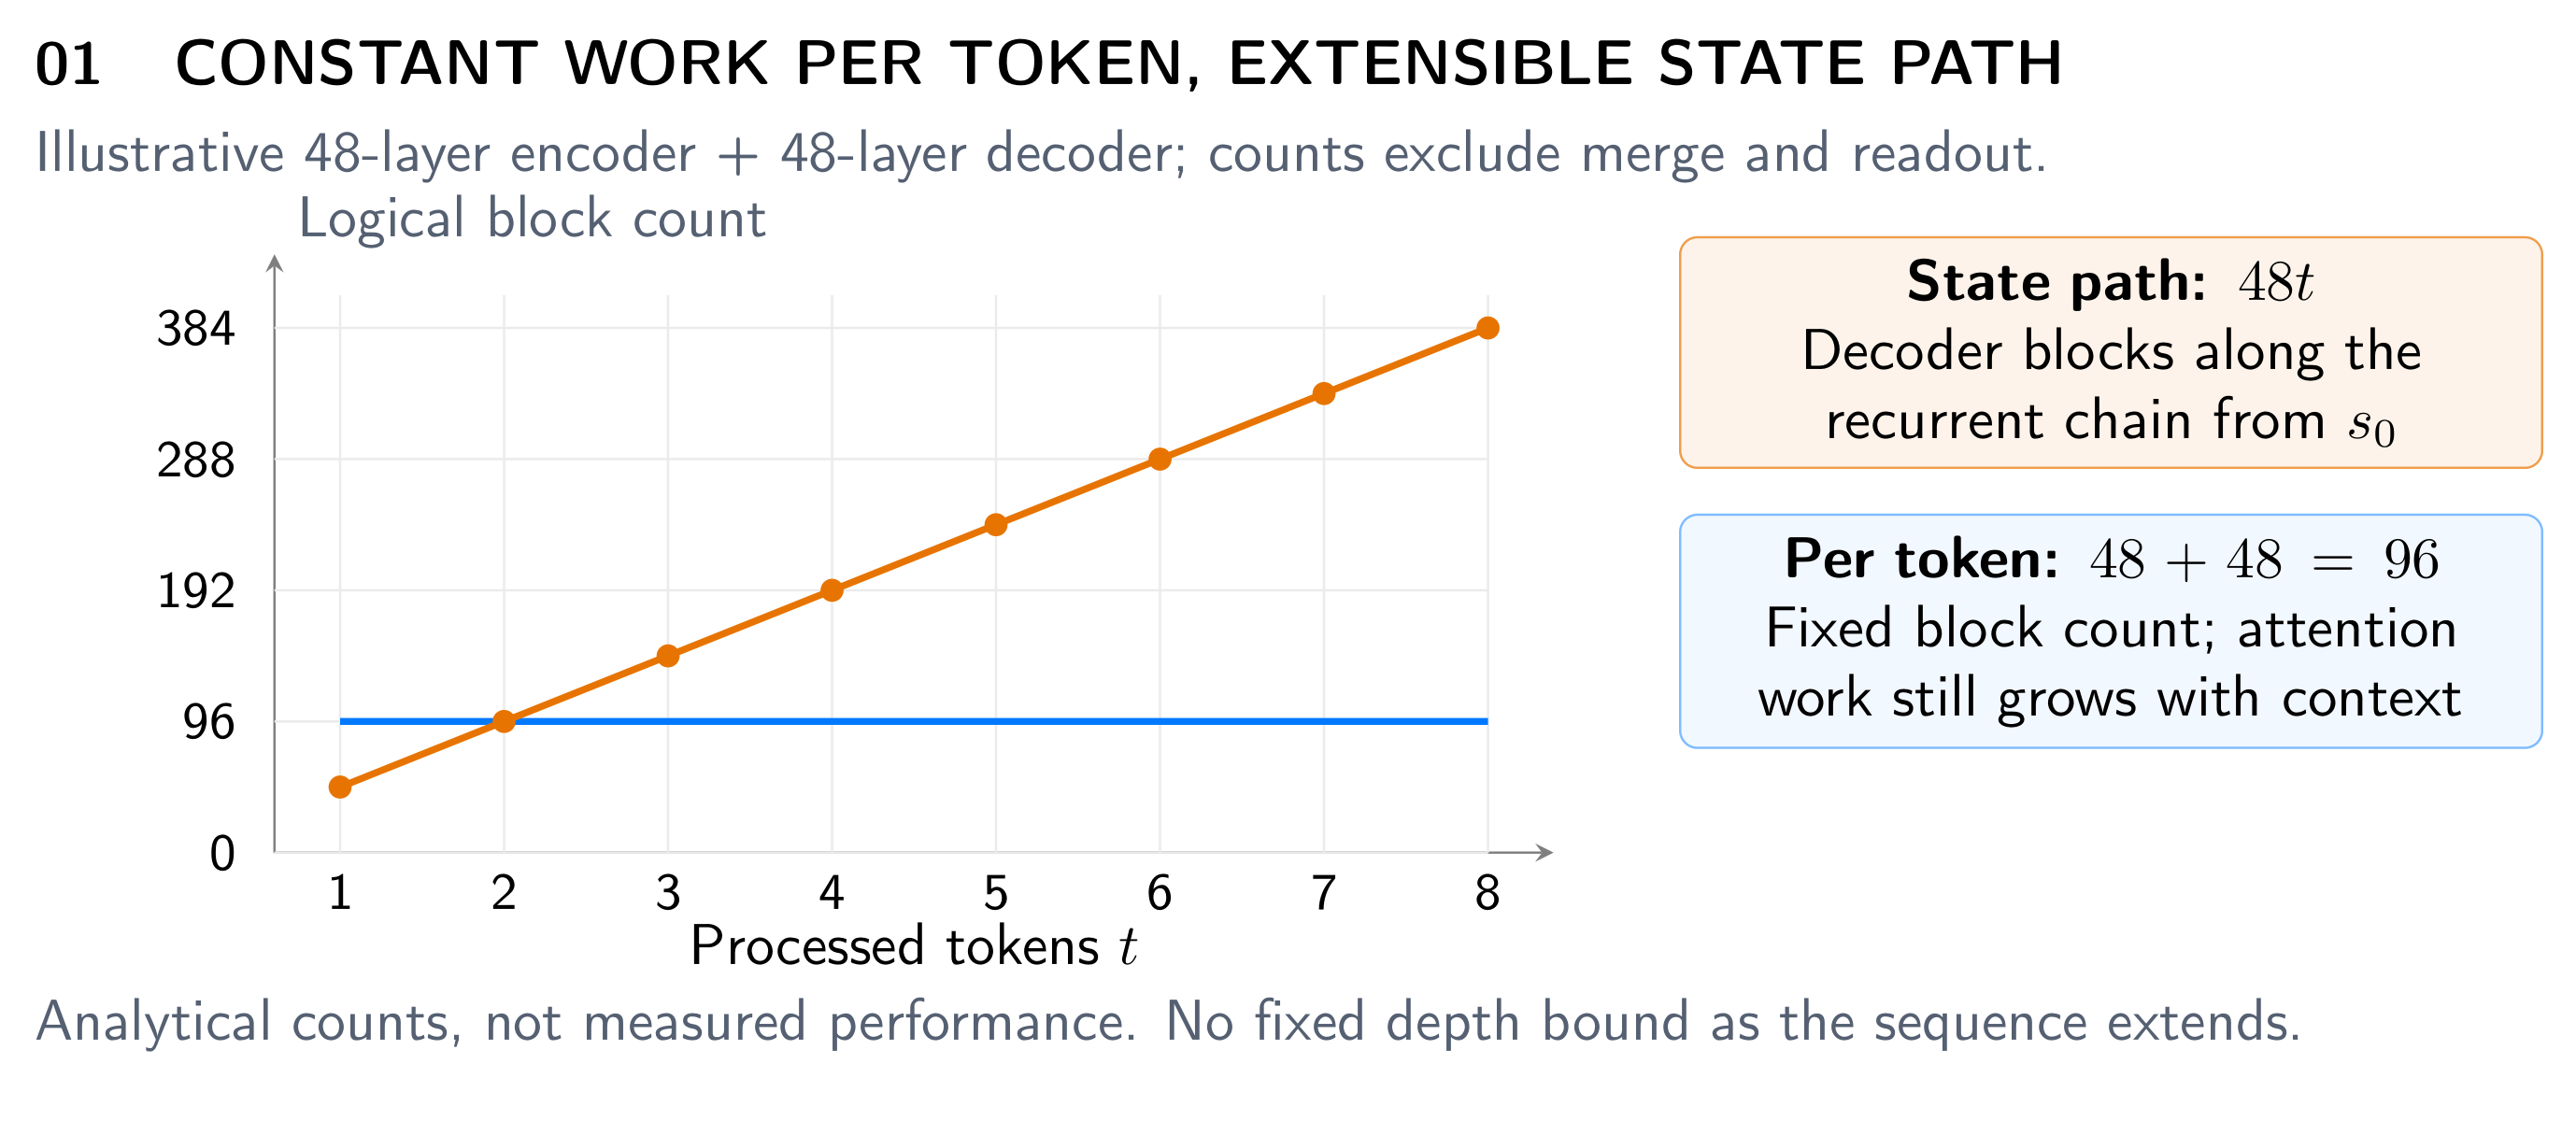
원논문 Figure 2. 가로축은 처리된 토큰 수 t(1–8), 세로축은 논리적 블록 수다. 주황 선은 s_0에서 시작하는 순환 사슬을 따라 지나는 디코더 블록 수 48t이고, 파란 수평선은 토큰당 블록 수 48 + 48 = 96이다. 두 선은 t = 2에서 만나고 그 뒤로 상태 경로가 토큰당 계산을 넘어선다. 오른쪽 아래 파란 상자는 "고정 블록 수; 어텐션 작업은 여전히 문맥과 함께 자란다"고 적고, 하단에 "분석적 계수이지 측정된 성능이 아니다"라고 명시한다. 계수는 병합과 판독을 제외한다. Zhang (2026), PDF p. 6. 원본 도판 영역 직접 추출.
세는 것은 정확하다. 다만 F_T \circ \cdots \circ F_1의 합성 깊이가 t에 비례한다는 것은 모든 순환 신경망의 정의적 성질이며, RLT가 더한 것은 그 전이가 교차 어텐션과 SWA 캐시를 가진 L_D개 블록의 Transformer라는 점이다. 그 경로를 따라 기울기가 실제로 전달되는지는 부록 B가 다룬다. 고정 슬롯 표현의 디코더 캐시에 대해 J_t = \partial H_t / \partial H_{t-1}을 정의하면 \partial H_t / \partial H_j = J_t J_{t-1} \cdots J_{j+1}이고(식 B.1–B.2), J_t는 s와 C^D 사이의 네 블록으로 이루어진다(식 B.3). 논문은 여기서 두 문장을 적는다. "\partial s_t / \partial s_{t-1}만 포함하는 곱은 일반적으로 디코더 KV를 지나는 경로를 놓친다. 정규화만으로는 이 야코비안들의 곱을 유계로 만들지 못한다." 논문 Appendix B
즉 논문은 긴 상태 경로를 지나는 기울기가 정규화만으로 유계가 되지 않는다는 사실을 스스로 적고, 논문 §3.3에서는 게이트와 수축이 긴 경로의 기여를 억누를 수 있다고도 적는다. 병합의 게이트·정규화(식 2.9–2.11)는 명세되어 있지만, 그것이 야코비안 곱을 묶는다는 주장은 하지 않는다. §3.3에서 되먹임 크기 \alpha의 초기화가 "확립된 안정성 처방이 아니다"라고 한 것과 짝을 이룬다. 시간 깊이가 무한하다는 주장과 그 깊이를 따라 학습이 가능하다는 주장은 별개이며, 논문은 앞의 것만 한다.
5. 모델–하드웨어 공동설계: 기회와 미측정
알려진 학습 시퀀스나 프롬프트에 대해 인코더 특징과 메모리 투영은 토큰 병렬 커널로 계산할 수 있고, 디코더 평가는 상태 의존성을 따른다. 독립 시퀀스들을 가로질러서는 준비된 디코더 전이들을 배치할 수 있다. 각 시퀀스는 자기 인코더 KV 접두부, 디코더 SWA 캐시, 순환 출력, 위치를 유지하면서 다음 상태 갱신을 기여한다. 논문은 이것이 "순환 디코더 안에서 시퀀스 수준 병렬성을 주장하지 않으면서 배치 수준 병렬성을 노출한다"는 것이고, "일반 비선형 디코더에 대한 정확한 병렬 스캔은 가정하지 않는다"고 적는다. 논문 §4.1
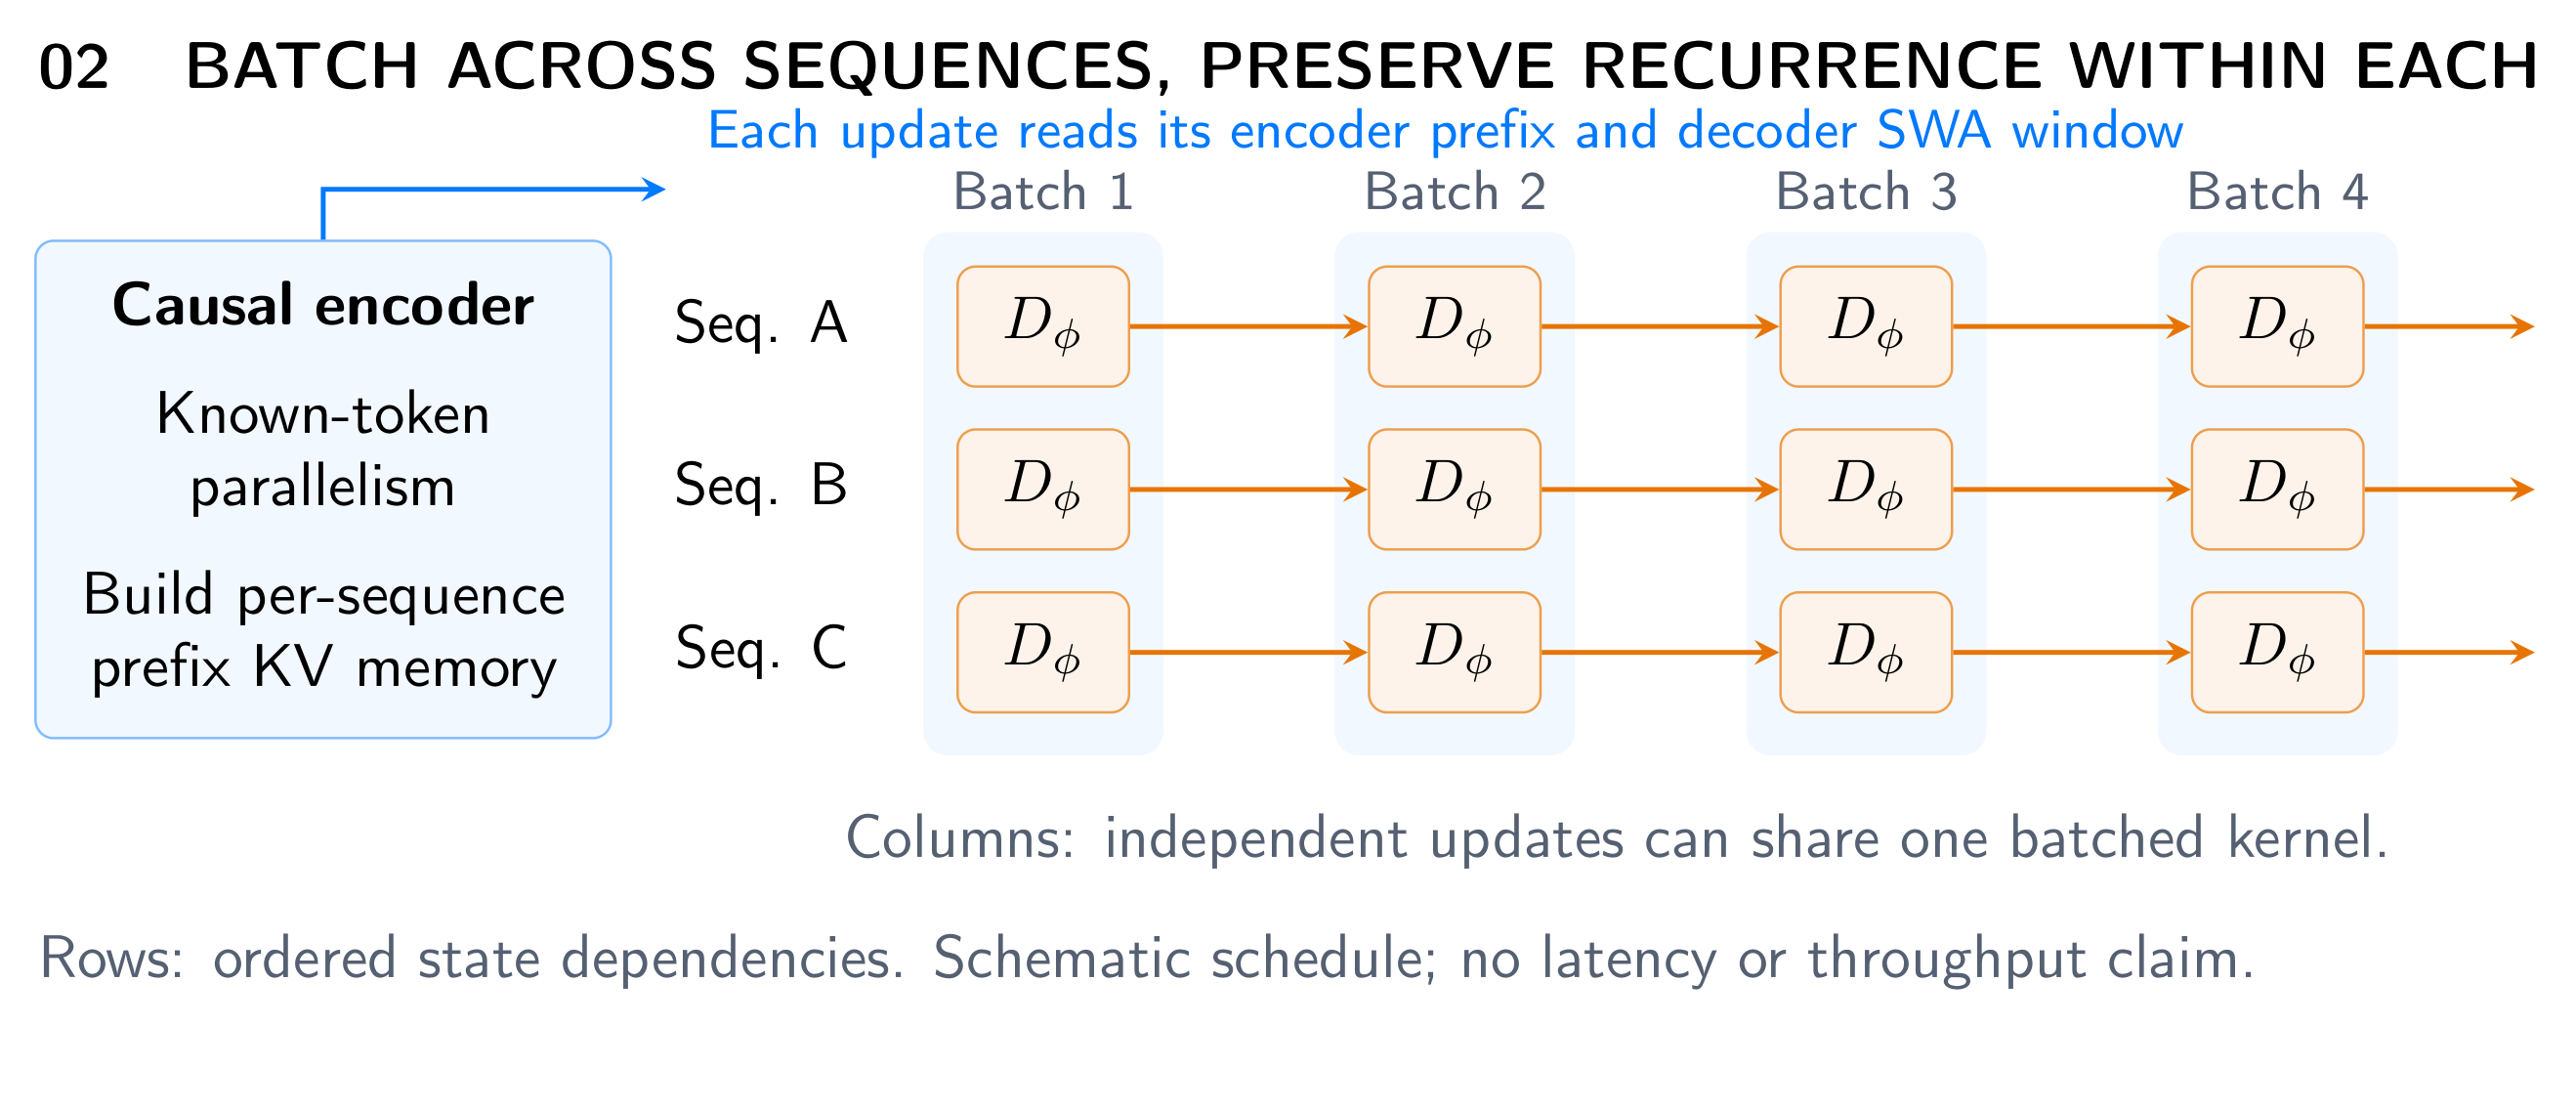
원논문 Figure 3. 왼쪽 상자는 인과 인코더의 알려진 토큰 병렬성과 시퀀스별 접두부 KV 메모리 구축이고, 오른쪽은 세 시퀀스 A·B·C가 배치 1–4의 열마다 하나의 배치 커널을 공유하되 각 행은 순서대로 상태 의존을 지키는 스케줄이다. 각 갱신은 자기 인코더 접두부와 디코더 SWA 윈도를 읽는다. 하단에 "도식적 스케줄이며 지연이나 처리량 주장이 아니다"라고 적혀 있다. Zhang (2026), PDF p. 7. 원본 도판 영역 직접 추출.
메모리 쪽의 논리는 이렇다. 인코더 유도 KV는 고정된 토큰 접두부와 파라미터 집합에 대해 불변이다. 디코더 층은 이 메모리를 읽고 별도로 유계 층별 SWA 캐시에 디코더 유도 KV를 덧붙이며, 이 캐시는 인코더 메모리로 대체될 수 없다. 메모리 그룹 공유는 저장 KV와 투영을 줄이고, 호환 인코더/디코더 가중치 묶기는 저장 파라미터 발자국을 줄여 가중치 상주에 유리할 수 있지만 그 자체로 블록 평가를 줄이거나 낮은 지연을 보장하지는 않는다. 정규화·게이팅·상태 투영·잔차 덧셈은 융합 실행 후보다. 논문 §4.2 논문은 이 절을 "이것들은 구현 목표이지 완성된 커널이나 측정된 대역폭 절감의 주장이 아니다"로 닫는다. 논문 §4.2
학습 메모리에 대해서는 활성 체크포인팅이 전체 BPTT를 유지하면서 재계산과 활성 저장을 맞바꾼다고 적고, 인코더 배치·예제 간 디코더 배치·체크포인트 배치를 시퀀스 길이와 가속기 메모리에 맞춰 함께 골라야 한다고 한다. 최적화 대상은 "근사로 순환을 없애는 것이 아니라 참조 순환 계산 아래의 유용한 학습·추론 처리량"이다. 저자의 앞선 보고서를 따라 실행된 정책이 가중치와 실행 선택(정밀도, 캐시 구성, 리덕션, 샘플링 변환) 양쪽의 함수라는 관점을 취하며, 하드웨어와 알고리즘 선택이 재생 충실도에서 만난다고 본다. 절의 마지막 문장은 "하드웨어 효율적 학습·추론은 측정되기 전까지 공학 목표로 남는다"이다. 논문 §4.3
이 장 전체에서 수치는 하나도 없다. 커널 설계도, 이용률 추정도, 배치 크기에 따른 처리량 곡선도 없다. 논문이 그 부재를 문장마다 명시하므로 과장은 아니지만, "모델–하드웨어 공동설계"라는 세 원칙 중 하나가 실제로 담고 있는 것은 측정이 아니라 구조적 관찰과 구현 제약의 목록이다. 그 목록은 §4.2가 인정한 T \cdot L_D의 순차 깊이를 상쇄하지 않는다.
6. 학습 목적과 RL 재생 계약
6.1 사전학습과 SFT
기본 목적은 전체 시퀀스 다음 토큰 예측이다.
\mathcal{L}_{\mathrm{PT}}(\Theta) = -\,\mathbb{E}_{x_{1:S}}\Big[\frac{1}{S-1}\sum_{t=1}^{S-1}\log p_\Theta(x_{t+1} \mid x_{1:t})\Big]H_0 = (s_\star, \emptyset)로 초기화하고 인과 인코더 특징을 계산한 뒤 위치 1, \dots, S-1에 걸쳐 완전 디코더 상태를 펼친다. 모든 비BOS 목표가 지도되고, 인코더·메모리 투영·병합·디코더가 함께 학습된다. 독립 문서는 순환 출력·디코더 SWA 캐시·인코더 캐시·위치를 재설정하고 분리된 어텐션 마스크를 쓴다. 논문은 "세그먼트 절단이 전체 이력 우도를 주장하면서 상태를 조용히 버릴 수는 없다"고 적는다. 논문 §5.1
SFT는 어시스턴트 목표에 m_{t+1} = 1, 사용자·시스템·도구·패딩 목표에 0을 두고 선택된 목표 수로 정규화한 손실(식 5.2)을 최소화한다. 여기서 논문이 강조하는 것은 마스크의 범위다. 손실 마스킹은 상태 갱신을 마스킹하지 않고 인코더 메모리·순환 출력·디코더 KV를 분리하지 않는다. 디코더는 사용자와 도구 메시지를 포함한 모든 선행 문맥 토큰을 처리하고, 어시스턴트 손실의 기울기는 그 프롬프트 계산을 통해 흐를 수 있다. 상태는 어시스턴트 경계에서 재설정되지 않으며, 프롬프트 전용 전이 변화를 보정하는 별도의 경계 적응 목적함수가 필요 없다. 논문 §5.2
6.2 같은 전이, 파라미터-정확 재생
프롬프트 c = x_{1:T}와 샘플된 응답 y = (y_1, \dots, y_N), y_i = x_{T+i}에 대해 정책은 \pi_\Theta(y \mid c) = \prod_{i=1}^N p_\Theta(y_i \mid c, y_{<i})이고(식 5.3), 시퀀스 보상 R(c, y)에 대한 온폴리시 점수함수 기울기는 응답 독립 베이스라인 b(c)를 상수로 취급한 표준 형태다(식 5.4). 이산 샘플 토큰은 로그확률 재생 중 고정되고 미분은 그 연속 순환 계산을 포함한다. 논문은 특정 보상 함수·클리핑 규칙·KL 정규화가 구조에 의해 요구되지 않는다고 적는다. 논문 §5.3
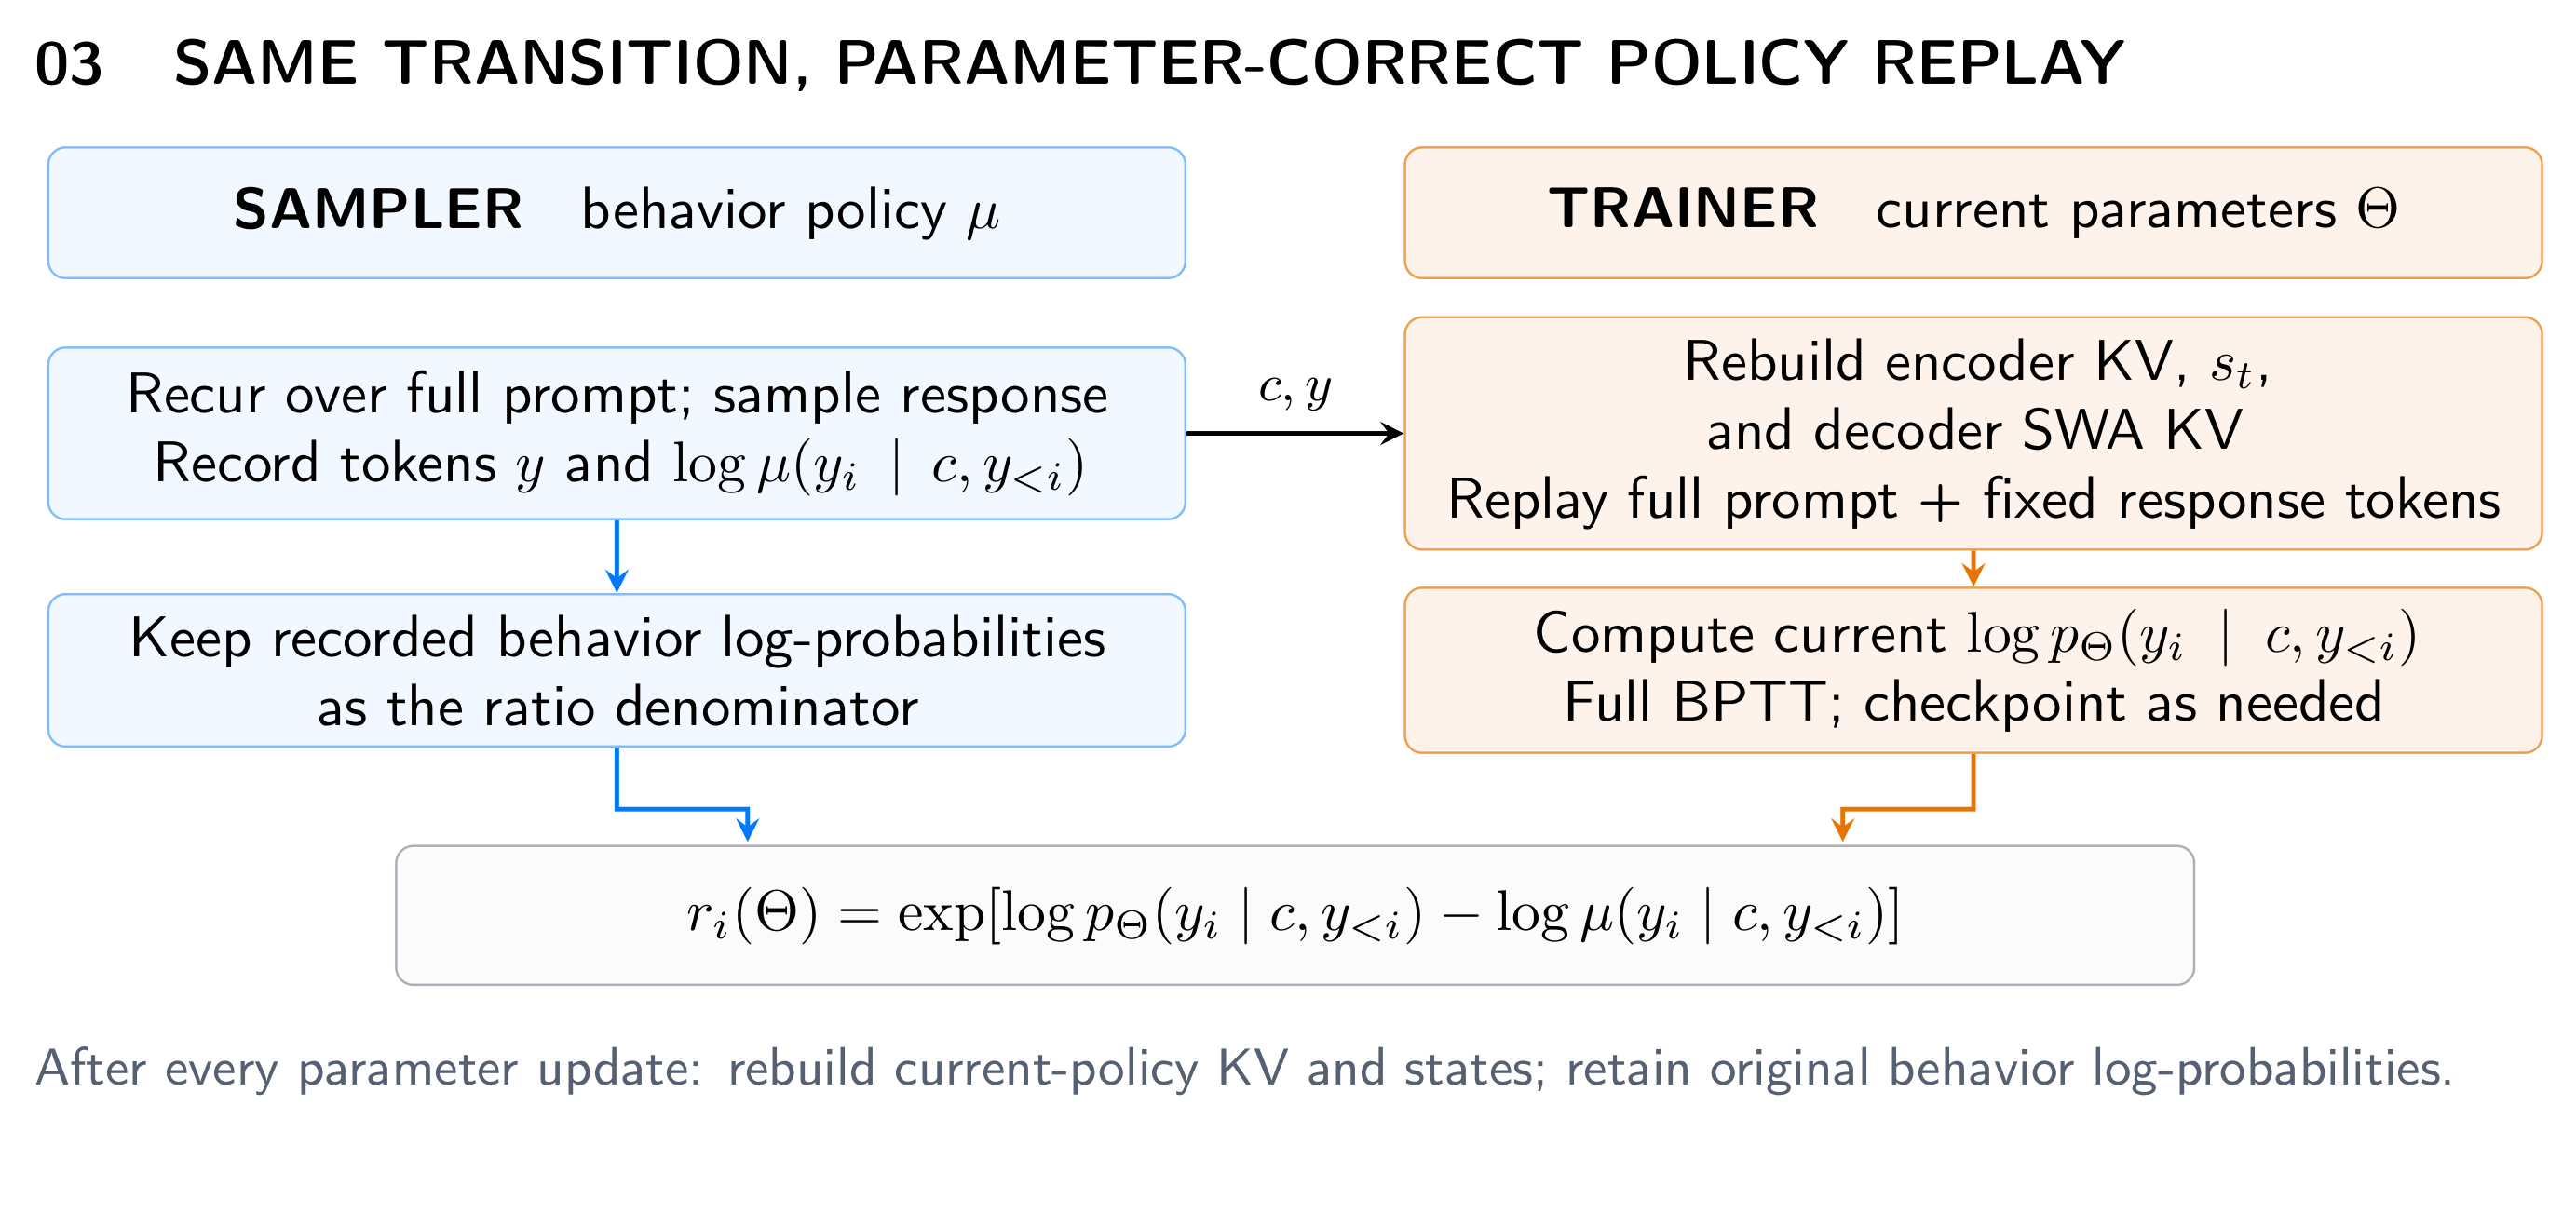
원논문 Figure 4. 왼쪽 열의 샘플러는 행동 정책 \mu로 전체 프롬프트를 순환하며 응답을 샘플하고 토큰 y와 \log \mu(y_i \mid c, y_{<i})를 기록해 비율의 분모로 보존한다. 오른쪽 열의 트레이너는 현재 파라미터 \Theta로 인코더 KV·s_t·디코더 SWA KV를 재구성하고, 전체 프롬프트와 고정된 응답 토큰을 재생해 현재 \log p_\Theta(y_i \mid c, y_{<i})를 계산하며 전체 BPTT에 필요 시 체크포인팅을 쓴다. 두 열이 r_i(\Theta) = \exp[\log p_\Theta - \log \mu]로 합쳐진다. 하단에 "파라미터 갱신마다 현재 정책 KV와 상태를 재구성하고 원래 행동 로그확률은 보존한다"고 적혀 있다. Zhang (2026), PDF p. 10. 원본 도판 영역 직접 추출.
재생 계약은 이렇다. 샘플러는 각 행동의 행동 로그확률을 실제 샘플링 분포 \mu 아래에서 기록한다. 파라미터 \Theta의 트레이너 갱신에 대해 인과 인코더 특징을 그 파라미터로 재계산하고, 같은 시퀀스 초기화에서 시작해 전체 프롬프트와 샘플된 응답 접두부에 걸쳐 순환 출력과 모든 디코더 SWA 캐시를 재구성한다. 이것이 현재 정책 로그확률과 토큰 비율 r_i(\Theta) = \exp(\log p_\Theta(y_i \mid c, y_{<i}) - \log \mu(y_i \mid c, y_{<i}))를 준다(식 5.5). 동일한 파라미터와 샘플링 규약에서 트레이너와 샘플러는 같은 계산을 표현한다. 논문 §5.3
논문은 이 계약이 대신해 주지 않는 것들을 같은 절에서 열거한다. 원시 모델 분포를 온도 조정되거나 절단된 샘플링 분포와 혼동해서는 안 된다. 정확한 중요도 샘플링은 관련 이력에서 p_\Theta(\cdot \mid h) \ll \mu(\cdot \mid h)를 요구하는데, top-k나 top-p 행동 샘플링은 절단되지 않은 소프트맥스 목표에 대해 일반적으로 이 조건을 위반한다. 행동 로그확률은 온도·절단·재정규화를 포함해야 하며 메타데이터만으로는 사라진 지지를 복원할 수 없다. 올바른 로그확률이 임의의 오프폴리시 손실을 비편향으로 만들지도 않는다. 구조가 유도한 상태 불일치와 통상적 정책 지연은 별개의 문제다. 논문 §5.3
6.3 정방향 일치는 기울기 일치가 아니다
저자의 앞선 보고서(Zhang et al., 2026)의 실행 수준 구분을 따라, 논문은 한 파라미터 값에서 정방향 확률이 일치한다는 것이 정책 기울기의 일치를 확립하기에 충분하지 않다고 적는다. 트레이너는 순환 목표 계산이나 그 정방향–역방향 동치 구현을 미분해야 한다. 그래서 RLT는 전체 이력 정방향 재생과 그 기울기 경로를 함께 명세한다. "공유된 구조적 전이만으로는 수치적 커널 동등성이 증명되지 않는다." 논문 §5.3
부록 B가 이를 식으로 적는다. 응답 손실 \ell(\Theta, H_T(\Theta), B^E_T(\Theta))에 대해 연쇄 법칙은 d\ell/d\Theta = \partial\ell/\partial\Theta + (\partial\ell/\partial H_T)(\partial H_T/\partial\Theta) + (\partial\ell/\partial B^E_T)(\partial B^E_T/\partial\Theta)이고(식 B.4), 첫 항은 경계 인수를 고정한 채 계산하며 나머지 항이 접두부 계산을 담당한다. s_T, 디코더 KV, 인코더 쪽 경계 텐서 중 어느 것을 분리하든 정방향 확률이 그대로여도 대응 기울기 경로가 사라진다. "이 연산들 중 어느 것도 전체 BPTT가 아니다." 논문 Appendix B
6.4 무엇이 오래되는가
참조 학습 계산은 필요 시 활성 체크포인팅을 곁들인 전체 BPTT다. 체크포인팅은 역방향 중 정방향 연산을 같은 파라미터와 확률적 상태로 재계산하므로 메모리·계산 비용을 바꾸지만 기울기를 의도적으로 절단하지 않는다. 절단 BPTT는 선택적 근사로, 수치는 보존하되 명시적으로 고른 경계 텐서를 분리한다. s_t만 분리하면 디코더 KV와 인코더 메모리를 지나는 기울기 경로가 남으므로, 절단 명세는 보존·분리되는 모든 경로를 밝혀야 한다. 논문 §5.4
한 번의 재생 안에서는 파라미터를 고정한다. 옵티마이저 갱신 뒤에는 이전에 계산된 인코더 KV·순환 출력·디코더 SWA KV가 일반적으로 현재 정책 값이 아니게 된다. 시퀀스 시작부터, 또는 같은 파라미터와 실행 규약으로 만든 정확한 접두부 체크포인트부터 다시 계산해야 한다. 논문은 "이것은 롤아웃에 대한 모든 반복 최적화 패스에 적용된다"고 명시한다. 샘플러의 옛 은닉 상태는 현재 정책 재생을 대체할 수 없고, 반대로 기록된 행동 로그확률은 실제로 행동을 샘플한 정책의 분모로 남는다. 논문 §5.4
이 문장이 계약의 대가를 정한다. 표준 디코더 전용 모델도 갱신된 파라미터에서는 프롬프트 계산을 다시 해야 한다. 다만 그 재계산은 깊이 L의 병렬 패스 한 번이다. RLT의 정확 재생은 같은 자리에서 프롬프트 처음부터 T + N번의 순차 전이를 요구한다. §4.2의 순차 깊이가 학습에서는 최적화 패스 수만큼 곱해지는 셈이며, 논문은 이 곱을 이름 붙이되 크기를 재지 않는다. 부록 C는 같은 논리를 캐시 쪽에서 적는다. 캐시된 접두부가 정방향 재생을 대체할 수 있는 것은 완전 캐시가 현재 파라미터·소비된 토큰 접두부·위치·초기화·윈도 의미론·정책 실행 설정과 일치할 때뿐이다. 논문 Appendix C 분리된 캐시는 전체 기울기 학습에 필요한 미분 그래프를 공급하지 않으며, 옛 가중치로 만든 캐시는 일반적으로 현재 정책 값 요건도 전체 기울기 요건도 만족하지 않는다. SWA 축출은 그 자체로 정지 기울기 연산이 아니므로 추론 캐시 크기가 전체 BPTT 활성 저장량을 제한하지 않는다. 논문 Appendix C
6.5 실행 스케줄과 결정론
부록 A.4는 현재 정책 RL 재생을 여섯 단계로 적는다. 롤아웃 토큰 이력·행동 마스크·실제 행동 로그확률·샘플링 메타데이터를 읽고, 정방향 재생과 역방향 내내 현재 파라미터를 고정하며, 알려진 이력의 인코더 표현을 재계산하고 H_0부터 모든 프롬프트 토큰을 지나 순환 출력과 모든 디코더 SWA 캐시를 재구성한 뒤, 후속 토큰을 순서대로 재생하며 각 샘플 행동을 소비하기 전에 선행 상태에서 현재 정책 로그확률을 읽고, RL 손실을 구성하되 외부 사용자·도구 토큰에는 정책 행동 인자를 부여하지 않으며, 역전파·갱신 뒤 파라미터 의존 캐시를 무효화한다. 행동 마스크는 정책 손실 항만 고르며 외부 토큰 갱신을 지나는 기울기 추적을 꺼서는 안 된다. 논문 Appendix A.4
같은 부록은 결정론을 요구한다. 드롭아웃을 끈 것 같은 결정론적 정책 정방향은 내부 확률 계산의 모호성을 피하며, 그렇지 않으면 정책이 그 무작위성을 어떻게 조건화하거나 주변화하는지를 명세해야 한다. "임의의 단일 확률적 재생은 일반적으로 주변 행동 확률이 아니다." 스케줄 일치만으로 커널이나 정밀도 설정을 가로지르는 수치적 동등성이 확립되지 않는다는 문장이 여기서도 반복된다. 논문 Appendix A.4
다중 턴 서빙은 같은 원리의 적용이다. 새 사용자 메시지·도구 결과·역할 구분자·어시스턴트 토큰이 모두 인코더와 디코더 갱신을 받고, 도구 반환 시 새로 관측된 구간을 캐시된 인코더 접두부로 인코딩한 뒤 기존 상태에서 모든 새 토큰을 지나 디코더를 전진시키며 재설정 없이 생성을 재개한다. 논문 §6 정확한 접두부 스냅숏은 인코더 캐시·인코더 유도 교차 어텐션 메모리·완전 디코더 상태·토큰과 위치 메타데이터·SWA 윈도 규약·모델 버전을 담는다. 접두부를 삭제·편집·절단하면 조건 이력이 바뀌므로 제거된 내용을 포함한 상태를 유지하는 대신 유효한 이전 체크포인트에서 재계산해야 하고, 이전 토큰을 다시 쓰는 템플릿 추가는 추가 전용 캐시 연산이 아니다. 논문 §6
7. 기존 방법과의 관계
논문의 관련 연구 절은 각 선행 방법과의 차이를 되먹임 위치와 메모리 표현으로 정리한다. 아래 표는 논문 §7의 서술을 옮긴 것이다. 논문 §7
| 선행 연구 | 핵심 아이디어 (논문 서술) | RLT와의 차이 (논문 서술) |
|---|---|---|
| Chen et al. (2018) | Transformer 인코더 + LSTM 기반 RNMT+ 디코더의 기계번역 하이브리드 | 순환 전이가 교차 어텐션과 SWA를 가진 Transformer 블록 스택이고, 하나의 인과 언어 모델에서 모든 프롬프트·응답 토큰을 지난다 |
| YOCO, Sun et al. (2024) | 상위 교차 디코더를 위한 재사용 가능 KV 메모리, 프리필 조기 종료 | 인코더 유도 메모리는 유지하되 모든 프롬프트 토큰을 순환 디코더로 처리하므로 프롬프트 전역 디코더 건너뛰기를 물려받지 않는다 |
| DeepSeek-V4.1-Flash (2026) | 최종 인코더 상태에서 디코더 전역 KV를 투영, 디코더 SWA 별도 처리 | 위와 같음 |
| Feedback Transformer, Fan et al. (2020) | 처리된 과거 표현을 미래 계산에 노출 | 되먹임 위치가 다르다. 직전 최종 디코더 출력을 다음 디코더 입력에 넣고, 전역 메모리는 인코더 유도, 국소 SWA KV는 디코더 유도 |
| Recurrent Transformer, Oncescu et al. (2026) | 각 층의 지속 KV를 그 층 출력에서 형성, 정확한 타일링 스케줄 | 층별 RT 타일링 결과가 이 전체 디코더 순환의 커널이 자동으로 되지는 않는다 |
| Full-bandwidth Transformer, Wang et al. (2026) | 직전 최상층 은닉 상태를 게이트 선형 유닛으로 다음 토큰 임베딩과 융합, 다중 패스 학습과 접두부 혼합 | RLT의 연속 출력→입력 되먹임의 직접 선행. RLT는 인코더–디코더 인터페이스에서 되먹임을 주입하고 완전 이력 순차 재생을 참조 학습 계산으로 삼는다 |
| T2MLR, Cai et al. (2026) | 캐시된 중간층 표현을 현재 위치의 앞 층에 되먹임. 국소 중간층 순환이 전체 순환을 능가할 수 있다는 실험 | RLT는 전체 디코더를 통한 최종 출력 되먹임을 명세한다. "이 선택들은 계산과 학습 의미론을 구분하지만, 어느 쪽에 대해서도 경험적 우위를 확립하지 않는다" |
| LRT, Huang et al. (2026) | 직전 토큰의 상위 층 상태를 KV 투영과 잔차 주입으로 재사용, 표준 디코더 전용 백본 유지. RL에서는 분리된 롤아웃 상태로 버퍼 초기화 | RLT는 인코더 메모리/순환 디코더 분리를 명세하고 정확한 정책 재생을 위해 현재 파라미터로 완전 이력을 재구성한다. "캐시된 행동 상태는 갱신 뒤 현재 정책 상태의 대체물이 아니다" |
| Coconut, Hao et al. (2024); PonderLM-2, Zeng et al. (2025) | 마지막 은닉 상태를 다음 입력 임베딩으로 되먹이는 잠재 추론 단계 / 사전학습에 잠재 사고 삽입 | RLT는 보조 잠재 위치나 별도 잠재 모드 없이 지속 디코더 출력을 각 토큰의 인코더 표현과 병합한다. 시간 깊이가 통상 토큰과 함께 자란다 |
| Block-Recurrent, Hutchins et al. (2022); RMT, Bulatov et al. (2022) | 블록·세그먼트 단위 상태 전파 | RLT는 매 토큰 갱신하므로 토큰 수준 순차 순환의 비용을 치르고 블록 수준 학습 스케줄을 물려받지 않는다 |
| Universal Transformers, Dehghani et al. (2018); Geiping et al. (2025) | 깊이 방향 계산 공유 / 순환 블록 반복으로 시험 시점 계산 확장 | RLT의 상태는 토큰을 가로질러 전진하고, 묶음 구성은 호환 인코더·디코더 가중치를 추가로 공유한다. "가중치 묶기도 시간 순환도 단독으로는 신규성이나 품질 개선을 확립하지 않는다" |
이 절에서 두 가지를 짚어 둘 필요가 있다.
첫째, 논문은 자기 위치를 낮게 잡는다. "Transformer 인코더와 순환 디코딩의 결합은 확립된 아이디어다"라는 문장 논문 §7과 "가중치 묶기도 시간 순환도 단독으로는 신규성이나 품질 개선을 확립하지 않는다"라는 문장 논문 §7이 논문의 것이다. 신규성 주장은 전체 디코더 순환과 그 하드웨어 실행·RL 재생 의미론의 결합 명세에 놓인다. 논문 §7
둘째, 표 안에 논문이 답하지 않은 반례가 하나 있다. T2MLR은 국소 중간층 순환이 전체 네트워크 순환을 능가할 수 있다는 실험을 보고하고, 논문은 이를 "더 깊은 순환 블록이 자동으로 더 낫지는 않다"고 요약한다. RLT의 설계 선택은 정확히 전체 디코더 순환이다. 논문은 그 차이를 "계산과 학습 의미론의 구분"으로 재기술할 뿐 T2MLR의 결과를 반박하거나 자기 설계가 왜 그 결과에 해당하지 않는지를 논증하지 않는다. LRT와의 대비도 마찬가지다. LRT가 분리된 롤아웃 상태로 RL 버퍼를 초기화해 롤아웃/재계산 불일치를 줄이는 반면 RLT는 정확 재생을 요구하는데, 그 정확성이 실제 RL 결과에서 무엇을 사는지는 이 논문이 가장 직접적으로 물을 수 있었던 비교인데 측정하지 않았다. 논문 §7
8. 방법적 한계와 확장
8.1 논문이 밝힌 한계
이 논문의 자기 한정은 예외적으로 촘촘하다. 절마다 하나씩 있다.
- 측정된 효율이나 스케일링 결과를 보고하지 않는다. 논문 §1
- 구조가 경로를 만들 뿐, 그 경로를 따라 유용한 추론을 학습하는 것은 별개의 질문이다. 논문 §1
- 되먹임 크기의 초기화는 후보이지 확립된 안정성 처방이 아니다. 논문 §2.5
- 두 논리적 패스가 블록당 같은 FLOPs를 뜻하지 않는다. 논문 §2.6
- 명제 3.1은 수학적 동치이며 커널·정밀도의 수치적 불일치는 남는다. 논문 §3.1
- 프리필 축소 가속은 주장하지 않으며 상태 순환은 하드웨어 이용률을 낮출 수 있다. 논문 §3.2
- 구조적 깊이만으로는 추론을 보장하지 않으며, 게이트·수축·투영이 긴 경로의 기여를 억제할 수 있다. 논문 §3.3
- 배치·메모리 재사용·커널 융합은 구현 목표이지 측정된 가속이 아니다. 하드웨어 효율은 측정되기 전까지 공학 목표다. 논문 §4.2–4.3
- 공유된 구조적 전이만으로는 수치적 커널 동등성이 증명되지 않는다. 올바른 로그확률이 임의의 오프폴리시 손실을 비편향으로 만들지 않는다. 논문 §5.3
- 어느 선행 방법에 대해서도 경험적 우위를 확립하지 않으며, 가중치 묶기도 시간 순환도 단독으로 신규성을 확립하지 않는다. 논문 §7
- 계산적 정의는 명시적이지만 실현된 추론 품질·하드웨어 효율·스케일링 거동은 향후 검증을 요한다. 논문 §8
- 정규화만으로는 상태 경로 야코비안들의 곱을 유계로 만들지 못한다. 논문 Appendix B
8.2 해설자 관점
논문이 인정한 것 위에 다음을 덧붙인다.
- 안정성은 인정만 되고 다뤄지지 않았다. 부록 B가 야코비안 곱의 비유계성을 사실로 적고 논문 §2.5가 초기화를 처방이 아니라고 적은 이상, "무한 시간 깊이"는 학습 가능한 깊이가 아니라 정의된 깊이다. 게이트와 정규화 자체는 병합 식 (2.9)–(2.11)에 명세되어 있다. 명세되지 않은 것은 그것들이 긴 경로의 야코비안 곱을 묶는다는 논증이며, 기울기 클리핑·스펙트럴 제약·상태를 지나는 보호된 선형 경로처럼 긴 의존을 직접 겨냥한 장치도 없다. 부록 B는 정규화만으로는 그 곱이 유계가 되지 않는다고 적을 뿐 대안을 제시하지 않는다. 이 구조의 첫 번째 실증 질문은 품질이 아니라
t가 수천에 이를 때\prod J_t의 거동이다. - 순차 프리필의 크기가 없다. 논문 §3.2는
T \cdot L_D의 순차 깊이를 받아들인다고 적지만,T가 수천 토큰인 프롬프트에서 그것이 지연 시간으로 얼마인지, 시퀀스 간 배치가 어느 배치 크기부터 이용률을 회복하는지를 재지 않는다. 논문 §4의 두 관찰이 이 비용을 상쇄한다는 주장은 논문에 없고, 상쇄하지 않는다는 계산도 없다. - 정확 재생의 비용은 최적화 패스 수에 비례한다. 논문 §5.4는 갱신마다 시퀀스 시작부터 재계산해야 하며 이것이 모든 반복 패스에 적용된다고 적는다. 표준 모델에서 재사용되는 프롬프트 계산이 RLT에서는 패스마다 반복된다. 이 곱의 크기가 없는 채로 "신뢰할 수 있는 RL 스케일링의 기반"이라는 결론 문장이 서 있다.
- 재현 표면이 없다. 코드, 하이퍼파라미터, 모델 크기, 학습 데이터, 어떤 규모의 실행도 없다. 48층·폭
d는 예시 계수다. 프로젝트 페이지는 논문 1쪽에 주소만 적혀 있고, 이 검토는 PDF만을 정본으로 삼았으므로 그 페이지에 무엇이 있는지 판정하지 않는다. - RL 논증의 두 전제가 모두 자기 인용이다. "정방향 일치는 기울기 일치가 아니다"와 "실행된 정책은 가중치와 실행 선택의 함수다"라는 두 관점은 모두 Zhang et al. (2026)에서 오는데, 이는 같은 저자의 앞선 기술 보고서이며 마찬가지로 심사되지 않았다. RLT의 RL 공동설계 논증은 그 보고서의 문제 설정을 전제한다.
- 단독 저자, 미심사, 비arXiv. 19쪽 보고서에 저자가 한 명이고 발표 venue가 없으며 조회 시점에 arXiv에도 없다. 이 사실은 내용의 옳고 그름과 무관하지만, 위의 네 항목이 어느 것도 외부 검증을 거치지 않았다는 뜻이다.
8.3 확장 방향
논문이 미룬 검증을 실제로 수행하려면 다음 순서가 자연스럽다.
- 고정된
L에서T를 늘리며 프리필 지연을 측정하고, 시퀀스 간 배치 크기에 따른 이용률 곡선을 그린다. 이것이 논문 §4의 두 관찰이 논문 §3.2의 비용을 얼마나 되찾는지 보여 준다. - 상태 경로 길이에 따른
\prod J_t의 노름을 학습 중 추적하고,\alpha·게이트·정규화 선택이 그 거동을 어떻게 바꾸는지 비교한다. - 논문이 별개라고 선언한 두 오차원, 즉 구조 유도 상태 불일치와 통상적 정책 지연을 분리해 측정한다. LRT의 분리 롤아웃 상태 초기화와 RLT의 정확 재생을 같은 백본·같은 롤아웃에서 비교하면 정확성이 사는 것이 드러난다.
- T2MLR의 국소 중간층 순환과 전체 디코더 순환을 같은 파라미터 예산에서 맞비교한다. 이것은 논문이 인용하고 답하지 않은 반례에 대한 직접 응답이다.
8.4 발전사 landscape
| 연도 | 연구 | 이 계보에서의 위치 |
|---|---|---|
| 2018 | Chen et al., RNMT+ 하이브리드 | Transformer 인코더 + 순환 디코더 분업의 초기 형태 |
| 2018 | Dehghani et al., Universal Transformers | 깊이 방향 계산 공유 |
| 2020 | Fan et al., Feedback Transformer | 처리된 과거 표현을 미래 계산에 노출 |
| 2022 | Hutchins et al., Block-Recurrent; Bulatov et al., RMT | 블록·세그먼트 단위 상태 전파 |
| 2024 | Sun et al., YOCO | 인코더 유도 KV 메모리 재사용, 프리필 조기 종료 |
| 2024 | Hao et al., Coconut | 마지막 은닉 상태를 다음 입력으로 되먹이는 잠재 추론 |
| 2025 | Geiping et al. | 순환 블록 반복으로 시험 시점 계산 확장 |
| 2025 | Zeng et al., PonderLM-2 | 사전학습에 잠재 사고 삽입, Jacobi 반복 근사 |
| 2026 | Oncescu et al., Recurrent Transformer | 층별 지속 KV와 정확 타일링 스케줄 |
| 2026 | Wang et al., Full-bandwidth Transformer | 최상층 은닉 상태를 다음 토큰 임베딩과 게이트 융합 |
| 2026 | Cai et al., T2MLR | 국소 중간층 순환이 전체 순환을 능가할 수 있음을 실험으로 보임 |
| 2026 | Huang et al., LRT | 상위 층 상태 재사용, RL에서 분리 롤아웃 상태로 버퍼 초기화 |
| 2026 | Zhang et al., Prefill–Decode 커널 불일치 보고서 | 실행된 정책을 가중치와 실행 선택의 함수로 봄 |
| 2026 | Zhang, RLT | 전체 디코더 순환 + 인코더 메모리 + 정확 RL 재생의 결합 명세. 실험 없음 |
9. 결론
9.1 핵심 기여 요약
| 기여 | 내용 | 의의와 한계 |
|---|---|---|
| 하나의 전이 | 프롬프트와 응답의 모든 토큰이 같은 F_t를 지나며 서빙 경계에서 재설정되지 않는다 |
명제 3.1이 정의에서 곧바로 따르는 성질을 못 박는다. 커널 수준 동등성은 별개다 |
| 두 저장소의 분리 | 인코더 유도 전역 메모리 M_{\le t}와 디코더 유도 국소 캐시 C^D_t |
인코더 작업의 병렬성과 디코더 작업의 시퀀스 간 배치를 노출한다. 시퀀스 안의 순차 깊이 T \cdot L_D는 그대로다 |
| 정확 재생 계약 | 갱신마다 전체 이력을 현재 파라미터로 재구성하고 행동 로그확률만 보존한다 | 무엇을 재계산해야 하는지가 텐서 단위로 명세된다. 비용은 최적화 패스 수에 비례하며 측정되지 않았다 |
| 자기 한정 | 절마다 측정하지 않은 것을 명시한다 | 과장은 없다. 검증도 없다 |
9.2 연구적 함의와 향후 방향
이 보고서는 하나의 질문에 정확히 답한다. 순환 상태를 가진 언어 모델에서 프롬프트 경계가 정책 정의를 갈라놓지 않으려면 무엇이 같아야 하고, 파라미터가 바뀐 뒤 무엇을 다시 계산해야 하는가. 그 답은 텐서 단위로 명세되어 있고 두 개의 짧은 귀납 증명이 그 명세의 정합성을 보인다. 이 명세의 가치는 RL 학습 인프라를 짜는 사람에게 있다. 분리해도 되는 텐서와 분리하면 안 되는 텐서, 캐시해도 되는 조건과 캐시가 무효가 되는 조건이 한 곳에 적혀 있다.
이 보고서가 답하지 않는 질문은 그 명세대로 만든 모델이 무엇을 하는가이다. 상태 경로가 길어질 때 기울기가 살아남는지, 순차 프리필이 실제 지연으로 얼마인지, 정확 재생이 근사 재생보다 RL 결과를 실제로 바꾸는지, 전체 디코더 순환이 T2MLR이 보고한 국소 순환의 우위를 뒤집는지. 논문은 이 네 질문을 모두 미루었고 미뤘다고 적었다. 이 구조를 옮겨 쓰려는 독자는 §6의 재생 계약을 그대로 가져가되, §8.2의 첫 세 항목을 자기 규모에서 먼저 재야 한다.
References
Bulatov, A., Kuratov, Y., & Burtsev, M. S. (2022). Recurrent memory transformer (arXiv:2207.06881). arXiv. arXiv 논문
Cai, Z., Zhu, X., Dong, Y., He, Y., & Arora, S. (2026). T2MLR: Transformer with temporal middle-layer recurrence (arXiv:2607.15178). arXiv. arXiv 논문
Chen, M. X., Firat, O., Bapna, A., Johnson, M., Macherey, W., Foster, G., Jones, L., Parmar, N., Schuster, M., Chen, Z., Wu, Y., & Hughes, M. (2018). The best of both worlds: Combining recent advances in neural machine translation (arXiv:1804.09849). arXiv. arXiv 논문
DeepSeek-AI. (2026). DeepSeek-V4.1-Flash: Pushing the limits of KV cache compression [Technical report]. DeepSeek-AI. 기술 보고서
Dehghani, M., Gouws, S., Vinyals, O., Uszkoreit, J., & Kaiser, Ł. (2018). Universal transformers (arXiv:1807.03819). arXiv. arXiv 논문
Fan, A., Lavril, T., Grave, E., Joulin, A., & Sukhbaatar, S. (2020). Addressing some limitations of transformers with feedback memory (arXiv:2002.09402). arXiv. arXiv 논문
Geiping, J., McLeish, S., Jain, N., Kirchenbauer, J., Singh, S., Bartoldson, B. R., Kailkhura, B., Bhatele, A., & Goldstein, T. (2025). Scaling up test-time compute with latent reasoning: A recurrent depth approach (arXiv:2502.05171). arXiv. arXiv 논문
Hao, S., Sukhbaatar, S., Su, D., Li, X., Hu, Z., Weston, J., & Tian, Y. (2024). Training large language models to reason in a continuous latent space (arXiv:2412.06769). arXiv. arXiv 논문
Huang, Z., He, X., Ren, L., Wang, Y., Peng, B., Cheng, H., Wang, S., He, P., Gao, J., Lee, Y. J., & Shen, Y. (2026). Latent recurrent transformer: Architecture exploration, training strategies, and scaling behavior (arXiv:2605.26797). arXiv. arXiv 논문
Hutchins, D., Schlag, I., Wu, Y., Dyer, E., & Neyshabur, B. (2022). Block-recurrent transformers (arXiv:2203.07852). arXiv. arXiv 논문
Oncescu, C.-A., Morwani, D., Jelassi, S., Meterez, A., Kwun, M., & Kakade, S. (2026). The recurrent transformer: Greater effective depth and efficient decoding (arXiv:2604.21215). arXiv. arXiv 논문
Sun, Y., Dong, L., Zhu, Y., Huang, S., Wang, W., Ma, S., Zhang, Q., Wang, J., & Wei, F. (2024). You only cache once: Decoder-decoder architectures for language models (arXiv:2405.05254). arXiv. arXiv 논문
Wang, X., Cai, Z., Zhan, Z., Dong, H., Fan, Y., de Rosa, G., Pearce, T., & Langford, J. (2026). Full-bandwidth transformer (arXiv:2608.08888). arXiv. arXiv 논문
Zeng, B., Li, H., Song, S., Wang, Y., He, Z., Wang, X., & Lin, Z. (2025). PonderLM-2: Pretraining LLM with latent thoughts in continuous space (arXiv:2509.23184). arXiv. arXiv 논문
Zhang, Y. (2026). Recurrent Looped Transformer [Technical report, 2026-09-12]. PDF
Zhang, Y., et al. (2026). Reliable RL scaling requires accounting for Prefill–Decode kernel mismatch [Technical report, Pretraining-RL-Science project, 2026-08-06, revised 2026-08-24]. PDF