WFM: Wiki Foundation Model for Complex Agentic Reasoning
WFM: 관계 지도에 원문 문단까지 함께 담으면
WFM은 엔티티 관계와 원문 문단을 한 그래프에서 학습한다. 관계 인지 주의와 반복 검색의 설계를 살펴보고, 논문이 명시한 계획값·실측 구분의 불확실성과 성능표의 집계 문제를 함께 검토한다.
Paper: Junnan Dong; Linhao Luo; Senlei Zhang; et al. (2026). WFM: Wiki Foundation Model for Complex Agentic Reasoning. arXiv:2609.18182v1 · 원문 PDF. 이 글은 2026년 9월 16일 공개된 v1을 기준으로 한다.
여러 문서를 읽고 답해야 하는 AI에게는 두 가지가 필요하다. 무엇과 무엇이 연결되는지 알려 주는 관계 지도, 그리고 그 연결이 어떤 맥락에서 성립하는지 설명하는 원문이다. 관계만 남기면 세부 조건을 놓칠 수 있고, 문단만 따로 찾으면 문서 사이를 건너가는 연결을 놓칠 수 있다.
WFM은 이 둘을 한 그래프에 넣고 함께 학습하자는 제안이다. 다만 이 논문은 아이디어와 성능 근거를 나누어 읽어야 한다. v1에는 일부 표와 진단 실험이 실측 검증이 필요한 계획값이라는 문장이 있고, 어느 값인지는 밝혀져 있지 않다. 아래 숫자는 논문에 적힌 비교를 설명하기 위한 것이지, 검증된 도입 효과를 뜻하지 않는다.
수식과 표의 집계 문제를 자세히 다룬 글은 WFM 딥리뷰에 있다.
1. 관계 지도만으로는 부족한 질문이 있다
예를 들어 “이 연구자가 어떤 기관에서 그 프로젝트를 수행했는가”를 묻는다고 하자. 연구자·기관·프로젝트를 연결한 지도는 답을 찾을 방향을 알려 준다. 그런데 중간에 소속이 바뀌었거나 예외적인 공동 작업이었다면, 문단 속의 시점과 조건까지 읽어야 한다. 이 예시는 표현의 차이를 설명하기 위한 것으로 논문의 실험 문항은 아니다.
GraphRAG는 관계 구조를 활용해 이런 다단계 검색을 돕는 접근이다. WFM은 그중에서도 관계를 간결하게 추출하는 과정에서 원문 맥락이 줄어드는 문제에 주목한다. 물론 모든 GraphRAG가 원문을 버리는 것은 아니다. 요약과 계층 구조를 함께 쓰는 방법도 있으므로, 기존 방식 전체를 하나의 한계로 묶어서는 안 된다.
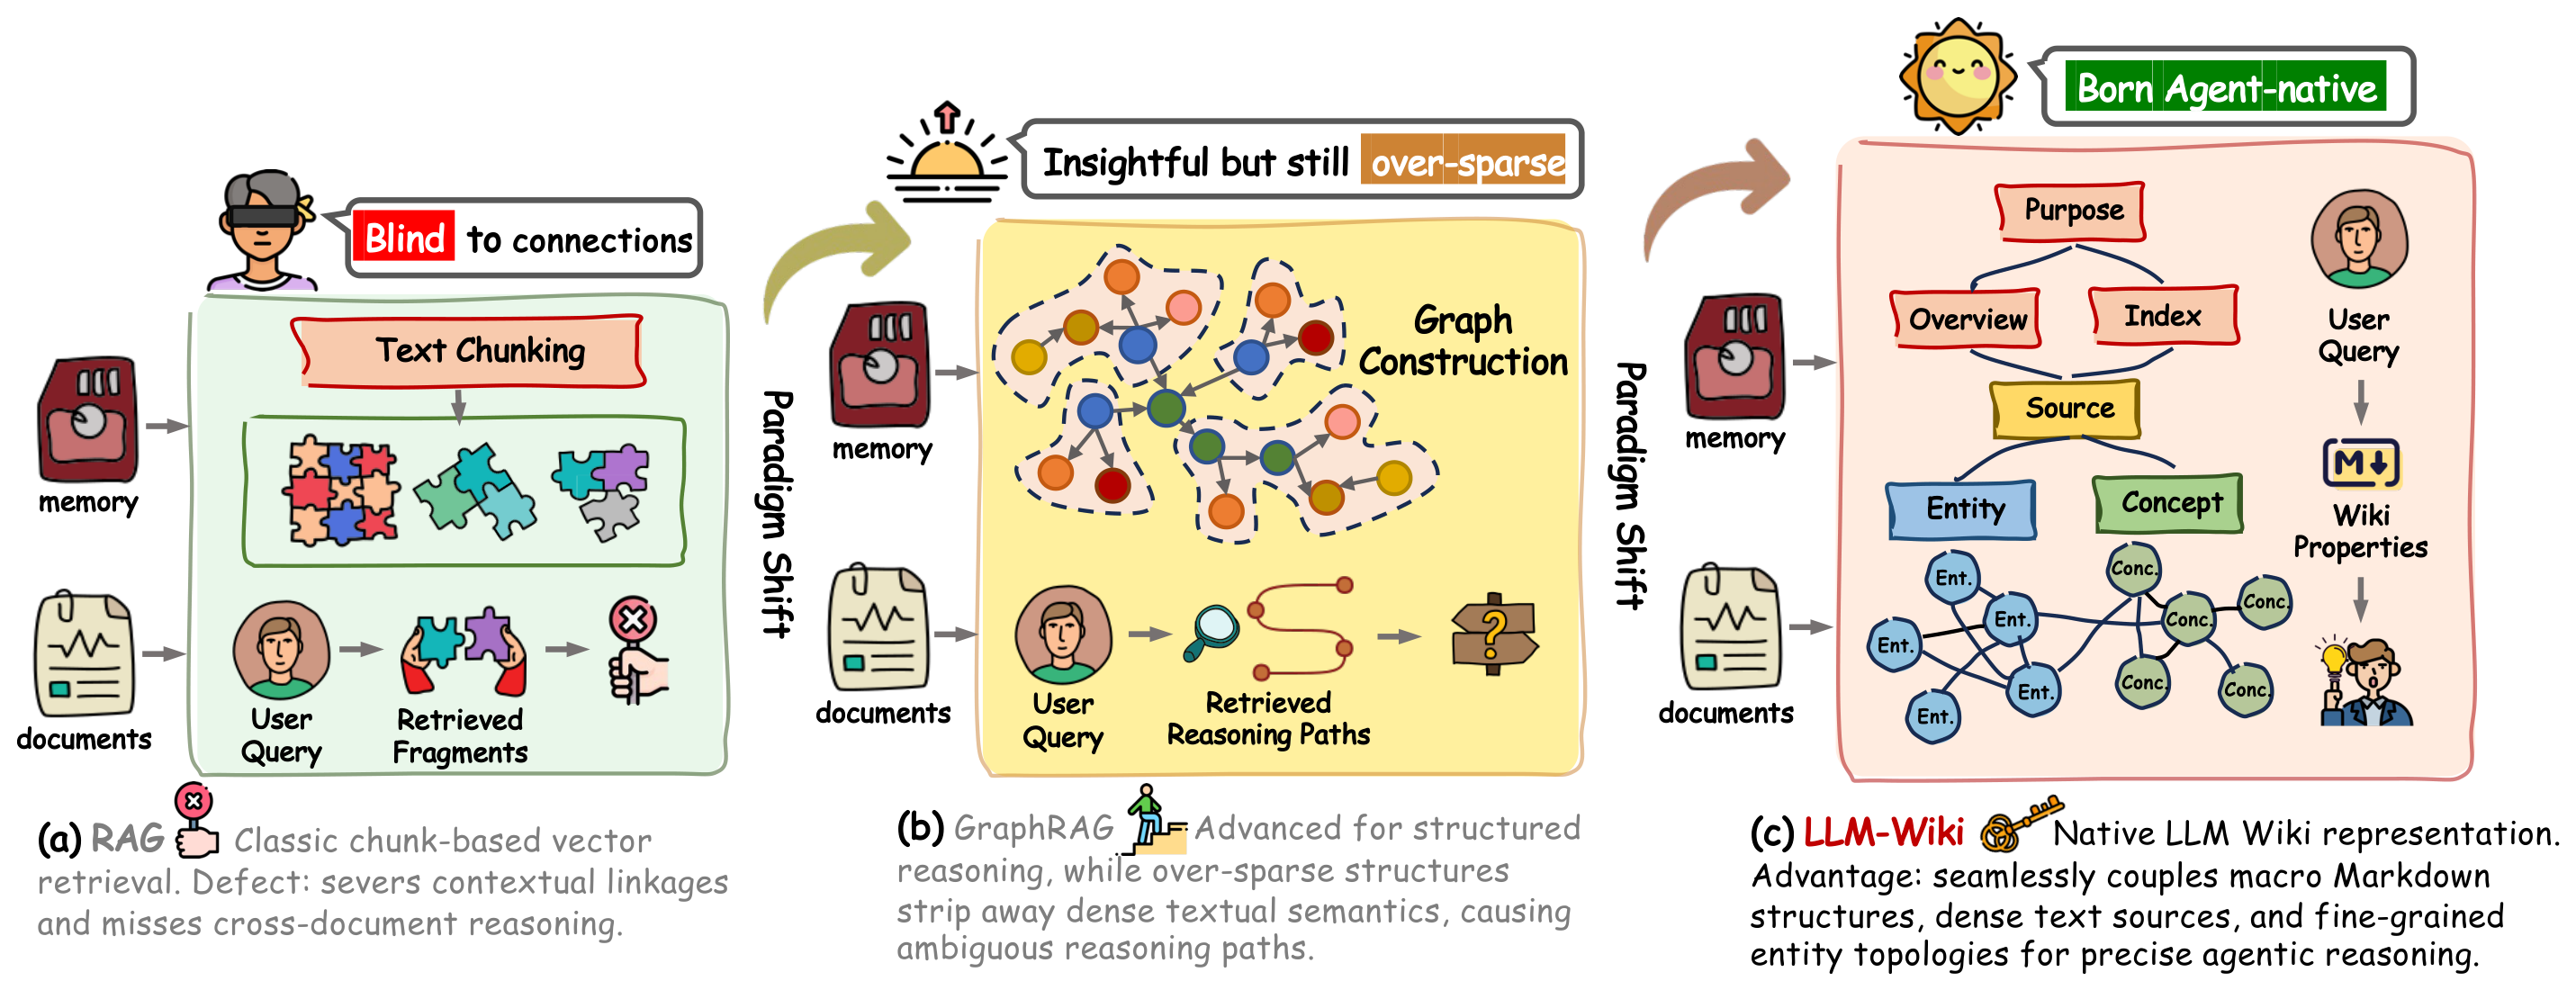
그림 1. 저자들은 문서의 맥락과 관계 구조를 함께 다루는 LLM Wiki를 제안한다. 그림의 ‘패러다임 전환’은 저자들의 관점이며 산업 전체에 대한 검증 결과는 아니다. 원논문 v1, 1쪽 Figure 1에서 인용.
2. 문단을 지도 바깥에 두지 않는다
WFM의 그래프에는 엔티티뿐 아니라 문단 자체도 노드로 들어간다. 엔티티는 사람·기관·개념처럼 연결의 대상이 되는 항목이다.
연결도 둘이다. 하나는 엔티티와 엔티티 사이의 관계이고, 다른 하나는 엔티티와 그 내용을 설명하는 문단 사이의 연결이다. 이렇게 하면 관계를 따라가다가 해당 문단의 정보를 받을 수 있다. 문단 전체를 또 하나의 짧은 관계로 압축할 필요가 없다.
여기서 ‘Wiki’라는 이름이 곧 위키백과를 뜻하는 것은 아니다. 논문은 마크다운 문서, 밀집된 설명, 여러 층의 연결을 가진 지식 표현을 LLM Wiki라고 부른다. WFM의 추가 제안은 이 자료를 저장하는 데 그치지 않고, 그 구조 위에서 검색에 쓸 표현을 학습하는 것이다. 논문 §3.1
3. 어떤 이웃을 더 참고할지 배운다
연결된 정보를 모두 같은 비중으로 섞으면 중요한 문단과 무관한 문단의 차이가 희미해질 수 있다. WFM은 관계 유형과 노드의 표현을 보고, 각 이웃의 정보를 얼마나 받을지 정한다. 관계 이웃과 문단 이웃이 같은 이웃집합에서 비중을 나눈다는 점이 특징이다.
질문도 계산 범위를 바꾼다. 먼저 질문과 관련된 엔티티·문단을 골라 지역 그래프를 정하고, 그 안에서 정보를 전달한다. 논문의 ‘질의 조건부’라는 표현은 우선 이 선택을 가리킨다.
학습할 때는 관계 구조를 유지하는 목표, 엔티티와 문단을 맞추는 목표, 주의 점수가 지나치게 같아지는 것을 억제하는 목표를 함께 쓴다. 마지막 장치는 낮은 분산에 벌점을 주는 방식이다. 벌점이 있다는 이유만으로 문제가 반드시 해결되는 것은 아니다. 무엇이 관련 근거인지 알려 주는 신호도 별도로 필요하다. 논문 §3.2·3.4
4. 한 번에 답하지 못하면 근거를 더 모은다
검색 루프는 비교적 직관적이다.
- 현재 질문으로 문단을 검색한다.
- 이전에 찾은 근거에 새 문단을 더한다.
- 후보 답과 함께, 더 찾아야 할 것이 있는지 판단한다.
- 충분하다고 판단하면 멈추고, 부족하면 후속 질문으로 다시 검색한다.
기본 설정은 한 번에 20개 문단, 최대 네 번의 검색·생성 반복이다. 문단 수와 반복 횟수는 다른 예산이다. 네 번까지 허용해도 완료 플래그가 나오면 일찍 멈춘다. 다만 완료 플래그는 모델의 판단이므로, 그 자체가 답의 정확성을 보증하지는 않는다. 논문 §3.3
큰 그래프를 여러 GPU에서 학습하는 시스템 설계도 포함된다. 그래프 분할과 경계 노드의 위치가 고정되어 있다는 점을 이용해, 바뀌는 표현값만 GPU 사이에서 교환한다. 논문은 약 10.5배의 학습 가속을 적지만 GPU 구성과 측정 조건이 충분하지 않아 같은 이득을 기대할 근거는 부족하다. 이것은 검색 응답이 10.5배 빨라진다는 뜻도 아니다.
5. 표에서는 무엇이 높고, 무엇이 예외인가
논문은 여러 문서를 연결해 답하는 세 과제와 긴 대화 이력을 사용하는 두 기억 과제를 다룬다. 여기서 재현율은 찾아야 할 근거를 검색 결과가 얼마나 포함했는지, 정확도는 생성한 답을 판정한 결과다. 둘은 같은 지표가 아니다.
아래는 원문의 일부 기재값이다. 계획값과 실측의 범위가 불명확하다는 유보가 이 비교에도 적용된다.
| 비교 | WFM | 비교 상대 | 읽을 때 주의할 점 |
|---|---|---|---|
| HotpotQA 검색 재현율@20 | 93.20% | Youtu-GraphRAG 89.70% | 이 열에서는 WFM이 가장 높다. |
| MuSiQue 검색 재현율@20 | 75.24% | Youtu-GraphRAG 75.90% | 모든 검색 조건에서 최고인 것은 아니다. |
| PersonaMem Overall 정확도 | 58.49% | MemoryOS 50.1% | Overall의 집계식을 확인해야 한다. |
| RHELM Overall 정확도 | 52.17% | 전체 맥락 제로샷 46.8% | 가장 높은 기준선은 검색 없이 이력 전체를 읽는다. |
멀티홉 답변 정확도에서는 검색 근거만 쓰는 Reject와 모델의 내부 지식도 허용하는 Open을 나눈다. Table 2의 여섯 열은 모두 WFM이 가장 높고, 비교 상대와의 차이는 Reject 쪽에서 더 크다. 저자들은 이를 근거 기반 답변의 개선으로 해석한다. 다만 이 표만으로 그 효과가 실측으로 검증됐다고 말할 수는 없다.
RHELM에서는 전체 맥락 기준선이 특히 중요하다. WFM 계열을 제외한 여덟 검색·기억 방법은 모두 이력을 통째로 읽는 기준선보다 낮게 기재되어 있다. 검색이 있다는 사실만으로 답이 더 좋아지는 것은 아니다. 긴 입력을 그대로 사용할 수 있는 환경이라면, 검색의 정확도와 비용을 그 방식과 함께 비교해야 한다. 논문 §4
6. 이 판본에서 아직 결론 낼 수 없는 것
가장 먼저 확인할 것은 논문 §4.4의 이 문장이다.
“The newly completed cells and diagnostic sweeps are constructed planning values and require validation with measured runs before external use.”
새로 채운 칸과 진단 스윕은 구성된 계획값이며, 외부 사용 전에 실측 검증이 필요하다는 뜻이다. 일부라는 범위는 적혀 있지만 해당 칸의 목록은 없다. 따라서 모든 결과를 실측으로 읽어서도, 반대로 전부 계획값이라고 단정해서도 안 된다.
집계 문제도 남는다. WFM의 기억 과제 Overall은 표에 적힌 일곱 범주의 단순평균과 약 0.89~3.12%p 다르다. 범주별 문항 수로 가중했을 가능성 등을 판단하려면 집계식과 원자료가 필요하다. 이 차이만으로 잘못된 수치라고 확정하거나, 어느 값이 계획값인지 찾아낼 수는 없다. 단순평균을 쓰면 오히려 WFM의 값이 높아지는 방향이므로 성능 부풀리기의 증거로 읽는 것도 부적절하다.
절제 그림은 문단 노드, 학습 방식, 반복 검색, 조기 종료의 역할을 나누려 한다. 그러나 진단 스윕의 실측 검증이 필요한 상황에서 “반드시 세 층을 쓰라”거나 “이 설정이면 비용이 줄어든다”는 실무 지침으로 옮길 수는 없다. 상세한 수치 검토
7. 가져갈 아이디어와 보류할 결론
가져갈 아이디어는 관계와 원문을 함께 보존하고, 같은 그래프에서 정보를 교환하며, 부족한 근거는 다시 찾는다는 설계다. 단순히 문서를 더 많이 넣는 대신 지식의 표현과 검색 과정을 함께 설계하려는 접근이다.
보류할 결론은 성능 우위와 가속률이다. 어느 값이 실측인지, 정확도를 어떻게 집계했는지, 어떤 장비와 조건에서 시간을 쟀는지가 명확해져야 한다. 이 글은 원문과 도판을 검토한 해설이며 모델을 재학습하거나 벤치마크를 재현한 결과는 아니다.
WFM은 텍스트와 그래프를 결합하는 방법을 검토할 자료다. 하지만 현재 v1의 숫자만으로 기존 검색 시스템을 교체할 이유가 확립되었다고 보기는 어렵다. 설계의 가능성과 그 가능성을 뒷받침하는 증거는 별도로 평가해야 한다.
References
- Dong, J.; Luo, L.; Zhang, S.; et al. (2026). WFM: Wiki Foundation Model for Complex Agentic Reasoning. arXiv:2609.18182v1. 본문의 방법·수치·유보 문장은 이 판본을 기준으로 한다.
- Luo, L.; Zhao, Z.; Haffari, G.; et al. (2025). GFM-RAG: Graph Foundation Model for Retrieval Augmented Generation. arXiv:2502.01113.
- Dong, J.; An, S.; Yu, Y.; et al. (2025). Youtu-GraphRAG: Vertically Unified Agents for Graph Retrieval-Augmented Complex Reasoning. arXiv:2508.19855.