WFM: Wiki Foundation Model for Complex Agentic Reasoning
WFM은 엔티티 관계와 원문 문단을 한 그래프에서 학습한다. 관계 인지 주의와 반복 검색의 설계를 살펴보고, 논문이 명시한 계획값·실측 구분의 불확실성과 성능표의 집계 문제를 함께 검토한다.
Paper: Junnan Dong; Linhao Luo; Senlei Zhang; Gong Chen; Taian Guo; Yifei Yu; Rong Tao; Tao Guo; Qian-wen Zhang; Siyu An; Ruizhi Qiao; Xing Sun (2026). WFM: Wiki Foundation Model for Complex Agentic Reasoning. arXiv:2609.18182v1 (2026-09-16). 논문 PDF · HTML. 이 글은 10쪽의 v1을 기준으로 한다. 논문에는 확정된 학회명이나 코드 저장소 주소가 제시되어 있지 않다.
Abstract: 여러 문서에 흩어진 근거를 찾아야 하는 에이전트에게는 관계 구조와 원문의 맥락이 모두 필요하다. WFM은 엔티티 사이의 관계와 문단 노드를 하나의 Wiki Graph에 담고, 같은 주의·갱신 규칙으로 표현을 학습한다. 여기에 주의 로짓의 분산 정칙화, 근거를 누적하는 반복 검색, GPU 간 경계 상태 교환을 결합한다. 설계의 중심은 문단을 단순한 검색 결과가 아니라 그래프 안에서 정보를 주고받는 노드로 다루는 데 있다. 다만 v1은 일부 표와 진단 실험이 실측 검증이 필요한 계획값이라고 명시하면서 그 범위를 특정하지 않는다. 따라서 이 글은 방법의 설계, 논문에 기재된 수치, 그 수치로 아직 판단할 수 없는 것을 구분한다.
수식 없이 읽는 버전은 쉽게 읽는 WFM에 있다.
수치를 읽기 전에: §4.4의 마지막 문장은 “The newly completed cells and diagnostic sweeps are constructed planning values and require validation with measured runs before external use”다. 새로 채운 칸과 진단 스윕은 구성된 계획값이며 외부 사용 전에 실측 검증이 필요하다는 뜻이다. 어느 칸인지 명시되어 있지 않으므로, 아래 표는 v1의 기재값을 설명하기 위한 인용이며 검증된 성능이나 재현 결과로 제시하는 것이 아니다. 모든 수치가 계획값이라고 단정할 근거도 없다. 원문 §4.4
Executive Summary
| 항목 | 설명 |
|---|---|
| 연구 질문 | 엔티티 관계와 원문 문단을 함께 학습하면 멀티홉 근거 검색과 장기 기억 질의응답을 개선할 수 있는가? |
| 핵심 표현 | 엔티티와 문단을 노드로 두고, 엔티티–엔티티 관계와 엔티티–문단 링크를 연결한다. |
| 학습 방법 | 관계 인지 주의와 Bi-Interaction으로 정보를 전파하고, 구조 손실·문단 정렬 손실·로짓 분산 힌지를 함께 최적화한다. |
| 질의 조건부의 의미 | 질의로 시드와 계산할 이웃집합을 먼저 정한다. 주의 점수 식 자체에 별도의 질의 벡터가 직접 들어가는 것은 아니다. |
| 검색과 종료 | 문단을 누적하면서 후속 질의를 만들고, 완료 플래그 또는 최대 반복 예산에서 멈춘다. |
| 기재된 결과 | Table 2의 Open/Reject 여섯 열에서 WFM이 최고다. Table 1의 MuSiQue Recall@20은 Youtu-GraphRAG보다 0.66%p 낮다. |
| 기억 실험의 비교점 | RHELM에서는 전체 맥락 제로샷이 WFM 계열을 제외한 여덟 검색·기억 기준선을 모두 앞선다. |
| 핵심 한계 | 계획값의 범위, Overall 집계식, 반복 실험과 시스템 측정 조건이 충분히 공개되지 않았다. 표의 우위를 검증된 성능 우위로 옮겨 읽을 수 없다. |
목차
- 관계만 남기면 무엇을 잃는가
- 문단도 그래프의 노드가 된다
- 구조와 텍스트가 같은 이웃집합에서 경쟁한다
- 균일한 주의를 억제하는 학습 목적
- 그래프를 나눠도 경계 상태는 필요하다
- 근거를 누적하며 다시 검색한다
- 멀티홉 결과는 어떤 비교인가
- 장기 기억에서는 전체 맥락이 중요한 기준선이다
- 절제 실험이 분리하려는 역할
- 한계와 재현 조건, 그리고 결론
1. 관계만 남기면 무엇을 잃는가
“어느 연구자가 어떤 기관에서 어떤 프로젝트를 수행했는가”라는 질문을 생각해 보자. 엔티티와 관계를 연결하면 여러 문서를 건너갈 경로를 만들 수 있다. 하지만 관계만 추출하고 원문을 충분히 보존하지 않으면, 수행 시점이나 예외 조건처럼 문단 전체를 읽어야 알 수 있는 정보가 빠질 수 있다. 이 예시는 표현의 차이를 설명하기 위한 것이며 논문의 실험 문항은 아니다.
WFM이 문제 삼는 것은 이 구조와 맥락 사이의 간격이다. 논문은 관계 트리플 중심 표현의 대안으로, 밀집 문단과 다층 링크를 가진 마크다운 문서를 결합한 LLM Wiki를 제안한다. 다만 기존 GraphRAG 전체가 트리플만 저장한다고 일반화해서는 안 된다. 커뮤니티 요약이나 계층 구조를 쓰는 방법도 있으므로, 이 대비는 논문이 선택한 문제 설정으로 읽는 편이 정확하다. 논문 §1
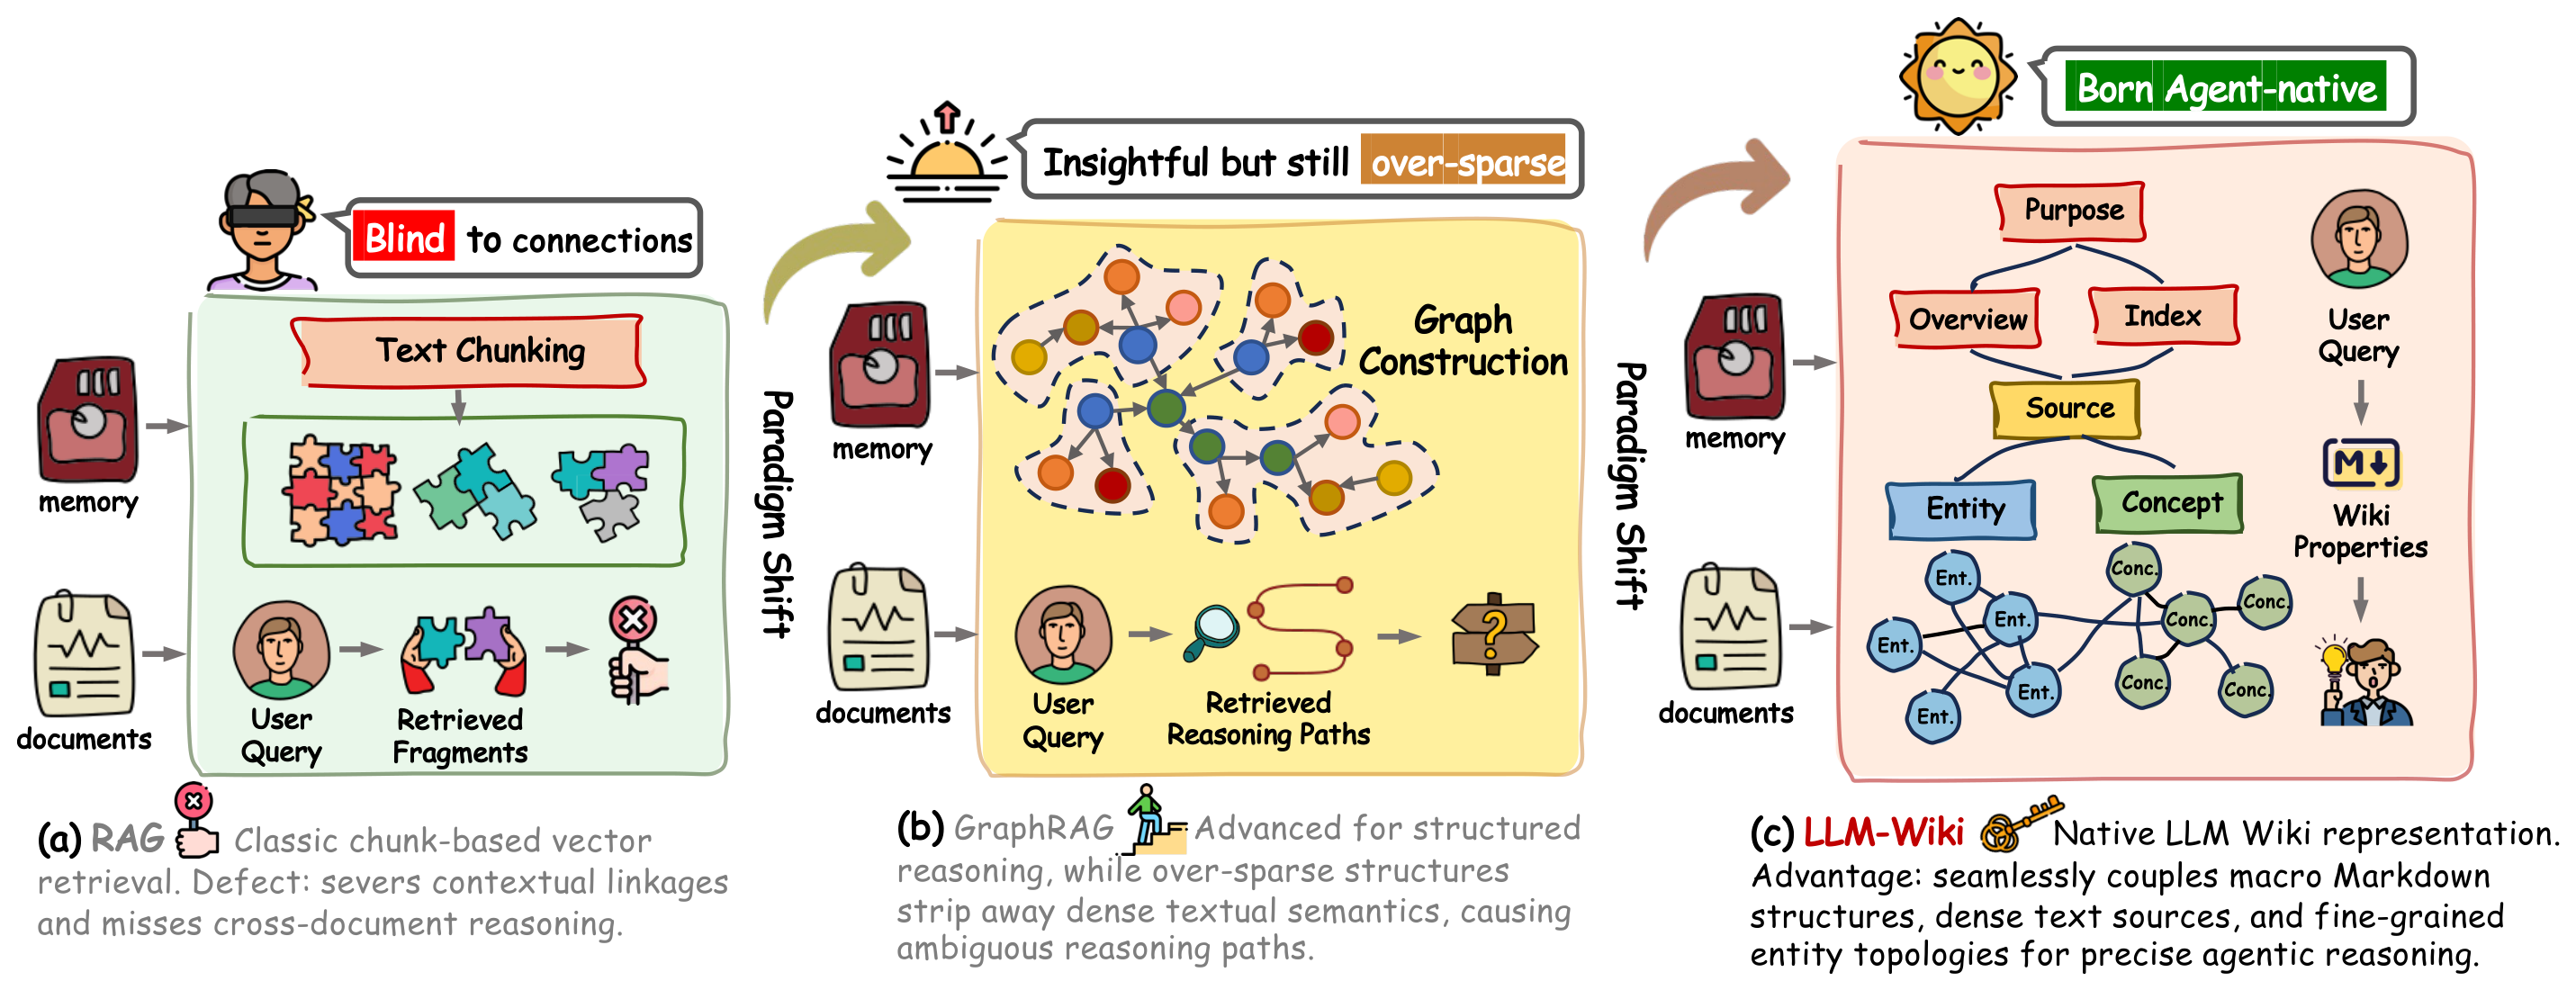
Figure 1. 청크 검색, 관계 경로, 문서 맥락을 결합한 Wiki 표현을 대비한다. ‘패러다임 전환’은 저자들의 해석이며, 그림 자체가 산업 전체의 전환을 입증하는 자료는 아니다. 논문 v1, 1쪽 Figure 1에서 인용.
여기서 중요한 구분은 위키 형식으로 지식을 정리하는 것과 그 위에서 모델을 학습하는 것은 다르다는 점이다. WFM은 문서를 마크다운으로 바꾸는 도구에 그치지 않는다. 엔티티와 문단을 연결한 그래프의 표현을 학습하고, 그 표현으로 검색하려는 모델이다.
2. 문단도 그래프의 노드가 된다
논문은 Wiki를 W = (E_w, R_w, D)로 정의한다. E_w는 엔티티, R_w는 엔티티 관계, D는 연결된 문서·문단 맥락이다. 실제 전파에 쓰는 노드 집합은 E_w ∪ D다.
간선은 두 종류다.
- 관계형 간선: 엔티티 사이의 (e_i, r, e_j) 관계를 보존한다.
- 교차층 간선: 엔티티와 그것이 서술되거나 언급된 문단을 연결한다.
따라서 문단의 내용을 또 하나의 트리플로 줄이지 않아도, 엔티티 경로에서 원문 맥락으로 이동할 수 있다. 한 엔티티가 여러 문단에서 정보를 받을 수도 있다. 본문의 정의는 엔티티 하나와 문단 하나를 잇는 링크다. 서론의 ‘하이퍼엣지’라는 표현과 달리, 제시된 수식에 여러 노드를 한꺼번에 묶는 별도의 하이퍼그래프 연산은 없다. 논문 §3.1
초기 표현은 출처에 따라 다르다. 엔티티와 관계는 학습 가능한 룩업 테이블에서 구조 표현을 얻고, 문단은 사전학습 텍스트 인코더 T로 의미 표현을 얻는다. 문단 표현에는 선형 사영 W_p를 적용한다.
h⁰_d = W_p T(d), h⁰_e = e_e
사영 뒤에는 두 노드 종류의 차원이 같아진다. 이 단계가 필요한 이유는 단순하다. 이후 같은 채점식과 갱신식을 쓰려면, 서로 다른 출처의 벡터가 같은 폭의 공간에 있어야 한다.
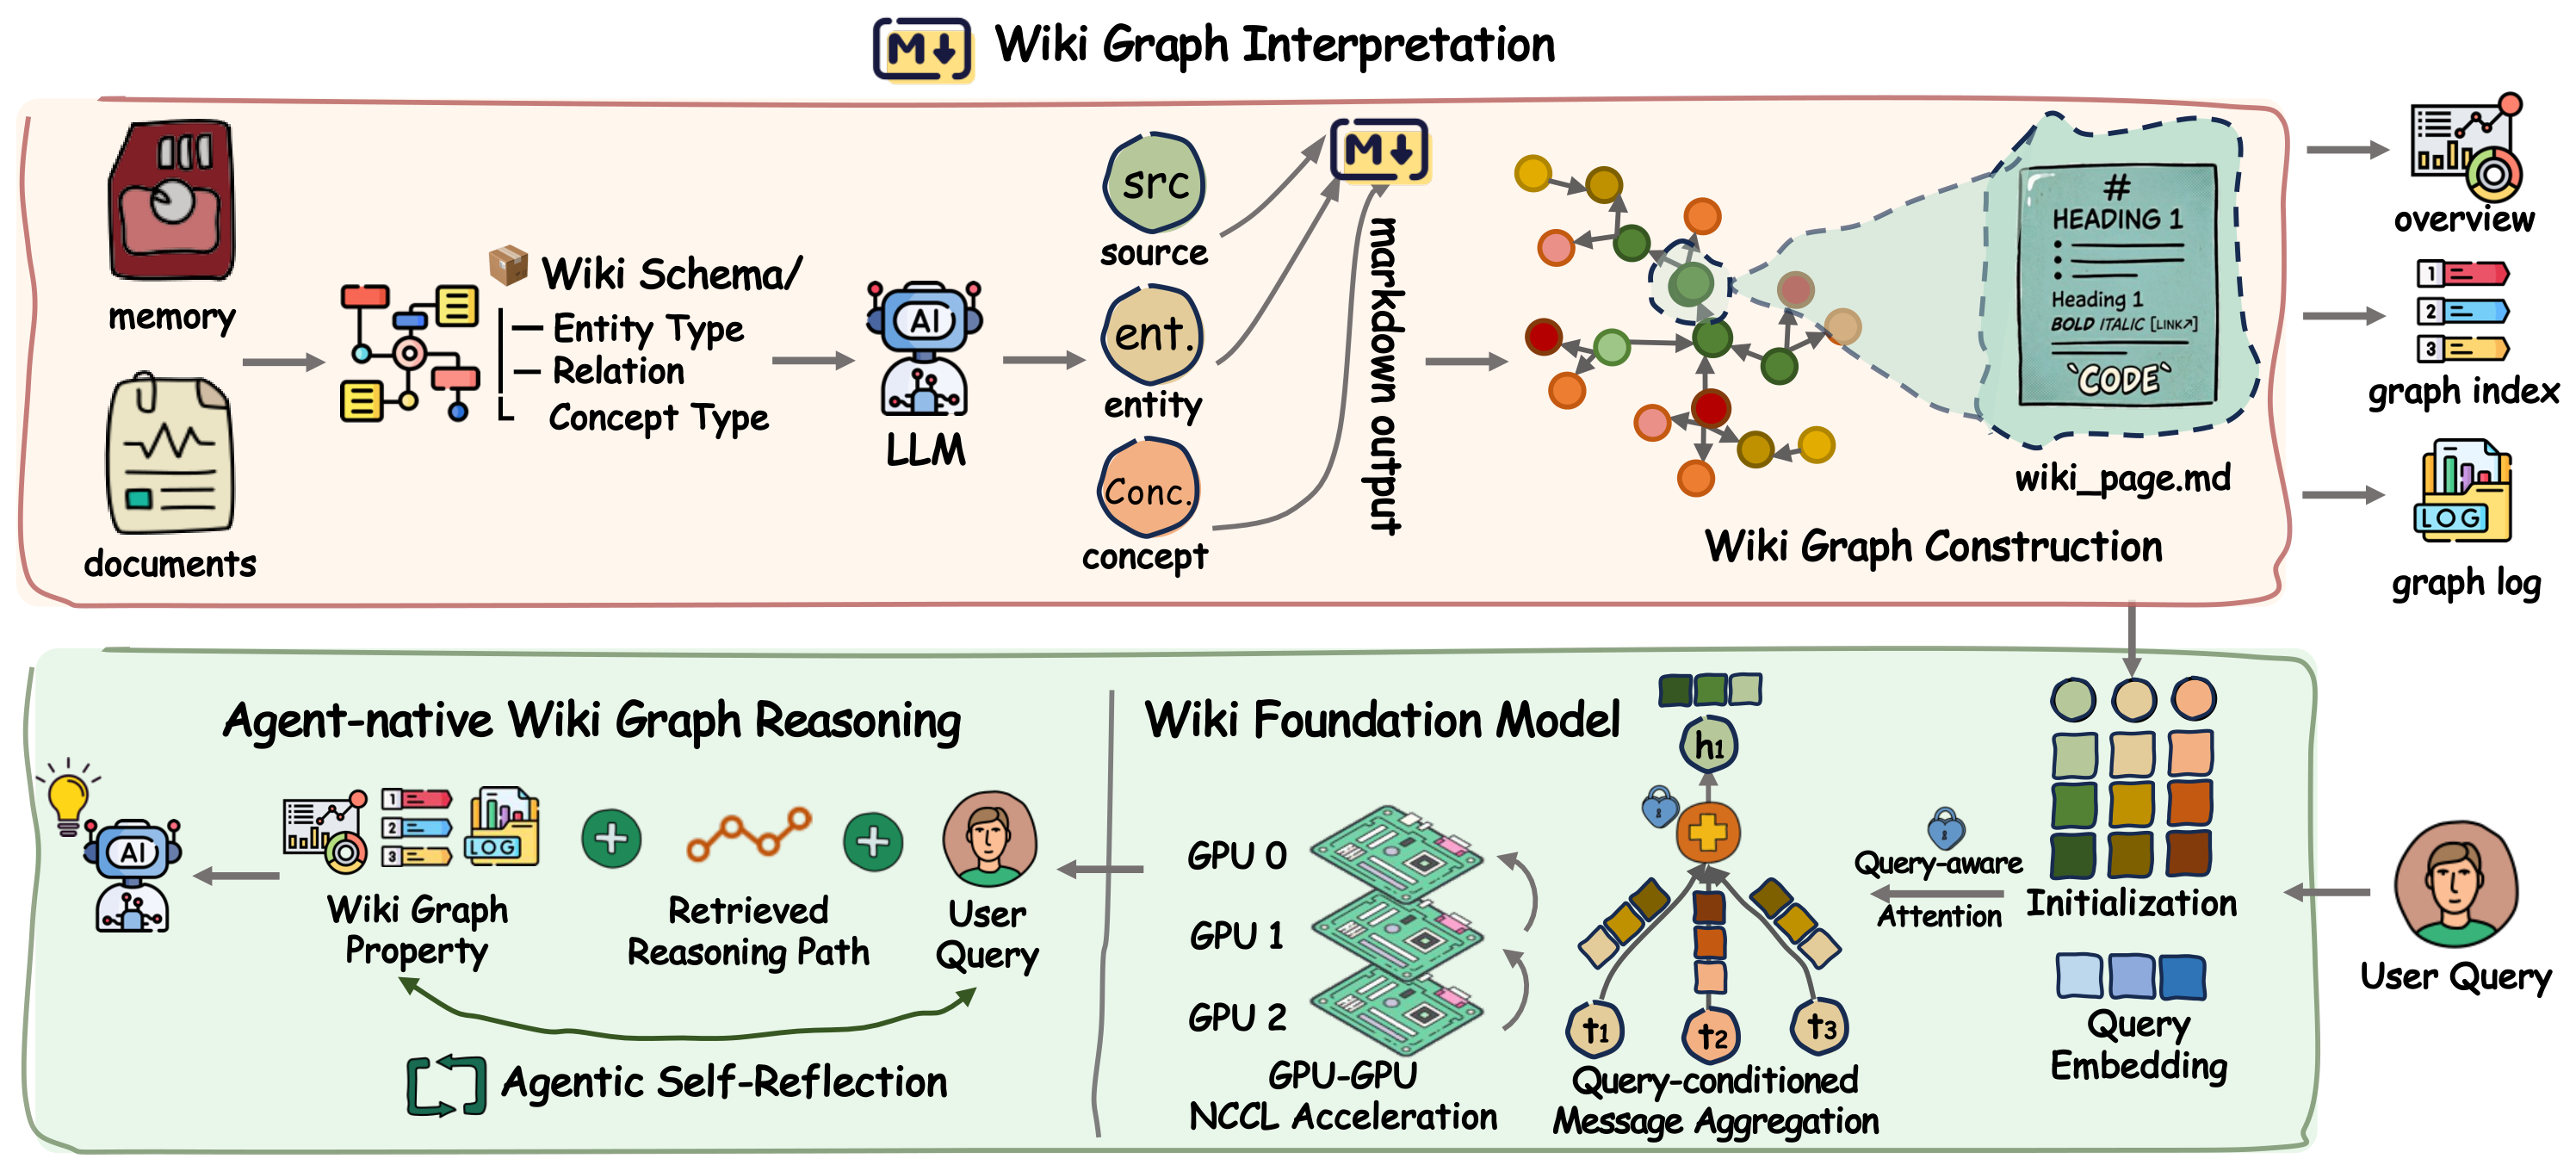
Figure 2. 위쪽은 기억·문서에서 Wiki Graph를 구축하는 과정, 아래쪽은 질의에 따른 전파·GPU 간 교환·반복 검색을 보여 준다. 구축, 표현 학습, 검색 루프는 역할이 다른 단계다. 논문 v1, 3쪽 Figure 2에서 인용.
3. 구조와 텍스트가 같은 이웃집합에서 경쟁한다
WFM은 먼저 질의와 관련된 시드 엔티티·문단을 고르고, 계산할 지역 그래프를 구성한다. 논문이 말하는 **질의 조건부(query-conditioned)**는 우선 이 이웃집합의 선택을 뜻한다. 아래 주의 점수에 질의 벡터가 직접 들어가는 것으로 해석하면 안 된다. 시드 선택의 구체적인 구현은 충분히 기술되어 있지 않다.
노드 v와 관계 r로 연결된 이웃 u의 점수는 다음과 같다.
π(v, r, u) = w_aᵀ tanh(W_r h_u + e_r − W_r h_v) (식 3)
W_r은 같은 관계 아래 두 노드의 상태를 변환한다. e_r은 간선 유형을 반영하고, w_a는 그 결과를 스칼라 점수로 바꾼다. 엔티티 이웃에는 원래의 관계 유형을, 문단 이웃에는 교차층 링크 유형을 사용한다.
점수는 v에 들어오는 모든 유형의 메시지에 걸쳐 하나의 Softmax로 정규화된다(식 4). 구조 정보와 문단 정보가 각각 따로 집계된 뒤 합쳐지는 것이 아니라, 한 이웃집합 안에서 상대적인 기여도를 정한다.
집계 메시지는 m_v = Σ_(r,u) α(v,r,u)(W_v h_u + e_r)다(식 5). 갱신에는 Bi-Interaction을 사용한다.
h⁽ˡ⁾_v = LeakyReLU(W₁(h⁽ˡ⁻¹⁾_v + m_v)) + LeakyReLU(W₂(h⁽ˡ⁻¹⁾_v ⊙ m_v)) (식 6)
덧셈 항은 기존 상태와 들어온 메시지를 함께 반영하고, 원소별 곱셈 항은 두 표현의 특징별 상호작용을 반영한다. 문단만을 위한 별도 갱신 규칙을 두지 않는다는 점이 핵심이다. 여러 층을 거치면 한 엔티티에 붙은 문단의 정보가 연결된 다른 엔티티까지 전달될 수 있다. 논문 §3.2
4. 균일한 주의를 억제하는 학습 목적
이웃의 주의 로짓이 모두 같아지면 Softmax는 각 이웃에 같은 가중치를 준다. 논문은 이를 반복하면 관련 근거와 부수적인 문단을 구분하기 어려워진다고 설명한다. 이를 완화하기 위해 세 손실을 결합한다.
| 손실 | 형태 | 의도 |
|---|---|---|
| L_topo | TransE형 마진 순위 손실 | 실제 관계의 엔티티 쌍을 손상된 쌍보다 가깝게 학습한다. |
| L_align | 엔티티–문단 쌍의 InfoNCE | 연결된 엔티티와 문단의 표현을 정렬한다. |
| L_var | Σ_v [ε − Var_(r,u) π(v,r,u)]₊ | 이웃 메시지의 로짓 분산이 ε보다 작을 때 벌점을 준다. |
전체 목적은 L_total = L_topo + λ₁L_align + λ₂L_var + λ₃‖Θ‖²₂다(식 12). 분산은 Softmax를 적용한 확률이 아니라 적용하기 전 로짓에 대해 계산한다.
여기서 힌지 정칙화의 의미를 정확히 한정해야 한다. 분산이 ε에 도달하면 이 항은 더 큰 분산을 요구하지 않는다. 또한 어느 이웃이 정답 근거인지를 직접 지정하지 않는다. 균일한 상태에 비용을 부과하는 것과, 학습이 반드시 그 상태를 벗어나도록 보장하는 것은 다르다. 유한한 가중치의 벌점은 엄격한 부등식 제약이 아니다.
완전히 같은 로짓에서는 더 구체적인 문제가 있다. n개 로짓의 모집단 분산에 대해 ∂Var/∂π_i = 2(π_i − 평균)/n이므로, 모두 같으면 이 미분도 0이다. 이때 힌지의 값은 양수여도 해당 항만으로 대칭을 깨는 기울기를 얻지는 못한다. 이는 식에서 도출한 해설이며, WFM이 실제 학습에서 항상 그 상태에 도달한다는 관측은 아니다. 서론의 ‘gradient lock을 수학적으로 제거한다’는 표현을 그대로 보장으로 받아들이기 어려운 이유다.
학습은 두 단계다. 먼저 그래프 전파 모델을 고정하고 W_p와 룩업 테이블을 L_align으로 학습한다. 그다음 전체 파라미터를 풀어 L_total을 최적화한다. 이 웜스타트는 그래프에서 섞기 전에 엔티티와 문단의 표현을 맞추는 장치이며, 추론 때 별도 모델을 추가하는 방식은 아니다. 논문 §3.4
5. 그래프를 나눠도 경계 상태는 필요하다
그래프를 여러 GPU에 나누면 다른 GPU에 있는 이웃의 상태도 받아야 한다. 논문은 경계 상태를 CPU에서 직렬화하고 통신한 뒤 GPU로 복사하는 경로를 병목으로 지목한다.
해결의 출발점은 학습 중 바뀌는 값과 고정된 배치를 분리하는 것이다. 노드 표현은 매번 바뀌지만, 논문이 가정하는 분할 토폴로지와 경계 노드의 소유권은 고정되어 있다. 따라서 송수신 인덱스를 미리 계산하고, 고정 형상 GPU 버퍼로 교환한다.
B_recv ← NCCL_AllToAll(Gather(H⁽ˡ⁾, Index_boundary)) (식 13)
받은 유효 행은 고스트 노드 위치에 배치한다. 패딩 항목은 집계에서 제외하며, 주의와 Bi-Interaction의 수학적 갱신은 그대로 유지한다. 이 설계가 바꾸려는 것은 모델의 연산식이 아니라 그 연산에 필요한 상태를 전달하는 경로다. 논문 §3.5
논문은 스텝당 2.40초에서 0.23초로 줄어 약 10.5배 빨라졌다고 적는다. 두 표기값의 비는 약 10.43이며, 반올림을 고려하면 10.5배와 모순되지 않는다. 그러나 GPU 모델·수, 그래프 크기, 분할 수, 반복 횟수와 변동 폭을 제시하지 않는다. 수치는 있지만 그것을 재현할 측정 조건은 부족하다. ‘실험이 없다’고 단정하기보다 이 차이를 짚는 것이 정확하다.
‘bit-exact’도 별도 확인이 필요하다. 같은 갱신식을 구현한다는 설명은 있지만, 비트 단위 동일성을 대조한 결과는 제시되어 있지 않다. 동적으로 그래프를 갱신할 때 경계 레이아웃을 어떻게 다시 구성할지도 이 고정 토폴로지 설명만으로는 알 수 없다.
6. 근거를 누적하며 다시 검색한다
한 번의 검색으로 필요한 근거가 모두 모이지 않을 수 있다. WFM은 현재 질의 q⁽ᵗ⁾와 전파된 문단 표현의 유사도로 상위 K개 문단을 찾는다(식 7).
s⁽ᵗ⁾(d) = sim(T(q⁽ᵗ⁾), h⁽ᴸ⁾_d)
검색한 문단은 이전 결과를 대체하지 않고 누적한다. LLM은 원래 질의와 누적 근거를 받아 후보 답, 후속 질의, 완료 플래그를 생성한다(식 8). 근거가 충분하다고 판단해 Final을 내면 멈추고, 그렇지 않으면 부족한 내용을 대상으로 다시 검색한다. 최대 B회에서도 끝나지 않으면 그때의 답을 반환한다.
여기서 K는 한 번에 검색하는 문단 수, B는 검색·생성 반복의 최대 횟수다. 기본값은 K = 20, B = 4다. 둘을 같은 ‘검색 예산’으로 묶으면 비용과 동작을 잘못 이해하기 쉽다. 또한 완료 플래그는 모델의 판단이지, 근거가 실제로 충분하다는 외부 검증은 아니다. 논문 §3.3
식 7의 구현에도 남는 질문이 있다. 문단 상태는 구조 폭으로 사영되지만, 질의 인코딩과 그 상태의 차원을 어떤 방식으로 맞추는지는 명시적이지 않다. 논문에 적힌 식을 설명하는 것과 실행 가능한 검색기를 재구현하는 것은 구분해야 한다.
7. 멀티홉 결과는 어떤 비교인가
논문은 HotpotQA·2WikiMultihopQA·MuSiQue에서 각 1,000문항을 사용한다. 말뭉치는 각각 9,990·6,642·11,694청크다. 생성기는 DeepSeek V4 Flash, 판정기는 DeepSeek V4 Pro, 공통 임베딩은 all-MiniLM-L6-v2라고 기술한다. 같은 분할·임베딩·검색 깊이·과제별 프로토콜을 사용했다고 적지만, 세부 실행 설정과 시드별 결과까지 제공하지는 않는다.
지표는 두 층으로 나뉜다.
- Recall@k: 정답 근거 가운데 상위 k개 검색 결과가 포함하는 비율이다.
- LLM 판정 정확도: 생성한 답이 참조 답에 부합하는지를 판정한다. Reject는 검색 근거만 사용하고 부족하면 기권하며, Open은 모델의 파라미터 지식도 허용한다.
검색 재현율
아래는 Table 1의 주요 방법을 발췌한 것이다. 단위는 %이며, 굵은 값은 이 열의 최고 기재값이다. 앞서 밝힌 계획값의 범위 불확실성이 모든 결과 해석에 적용된다.
| Recall@20 | HotpotQA | 2Wiki | MuSiQue |
|---|---|---|---|
| Native RAG | 68.10 | 49.22 | 44.44 |
| RAPTOR | 84.30 | 68.10 | 61.93 |
| HippoRAG2 | 89.20 | 84.98 | 67.66 |
| Youtu-GraphRAG | 89.70 | 88.50 | 75.90 |
| GFM-RAG | 81.38 | 72.63 | 48.57 |
| WFM | 93.20 | 90.15 | 75.24 |
WFM은 HotpotQA와 2Wiki에서 가장 높지만, MuSiQue에서는 Youtu-GraphRAG보다 0.66%p 낮다. ‘모든 검색 조건에서 최고’라는 요약은 맞지 않는다. MuSiQue에서도 k = 2·5·10에서는 WFM의 기재값이 더 높다.
답변 정확도
| Table 2 | HotpotQA Open / Reject | 2Wiki Open / Reject | MuSiQue Open / Reject |
|---|---|---|---|
| Youtu-GraphRAG | 86.8 / 80.2 | 87.0 / 77.6 | 65.7 / 47.5 |
| WFM | 89.6 / 84.3 | 90.2 / 82.4 | 69.8 / 52.6 |
| 차이(%p) | +2.8 / +4.1 | +3.2 / +4.8 | +4.1 / +5.1 |
여섯 열 모두 WFM이 최고이고, 세 데이터셋 모두 Reject의 차이가 Open보다 크다. 이는 논문이 강조하는 증거 기반 답변 개선의 방향과 맞는다. 다만 이 비교만으로 어떤 구성 요소가 이득을 만들었는지, 차이가 반복 실행에서도 유지되는지는 알 수 없다. 논문 §4.1–4.5
8. 장기 기억에서는 전체 맥락이 중요한 기준선이다
기억 과제는 PersonaMem 1M과 RHELM의 1M 맥락 설정이다. PersonaMem은 20개 페르소나의 2,674문항을 포함한다. RHELM은 사실·시간·집계·혼합·환각·첨부·오도 관련 일곱 범주를 다룬다.
| Table 3의 Overall(%) | PersonaMem-1M | RHELM |
|---|---|---|
| Zero-shot LLM, 전체 맥락 | 44.1 | 46.8 |
| Youtu-GraphRAG | 48.0 | 35.7 |
| A-mem | 50.0 | 37.8 |
| MemoryOS | 50.1 | 32.0 |
| WFM w/o reflection | 54.12 | 48.90 |
| WFM | 58.49 | 52.17 |
WFM 두 변형은 범주와 Overall을 합친 16개 열에서 모두 비WFM 기준선을 앞선다. Full WFM의 Overall 차이는 PersonaMem에서 MemoryOS 대비 8.39%p, RHELM에서 전체 맥락 제로샷 대비 5.37%p다.
특히 RHELM에서 비교 상대의 정체가 중요하다. 46.8을 기록한 제로샷 기준선은 기억이 없는 모델이 아니라, 이력을 통째로 입력받는 모델이다. 나머지 여덟 검색·기억 기준선은 이보다 9.0~40.3%p 낮게 기재되어 있다. 이 표에서는 WFM 계열만 그 수준을 넘는다.
이것이 ‘검색은 긴 맥락보다 본질적으로 나쁘다’는 뜻은 아니다. 이 설정에서 검색으로 근거가 누락될 수 있다는 점, 그리고 검색의 가치를 판단할 때 전체 맥락 입력도 비교해야 한다는 점을 보여 주는 비교다. 전체 맥락의 토큰 비용·지연과 검색 비용까지 함께 통제한 우열은 이 정확도 표만으로 정할 수 없다.
기억 검색의 재현율
| Table 4 | PersonaMem R@5 / R@10 / R@20 | RHELM R@5 / R@10 / R@20 |
|---|---|---|
| A-mem | 23.7 / 30.2 / 38.2 | 34.2 / 43.8 / 53.9 |
| WFM | 23.46 / 37.39 / 52.63 | 38.81 / 49.21 / 60.03 |
PersonaMem에서는 k = 5일 때 WFM이 0.24%p 낮지만, k = 10·20에서는 각각 7.19·14.43%p 높다. 작은 검색 예산과 큰 검색 예산의 결과가 같지 않다.
또 하나의 구분이 필요하다. RHELM은 주석된 턴 근거를 사용하지만, PersonaMem에는 같은 턴 수준 근거 라벨이 없어 LLM 판정을 사용한다고 §4.1이 명시한다. 따라서 두 데이터셋의 재현율을 같은 측정 절차에서 나온 값처럼 직접 비교해서는 안 된다. 논문 §4.6
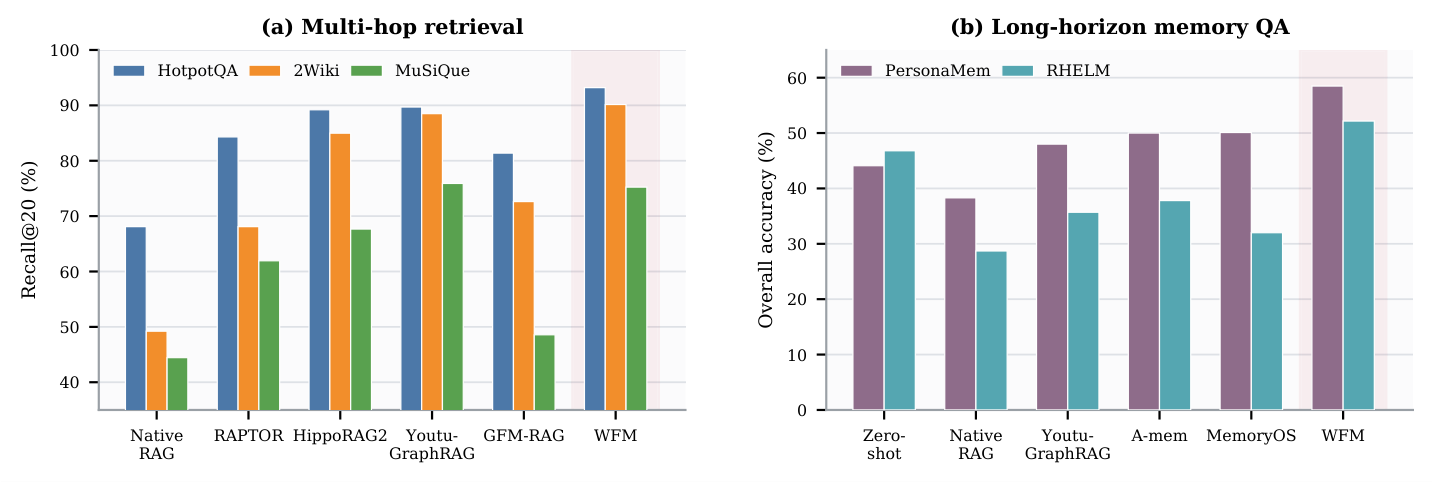
Figure 4. Table 1·3의 일부 값을 다시 그린 도판이다. MuSiQue의 예외와 RHELM의 전체 맥락 기준선을 함께 읽어야 한다. 독립적인 추가 실험은 아니며, §4.4의 수치 검증 유보가 적용된다. 논문 v1, 9쪽 Figure 4에서 인용.
9. 절제 실험이 분리하려는 역할
Figure 5는 표현, 집계, 학습, 검색 루프의 구성 요소를 하나씩 바꾼다. 아래 수치는 도판에 기재된 값이며, 진단 스윕에 관한 §4.4의 유보 때문에 구성 요소의 효과가 실측으로 확정됐다는 근거로 사용할 수는 없다.
| 변형 | 멀티홉 평균 R@20(%) | 기억 평균 정확도(%) | 질의당 상대 시간 |
|---|---|---|---|
| Full WFM | 86.20 | 55.33 | 1.00 |
| Ordinary graph | 78.72 | 47.65 | 0.86 |
| DistMult aggregator | 74.31 | 42.86 | 2.65 |
| 분산 정칙화 제거 | 82.47 | 50.94 | 0.96 |
| 웜스타트 제거 | 80.36 | 48.77 | 0.97 |
| 자기 반성 제거 | 81.08 | 51.51 | 0.69 |
| 완료 플래그 제거 | 85.91 | 54.88 | 1.58 |
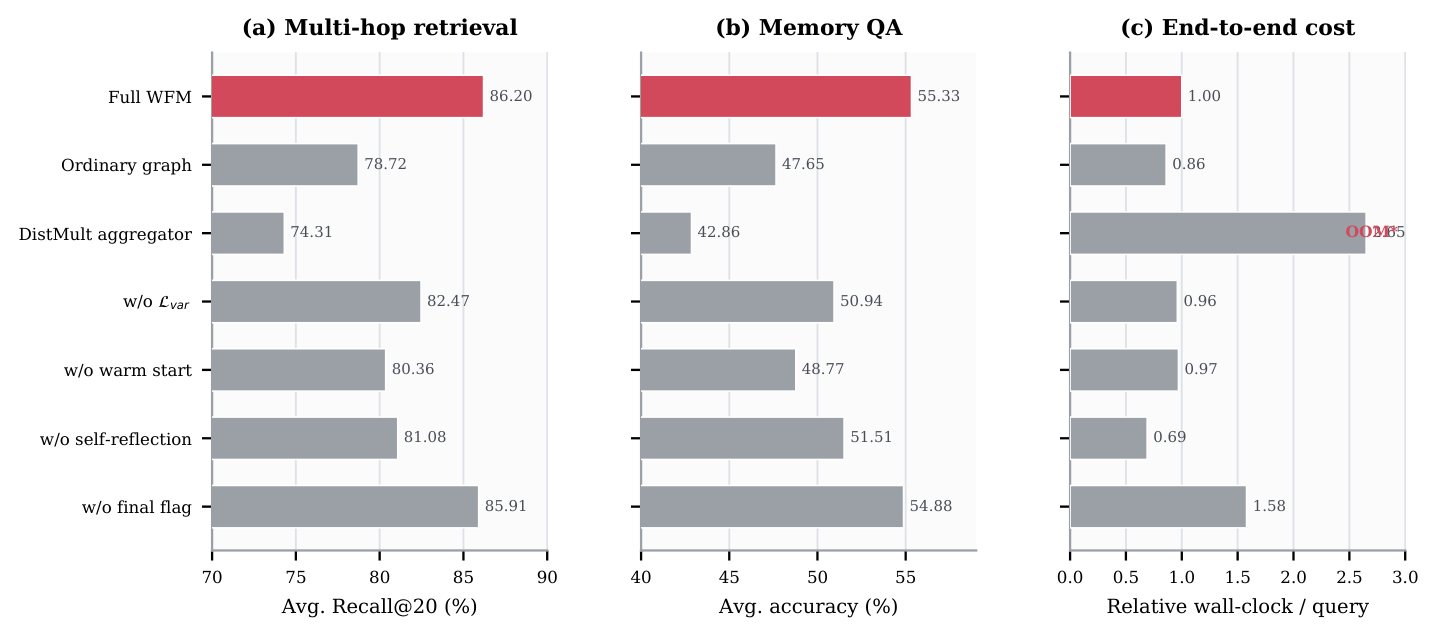
Figure 5. 멀티홉은 세 데이터셋의 Recall@20 평균, 기억은 두 Overall의 평균이다. 시간은 Full WFM의 질의당 시간을 1로 정규화했다. DistMult의 시간 라벨과 OOM 주석은 원도판에서 겹치며, 본문은 이웃 수를 제한한 실행과 제한 없는 실행의 OOM을 구분한다. 논문 v1, 9쪽 Figure 5에서 인용.
Ordinary graph는 문단 노드와 교차층 링크를 함께 제거한다. 두 지표가 7.48·7.68%p 낮아지는 것으로 기재되어 있으므로, 저자들이 검증하려는 가설은 문단 맥락을 그래프 내부에서 다루는 일이 중요하다는 것이다. 하지만 두 요소를 동시에 제거한 비교이므로 각각의 독립적인 기여까지 분리하지는 못한다.
DistMult는 주의와 Bi-Interaction을 바꾼 데 더해 이웃 수도 제한한다. 제한 없이 실행하면 1M 설정에서 메모리 부족이 발생한다고 본문이 설명한다. 따라서 이 비교는 순수하게 집계식 하나만 바꾼 통제 실험으로 읽기 어렵다.
검색 루프에서는 더 찾는 일과 언제 멈출지를 정하는 일이 구분된다. 자기 반성을 빼면 비용도 낮아지지만 기억 정확도도 낮아진다. 완료 플래그를 빼고 네 라운드를 모두 실행하면 상대 시간이 1.58이고 정확도는 54.88이다. 기본 설정은 1.00과 55.33이므로, 기재값상 적응적 종료의 가장 뚜렷한 이점은 비용 쪽이다. 0.45%p의 정확도 차이가 유의한지는 판단할 수 없다. 논문 §4.7
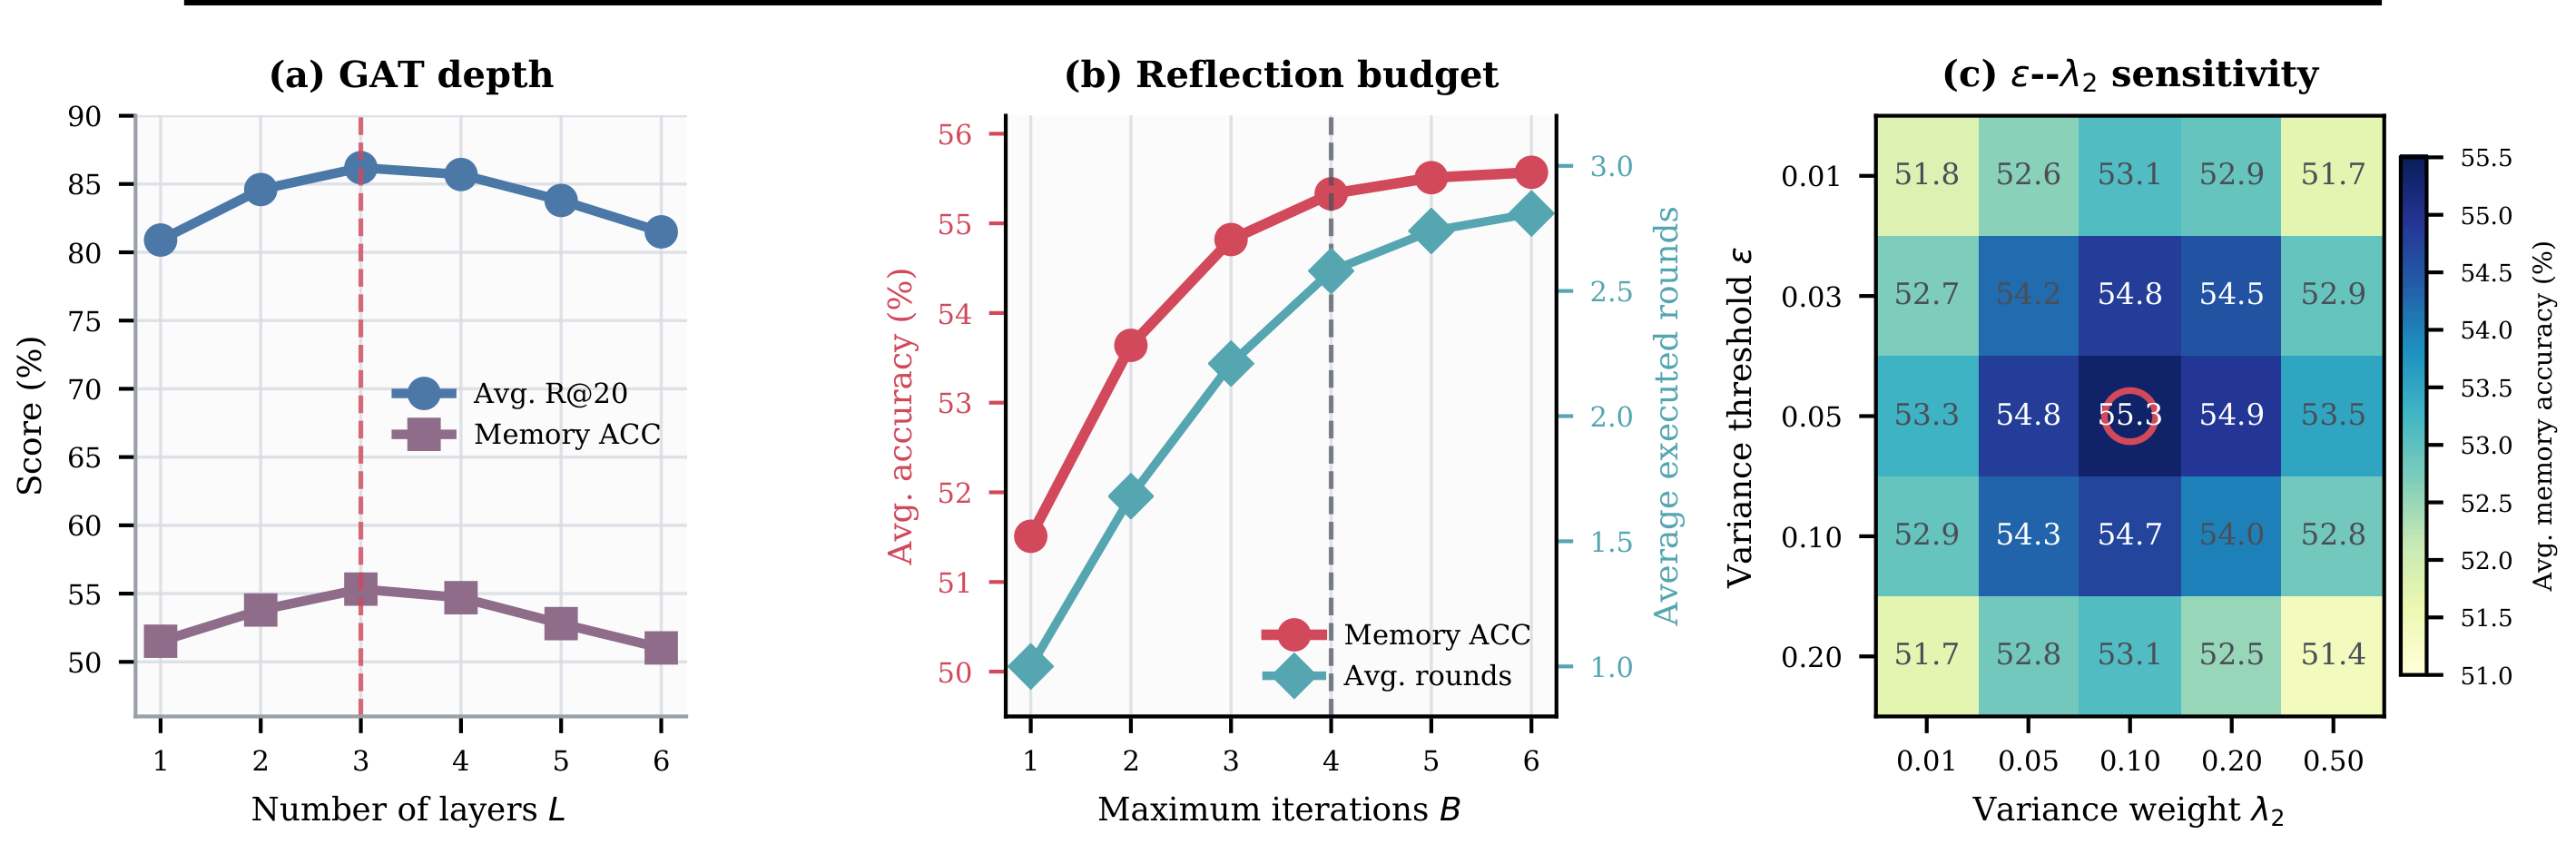
Figure 3. 기재된 곡선은 세 층에서 정점을 보이고, 최대 반복 B = 4 이후에는 기억 정확도의 증가가 작다. 오른쪽은 분산 임계값 ε와 가중치 λ₂의 조합이다. 실제 실행 라운드와 최대 허용 라운드는 다르다. 논문 v1, 8쪽 Figure 3에서 인용.
B를 1에서 4로 늘리면 기억 정확도는 51.51에서 55.33으로, B = 6에서는 55.57로 기재되어 있다. B = 4의 평균 실행 라운드는 2.58이다. 이는 반복 예산과 적응적 종료를 함께 평가하려는 설계다. 다만 세 층·네 라운드·ε = 0.05·λ₂ = 0.1을 다른 환경에도 바로 적용할 최적값으로 권할 수는 없다. 논문 §4.8
10. 한계와 재현 조건, 그리고 결론
10.1 계획값의 범위는 표에서 복원할 수 없다
가장 큰 제약은 §4.4의 계획값 문장이다. 본문은 이후 수치를 결과로 설명하고 §3.5는 지연을 ‘measured’라고 표현하지만, 어떤 셀과 스윕이 아직 실측 검증 전인지 구분하지 않는다.
이 상태에서는 개별 수치의 출처를 먼저 확인해야 한다. 집계값의 어긋남, 소수 자릿수, 굵은 글씨의 불일치만으로 실측과 계획값의 경계를 식별할 수는 없다. 편집 이력이나 저자의 의도를 추론하는 대신, 공개된 문장과 수치의 정합성 문제를 분리해서 다루는 것이 적절하다.
10.2 Overall은 어떤 평균인가
Table 3은 Overall의 계산식을 명시하지 않는다. 표에 적힌 일곱 범주의 단순평균을 직접 계산하면 WFM 행에서 다음 차이가 나온다. 차이는 ‘Overall − 범주 평균’이며 단위는 %p다.
| 데이터셋·변형 | 표기 범주의 단순평균 | 기재된 Overall | 차이 |
|---|---|---|---|
| PersonaMem · 반성 없음 | 57.24 | 54.12 | −3.12 |
| PersonaMem · Full | 61.21 | 58.49 | −2.72 |
| RHELM · 반성 없음 | 49.79 | 48.90 | −0.89 |
| RHELM · Full | 53.24 | 52.17 | −1.07 |
비WFM 기준선의 Overall 18칸 가운데 17칸은 표기 범주의 단순평균을 소수 첫째 자리로 반올림한 값과 같다. 예외는 Youtu-GraphRAG의 RHELM으로, 표기 범주 평균은 약 35.7857인데 Overall은 35.7이다. 다만 범주 값 자체가 반올림되어 있으므로, 이 작은 차이만으로 원자료 집계가 잘못되었다고 단정할 수는 없다.
WFM의 네 차이는 단순한 소수 첫째 자리 반올림으로 설명하기에는 크다. 그렇다고 Overall이 반드시 틀렸다고 결론 낼 수는 없다. 문항별 가중평균인지, 평가 대상이나 집계 절차가 다른지 확인하려면 범주별 표본 수, 집계식, 반올림 전 결과가 필요하다. 단순평균으로 통일하면 WFM의 값은 오히려 높아지므로, 이 현상을 성능 부풀리기의 증거로 읽어서도 안 된다.
또한 Figure 5의 기억 평균 55.33은 두 Overall인 58.49와 52.17의 평균이고, 51.51은 54.12와 48.90의 평균이다. 표와 도판에서 같은 값이 반복된다고 해서 독립적인 검증이 추가된 것은 아니다.
10.3 나머지 표기와 주장도 구분해서 읽어야 한다
- Recall의 포함 관계: Table 1의 HippoRAG-IRCOT은 HotpotQA에서 R@5 = 76.90, R@10 = 76.10이다. 같은 순위 목록의 상위 k개를 늘리는 평가라면 재현율은 감소하지 않아야 한다. 오기인지, k마다 검색을 다시 수행한 것인지 확인이 필요하다.
- 최고값 표시: Table 4는 일부 A-mem 값이 WFM보다 낮은데도 굵게 표시되어 있다. 순위는 글꼴이 아니라 수치로 비교해야 한다. 이 글의 발췌 표는 실제 최고 기재값에 맞춰 강조했다.
- 시스템 기여: 10.5배 가속의 측정 조건과 비트 단위 동일성 검증이 부족하다. DistMult 변형의 OOM 결과를 NCCL 프로토콜이 메모리 한계를 제거했다는 검증으로 사용할 수도 없다. 학습 스텝 시간과 Figure 5의 질의당 추론 시간은 다른 지표다.
- 독창성의 범위: GFM-RAG처럼 가까운 학습형 그래프 검색 방법과 어떤 학습·전이 조건이 다른지 더 구체적인 비교가 필요하다. 기준선으로 포함했다는 사실만으로 ‘최초’가 입증되지는 않는다.
- LLM Wiki의 출처: 참고문헌의 Karpathy 항목은 특정 문서가 아니라 gist 목록 주소를 가리킨다. 산업 전체가 전환하고 있다는 서술은 이 인용만으로 확인하기 어렵다.
- 판본의 성격: ACM 학회명·DOI 자리표시자가 남아 있으므로 확정된 학회 논문처럼 소개하지 않는다. 템플릿 상태 자체를 실험의 진위에 대한 근거로 삼지는 않는다.
10.4 재현과 도입 전에 확인할 것
우선 필요한 것은 하이퍼파라미터를 따라 설정하는 일이 아니라 검증 가능한 실험 명세다.
- 계획값에 해당하는 표·셀·스윕을 명시하고, 실측 결과와 분리해야 한다.
- 기억 벤치마크의 범주 정의·표본 수·Overall 집계식과 판정 프롬프트를 공개해야 한다.
- Wiki 구축 모델과 비용, 노드·간선 수, 질의의 시드 선택, 질의·문단 표현의 차원 정합을 확인해야 한다.
- 마진 γ, 온도 τ, λ₁·λ₃, 학습 데이터·시드·반복 결과가 필요하다.
- GPU와 통신망, 분할 구성, 측정 구간·반복 횟수, 수치 동일성의 비교 방식이 필요하다.
- 실제 도입 환경에서는 전체 맥락 입력, 평면 검색, 그래프 검색을 정확도뿐 아니라 구축·갱신·질의 비용으로 함께 비교해야 한다.
이 검토는 v1 PDF·HTML의 설명과 표, 제공된 원도판을 대조한 문헌 검토다. 모델을 학습하거나 벤치마크를 재실행한 결과가 아니다.
10.5 결론
WFM에서 검토할 만한 설계는 분명하다. 문단을 그래프 안의 노드로 두고, 구조 이웃과 같은 주의·갱신 규칙으로 다루며, 필요한 근거를 반복 검색으로 보완한다. 표현, 최적화, 검색, 통신의 역할을 나누어 보면 무엇을 바꾸려는 방법인지 이해하기 쉽다.
현재 판본에서 확정하기 어려운 것은 그 설계의 성능 이득이다. 계획값의 범위가 불명확하고 Overall 집계식과 시스템 측정 조건도 충분하지 않다. 따라서 이 논문은 혼합 텍스트–그래프 검색의 설계를 탐색하는 자료로 읽되, 표의 우위나 10.5배 가속을 도입 효과의 근거로 사용하려면 실측 결과와 재현 조건이 먼저 필요하다. 아이디어의 가치와 증거의 완성도는 별도로 평가해야 한다.
References
본문에서 직접 다룬 원논문과 비교 방법을 추렸다. WFM의 전체 참고문헌을 옮긴 목록은 아니다.
- Dong, J.; Luo, L.; Zhang, S.; et al. (2026). WFM: Wiki Foundation Model for Complex Agentic Reasoning. arXiv:2609.18182v1.
- Luo, L.; Zhao, Z.; Haffari, G.; Phung, D.; Gong, C.; Pan, S. (2025). GFM-RAG: Graph Foundation Model for Retrieval Augmented Generation. arXiv:2502.01113.
- Dong, J.; An, S.; Yu, Y.; et al. (2025). Youtu-GraphRAG: Vertically Unified Agents for Graph Retrieval-Augmented Complex Reasoning. arXiv:2508.19855.
- Edge, D.; Trinh, H.; Cheng, N.; et al. (2024). From Local to Global: A Graph RAG Approach to Query-Focused Summarization. arXiv:2404.16130.
- Xu, W.; Liang, Z.; Mei, K.; Gao, H.; Tan, J.; Zhang, Y. (2025). A-Mem: Agentic Memory for LLM Agents. arXiv:2502.12110.
- Jiang, B.; Hao, Z.; Cho, Y.-M.; et al. (2025). Know Me, Respond to Me: Benchmarking LLMs for Dynamic User Profiling and Personalized Responses at Scale. PersonaMem 출처이며 WFM 참고문헌 [19]에 해당한다.
- Zhang, H.; Tang, Z.; Yu, X.; et al. (2026). Beyond Static Dialogues: Benchmarking Realistic, Heterogeneous, and Evolving Long-Term Memory. RHELM 출처이며 WFM 참고문헌 [38]에 해당한다.
- Karpathy, A. (2026). llm-wiki. WFM 참고문헌 [23]의 링크는 사용자 gist 목록이며, 특정 문서의 주소는 제시되어 있지 않다.