JEV-as-a-Judge: Accept When Confident, Escalate When Unsure
JEV가 판정과 라벨 확률을 이용해 추가 검토가 필요한 응답을 가려내는 방법을 설명한다. 작업별 정확도, 호스팅 요금, 동결된 이중 순서 정책의 결과와 적용 조건을 살펴본다.
Paper: Yubo Li; Yidi Miao; Ramayya Krishnan; Rema Padman (2026). "JEV-as-a-Judge: Accept When Confident, Escalate When Unsure". arXiv:2609.26550v1. 논문 · PDF
Abstract: 많은 응답을 평가할 때는 판정 정확도뿐 아니라 비용과 추가 검토가 필요한 항목을 가려내는 능력도 중요하다. JEV-as-a-Judge는 판정과 라벨 확률을 반환하는 호스팅 서비스를 평가하고, 확신이 낮은 항목만 더 강한 판정자에게 넘기는 방식을 살핀다. 통상적 선호와 증거 기반 사실성에서는 선택된 강한 비교 대상 GPT-6와의 정확도 점추정 차이가 작았지만, 어려운 추론과 정교하게 작성된 오답을 비교할 때는 격차가 커졌다. 별도의 120판정 패널에서 JEV의 추정 요금은 GPT-6의 0.36%였으며, 이는 수집 시점 가격과 사용량에 따른 서비스 요금 비교다. 선택 집합에서 임계값을 정한 뒤 고정한 이중 순서 정책은 확장 510쌍에서 정확도 92.5%를 얻어 GPT-6 단독의 93.1%에 근접했고 추정 요금은 그 56.8%였다. 다만 높은 확신이 항상 정답을 뜻하지는 않았고, 다른 후속 판정자와 참조 없는 산문에서는 결과가 달라져 적용할 작업에서 별도 검증이 필요하다.
Executive Summary
| 항목 | 설명 |
|---|---|
| 연구 질문 | 저렴한 판정자가 자신의 확신으로 추가 검토가 필요한 항목을 가려낼 수 있는가? |
| 방법 | 먼저 판정과 라벨 확률을 받고, 확신이 낮은 항목을 후속 판정자에게 넘긴다. |
| 비교 조건 | JEV와 16개 비교 구성이다. 생성형 판정자도 설명 없이 판정·확률만 출력하지만, 동일 연산량 비교는 아니다. |
| 단독 정확도 | RewardBench 92.2% 대 GPT-6 93.5%, JudgeBench 78.6% 대 93.1%로 작업에 따라 격차가 다르다. |
| 단독 요금 | 과제당 40건씩 총 120판정에서 1,000판정당 0.044 대12.182다. 청구서나 연산량이 아닌 추정 API 요금이다. |
| 동결 정책 | 확장 510쌍에서 92.5% 대 93.1%, 요금 비 56.8%다. 약 99.4%는 상대 정확도 유지율이지 절대 정확도가 아니다. |
| 실패 경계 | GPT-5.6 정책은 선택 시 허용한 손실을 넘겼고, 문체 적대 조건과 참조 없는 산문에서는 확신 신호가 약해졌다. |
| 해석 범위 | 블랙박스 서비스, 작은 선택 집합, 제한된 사람 재판정, 오프라인 정책 평가다. 이 리뷰는 실험을 재실행하지 않았다. |
목차
- 모든 판정에 같은 비용을 써야 할까
- 판정과 확신은 서로 다른 출력이다
- 같은 출력 규약에서 무엇을 비교했나
- 어떤 판정에서 격차가 작고 커지는가
- 낮은 요금과 짧은 지연은 어떻게 측정했나
- 확신은 오류를 얼마나 구별하는가
- 순서를 바꿔 판정하고 불확실한 항목을 넘긴다
- 정교한 오답과 참조 없는 글에서 드러난 경계
- 사람 재판정은 결과를 어떻게 바꾸었나
- 적용 조건과 공개 범위 그리고 결론
1. 모든 판정에 같은 비용을 써야 할까
많은 응답을 검토할 때는 평가 비용도 커진다. 간단한 지시 위반과 복잡한 유도 오류를 매번 같은 판정자에게 맡겨야 할까?
논문은 값싼 1차 판정과 선택적인 추가 검토의 분업을 시험한다. JEV의 판정을 먼저 받고 확신이 낮으면 후속 모델, 즉 폴백으로 넘긴다. 평균 정확도뿐 아니라 틀리기 쉬운 항목에서 실제로 덜 확신하는지가 중요하다.
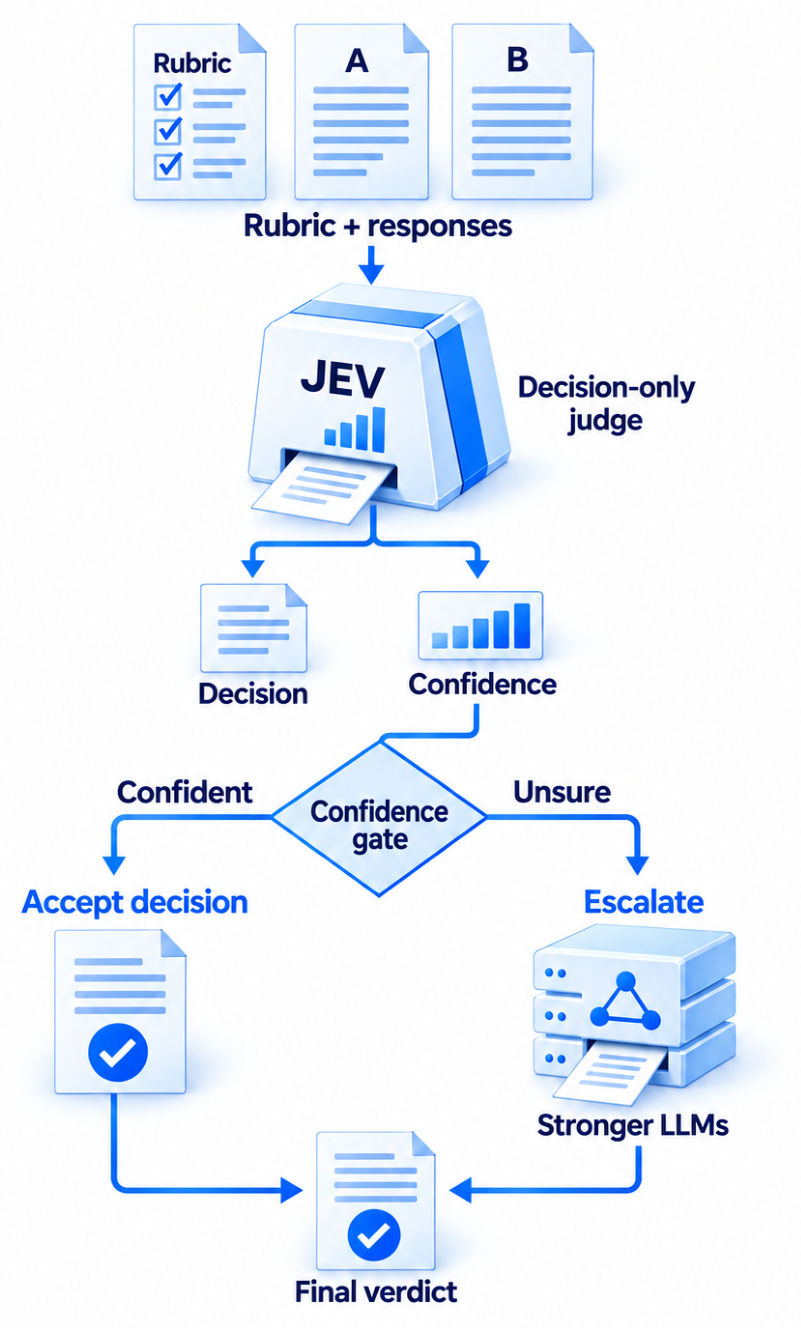
Figure 4. 확신이 낮은 판정만 후속 모델에게 넘긴다. 쌍별 정책은 두 제시 순서의 정렬 확률을 평균한다. 논문 v1, 9쪽.
FrugalGPT의 캐스케이드와 RouteLLM의 선호 데이터 기반 라우팅은 비용–성능 분업의 선행 접근이다(Chen et al., 2023; Ong et al., 2024). 선택적 분류 역시 수용률과 오류 위험을 함께 본다(Geifman & El-Yaniv, 2017). 이 논문은 새 라우팅 알고리즘보다 특정 서비스의 정확도·확신·요금에 초점을 둔다.
2. 판정과 확신은 서로 다른 출력이다
TypeSafe JEV 1.13은 자연어 지시·구조화 상태·출력 타입을 받아 판정과 라벨 분포를 반환한다. 주 실험은 요청당 Choice 질문 하나를 쓴다. 산문도 두 선택지로 평가할 수 있으므로 판정자의 출력 형식과 평가되는 답의 형식은 다르다.
논문의 주 확신 지표는 명시적으로 정의된다.
q = maxₖ pₖ
반환된 라벨 확률의 최댓값이다. q=0.9는 선택 라벨에 배정한 확률이지 정답 보증은 아니다. 비슷한 q의 실제 정답률을 확인하는 보정과, 오류 순서를 매기는 능력은 따로 평가해야 한다.
별도의 native confidence는 내부 구현이 공개되지 않은 제공자 통계량이다. 논문은 그 대신 q를 그림·오류 탐지·이월에 쓴다. 두 값의 높은 상관은 보정의 증거가 아니다. q는 명시적으로 정의되지만 라벨 확률 생성 내부는 비공개다.
생성형 비교 대상은 JSON에 자기 추정 확률을 적는다. 토큰 logprob가 아니며 JEV의 서비스 제공 분포와 생성 기제가 같다고 가정할 수 없다. 방법 §4
3. 같은 출력 규약에서 무엇을 비교했나
JEV를 포함한 17개 구성은 호스팅 LLM들과 로컬 Qwen 생성형 모델·PairRM·Skywork 보상모델을 포함한다. 생성형 판정자에게도 같은 지시와 상태로 설명 없이 판정·라벨 확률만 요구했다. JEV만 설명을 생략한 실험이 아니다.
반면 내부 계산은 맞추지 않았다. 추론 노력, 모델 크기·학습 자료, 서빙 인프라는 다르다. 설명이 출력되지 않는다고 내부 추론까지 없다는 뜻도 아니다. 구매 가능한 서비스의 운영 비교이지 결정 전용 구조의 계산 효율을 입증하는 인과 실험은 아니다.
| 기본 평가 자료 | 판정 수 | 판정의 의미와 단위 |
|---|---|---|
| RewardBench | 400쌍 | 네 범주에서 각 100쌍을 뽑은 선호 비교 |
| JudgeBench | 350쌍 | GPT-4o 분할의 지식·추론·수학·코딩 정오 비교 |
| HaluEval | 240건 | 120문항의 참조 답·환각 답을 제공 증거에 비추어 판정 |
| 기존 라벨 응답 | 150건 | 최종 답의 정답·오답·무답 라벨과 일치하는지 평가 |
| 궤적·합성 통제 | 172건 | 정답 응답 108건과 합성 증거 통제 64건 |
RewardBench는 공식 전체 점수와 다른 범주 균형 표본이다(Lambert et al., 2025). JudgeBench는 어려운 정오 비교(Tan et al., 2024), HaluEval은 증거 기반 환각 판정이다(Li et al., 2023). 기존 응답의 주석 출처는 불완전하므로 각 라벨이 무엇을 평가하는지 구분해야 한다.
파일럿은 642건이며, 그중 공개 과제 320건만 출처 문항 단위로 선택 128건과 시험 192건으로 나뉜다. 별도 확장 670건을 합치면 기본 자료는 1,312건, 공개 세 과제는 990건이다. 논문에 따르면 파일럿은 추론 전에, 확장은 파일럿 정확도를 보기 전에 동결되었다. 다만 초기 결과 이후 비교 모델 가족과 후속 평가가 추가되었고 다중 가족 비교는 탐색적이다. 확장은 적합에 쓰이지 않았지만 같은 벤치마크 가족이며, 분석자에게 새로 숨겨진 외부 평가도 아니다.
출력은 스키마, 라벨, 확률과 판정의 일관성을 검사한다. 무효 출력은 정확도에서 오답으로 남기고, 확률 지표는 유효 출력만으로 계산한다. 전송 실패만 최대 세 번 시도한다. JEV의 기본 출력 1,312건은 모두 유효했고 다른 여러 제약 생성형 구성도 같았다. 미래의 유효성 보장은 아니다.
신뢰구간은 저자 보고 짝지은 출처 문항 클러스터 부트스트랩 2,000회 결과다. 같은 문항의 답·문체·순서를 함께 묶는다. 기존 응답 150건도 119문항이며 반복 제시를 독립 표본으로 세지 않는다. 자료·분할 Table 4
4. 어떤 판정에서 격차가 작고 커지는가
Tables 1·2·8·19의 발췌다. 정확도는 %, Δ는 JEV−비교 대상의 퍼센트포인트(pp), 구간은 저자 보고 95% 신뢰구간이다.
| 작업·분모 | JEV | 비교 대상 | Δ [95% CI] |
|---|---|---|---|
| RewardBench 400쌍 | 92.2 | GPT-6 93.5 | −1.3 [−3.8, 1.5] |
| HaluEval 240판정·120문항 | 87.5 | GPT-6 86.7 | +0.8 [−1.3, 2.9] |
| 기존 라벨 150응답·119문항 | 94.0 | GPT-6 96.7 | −2.7 [−6.5, 0.7] |
| JudgeBench 350쌍 | 78.6 | GPT-6 93.1 | −14.6 [−18.9, −10.3] |
| RM-Bench hard 480제시·80문항 | 74.8 | GPT-6 94.6 | −19.8 [−27.7, −12.7] |
| RM-Bench normal 480제시·80문항 | 84.0 | GPT-6 93.3 | −9.4 [−16.7, −2.9] |
| RewardBench 2 사지선다 100프롬프트 | 73.0 | Skywork 79.0 | −6.0 [−13.0, 1.0] |
| 문서 기반 요약 80판정·40문서 | 71.2 | GPT-5.4 72.5 | −1.2 [−10.0, 7.5] |
| 참조 없는 응답 80건 | 52.5 | GPT-5.4 55.0 | −2.5 [−11.2, 6.2] |
앞의 세 작업은 GPT-6와 점추정 차이가 3pp 이내지만 동등성·비열등성의 증거는 아니다. 기존 라벨 응답의 구간은 −6.5pp까지 열려 있다. 그 자료는 정답 99·오답 25·무답 26건으로 불균형하며 macro-F1은 JEV 0.923, GPT-6 0.947이다.
GPT-6는 선택된 강한 비교 대상이지 과제마다 최고는 아니다. RewardBench의 Gemini 3.1 Pro는 94.5%, HaluEval의 GPT-5.2는 89.6%다. 표의 차이·구간은 표시된 비교 대상에 대한 값이다. Skywork도 RewardBench 94.0%, JudgeBench 71.1%여서 오래된 PairRM만으로 보상모델을 대표할 수 없다.
RewardBench 2는 사지선다라 이진 선호 정확도와 직접 비교할 수 없다(Malik et al., 2025). 거의 모든 모델이 맞힌 궤적·합성 통제도 넓은 신뢰성을 입증하지는 않는다. 주 결과 §5
5. 낮은 요금과 짧은 지연은 어떻게 측정했나
0.36%의 분모는 공개 세 과제에서 40판정씩 뽑은 동일한 120판정 패널이다. HaluEval은 20문항의 두 답이다. 클라이언트 경합이 있었던 대량 품질 실행과 분리해 측정했다.
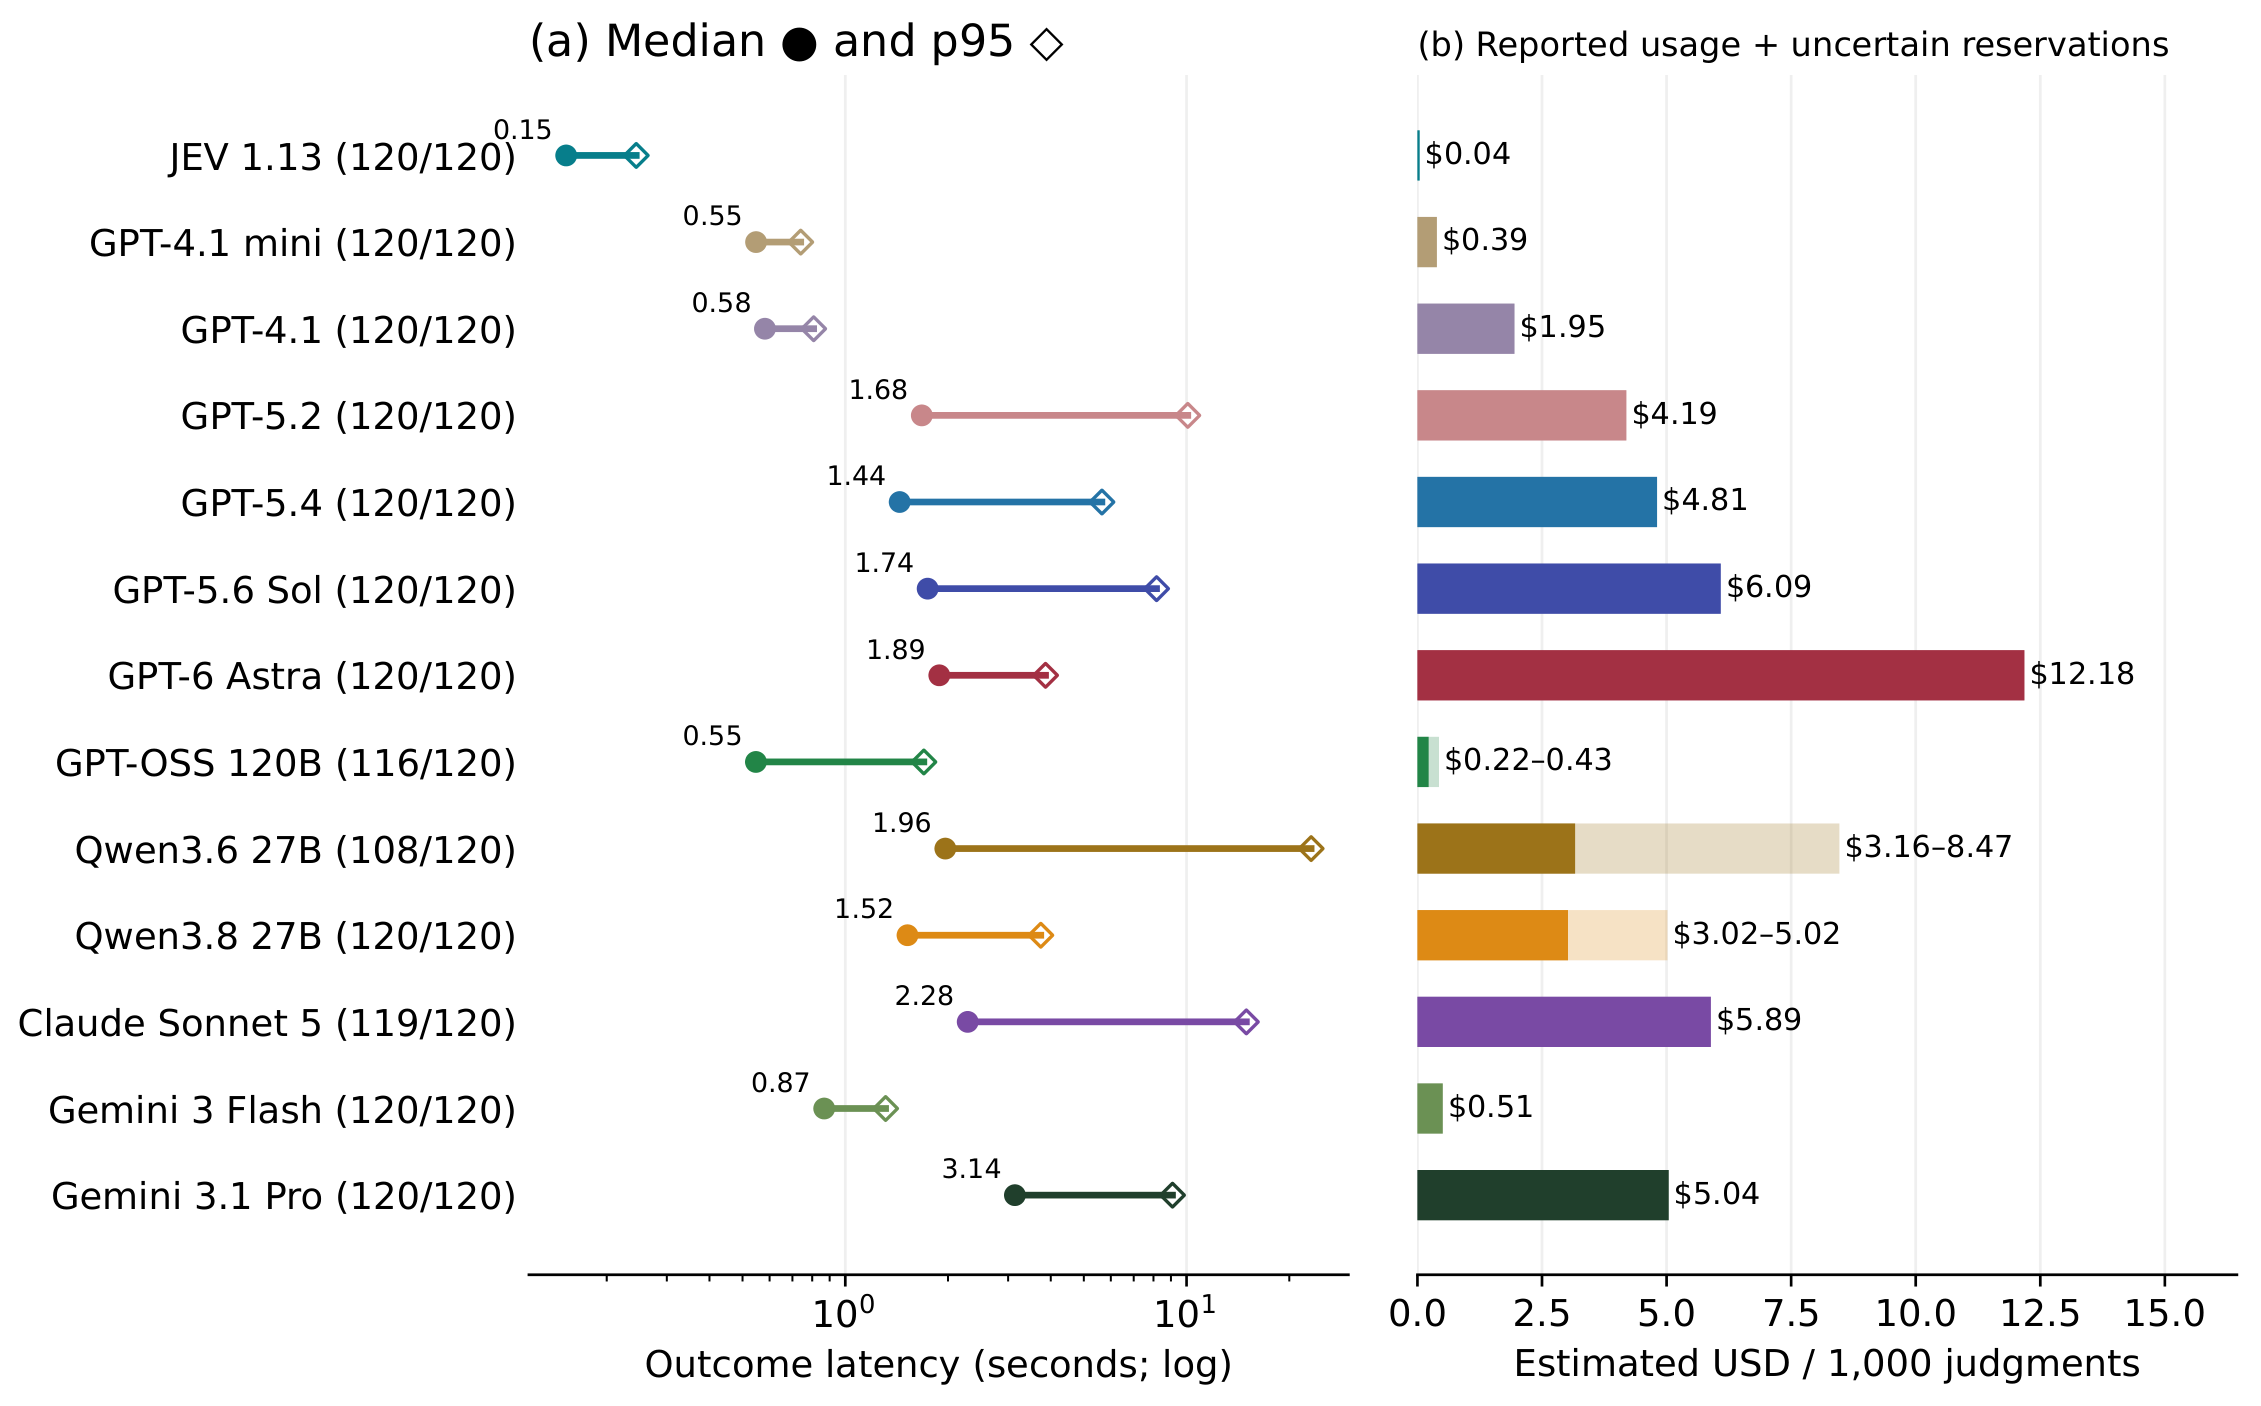
Figure 2. 별도 120판정 패널의 결과 지연과 추정 요금이다. 로컬 연산량이나 실제 순차 캐스케이드 지연의 비교가 아니다. 논문 v1, 7쪽.
JEV는 1,000판정당 0.044, GPT-6는12.182로 보고된다. 비율은 약 0.36%, 역으로 GPT-6 요금의 약 1/277이다. GPT-4.1 mini의 $0.390과 비교하면 약 1/9이다. 이 요금은 수집 시점 공표 가격에 보고 사용량을 적용한 추정치로, 캐시 할인과 과금되는 추론 토큰을 반영한다. 사용량 누락에 대해서는 별도의 보수적 회계를 제시한다. 실제 청구서를 비교한 값은 아니다.
중앙 결과 지연은 JEV 0.152초, GPT-6 1.885초다. 네트워크·제공자 처리·재시도를 포함하므로 약 12.4배라는 중앙값의 비를 처리량 향상이나 순수 추론 가속으로 바꿔 말할 수 없다. 한 수집 환경의 작은 패널이라 꼬리 지연 추정에도 한계가 있다.
낮은 요금은 연산량·에너지·FLOPs의 증거가 아니며 설명 생략의 인과 효과도 아니다. API 등가 가격이 없는 로컬 모델에 이 순위를 확장할 수 없다. 가격·추론 설정·워크로드가 바뀌면 비율도 달라질 수 있다. 측정 §4
6. 확신은 오류를 얼마나 구별하는가
정확도는 선택이 맞는지, Brier·NLL은 정답에 적절한 확률을 배정했는지 본다. 오류 탐지 AUROC는 1−q로 오답을 높은 위험 순서에 놓는 능력이다. 높은 AUROC가 보정을, 낮은 Brier가 더 좋은 라우팅을 보장하지는 않는다.
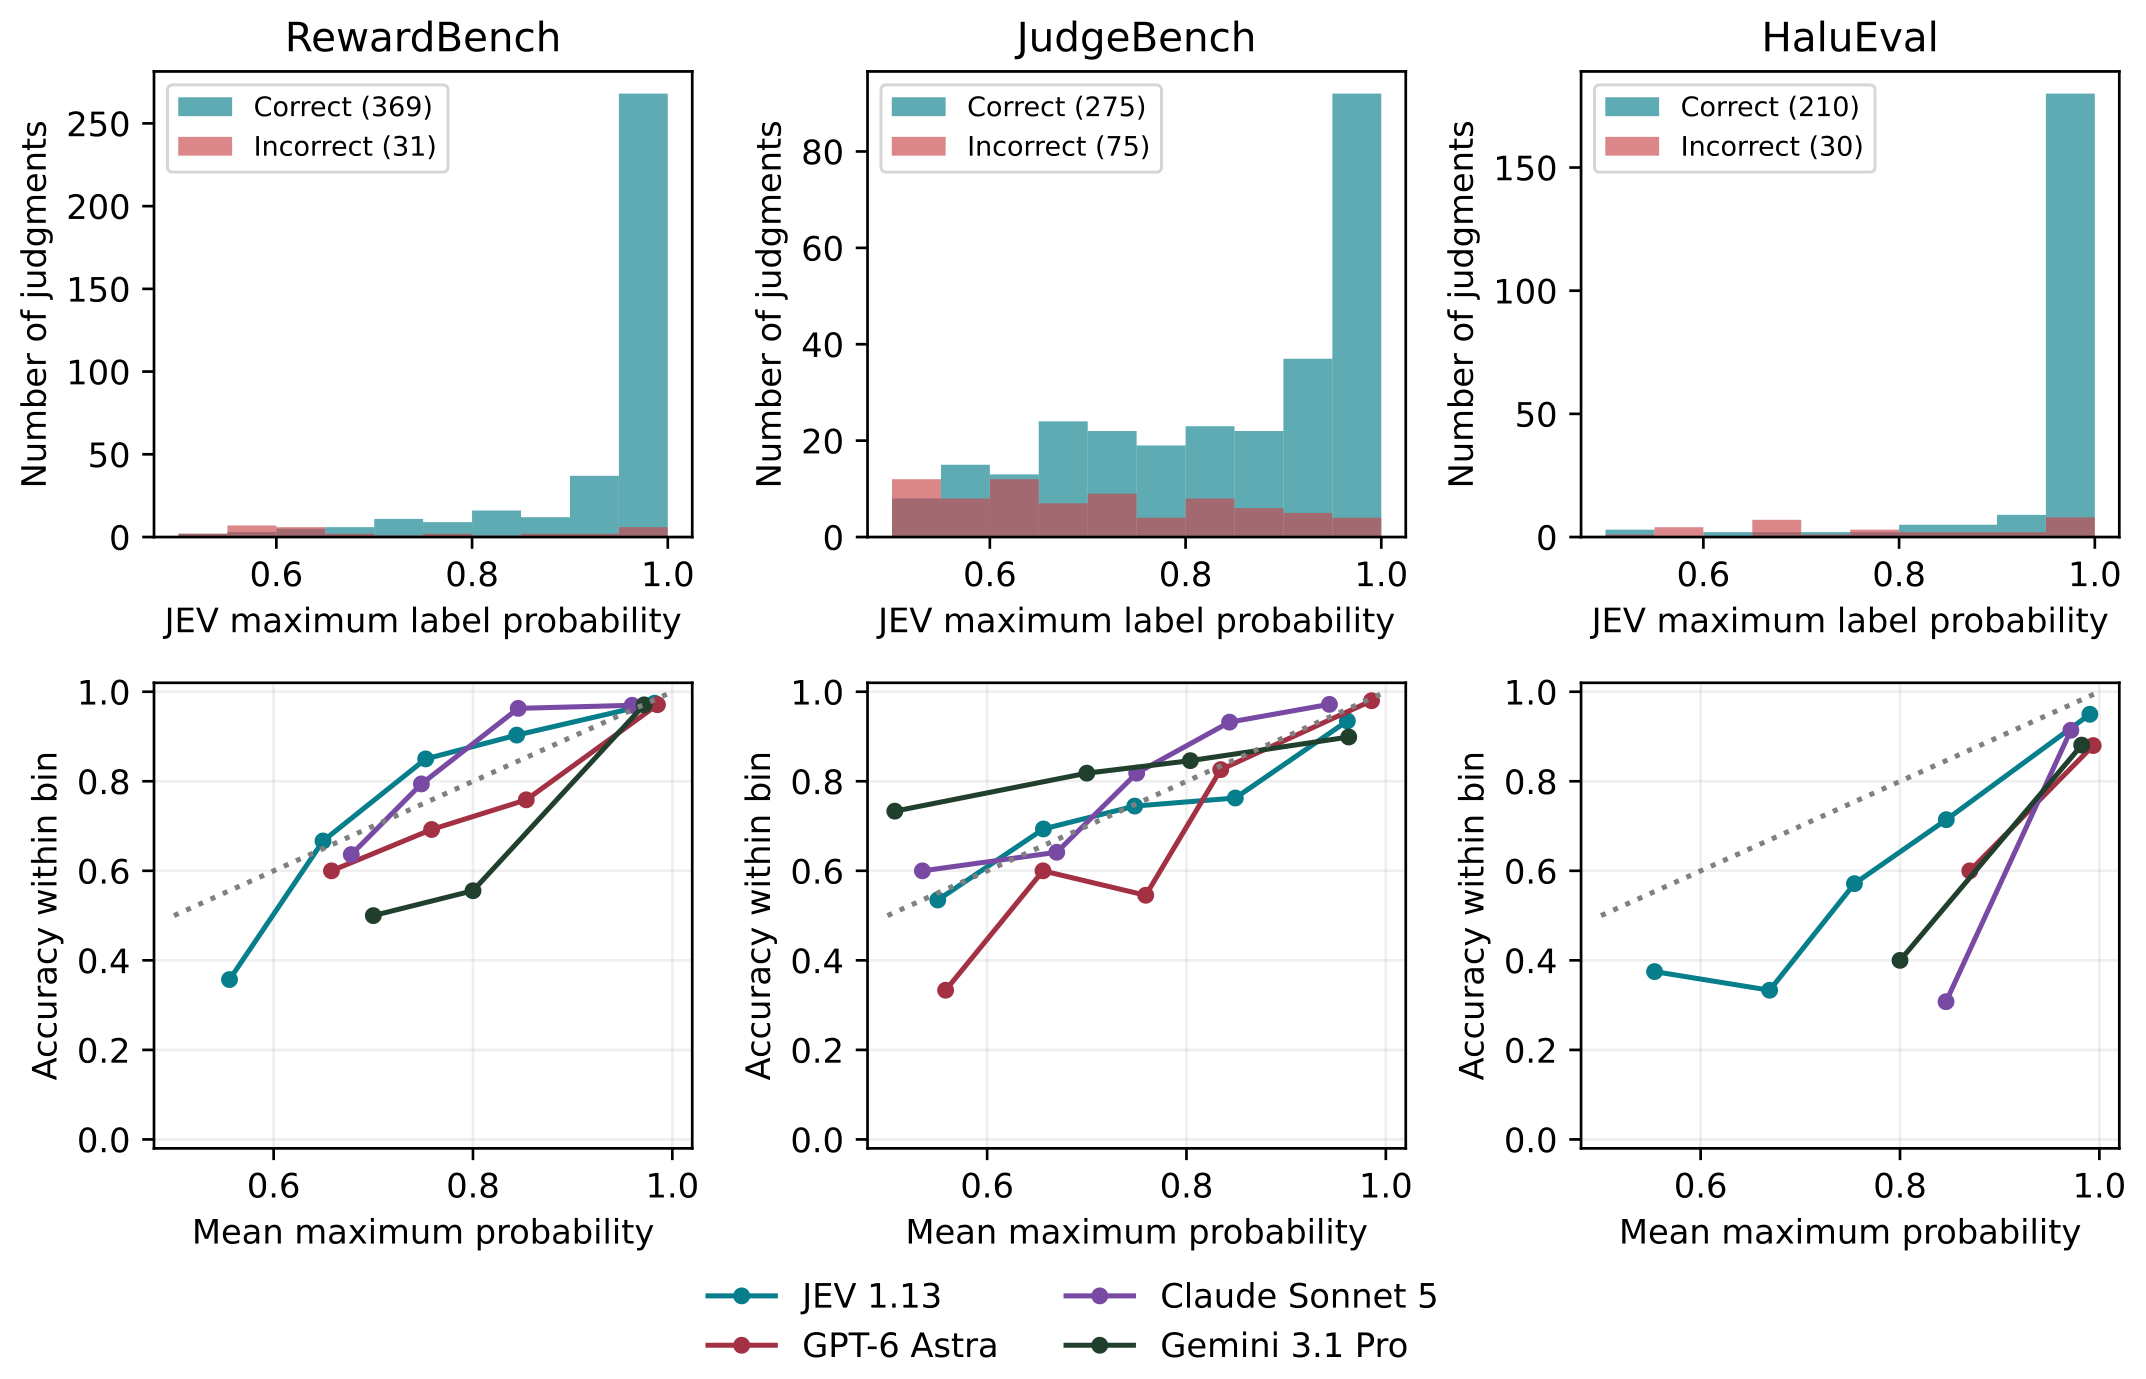
Figure 3. 최대 라벨 확률 q와 실제 정오의 관계다. 희소 구간과 서로 다른 유효 출력 범위 때문에 곡선만으로 우열을 확정할 수 없다. 논문 v1, 8쪽.
JEV의 오류 탐지 AUROC는 RewardBench 0.869, JudgeBench 0.745, HaluEval 0.863이다. GPT-6는 각각 0.891, 0.907, 0.899다. 한편 HaluEval의 기존 라벨 기준 Brier는 JEV 0.176으로 GPT-6 0.245보다 낮다. 즉 같은 작업에서도 JEV가 이 확률 손실 지표에서는 낫지만, 오류 순서를 매기는 AUROC는 GPT-6가 더 높다. 라벨 잡음이 있는 자료라는 조건도 두 지표 모두에 영향을 준다.
공개 세 과제 990건에서 q<0.6인 65건의 정확도는 47.7%, q=1인 322건은 99.1%다. 최대 확률에도 세 오답이 남는다. 합산 정확도는 확신과 함께 대체로 오르지만, 과제와 구간별 표본 수가 달라 모든 구간의 엄격한 단조 관계를 뜻하지는 않는다.
보정 방법으로는 온도 스케일링도 시험한다(Guo et al., 2017). RewardBench 64건, JudgeBench 32건, HaluEval 32판정의 각 과제 선택 집합에 온도를 따로 적합하고 같은 과제의 확장 집합에서 평가했다. HaluEval 확장의 NLL은 0.333에서 0.284로 개선됐지만 RewardBench는 0.205에서 0.232, JudgeBench는 0.449에서 0.475로 악화됐다. 하나의 온도를 다른 과제로 옮긴 실험이 아니며, 보정을 했다는 사실만으로 보류 자료에서 개선된다는 보장도 없다. 이 실험을 다음 절의 정책 게이트에 자동 적용된 보정으로 읽어서도 안 된다.
후보 순서를 뒤집으면 JEV의 선택은 RewardBench 13/400, JudgeBench 39/350에서 달라졌다. 전체 첫 위치 선택률이 약 절반이어도 개별 쌍은 위치에 민감할 수 있다. 이것이 양 순서를 함께 사용하는 동기다. 확률·안정성 §6
7. 순서를 바꿔 판정하고 불확실한 항목을 넘긴다
동결 정책은 한 쌍을 (A, B)와 (B, A) 두 순서로 JEV에 제시한다. p₁(x, y)를 첫 위치 응답에 대한 확률이라 할 때, 두 결과를 의미상 같은 응답 A에 정렬해 평균한다.
p̄(A) = ½[p₁(A, B) + 1 − p₁(B, A)]
순서를 뒤집은 요청에서 첫 위치는 B이므로 1−p₁(B,A)가 A의 확률이 된다. 이 평균으로 판정을 정하고 최대 정렬 평균 확률을 임계값과 비교한다. 두 순서가 반드시 같은 결정을 내려야 한다는 별도 합의 조건이나, 두 확률 중 작은 값을 쓰는 게이트가 아니다. 무효 1단계 출력은 이월하고 정확 동점은 정확도에서 반 점으로 처리한다.
임계값은 **96쌍(RewardBench 64+JudgeBench 32)**에서 폴백 대비 정확도 손실 2pp 이내로 수용률을 최대화해 고른다. 격자와 선택 규칙을 미리 정하고 선택 후 정책을 바꾸지 않고 평가한다. 최종 임계값까지 추론 전에 알려졌다는 뜻은 아니다.
96쌍의 2pp는 순정답 점수 1.92건이다. 두 건이면 약 2.083pp이므로 정확히 두 오답을 허용하는 규칙은 아니다. 작은 선택 집합은 불확실성을 남기지만 특정 실패의 원인이라고 단정할 수 없다.
| 동결 정책: 확장 510쌍 | 임계값 | JEV 수용률 | 정책 / 폴백 정확도 | Δ와 95% CI | 상대 요금 |
|---|---|---|---|---|---|
| JEV → GPT-6 | 0.90 | 53.7% | 92.5% / 93.1% | −0.59pp [−1.78, 0.59] | 56.8% / 보수 회계 62.2% |
| JEV → GPT-5.6 | 0.70 | 81.0% | 91.0% / 93.3% | −2.35pp [−4.5, −0.2] | 28.8% / 보수 회계 38.0% |
확장 510쌍은 RewardBench 240+JudgeBench 270이며 HaluEval은 없다. GPT-6 정책의 유지율 약 99.4%는 92.5/93.1이라는 관측 비율이지 절대 정확도나 최소 99% 유지 보장이 아니다. 구간은 더 큰 손실도 포함하며 동등성도 입증하지 않는다.
요금에는 모든 쌍의 JEV 두 번 호출과 이월 항목의 폴백 사용량이 들어간다. 오프라인 요금 추정이지 실제 순차 지연 측정은 아니다. GPT-5.6은 확장에서 2.35pp를 잃어 목표를 넘었다. 임계값 0.5인 세 정책은 전부 수용해 후속 호출이 없었다. 동결 정책 Table 3
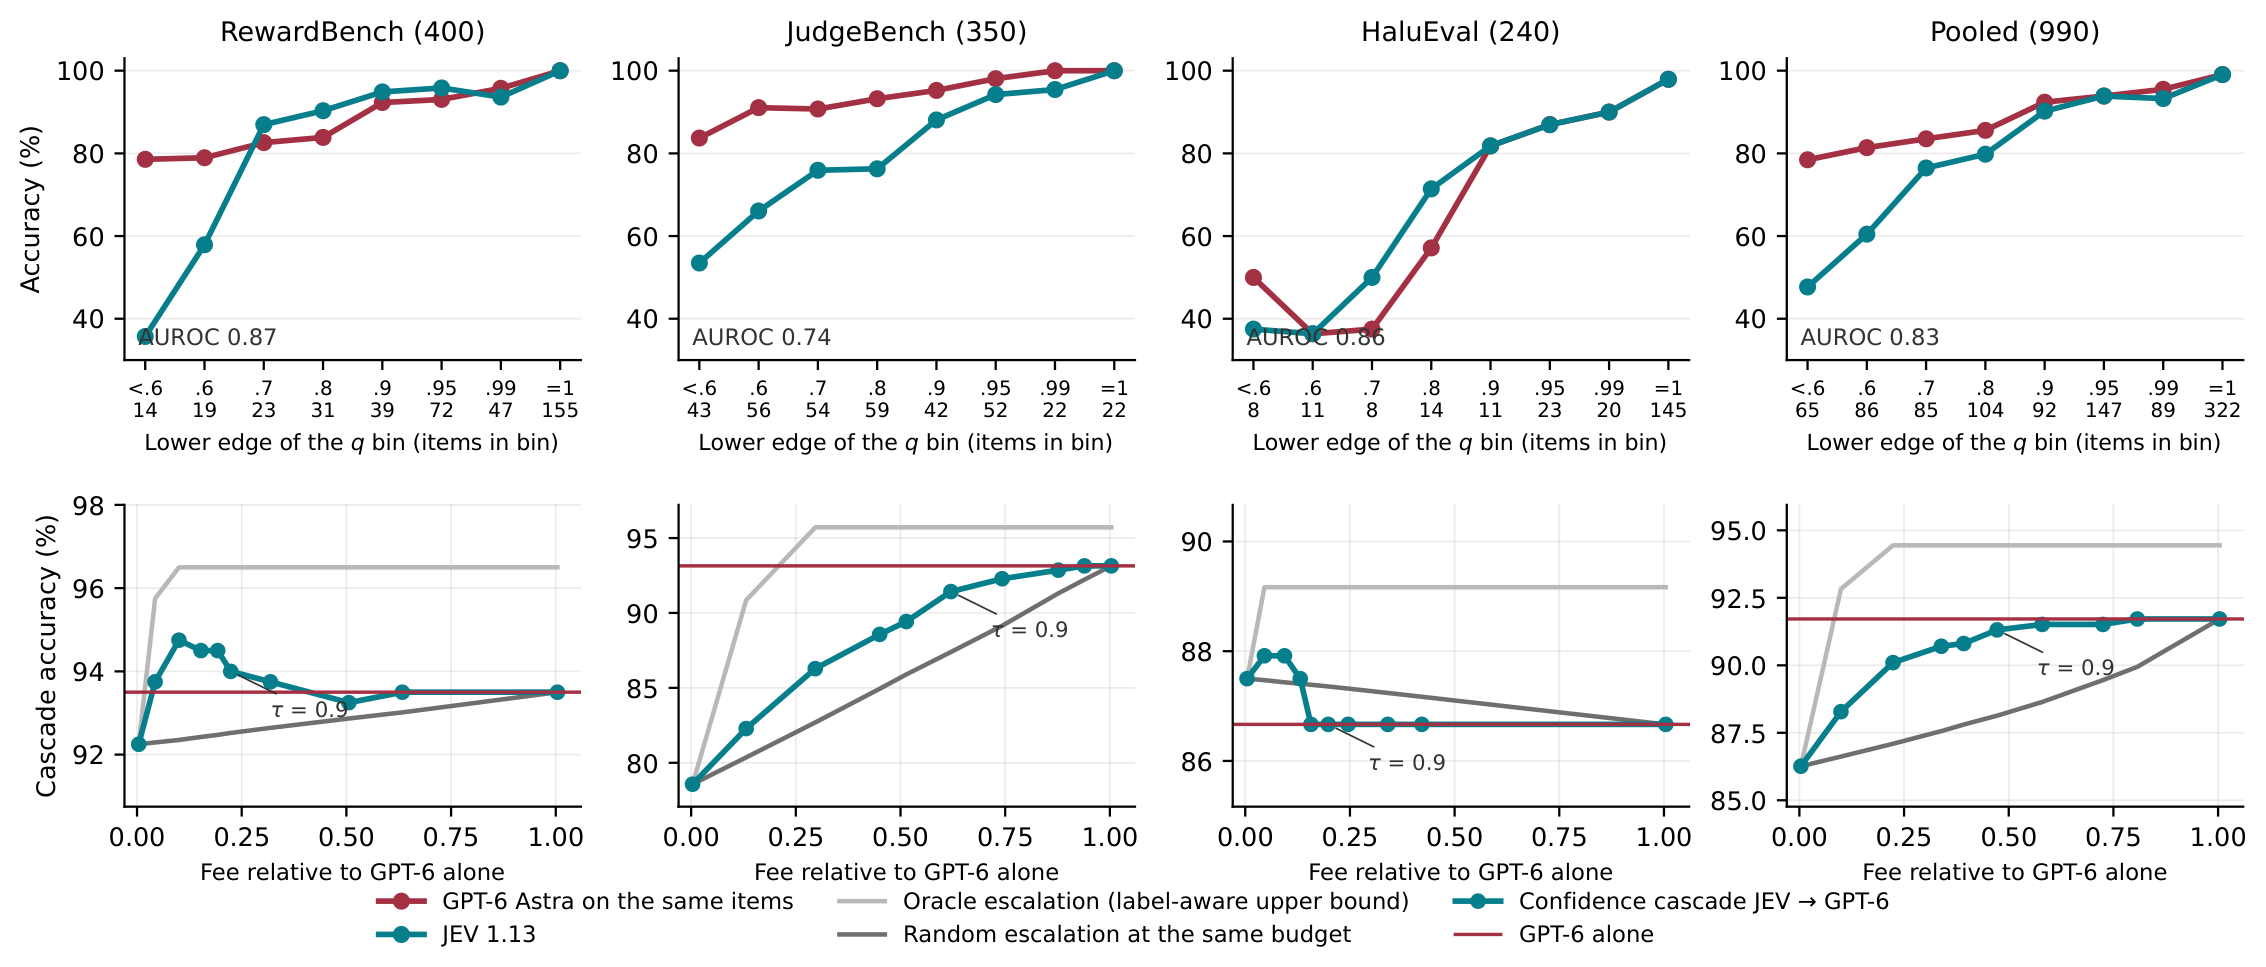
Figure 5. 저확신 구간에서 추가 검토의 이득이 커진다. 아래 곡선은 990판정의 사후 단일 순서 분석으로, 동결된 510쌍 결과와 다르다. 논문 v1, 10쪽.
이 그림의 사후 분석은 세 공개 과제의 단일 순서 990판정에서 임계값을 살펴본 것이다. τ=0.9에서 34.3%를 이월해 정책 91.3%, GPT-6 단독 91.7%, 상대 요금 47%를 보고한다. 작동 가능성을 설명하는 보조 결과지만, 채점된 자료에서 읽은 임계값이므로 동결 정책의 검증과 합쳐서는 안 된다. HaluEval만 보면 Table 13의 τ=0.8은 87.5%, τ=0.9·0.95·0.99는 86.7%로, 네 설정 모두 JEV 단독 87.5%보다 높지 않았다. 모든 임계값에서 정확도가 같았던 것은 아니다.
사후 분석의 약 6.3/1,000판정은 990건 전체 기준요금이 지면에 수치로 없어 검산하지 못했다. 별도 120건의12.182에 47%를 곱해 반박할 수는 없다. 비용은 실제 이월 항목의 사용량과 1단계 호출에 달려 있다.
8. 정교한 오답과 참조 없는 글에서 드러난 경계
그럴듯한 오답을 자신 있게 고르면 게이트는 오류를 놓친다. RM-Bench는 문체를 바꾸어 이 경계를 살핀다(Liu et al., 2024). 80문항×9문체 조합×양 순서로 1,440판정을 얻으며 easy·normal·hard 각 480제시는 같은 80문항을 공유한다.
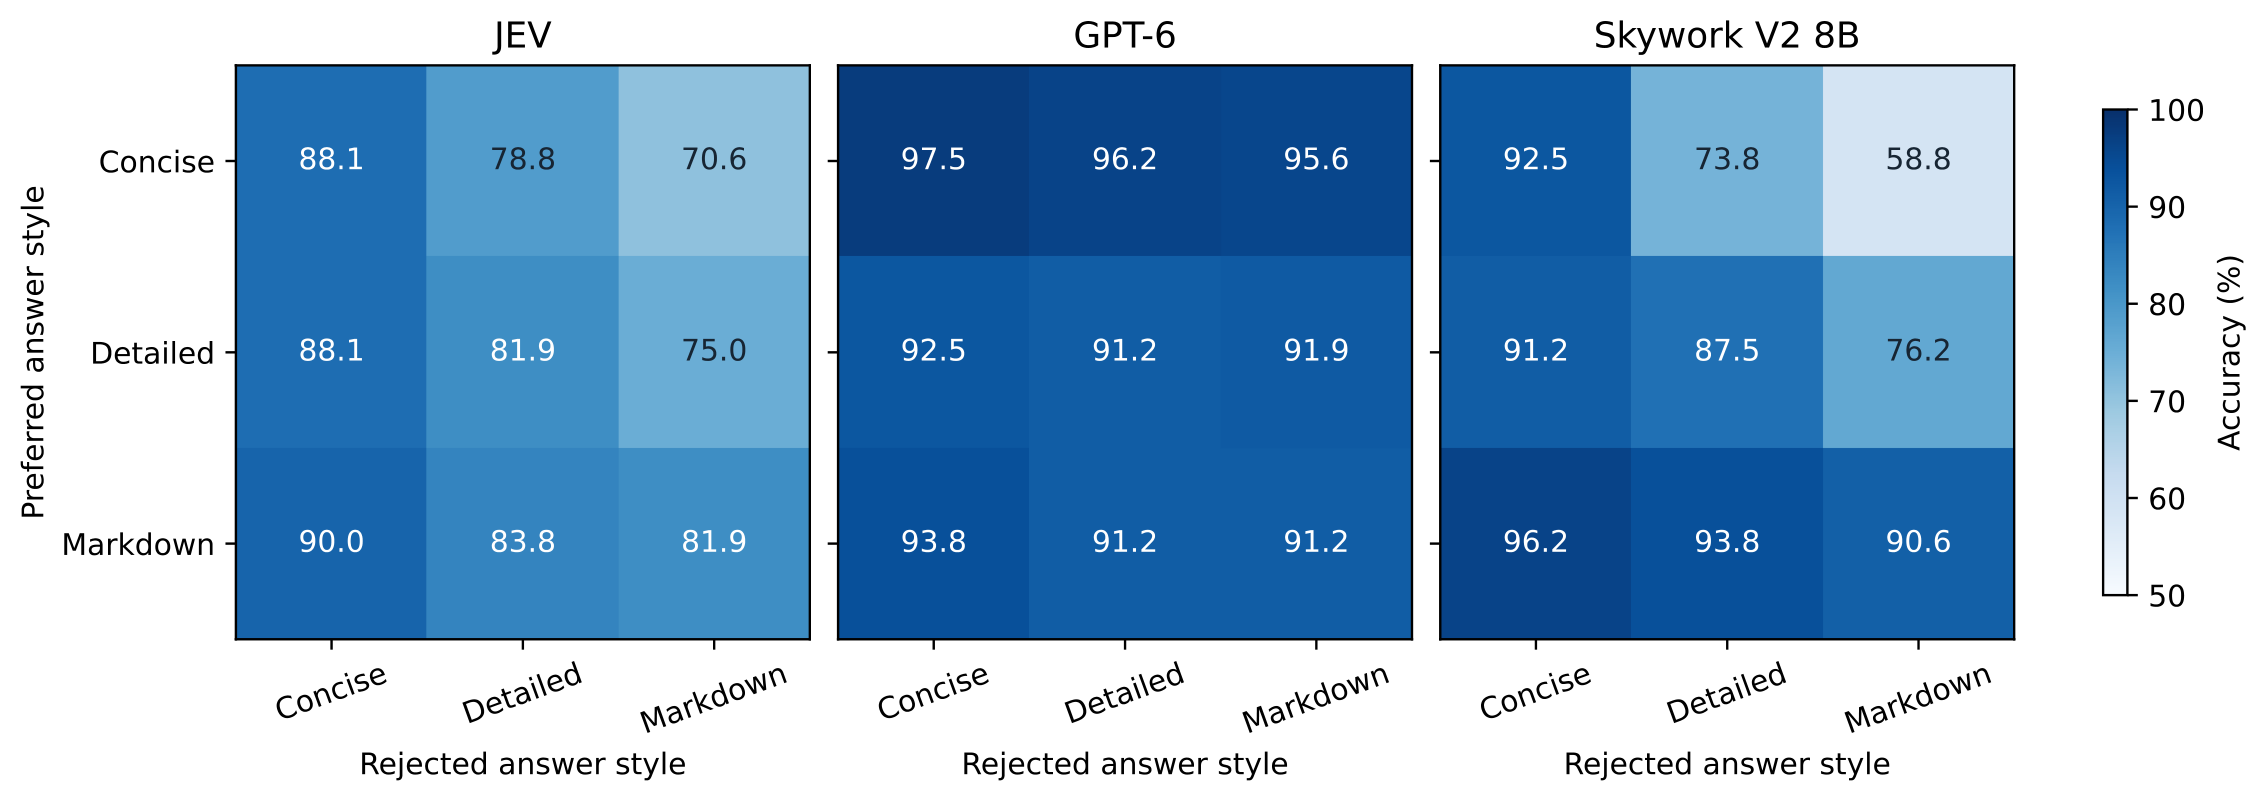
Figure 10. 거부 답을 더 정교하게 쓰면 JEV와 Skywork의 정확도가 낮아진다. 각 셀은 같은 출처 문항의 문체·순서 반복 판정이다. 논문 v1, 20쪽.
JEV는 같은 문체의 normal 84.0%에서 거부 답이 정교한 hard 74.8%로 낮아진다. 출처 내 변화는 −9.2pp [−14.0, −4.8]다. GPT-6는 93.3%·94.6%, Skywork hard는 69.6%다. 문체를 정확성으로 오인하지 않는 능력은 통상적 선호 점수와 다르다.
확신 분석은 분모가 명시된 Table 10을 기준으로 읽는다. JEV는 각 조건 480개 유효 제시에서 easy·normal·hard 오류 탐지 AUROC가 0.916·0.868·0.763이다. q≥0.9인 제시의 오답은 각각 4/320, 11/298, 27/251로, hard의 고확신 집합에도 약 10.8% 오류가 있다. GPT-6의 유효 제시는 easy 478, normal 480, hard 479이며, 제외된 확률 출력도 정확도 분모에서는 오류로 남는다.
여기에는 원문 보고상의 미해결 차이가 있다. §7 본문의 JEV AUROC는 0.918·0.902·0.770, GPT-6 hard 정확도는 94.2%로 Tables 10·8과 다르다. 양 순서 평균 쌍과 개별 제시의 차이일 가능성은 있지만 지면만으로 계산 단위를 확인할 수 없다. 따라서 이 글은 위 표의 분모와 값만 함께 사용하며 두 집계를 섞지 않는다.
참조 없는 자연 응답은 다른 실패 조건이다. 후속 80응답에서 시험한 구성은 JEV·GPT-4.1 mini·GPT-5.4 세 가지뿐이며, 기존 사람 환각 라벨과의 일치율은 52.5%·53.8%·55.0%다. GPT-6는 여기서 평가하지 않았다. JEV의 평균 최대 확률은 0.90, 오류 탐지 AUROC는 0.518이어서 높은 확신에도 관측된 오류 구별 능력이 약했다. 이것이 모든 판정자의 보편적 천장이나 가능한 모든 임계값의 무용성을 증명하지는 않는다.
문서 기반 요약 80건은 40문서에서 만든 구성 라벨을 쓴다. 참조 없는 응답의 기존 사람 주석과 내용·출처가 달라 점수 차이를 참조 제공의 순수 효과로 볼 수 없다. HaluEval 40문항의 답 형식 통제 역시 객관식 100% 대 자유 응답 92.5%를 보여 주지만 다른 워크로드의 격차를 설명하는 인과 분해는 아니다. 재사용된 자료를 독립 표본으로 합산해서도 안 된다. 후속 평가 부록 E·K
9. 사람 재판정은 결과를 어떻게 바꾸었나
벤치마크 라벨과 다르면 항상 판정자가 틀린 것일까? 논문은 이 질문을 위해 183건을 표적 감사했다. 두 판정자 중 하나만 기존 라벨과 일치한 108건, 둘 다 불일치한 55건, 둘 다 일치한 통제 20건이다. 무작위로 전체 벤치마크를 다시 주석한 자료는 아니다.
팀원 한 명이 183건 모두를 판정했다. 패킷에서는 벤치마크 라벨과 판정자 출력, 원 식별자를 가리고 후보 순서도 바꿨다. 당초 사람의 두 번째 통과 대신 Claude가 같은 눈가림 패킷을 검토했으며, 논문은 이 변경을 수정 로그에 기록했다고 설명한다. 사람과 Claude가 다른 39건은 저자가 해결했다. 조정자는 집계 결과는 보았지만 항목 수준 키는 보지 않았다고 보고된다.
Claude는 최종 라벨에 한 표를 보태는 다수결 판정자가 아니라 조정할 항목을 고르는 두 번째 검토자였다. 따라서 최종 라벨은 모두 사람 결정이다. 그렇다고 여러 독립 인간 전문가의 합의라고 부를 수는 없다. RewardBench·JudgeBench·HaluEval의 κ=0.29·0.74·0.81도 사람–사람이 아니라 사람–Claude 일치도다. 최종적으로 36/183건은 미결이다.
사람 판정의 JEV−GPT-6 차이는 RewardBench −3.0pp [−5.3, −0.8], JudgeBench −16.0pp [−20.0, −12.3], HaluEval −2.5pp [−5.0, −0.4]다. 분모는 감사 표본이 아니라 전체 과제의 400·350·240판정이다. 어려운 비교의 GPT-6 우세는 유지됐고, 기존 HaluEval 라벨의 JEV 우세도 사람 판단으로 옮길 수 없다.
HaluEval 공동 불일치 26건 중 24건은 사람이 판정자 쪽을 지지했다. 결정적인 사람 라벨만 대체하고 미결은 유지한 민감도 분석에서 JEV 95.8%, GPT-6 98.3%가 된다. 일부 표적 항목의 라벨 변경이지 새로운 모집단 정답률이나 전수 재주석이 아니다.
JEV에 최종 답 정확성을 우선하라고 지시한 절제 실험의 JudgeBench 개선은 +0.86pp [−1.14, 3.14]였다. 이 지시 변경만으로 격차가 해소되지는 않았지만 모든 루브릭 효과를 배제하는 결과는 아니다. 사람 감사 부록 I
10. 적용 조건과 공개 범위 그리고 결론
가져갈 원칙은 임계값 복사가 아니라 판정 품질과 이월 품질의 분리 검증이다.
- 작업과 라벨의 의미를 정하고, 선택에 쓰지 않은 문항에서 수용률·정확도 손실·고확신 오류를 확인한다.
- 순서를 정렬하고 무효 출력을 정확도에서 빼지 않는다. 확률 지표의 유효 건수는 따로 둔다.
- 두 번의 1차 호출과 실제 이월 사용량·실패·재시도를 비용에 넣고 실시간 지연은 따로 잰다.
- 판본·가격·입력 분포가 바뀌면 보정과 임계값을 다시 검증한다.
JEV의 학습 자료와 확률 생성 내부는 비공개다. 원문 중복 제거도 의미상 중복이나 학습 오염을 배제하지 않는다. 이 조건들이 일반화에 미치는 크기는 미확인이며, 중대한 결정의 최종 중재자로 자동 판정자 하나를 쓰는 근거도 아니다.
부록 L은 입력·저장 판정·코드·사람 감사 자료를 담은 익명 보충 ZIP과 API·GPU 없는 결과 재계산을 설명한다. 확인한 논문 HTML과 arXiv v1 페이지에서 직접 접근 링크를 찾지 못해 내용·실행 가능성은 미확인이다. 공개 코드가 없다는 단정과는 다르다.
이 리뷰는 문서를 대조했지만 모델·실험·통계 재표집을 재실행하지 않았다. 신뢰구간·확률 지표·요금은 저자 보고값이다. RM-Bench 계산 단위와 990건 요금 회계는 미확인이다. Skywork의 Table 1 행은 없지만 본문에 결과가 있으므로 실험 부재가 아니라 제시 누락이다.
JEV와 확신 기반 분업은 일부 작업과 확장 510쌍에서 유용한 비용–품질 절충을 보였다. 어려운 추론·정교한 오답·참조 없는 산문은 실패 경계를 드러냈다. 확신은 정답 인증서가 아니라 추가 검토를 배분하는 신호이며, 실제 오류와의 연결을 작업마다 확인해야 한다.
References
Chen, L., Zaharia, M., & Zou, J. (2023). FrugalGPT: How to use large language models while reducing cost and improving performance [Preprint]. arXiv. https://arxiv.org/abs/2305.05176v1
Geifman, Y., & El-Yaniv, R. (2017). Selective classification for deep neural networks. In I. Guyon, U. von Luxburg, S. Bengio, H. Wallach, R. Fergus, S. Vishwanathan, & R. Garnett (Eds.), Advances in neural information processing systems (Vol. 30). Curran Associates. https://proceedings.neurips.cc/paper_files/paper/2017/file/4a8423d5e91fda00bb7e46540e2b0cf1-Paper.pdf
Guo, C., Pleiss, G., Sun, Y., & Weinberger, K. Q. (2017). On calibration of modern neural networks. In D. Precup & Y. W. Teh (Eds.), Proceedings of the 34th International Conference on Machine Learning (Vol. 70, pp. 1321–1330). PMLR. https://proceedings.mlr.press/v70/guo17a.html
Lambert, N., Pyatkin, V., Morrison, J., Miranda, L. J., Lin, B. Y., Chandu, K., Dziri, N., Kumar, S., Zick, T., Choi, Y., Smith, N. A., & Hajishirzi, H. (2025). RewardBench: Evaluating reward models for language modeling. In L. Chiruzzo, A. Ritter, & L. Wang (Eds.), Findings of the Association for Computational Linguistics: NAACL 2025 (pp. 1755–1797). Association for Computational Linguistics. https://doi.org/10.18653/v1/2025.findings-naacl.96
Li, J., Cheng, X., Zhao, X., Nie, J.-Y., & Wen, J.-R. (2023). HaluEval: A large-scale hallucination evaluation benchmark for large language models. In H. Bouamor, J. Pino, & K. Bali (Eds.), Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing (pp. 6449–6464). Association for Computational Linguistics. https://doi.org/10.18653/v1/2023.emnlp-main.397
Li, Y., Miao, Y., Krishnan, R., & Padman, R. (2026). JEV-as-a-Judge: Accept when confident, escalate when unsure [Preprint]. arXiv. https://arxiv.org/abs/2609.26550v1
Liu, Y., Yao, Z., Min, R., Cao, Y., Hou, L., & Li, J. (2024). RM-Bench: Benchmarking reward models of language models with subtlety and style [Preprint]. arXiv. https://arxiv.org/abs/2410.16184v1
Malik, S., Pyatkin, V., Land, S., Morrison, J., Smith, N. A., Hajishirzi, H., & Lambert, N. (2025). RewardBench 2: Advancing reward model evaluation [Preprint]. arXiv. https://arxiv.org/abs/2506.01937v1
Ong, I., Almahairi, A., Wu, V., Chiang, W.-L., Wu, T., Gonzalez, J. E., Kadous, M. W., & Stoica, I. (2024). RouteLLM: Learning to route LLMs with preference data [Preprint]. arXiv. https://arxiv.org/abs/2406.18665v1
Tan, S., Zhuang, S., Montgomery, K., Tang, W. Y., Cuadron, A., Wang, C., Popa, R. A., & Stoica, I. (2024). JudgeBench: A benchmark for evaluating LLM-based judges [Preprint]. arXiv. https://arxiv.org/abs/2410.12784v1