Dynamic Latent Routing: 이산 코드로 언어 모델의 계산을 조절하기
몇 토큰마다 코드 하나를 골라 모델의 중간 표현을 바꾸면 추론에 도움이 될까? DLR의 라우팅과 공동 학습을 설명하고, 24개 QA 설정의 개선과 산술 코드 개입이 무엇을 보여 주는지 살펴본다.
Paper: Fangyuan Yu; Xin Su; Amir Abdullah (2026). "Dynamic Latent Routing". arXiv:2605.14323v1. PDF · HTML
Abstract: 어려운 문제를 풀게 하려고 언어 모델에 새로운 토큰을 추가하는 대신, 이미 처리하는 문장의 중간 표현을 조절할 수는 없을까. Dynamic Latent Routing(DLR)은 몇 개 토큰마다 이산 코드를 고르고, 그 코드에 대응하는 학습된 벡터를 모델 내부에 더한다. 학습에서는 여러 코드열을 시험해 정답 시퀀스의 조건부 가능도가 가장 높은 후보를 고른 뒤, 언어 모델과 코드북과 라우터를 함께 갱신한다. 논문은 여섯 모델과 네 QA 데이터셋의 24개 설정에서 DLR의 정확도 점추정치가 모두 SFT보다 높으며, 설정별 차이의 평균은 약 6.6퍼센트포인트라고 보고한다. 코드 조절을 끄거나 교체하는 실험은 이 경로가 출력에 영향을 준다는 근거지만, 코드마다 하나의 인간 친화적인 계산 규칙이 생겼다는 뜻은 아니다. GDS 이론은 실제 DLR의 전역 최적성을 보장하지 않고, 같은 계산량의 비교나 학습 변동을 포함한 검증도 아니며, 후보 수와 생성 절차 등은 추가 확인이 필요하다.
Executive Summary
| 항목 | 설명 |
|---|---|
| 질문 | 새 토큰을 넣지 않고, 입력에 맞춰 내부 계산을 조절하는 방법을 학습할 수 있는가? |
| 구조 | 청크 첫 입력 위치의 주입 전 표현으로 코드를 고르고, 대응 벡터를 그 청크의 중간 표현에 더한다. |
| 학습 | 후보 코드열 탐색 → 정답 시퀀스의 가능도로 선택 → 언어 모델·코드북·라우터 공동 갱신이다. |
| 목적함수 | 무조절 능력, 조절된 예측, 선택된 코드의 재학습, 코드 사용의 다양성을 네 손실항으로 다룬다. |
| QA 결과 | 6모델×4과제의 인쇄값에서 설정별 평균 약 +6.6퍼센트포인트다. 데이터·업데이트 수를 맞췄지만 계산량을 맞추지는 않았다. |
| 해석 가능성 | 코드의 사용 맥락과 개입 효과를 관찰할 수 있다. 효과가 있다는 사실은 특정 개념·회로의 정체를 밝혔다는 뜻과 다르다. |
| 이론과 한계 | GDS는 설계 동기이지 DLR의 인증서가 아니다. 실제 후보 수·주입층·일부 기준선 및 코드 프로필에는 문서 내부 불일치가 남는다. |
성능은 저자 보고값을 해설한 것이며, 이 글은 모델 학습이나 벤치마크를 새로 실행한 실험 보고가 아니다. 차이와 평균은 원문 인쇄값을 기준으로 읽는다.
목차
- 답을 더 길게 쓰지 않고 계산을 바꿀 수 있을까
- 코드 하나가 토큰 구간의 중간 표현을 바꾼다
- 여러 코드열을 시험하고 선택을 다시 배운다
- 언어 모델과 라우터는 서로 다른 신호로 배운다
- GDS는 동기를 주지만 DLR을 보증하지 않는다
- 24개 QA 설정에서 개선은 어떻게 나타났는가
- 여러 코드와 선택 학습은 각각 필요한가
- 코드를 바꾸면 답도 바뀌지만 의미가 하나로 정해지지는 않는다
- 작은 산술 모델에서 계산 단서를 찾는다
- 유용한 내부 조절 인터페이스라는 결론의 범위
1. 답을 더 길게 쓰지 않고 계산을 바꿀 수 있을까
중간 과정을 길게 쓰면 계산 기회가 늘어난다. 하지만 오래 계산하는 것과 같은 입력을 다르게 처리하는 것은 다른 선택이다. DLR은 토큰열을 유지하면서 내부 표현을 입력에 따라 조절하도록 학습한다.
Goyal과 동료들의 Think Before You Speak(ICLR 2024)는 pause token으로 계산 여유를 주고, Su와 동료들의 Token Assorted(ICML 2025)는 잠재 토큰과 텍스트를 섞는다. 이런 새 배치의 적응 비용이 부담스러울 수 있는 저데이터 후학습이 DLR의 비교 조건이다.
DLR에는 두 종류의 학습 대상이 있다. 하나는 어떤 조절을 가할지를 나타내는 벡터들이고, 다른 하나는 지금 어떤 조절을 고를지를 결정하는 라우터다. 설명을 위해 네 토큰씩 묶는다고 하자. 첫 구간에서는 코드 7에 해당하는 벡터를 더하고, 다음 구간에서는 코드 2에 해당하는 벡터를 더할 수 있다. 7과 2는 사람이 정해 준 ‘덧셈’이나 ‘검산’ 명령이 아니라 학습되는 선택지의 번호다. 이 코드열은 작동 원리를 설명하는 가상 예시이지 관측된 추론 기록이 아니다.
코드 선택은 이산적이지만 벡터를 더하는 효과는 연속적이다. 이 번호를 토크나이저 어휘에 끼워 넣거나 출력 문장으로 생성하지는 않는다. 모델 내부와 가중치에 접근해야 하므로 텍스트 API에 붙이는 프롬프트 기법도 아니다. 별도의 전문가 신경망을 고르는 MoE와 달리 같은 언어 모델에 더할 벡터를 고른다. 토큰을 추가하지 않아도 후보 평가에는 연산이 필요하므로 무료 계산이나 빠른 추론을 뜻하지는 않는다. 원논문 §1–4
2. 코드 하나가 토큰 구간의 중간 표현을 바꾼다
DLR은 한 층의 토큰별 표현에 벡터를 더한다. 같은 코드가 담당하는 청크의 크기 K는 문장이나 추론 단계가 아니라 토큰 수다.
| 기호 | 의미 |
|---|---|
x_{1:T} |
길이 T의 입력 토큰 시퀀스 |
h_t^{(l)}\in\mathbb R^H |
위치 t, 층 l의 중간 표현 |
l^* |
벡터를 주입하는 층 |
K, M |
청크당 토큰 수와 전체 청크 수 |
C, a_m |
코드북 크기와 청크 m의 코드 번호 |
e_k\in\mathbb R^H |
코드 k에 대응하는 학습 가능한 벡터 |
N |
학습에서 평가할 후보 코드열 수 |
\alpha |
주입 강도. 뒤의 정책 손실 가중치와는 다르다. |
원논문 Eq. (1)–(3)의 구조는 다음과 같다. 토큰 위치는 1부터, 청크 번호는 0부터 센다.
m(t)=\left\lfloor\frac{t-1}{K}\right\rfloor,
\qquad M=\left\lceil\frac{T}{K}\right\rceil.
\begin{aligned}
z_m&=W_{\mathrm{rt}}\operatorname{sg}\!\left(h_{mK+1}^{(l^*)}\right),\\
W_{\mathrm{rt}}&\in\mathbb R^{C\times H}.
\end{aligned}h_t^{(l^*)}\leftarrow h_t^{(l^*)}+\alpha e_{a_{m(t)}}.먼저 청크의 첫 입력 위치에 있는 주입 전 표현을 읽어 코드별 점수 z_m을 만든다. 그 점수로 코드를 선택한 뒤 같은 층의 해당 청크 표현들에 벡터를 더한다. 순서는 ‘먼저 라우팅, 그다음 조절’이다. 선택이 자기 자신의 조절 결과를 먼저 읽어야 한다는 순환 구조로 이해하면 안 된다. 코드북 벡터는 0으로 초기화하지만 학습 후에는 달라질 수 있다.
\operatorname{sg}는 값은 보존하고 해당 역전파 경로만 막는 stop-gradient다. 라우터 가중치 W_{\mathrm{rt}}를 고정하지는 않는다.
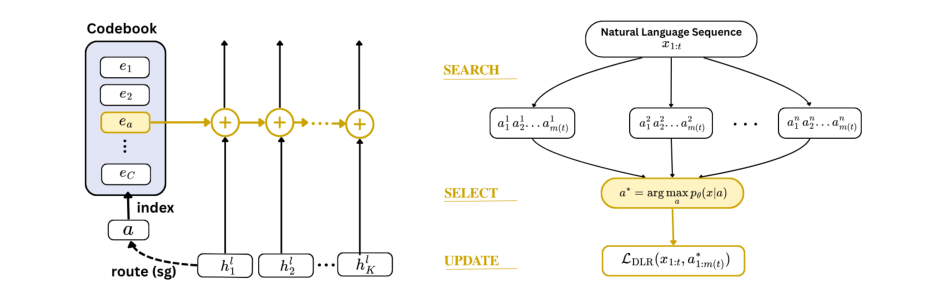
Figure 1. 코드 선택은 청크의 벡터 조절로 이어지고, 학습은 여러 코드열을 비교한다. 출처: Yu, Su, & Abdullah (2026), v1 PDF 5쪽, Fig. 1.
K=4라면 첫 네 입력 위치에 하나의 벡터, 다음 네 위치에 또 하나의 벡터가 적용된다. 앞선 토큰과 조절의 영향을 받은 계산이 이어지므로 코드들은 독립된 명령 카드가 아니며, 효과는 당시 입력과 상태에 의존한다.
입력 위치와 예측 목표도 구분해야 한다. 표준 causal next-token 학습의 해석에서는 h_t가 이미 관측한 x_{\leq t}에서 계산되고 다음 토큰 x_{t+1}을 예측한다. 따라서 청크 첫 입력 토큰의 표현을 읽는다는 사실만으로 미래 정답 누출이 생기는 것은 아니며, 이미 입력된 그 토큰을 같은 위치의 코드가 생성했다고 말해서도 안 된다. 이는 일반적인 한 칸 이동 정렬에 대한 설명이지, 이 논문의 실제 BOS·패딩·청크 경계·캐시 구현을 확인했다는 뜻은 아니다.
3. 여러 코드열을 시험하고 선택을 다시 배운다
데이터에는 정답 토큰이 있지만 정답 코드열은 없다. DLR은 여러 선택을 시험하고 학습 시퀀스를 잘 예측하는 후보를 다시 배우며, 벡터와 그 선택을 함께 학습한다.
Algorithm 2의 한 학습 단계는 다음 네 동작으로 정리된다.
- 라우팅 분포와 온도를 이용해
N개의 후보 코드열을 얻는다. - 각 코드열을 적용했을 때 주어진 학습 시퀀스
x의 조건부 가능도를 계산한다. - 그 후보들 중 가능도가 가장 높은 코드열을 고른다.
- 선택된 코드열을 사용해 언어 모델·코드북·라우터를 공동 갱신한다.
a^*=\arg\max_{a\in\{a^{(1)},\ldots,a^{(N)}\}}
\log p_\theta(x\mid a).
점수는 외부 검증자의 정답 점수가 아니라 현재 모델 자신의 조건부 가능도다. 높은 학습 가능도가 생성 정확도로 이어지는지는 실험으로 확인해야 한다. 모델이 갱신되면 유용한 코드도 바뀌므로, 코드의 의미와 선택 정책을 고정한 채 본체만 학습하는 구조가 아니다.
청크가 M개이고 코드가 C개면 가능한 코드열은 C^M개다. best-of-N은 이 전체 공간의 최적해를 찾는 것이 아니라 샘플링한 후보 집합에서 가장 좋은 것을 고르는 절차다. 실제 주결과의 N은 확정해 소개하기 어렵다. 본문 §5는 8로 적지만 부록 F와 Table 13은 4를 주결과 기본값, 8을 두 배 예산의 절제로 설명한다. 따라서 아래 성능을 특정 후보 예산의 확정된 결과로 묶지 않는다.
학습 때 아는 정답과 배포 때 모르는 정답
알려진 시퀀스로 다음 토큰 가능도를 평가하는 것은 teacher-forced scoring으로 이해할 수 있다. 학습의 후보 선택이 뒤쪽 정답 토큰의 감독을 받는 것은 학습 절차의 일부다. 그것만으로 시험 정답을 사용했다고 볼 수는 없다. 반대로 배포 때에는 정답 시퀀스를 모르므로 이 점수를 그대로 이용해 후보를 고를 수도 없다.
논문의 체크리스트는 평가에서 teacher forcing을 쓰지 않았다고 밝히고, 부록 H에는 QA의 prefill·decode 코드열 흔적이 있다. 따라서 생성 증거가 전혀 없다고 말하는 것은 부정확하다. 다만 정답 없이 후보를 선택하는 규칙, 캐시 갱신과 청크 경계의 처리는 완전한 실행 명세로 제시되지 않는다. 산술 부록의 자기회귀 생성 설명이나 본문의 hard-argmax 해설만으로 모든 QA 추론에서 항상 단일 argmax를 썼다고 확정해서도 안 된다.
4. 언어 모델과 라우터는 서로 다른 신호로 배운다
원논문 Eq. (4)는 네 손실항을 사용한다. 무엇을 학습시키는지 먼저 나누면 수식의 역할이 분명해진다.
| 손실항 | 역할 |
|---|---|
| Generalist | 벡터 조절 없이도 학습 시퀀스를 예측한다. |
| Information Gain | 조절된 시퀀스 가능도를 무조절 기준과 비교한다. |
| Policy Optimization | 탐색에서 선택한 코드열을 라우터가 다시 고르게 한다. |
| Bigram-Zipfian 정규화 | 한 코드로의 붕괴를 억제하고 코드 쌍의 사용 분포를 조절한다. |
긴 로그비는 두 항으로 풀어 쓰면 다음과 같다. p_\theta(x)는 논문이 정의한 무조절 모델 가능도다.
\begin{aligned}
\mathcal L_{\mathrm{generalist}}&=-\log p_\theta(x),\\
\mathcal L_{\mathrm{IG}}&=-\log p_\theta(x\mid a)\\
&\quad+\log\operatorname{sg}(p_\theta(x)),\\
\mathcal L_{\mathrm{policy}}&=-\alpha_{\mathrm{policy}}\log p_\theta(a\mid x),\\
\mathcal L_{\mathrm{reg}}&=\alpha_{\mathrm{reg}}
D_{\mathrm{KL}}\!\left(p_\theta(a)\,\|\,p_{\mathrm{bi\text{-}zipf}}(a)\right).
\end{aligned}
\begin{aligned}
\mathcal L_{\mathrm{DLR}}
={}&\mathcal L_{\mathrm{generalist}}+\mathcal L_{\mathrm{IG}}\\
&+\mathcal L_{\mathrm{policy}}+\mathcal L_{\mathrm{reg}}.
\end{aligned}값의 상쇄와 gradient의 상쇄는 다르다
첫 두 항은 수치만 전개하면 무조절 로그 가능도가 상쇄되는 모양이다. 그러나 분모에 해당하는 기준값에는 stop-gradient가 있다. 선택된 a를 고정하고 Eq. (4)의 첫 두 항에 단위 가중치를 적용할 때 역전파는 다음과 같다.
\begin{aligned}
\nabla_\theta(\mathcal L_{\mathrm{generalist}}+\mathcal L_{\mathrm{IG}})
={}&-\nabla_\theta\log p_\theta(x)\\
&-\nabla_\theta\log p_\theta(x\mid a).
\end{aligned}
즉 무조절 NLL과 조절 NLL을 함께 최적화한다. 기본 모델은 두 NLL에서, 선택된 코드 벡터는 조절된 예측에서 배운다. stop-gradient는 기본 모델 전체의 동결이 아니며 라우터 가중치의 학습도 막지 않는다. 경성 코드 선택 자체를 통과하는 일반적인 미분 경로가 주어진 것은 아니다.
‘Information Gain’이라는 이름도 신중히 읽어야 한다. 논문은 무조절 p_\theta(x)가 코드를 주변화한 분포와 같다는 관계를 증명하지 않는다. 따라서 이 손실을 정밀한 상호정보량 최대화의 증명이나 별도의 대조학습 효과로 바꾸어 설명할 수 없다. 수식에서 직접 확인되는 것은 위의 공동 NLL gradient다. 또 산술 Table 26의 information-gain 가중치는 10이므로, 이 단위 가중치 식을 산술 실험에 그대로 적용해서는 안 된다.
정책 손실은 선택된 코드열에 대한 분류·모방 학습으로, 좋은 후보를 다시 고를 확률을 높인다. PPO나 REINFORCE를 수행하는 것은 아니다.
정규화는 같은 코드만 고르는 붕괴를 다룬다. 연속 코드 쌍의 경험적 분포를 bigram-Zipfian prior와 비교해 자주 쓰는 코드와 드문 코드의 공존을 의도한다. 균등 사용이나 인간 친화적인 의미를 보장하지는 않는다.
구현 명세에는 빈칸이 남는다. 부록 E의 no-grad 누적 통계가 현재 배치의 미분 가능한 확률과 어떻게 결합되는지, 반복 쌍의 확률을 0으로 만드는 처리가 어느 단계에 적용되는지 명확하지 않다. 양의 경험적 질량과 prior의 정확한 0이 만나는 forward KL에는 마스킹·재정규화·평활화가 중요하다. 이는 재구현에 필요한 질문이지, 실제 정규화의 gradient가 없거나 학습이 망가졌다는 확인이 아니다. 부록 D–E
5. GDS는 동기를 주지만 DLR을 보증하지 않는다
General Dijkstra Search(GDS)는 시간 의존 보상의 유한 horizon MDP에서 정책들을 시간축으로 이어 붙이는 탐색이다. 같은 상태·행동의 보상도 시점에 따라 달라지므로 정책도 달라질 수 있다.
Bellman 원리가 불가능하다는 뜻은 아니다. 시간을 포함한 상태 (s,t)에서 동적 계획법을 적용할 수 있으며 논문도 이를 다룬다. 유한 horizon에서는 정적 보상에서도 남은 시간에 따라 최적 행동이 달라질 수 있다.
GDS는 정책 가치와 도달 집합을 우선순위 큐로 관리하며 확장·가지치기한다. 저자들은 가정 아래 최적 목표 도달 정책을 찾는다고 주장한다. 좋은 부분 정책의 임의 조합이 항상 최적이라는 말은 아니며, DLR은 그 큐와 완전한 정책 확장을 구현하지 않는다.
| GDS | 실제 DLR |
|---|---|
| 환경이 정한 시간 의존 보상 | 현재 모델의 조건부 로그 가능도 |
| 명시적 큐, 정책 확장과 가지치기 | 학습된 라우터에서 유한 개 후보 샘플링 |
| 목표 집합과 정책 가치의 비교 | 알려진 학습 시퀀스의 상대적 가능도 비교 |
| 명시된 가정 아래 최적성 주장 | 신경망 공동 학습의 경험적 개선 |
DLR의 점수는 모델 갱신에 따라 변하며, 이는 환경 내부의 시간 의존 보상과 같지 않다. 원논문 61쪽 Limitations의 표현대로 GDS는 동기를 주지만 인증하지는 않는다. 이론의 역할은 설계 관점을 제공하는 것이다.
수학적 해석에서 남는 세 가지 조건
첫째, 후속 정책은 앞선 시간이 지난 환경에서 시작해야 한다. 길이 T_1인 정책 뒤에 길이 T_2인 정책을 실행한다면, 뒤 구간의 보상은 다음과 같이 시점을 옮겨 읽어야 한다.
\begin{aligned}
V_0^{\pi^1\circ\pi^2}(s)
=\mathbb E\Big[&\sum_{u=0}^{T_1-1}\gamma^u r_u(s_u,\pi^1_u(s_u))\\
&+\gamma^{T_1}\sum_{v=0}^{T_2-1}\gamma^v
r_{T_1+v}(s_{T_1+v},\pi^2_v(s_{T_1+v}))\Big].
\end{aligned}
이는 해설자가 시간 이동을 드러낸 식이다. 정리 12와 부록 A는 후속 가치를 shift 없이 표기한다. 암묵적 의도일 수 있지만 정책 인덱스의 재시작과 환경 시계의 재시작은 다르다.
둘째, 목표 도달의 집합 정의에는 분포 조건이 필요하다. 원문의 \mathcal G^\pi(s)는 종료 시점에 양의 점확률을 갖는 상태의 집합이며 목표 도달은 \mathcal G^\pi(s)\subseteq\mathcal G로 정의된다. 유한·이산 분포에서는 목표 밖에 남을 확률을 배제하는 조건이다. 그러나 compact 연속 상태공간의 atomless 분포에서는 모든 점확률이 0이어서 이 집합이 비게 된다. 연속분포까지 확장하려면 지지집합 또는 확률측도에 관한 정의를 보완해야 한다. 목표 집합이 도달 집합에 포함되는 goal-covering은 포함 방향부터 다른 조건이다.
셋째, 보상에서 상한을 빼도 정책 순서가 유지된다는 설명은 평가 길이에 의존한다. 모든 정책이 같은 길이면 뺀 누적 상수가 공통이다. 반면 종료 시점까지 합산하는 가변 길이에서는 그렇지 않다. 해설용 반례로 할인율 0.9에서 보상열 [1]과 [0.75,0.75]의 가치는 1과 1.425다. 매 단계 1을 빼면 0과 −0.475가 되어 순서가 뒤집힌다. 공통 horizon까지의 정산 조건 없이 보상 이동을 일반화할 수 없다는 뜻이지, 처음부터 비양수 보상을 가정한 정리 전체의 반박은 아니다.
가정 표기도 정돈이 필요하다. 정리 13은 A1–A3를 명시하지만 가지치기 보조정리는 값함수 연속성인 Assumption 4를 인용한다. 이론의 compact 상태공간과 체크리스트의 유한 상태·행동공간도 동일한 범위가 아니며, 연속공간에서 모든 한 단계 정책을 유한하게 열거하는 절차는 명시되지 않는다. 이들은 증명과 알고리즘의 적용 범위를 확인해야 할 문서화 문제다. 의도된 유한상태 정리가 거짓이라거나 이 리뷰가 전체 증명을 인증했다는 결론으로 확대하지 않는다. §3, 부록 A–C
6. 24개 QA 설정에서 개선은 어떻게 나타났는가
QA 비교는 Qwen3 0.6B·1.7B·4B·8B와 Llama3.2 1B·3B, 여섯 모델을 대상으로 한다. 본문 설정은 데이터와 optimizer update 수를 맞춘 1 epoch 후학습, 학습률 10^{-5}, effective batch 8, GPU 2×H100을 보고한다. 코드북 크기는 32, 청크 크기는 4로 제시되며 후보 수의 충돌은 앞서 본 대로 미해결이다.
| 데이터셋 | 저자 보고 평가 표본 수 | 과제 |
|---|---|---|
| GSM8K | 1,319 | 수학 문장제 |
| ScienceQA | 2,224 | 과학 질의응답 |
| StrategyQA | 687 | 여러 사실을 연결하는 예/아니오 질의응답 |
| CommonsenseQA(CSQA) | 1,221 | 상식 객관식 질의응답 |
표본 수만으로 전처리·답 추출 규칙까지 확정할 수는 없다. 같은 업데이트는 같은 FLOPs나 GPU 시간이 아니다. 후보 탐색과 무조절·조절 가능도를 계산하는 DLR이 같은 계산 예산의 SFT보다 효율적인지는 별도 질문이다.
아래 각 셀은 **SFT → DLR 정확도(%) [차이, 퍼센트포인트(%p)]**다. 정확도는 Table 1의 저자 보고값, 차이는 인쇄값의 뺄셈이다.
| 모델 | GSM8K | ScienceQA | StrategyQA | CSQA |
|---|---|---|---|---|
| Qwen3-0.6B | 46.0→49.4 [+3.4] | 48.0→55.3 [+7.3] | 47.0→54.6 [+7.6] | 64.1→66.4 [+2.3] |
| Qwen3-1.7B | 60.2→65.7 [+5.5] | 56.4→64.1 [+7.7] | 51.7→60.3 [+8.6] | 74.3→78.4 [+4.1] |
| Qwen3-4B | 75.4→82.1 [+6.7] | 59.4→72.3 [+12.9] | 65.8→68.7 [+2.9] | 82.5→84.0 [+1.5] |
| Qwen3-8B | 78.9→84.3 [+5.4] | 61.8→80.6 [+18.8] | 68.2→72.9 [+4.7] | 85.6→87.2 [+1.6] |
| Llama3.2-1B | 30.9→41.1 [+10.2] | 38.0→49.1 [+11.1] | 48.0→51.4 [+3.4] | 65.2→71.4 [+6.2] |
| Llama3.2-3B | 41.3→49.1 [+7.8] | 56.7→63.3 [+6.6] | 52.5→62.3 [+9.8] | 79.8→81.0 [+1.2] |
| 차이의 모델 간 평균 | +6.50 | +10.73 | +6.17 | +2.82 |
출처: Yu, Su, & Abdullah (2026), Table 1, PDF 7쪽. 원문의 시험 표본 bootstrap 구간은 생략하고 아래에서 해석한다.
24개 설정의 차이 합계는 157.3이고 동일 가중 평균은 +6.554…%p, 약 +6.6%p다. GSM8K·ScienceQA·StrategyQA의 세 추론 과제만 모으면 18개 설정 평균 +7.8%p다. 이는 평가 문항을 모두 합친 정답률 차이가 아니다. 작은 평가셋의 한 설정도 큰 평가셋의 한 설정과 같은 가중치를 갖는다.
ScienceQA의 평균 이득이 가장 크고 CSQA는 상대적으로 작다. DLR은 24개 셀 모두에서 가장 높은 점추정치지만, 모델 크기에 따라 이득이 단조롭게 커지지는 않는다. 보편적인 scaling law가 아니라 이 조건에서의 개선 방향을 보여 준다.
Qwen3-4B/CSQA는 SFT 82.5\pm2.1, DLR 84.0\pm2.1이다. 오차는 시험 문항 bootstrap 95% 신뢰구간 반폭으로 재학습 시드 변동은 포함하지 않는다. 모든 셀의 유의한 개선을 선언하거나 구간이 겹쳐 차이가 없다고 단정할 수 없다. 같은 문항의 paired prediction으로 차이를 분석해야 한다.
TokenAssorted의 Qwen3-4B/ScienceQA는 68.0으로 SFT 59.4보다 높고, PauseToken의 Qwen3-1.7B/CSQA는 76.4로 SFT 74.3보다 높다. ‘선행 방법이 일관되게 SFT에 못 미친다’는 표현은 모든 셀에 맞지 않는다. 준비·적응 예산을 제한한 저데이터 비교를 해당 방법의 무조건적 열세로 확대할 수도 없다.
7. 여러 코드와 선택 학습은 각각 필요한가
절제 실험은 전체 성능에서 나아가 벡터의 수, 라우터 학습, 조절 빈도의 역할을 나누어 묻는다.
| 질문 | 저자 보고 대표 결과 | 해석 |
|---|---|---|
| 하나의 벡터로 충분한가? | Qwen3-8B/ScienceQA: C=1 66.4, DLR 80.6 |
여러 코드의 입력 의존 조절이 유리하지만 코드 수와 파라미터 수도 함께 달라진다. |
| 선택한 코드를 다시 배우는가? | 정책 손실 제거 시 Llama3.2-1B/GSM8K 41.1→17.4 | 좋은 코드의 재선택을 학습하는 경로가 중요하다. |
| 조절된 예측만 학습해도 되는가? | specialist-only: Llama3.2-1B/ScienceQA 49.1→42.7 | 무조절 NLL을 함께 유지하는 설계의 가치를 지지한다. |
| 코드 다양성을 유지해야 하는가? | 정규화 제거 시 거의 한 코드로 붕괴한다고 보고 | 붕괴 방지 장치의 필요성을 지지하되 Zipf prior의 유일한 최적성을 증명하지는 않는다. |
| 자주 조절할수록 좋은가? | Qwen3-0.6B/ScienceQA: K=1 42.3, K=4 55.3 |
더 촘촘한 조절이 항상 좋은 것은 아니다. |
Table 1, Tables 5–9 및 부록 F. 기준선과 주입층의 보고 차이가 있어 모든 행을 완전히 동일한 단일요인 실험으로 확정하지 않는다.
C=1도 기본 모델과 벡터를 함께 학습하므로 동결 모델의 사후 steering과는 다르다. 여러 코드의 이득은 파라미터 수와 선택 구조가 함께 바뀐 결과여서 ‘이산화 자체’의 효과로 분리할 수 없다.
정책 손실 제거의 −23.7%p는 좋은 벡터를 갖는 것만큼 다시 선택하는 학습이 중요함을 시사한다. specialist-only의 −6.4%p는 §4의 gradient 해석과 연결된다. 주요 차이가 무조절 NLL의 동시 학습 여부이므로 로그비만의 독립적인 shaping 효과를 입증한 실험은 아니다.
청크 크기는 조절 빈도의 절충이다. K가 작으면 세밀하게 고르지만 결정 횟수가 늘고, 크면 서로 다른 계산 요구를 한 벡터가 담당한다. Table 9에는 K=2나 8이 기본 4를 조금 앞서는 행도 있어 모든 모델의 최적값을 하나로 일반화할 수 없다. 후보 수와 온도 절제도 탐색 다양성의 역할을 묻지만, 비용을 맞춘 다른 학습 방법과의 비교를 대신하지는 않는다.
Table 2의 ScienceQA 코드 이용률은 31–100%, 벡터 간 평균 cosine similarity는 0.00–0.28이다. 동일 선택·벡터로의 퇴화를 벗어났다는 근거이지, 낮은 이용률이 실패이거나 다른 벡터가 독립적인 의미라는 증명은 아니다.
8. 코드를 바꾸면 답도 바뀌지만 의미가 하나로 정해지지는 않는다
어떤 주제에서 특정 코드가 자주 나오는지는 연관성이고, 코드를 바꿔 출력이 달라지는지는 개입 효과다. 두 증거는 다르며 어느 쪽도 자동으로 완전한 의미 사전이 되지는 않는다.
ScienceQA는 30회 넘게 등장한 코드 n-gram의 대표 주제 비율을 topic purity로 삼는다. Figure 2는 긴 패턴일수록 높은 순도를 보고하며 주제 불균형을 반영한 무작위 기준은 0.17이다. 입력과의 연관성을 지지하지만 패턴 길이와 빈도 필터도 맥락을 좁히므로, 주제를 계산하는 원인이라는 증거는 아니다.
보다 직접적인 질문은 조절을 끄거나 무작위로 바꾸었을 때다.
| Qwen3 모델 | 원래 ScienceQA 정확도 | scale→0 변화 | 무작위 코드 교체 변화 |
|---|---|---|---|
| 0.6B | 55.3% | −6.2%p | −4.8%p |
| 1.7B | 64.1% | −6.4%p | −5.7%p |
| 4B | 72.3% | −12.2%p | −8.1%p |
| 8B | 80.6% | −17.4%p | −11.7%p |
저자 보고, Table 3, PDF 8쪽.
무작위 교체도 성능을 떨어뜨리므로 아무 벡터나 더하는 것이 아니라 학습된 선택과 벡터의 조합이 중요하다는 근거다.
그러나 scale→0은 DLR로 학습한 체크포인트의 조절을 끄는 것이지 별도 SFT 모델로 돌아가는 것이 아니다. Qwen3-8B의 경우 80.6−17.4=63.2이고 SFT는 61.8이다. 따라서 −17.4%p의 조절 제거 효과와 +18.8%p의 전체 후학습 이득은 다른 비교다. 기본 모델도 공동 학습되었다는 사실이 이 차이를 이해하는 열쇠다.
개별 코드의 효과는 더 맥락 의존적이다. Table 4는 모델별 시험한 네 코드의 평균 절제 효과를 −0.71∼−2.74%p로 보고한다. 이는 코드북 전체의 모든 코드 평균이 아니다. Figure 3에서는 Qwen3-0.6B의 코드 0을 절제할 때 biology는 +3.6%p, physics는 −4.0%p다. 이 결과는 코드 0에 ‘생물학’이라는 단일 라벨을 붙이기보다, 같은 조절이 입력에 따라 돕거나 방해할 수 있음을 보여 준다.
교체는 다음 토큰과 라우팅까지 바꾸므로 결과는 총 행동 효과다. 특정 회로의 직접 효과나 개념의 정체를 분리한 값은 아니다. 주제·위치·빈도를 맞춘 통제와 새로운 입력에서의 효과 예측이 더 필요하다.
9. 작은 산술 모델에서 계산 단서를 찾는다
QA의 정답률만으로 내부 계산을 자세히 알기는 어렵다. 논문은 그래서 여섯 자리 덧셈·뺄셈으로 이동한다. carry와 borrow라는 중간 상태를 비교할 수 있는 작은 합성 transformer 실험이며, 대형 QA 모델과는 별개의 설정이다. 대표 분석 모델은 2층·1 attention head·hidden dimension 128, 학습 문제 100K, 청크 크기 1, 코드북 크기 30이다.
예를 들어 논문에 나오는 다음 덧셈은 연속된 올림과 경계 조건을 포함한다.
959{,}271+040{,}756=1{,}000{,}027.저자들은 subtask 정답 라벨을 제공하지 않았는데도 코드 사용이 carry·borrow 유형과 답 위치에 연관되며, 30개 중 23개 코드가 활성화됐다고 보고한다. 이는 학습된 코드와 계산의 관계를 탐색하기 좋은 단서다. 그러나 모든 활성 코드가 한두 위치만 맡는 좁은 전문가인 것은 아니다. Table 23에는 세 위치 이상에 등장하는 코드도 있고, 위치와 연산 유형이 함께 얽힌다. Figure 5와 Tables 22–23의 빈도·대표 subtask 불일치도 있어 코드 번호별 기능을 확정적인 사전으로 합칠 수 없다.
경로에 의존한다는 증거와 오류를 고칠 수 있다는 증거
부록 I.2는 위 대표 모델을 26개 split의 held-out 문제 2,600개에서 평가했다고 보고한다. 모든 코드를 고정된 [UNK] 임베딩으로 대체하는 knockout은 0벡터 주입이나 단순 제거가 아니다.
| 산술 개입 | 저자 보고 정확도 |
|---|---|
| 원래 코드 사용 | 95.5% |
| 코드 순서 shuffle | 26.6% |
| 균등 무작위 코드 교체 | 12.3% |
| 고정 [UNK] 임베딩으로 모든 코드 대체 | 0.1% |
이 결과는 해당 모델이 학습된 코드 경로에 크게 의존함을 보여 준다. 코드 정보의 훼손과 낯선 대체 표현이 만드는 분포 이동을 완전히 분리한 실험은 아니며, 코드 없는 transformer는 산술을 풀 수 없다는 뜻도 아니다. shuffle이 random보다 항상 나쁘다는 식의 일반화도 표와 맞지 않는다. 위 전체 정확도에서는 오히려 shuffle이 더 높다.
반면 일부 코드를 바꾸어 오답을 고치는 실험은 다른 질문이다. 부록 I.4는 오답마다 29개 대체 코드×5개 위치=145개 개입을 시험한다. d0–d2에서 보고한 27–31%는 그 후보 중 고치는 교체가 존재하는 비율이다. 정답을 모르는 정책이 한 번 선택해서 얻은 자동수정 성공률이 아니라 oracle 탐색의 존재 비율이다. 대표적인 d1의 t16→t25 교체도 오답 10개를 고치면서 정답 5개를 망가뜨린다. 분모가 없어 이 수를 새로운 성공률로 바꿀 수 없다.
또 생성은 d0–d6의 일곱 출력 위치를 다루지만 개입은 다섯 위치를 검사하며 그 범위 차이는 설명이 더 필요하다. §6.1의 cross-operation 이식 93.5% 대 무작위 대조 75.5%도 저자 보고값이지만, 표본 분모·기증 코드 선택·시행 절차가 충분히 명시되지 않는다. 이를 전체 오답의 수정률이나 범용 개입 정책의 정확도와 합쳐 읽지 않는다.
좋은 고정 길이 결과가 길이 일반화는 아니다
Table 20에서는 13개 architecture/data-size 설정 중 12개가 전체 정확도에서, 13개 모두가 가장 깊은 C6 carry에서 SFT를 앞선다. 최대 +50%p라는 수치는 2층·1헤드·128차원, 50K 학습의 C6 차이이지 전체 산술 평균이 아니다. 인쇄 점수 차이와 Gap 열이 일부 1%p 어긋나는 행도 있어 반올림 전 원자료 없이 임의로 실험값을 고쳐 쓰지 않는다.
평가 범위는 고정 여섯 자리 입력과 자기회귀 d0→d6 생성이다. 더 긴 피연산자나 학습에 없는 새로운 연산 조합으로의 전이를 보여 주는 프로토콜은 확인되지 않는다. 저자는 split당 100개씩 26개 split을 말하지만 Table 21에는 12개 split 행만 있으며 나머지 14개는 그 표에서 설명되지 않는다. 완전한 생성기·분할 목록과 중복 점검도 제공되지 않아 일반화 범위를 세밀하게 분해하기 어렵다. 이는 누출이 확인됐다는 주장이 아니라 중복과 분할 설계를 독립적으로 판단할 자료가 부족하다는 뜻이다.
자동 설명 역시 보조 분석으로 남는다. 부록 I.7은 코드별 라우터 softmax 확신이 높은 예시 10개를 claude-haiku에 보여 주어 역할을 설명하게 한다. 높은 라우터 확신은 설명의 충실도 점수가 아니다. 그 설명이 새로운 예시의 코드나 개입 효과를 예측하는지 검증한 것과 구분해야 한다. 부록 I
10. 유용한 내부 조절 인터페이스라는 결론의 범위
DLR의 기여는 자연어 시퀀스를 늘리지 않고 입력 의존적인 이산 조절을 배우고 개입하는 인터페이스다. QA의 개선과 산술의 코드 의존성을 인정하되, 코드의 의미와 효율은 별도로 판단해야 한다.
재현에 필요한 불확실성은 다음처럼 모을 수 있다. 설정 차이를 임의로 하나의 값으로 통일하지 않는 것이 중요하다.
| 확인할 묶음 | v1에서 남은 불일치 또는 명세 한계 |
|---|---|
| 탐색 예산 | §5는 N=8이지만 부록 F·Table 13은 N=4 주결과와 N=8 두 배 예산을 명시한다. 실제 주결과 예산은 미확정이다. |
| 주입층과 기준선 | 부록 F·Tables 16–17의 작은 Qwen/Llama1B/Qwen4B 최적층은 1/14/22인데 절제 표는 14/10/19다. Qwen4B/CSQA의 Tables 5–7 delta도 Table 1의 84.0이 아닌 83.0을 기준으로 한 모양이며, C=1의 Tables 1·8 점수도 다르다. 실제 체크포인트 대응 없이는 순수한 단일요인 비교로 확정하기 어렵다. |
| 코드 프로필 | Figure 5의 t20은 UD 84%지만 Table 23은 UB 24%로 적는다. 빈도도 달라 실행·필터·번호 체계 차이인지 표기 오류인지 미해결이다. |
| 실행 명세 | 평가 no-teacher-forcing 진술과 생성 흔적은 있으나 QA의 gold-free 선택·캐시·정렬, prior의 미분 경로·평활화는 더 상세한 명세가 필요하다. |
| 공개와 재현 | 부록 I는 ‘released code’를 언급하지만 체크리스트 5·13은 제출본 미공개·출판 시 공개라고 쓴다. 이 리뷰는 현재 공식 저장소를 검증하지 않았으며 v1의 충돌을 현재 비공개라는 단정으로 바꾸지 않는다. |
이 차이는 결과의 허위나 구현 고장의 증거는 아니지만 체크리스트의 긍정 응답만으로 사라지지도 않는다. 후보 수는 비용, 주입층과 기준선은 비교 조건, 프로필은 의미 해석에 영향을 준다.
후속 질문은 같은 계산 예산에서도 개선되는가, 정답 없이 유용한 개입을 선택하는가, 위치·길이·조합이 바뀌어도 코드 기능이 유지되는가다. 다중 학습 시드와 paired 평가도 필요하다. 이는 완료된 추가 실험이 아니라 검증 제안이다.
적용 범위는 저데이터 후학습, 두 모델 계열, 0.6B–8B와 네 QA 과제다. 긴 시퀀스·큰 데이터의 continued pretraining, 일반 능력 유지와 서빙 비용은 별도 검증이 필요하다.
최적성 정리와 경험적 개선은 다르고, 정확도 향상과 효율 향상은 다르며, 코드 개입 가능성과 완전한 추론 프로그램의 해독도 다르다. 현재 증거에 가장 잘 맞는 평가는 DLR이 학습 가능하고 관찰 가능한 내부 조절 인터페이스를 제시했다는 것이다. 유용성은 관측됐지만 그 인터페이스의 정확한 실행 예산과 안정된 의미, 새로운 조건으로의 전이는 더 확인해야 한다.
References
Goyal, S., Ji, Z., Rawat, A. S., Menon, A. K., Kumar, S., & Nagarajan, V. (2024). Think before you speak: Training language models with pause tokens. In B. Kim, Y. Yue, S. Chaudhuri, K. Fragkiadaki, M. Khan, & Y. Sun (Eds.), International Conference on Learning Representations (pp. 27896–27923). https://proceedings.iclr.cc/paper_files/paper/2024/file/76917808731dae9e6d62c2a7a6afb542-Paper-Conference.pdf
Su, D., Zhu, H., Xu, Y., Jiao, J., Tian, Y., & Zheng, Q. (2025). Token assorted: Mixing latent and text tokens for improved language model reasoning. In A. Singh, M. Fazel, D. Hsu, S. Lacoste-Julien, F. Berkenkamp, T. Maharaj, K. Wagstaff, & J. Zhu (Eds.), Proceedings of the 42nd International Conference on Machine Learning (Proceedings of Machine Learning Research, Vol. 267, pp. 57144–57163). PMLR. https://proceedings.mlr.press/v267/su25g.html
Yu, F., Su, X., & Abdullah, A. (2026). Dynamic latent routing [Preprint]. arXiv. https://arxiv.org/abs/2605.14323v1