A Decoder-Only Foundation Model for Time-Series Forecasting
TimesFM은 여러 시계열을 사전학습해 새 데이터셋을 zero-shot 예측하려는 decoder-only 모델이다. 집계 방식과 데이터셋별 편차를 함께 읽어야 성능 범위를 알 수 있다.
Paper: Abhimanyu Das; Weihao Kong; Rajat Sen; Yichen Zhou (2024). "A Decoder-Only Foundation Model for Time-Series Forecasting". https://proceedings.mlr.press/v235/das24c.html · arXiv:2310.10688v4
Abstract: Das et al.은 대규모 시계열을 함께 사전학습한 뒤 처음 보는 데이터셋에서 가중치 미세조정 없이 예측하는 decoder-only foundation model TimesFM을 제안한다. 200M 모델은 시계열을 길이 32의 비중첩 입력 패치로 바꾸고, causal Transformer의 각 출력에서 다음 128개 시점을 MSE로 학습한다. 첫 패치 일부를 무작위로 가리는 방식으로 다양한 문맥 길이를 노출하며, 긴 예측 지평에서는 생성한 128시점 패치를 다시 입력에 붙여 필요한 만큼 자기회귀한다. 저자 보고에서는 Monash·Darts·ETT에서 데이터셋별 지도학습 모델과 경쟁하는 집계 성능을 보이지만, Monash 순위는 집계 방식에 따라 달라지고 Darts에서는 두 집계 모두 3위다.
Executive Summary
| 항목 | 설명 |
|---|---|
| 연구 질문 | 서로 다른 도메인·시간 입도·예측 지평의 시계열을 함께 사전학습한 하나의 모델이, 처음 보는 데이터셋에서도 별도 학습 없이 데이터셋별 지도학습 모델과 경쟁할 수 있는가. |
| 핵심 기여 | 시계열을 겹치지 않는 패치로 토큰화해 decoder-only Transformer에 넣고, 입력 패치보다 긴 출력 패치를 한 번에 생성하는 TimesFM을 제안했다. |
| 방법적 결과 | 200M 모델은 길이 32의 입력 패치를 causal attention으로 처리해 다음 128시점을 MSE로 예측한다. 첫 패치의 부분 masking으로 다양한 문맥 길이를 학습하고, 128보다 긴 지평은 출력 패치를 이어 붙여 자기회귀한다. 사전학습 loader는 real 80%·synthetic 20%를 표집한다. |
| 실험 결과 | Monash에서는 기하평균 기준 TimesFM 0.6846이 1위지만 산술평균에서는 0.8005로 2위다. Darts에서는 두 집계 모두 3위다. Monash·Darts 26개 데이터셋 중 5개에서는 naive 기준선보다 오차가 크고, ETT의 PatchTST(ZS) 평균 0.349는 TimesFM 0.364보다 낮다. |
| 핵심 한계 | 순위가 집계 방식과 비교군 구성에 민감하며, 일부 Monash 데이터셋에서는 추론 시 문맥 길이를 선택했다. 사전학습 그룹 내부 표집, 평가 데이터와의 겉보기 중첩, 본문 도판과 부록 표의 방법 대응도 문서만으로 완전히 재구성되지 않는다. |
목차
- 데이터셋별 모델에서 범용 시계열 예측 모델로
- 예측 문제 정의와 zero-shot의 범위
- TimesFM의 decoder-only 패치 아키텍처
- 사전학습 코퍼스와 데이터 혼합
- 설계 선택과 절제
- 평가 설계와 비교 조건
- 결과와 절제
- 결과가 뒷받침하는 범위
- 결론
1. 데이터셋별 모델에서 범용 시계열 예측 모델로
1.1 데이터셋마다 다시 학습하던 방식
시계열 예측은 보통 데이터셋마다 모델과 하이퍼파라미터를 다시 맞춘다. local model은 개별 시계열마다 하나씩 학습하고, global model은 한 데이터셋 안의 여러 시계열을 함께 학습한다. 데이터가 바뀌면 두 방식 모두 재학습이나 조정이 필요하다. TimesFM이 묻는 질문은 한 단계 더 크다. 도메인·시간 입도·문맥 길이·예측 지평이 다른 시계열을 함께 학습한 하나의 전역 모델이 새로운 데이터셋에도 바로 전이될 수 있는가.
텍스트 foundation model과 달리 시계열에는 고정 vocabulary가 없고, 값의 scale과 sampling frequency도 제각각이다. 월별 수요 24개와 15분 간격 센서값 512개는 같은 길이의 문장이 아니다. TimesFM의 기여를 보려면 Transformer를 썼다는 사실보다, 이런 이질성을 공통된 패치 예측 문제로 바꾼 설계를 봐야 한다.
1.2 기존 접근과 TimesFM의 위치
| 접근 | 평가 시 적응 | TimesFM과의 차이 |
|---|---|---|
| ARIMA·ETS | 데이터별 parameter 추정 | 개별 시계열에 맞춘 통계 모델 |
| N-BEATS·PatchTST | 데이터셋별 재학습·튜닝 | 강한 supervised 기준선 |
| llmtime | prompting 기반 zero-shot | 숫자를 text token으로 다루는 대형 LLM |
| TimeGPT-1 | 공개된 적응 세부가 제한적 | 동시기 시계열 foundation model |
| TimesFM | 기본적으로 가중치 고정 | 시계열 전용 200M decoder-only 패치 모델 |
PatchTST도 패치를 쓰지만 일반적으로 주어진 문맥에서 정해진 지평을 예측하도록 encoder 중심으로 학습한다. TimesFM은 causal next-patch 목적함수로 여러 문맥 길이와 지평을 한 모델에 넣으려 한다. 이 차이가 Appendix A.4의 동조건 PatchTST(ZS) 절제로 이어진다.
1.3 연구 질문
| 질문 | 이 논문이 택한 답 |
|---|---|
| 서로 다른 길이의 시계열을 어떻게 공통 입력으로 만들까. | 값을 비중첩 패치로 묶어 Transformer token으로 변환한다. |
| 문맥과 지평 길이를 미리 고정하지 않고 어떻게 학습할까. | 첫 패치 일부를 masking하고 모든 patch position에서 다음 구간을 예측한다. |
| 긴 지평의 자기회귀 비용을 어떻게 줄일까. | 입력 패치 32보다 긴 출력 패치 128을 생성한다. |
| 서로 다른 입도와 패턴을 어디서 확보할까. | Wiki·Trends·공개 데이터와 합성 시계열을 mixture로 학습한다. |
2. 예측 문제 정의와 zero-shot의 범위
2.1 문맥에서 지평으로
과거 문맥을 y_{1:L}=(y_1,\ldots,y_L), 앞으로 맞혀야 할 지평을 H라 두면 목표는 다음 mapping이다.
f:y_{1:L}\longrightarrow \widehat{y}_{L+1:L+H}하나의 사전학습 모델이 데이터셋마다 달라지는 L, H, 시간 입도를 함께 처리해야 한다. 논문의 직접 범위는 univariate point forecasting이다. 모델 입력은 목표 시계열 하나이며, 데이터셋별 static·dynamic covariate는 사전학습에 넣지 않는다. 날짜 파생 feature와 공변량 결합, 확률 예측은 Appendix A.1·A.7에서 후속 과제로 다룬다.
2.2 학습 목표와 평가 지표는 다르다
TimesFM은 모든 예측 구간의 mean squared error(MSE)를 최소화한다. 반면 주요 zero-shot 평가는 mean absolute error(MAE)와 이를 naive MAE로 나눈 scaled MAE를 쓴다. MSE는 큰 오차에 더 큰 벌점을 주고 MAE는 절대 오차를 선형으로 다루므로 두 목적의 순위가 항상 같지는 않다. 이는 오류가 아니라 설계 선택이지만, 학습 objective와 headline metric이 동일하다고 설명해서는 안 된다.
논문은 여러 quantile head나 확률분포 likelihood로 확장할 수 있다고 제안한다. 그러나 ICML 2024의 200M 결과는 MSE로 학습한 point forecast다. quantile forecasting은 구현 가능한 방향이지 이 논문이 실험으로 입증한 기능이 아니다.
2.3 TimesFM이 말하는 zero-shot
목표는 한 번 학습한 모델 하나로 도메인·지평·시간 입도가 다른 여러 데이터셋을 예측하는 것이다. 여기서 zero-shot은 평가 데이터셋마다 모델 가중치를 다시 학습하지 않는다는 뜻이다. 모델 규모는 200M 파라미터, 사전학습 데이터는 O(100B) 시점으로 당시 대형 언어 모델보다 작다.
다만 적용 과정 전체가 데이터셋 독립적이라는 뜻은 아니다. 일부 Monash 데이터셋에서는 훈련 구간의 마지막 horizon을 검증 대상으로 삼아 문맥 길이 32·64·최대 길이 중 하나를 골랐다. 가중치는 고정되어 있으므로 논문의 zero-shot 정의에는 들어가지만, 완전한 out-of-box 고정 설정과는 구분해야 한다. Appendix A.3의 10% fine-tuning 실험은 별도 축이며 zero-shot 결과에 포함되지 않는다.
3. TimesFM의 decoder-only 패치 아키텍처
3.1 전체 흐름
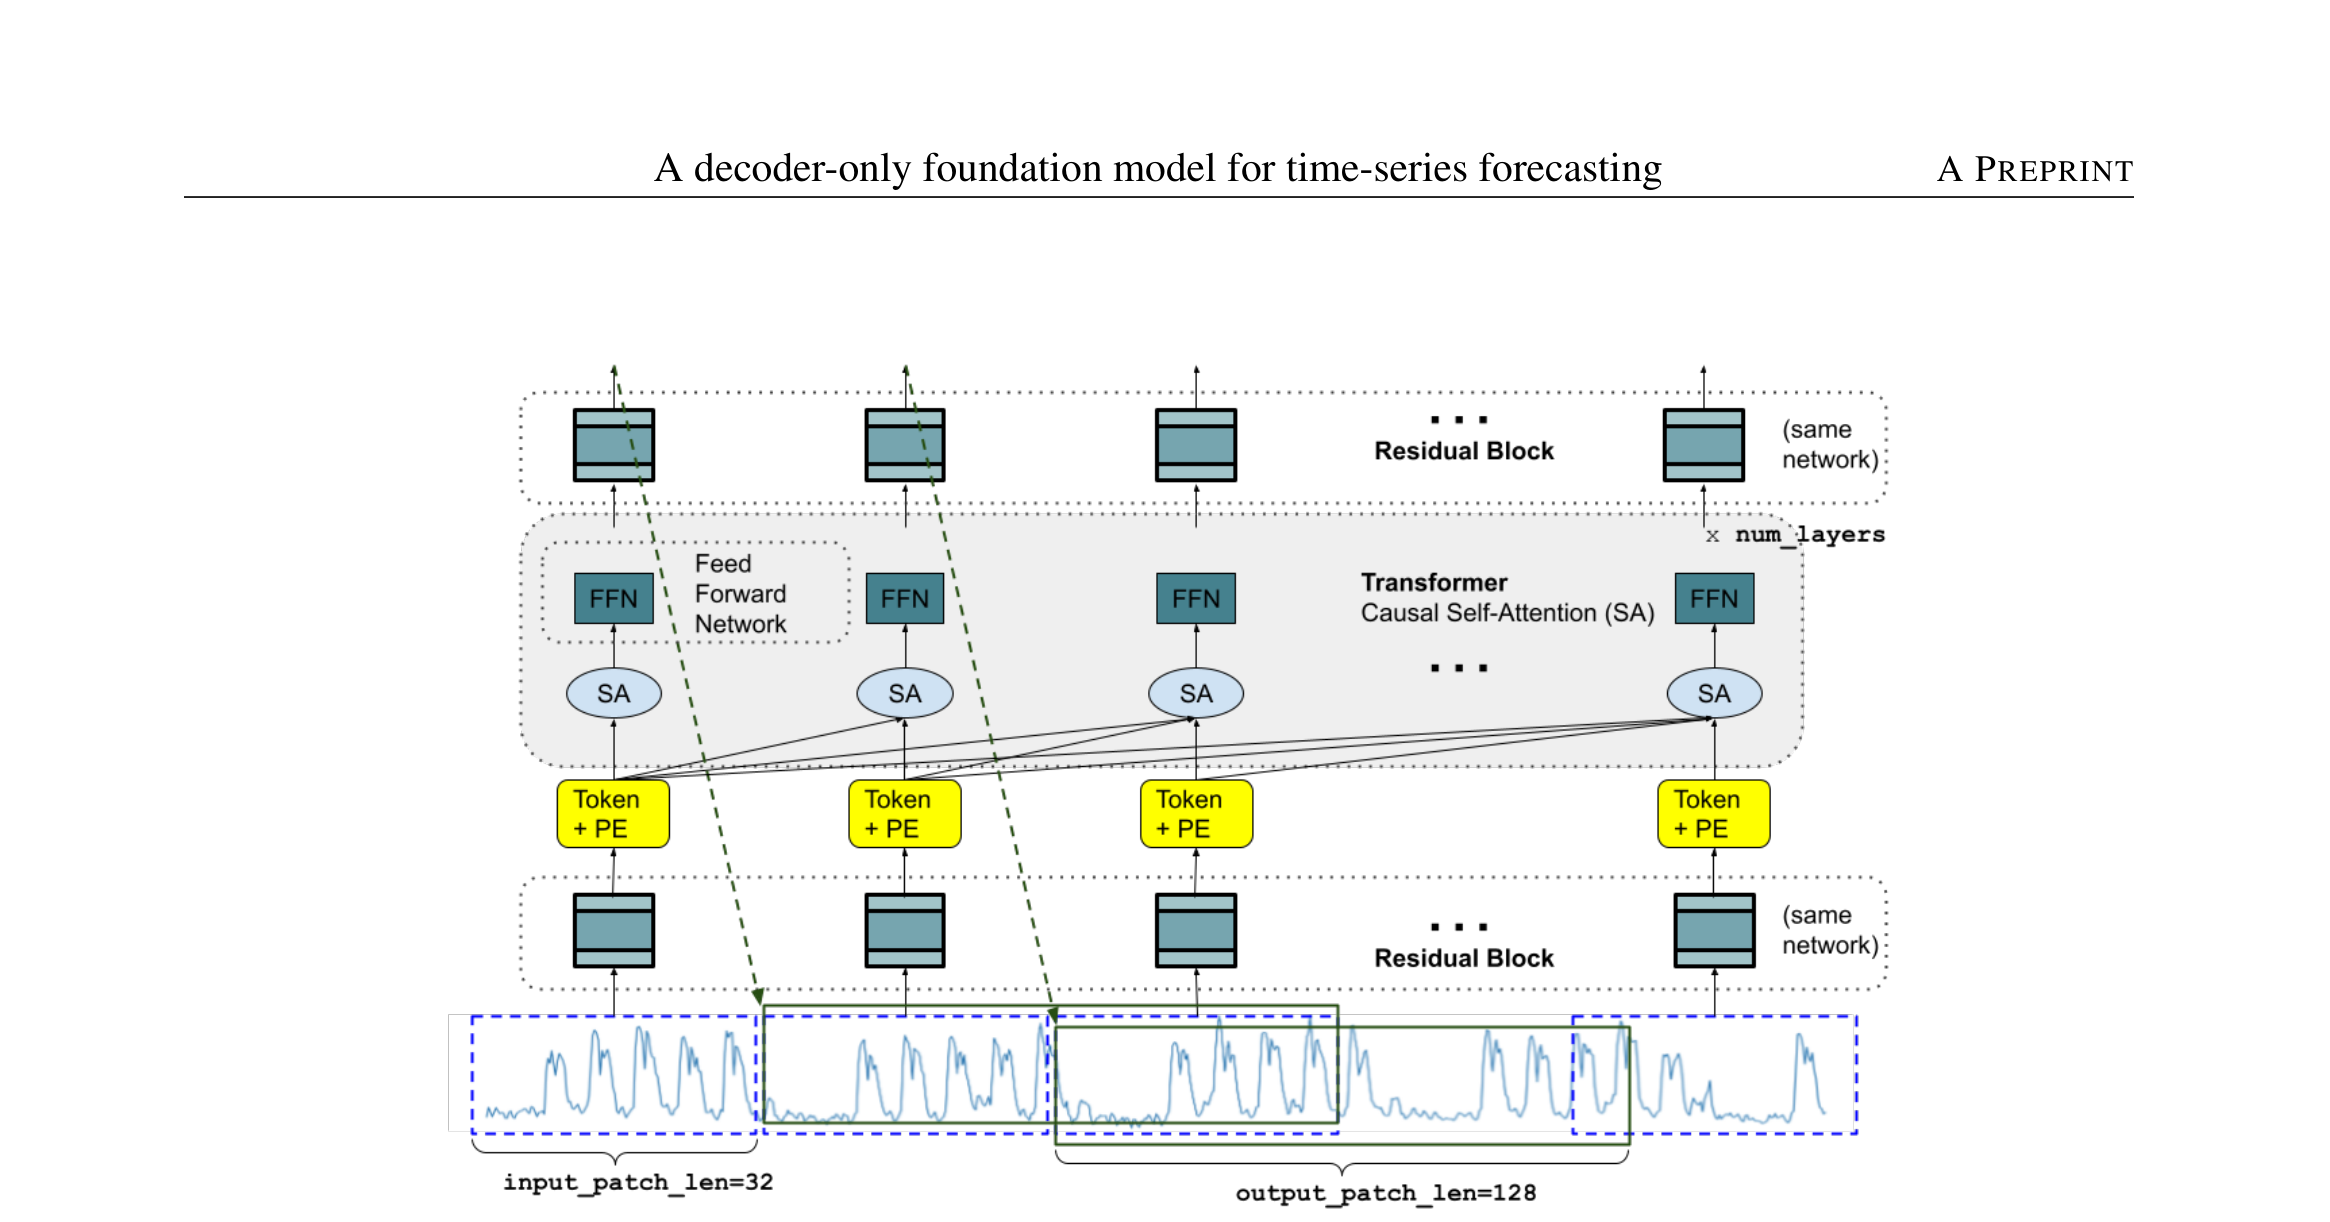
그림 1. TimesFM의 학습 구조. 출처: Das et al. (2024), Figure 1, arXiv:2310.10688v4, CC BY 4.0. 블로그용으로 축소·재배치.
TimesFM의 데이터 흐름은 다음과 같다.
첫 입력 패치의 평균·표준편차로 정규화
→ 길이 p의 비중첩 입력 패치
→ input residual block + positional encoding
→ causal decoder-only Transformer
→ output residual block
→ 각 위치 다음의 길이 h 예측 패치
→ 필요한 지평까지 예측 패치를 이어 생성
입력과 출력에 residual MLP를 두고 그 사이에 표준 causal Transformer를 놓는다. 언어 모델의 token을 연속값 패치로, next-token prediction을 next-patch forecasting으로 바꾼 구조다.
3.2 입력 패치와 causal next-patch learning
입력 패치 길이를 p라 두고 시계열을 겹치지 않는 조각 \widetilde{y}j=y{p(j-1)+1:pj}로 나눈다. padding mask도 같은 방식으로 패치화한다. 각 패치는 hidden layer 하나와 skip connection을 가진 input residual block을 거쳐 model dimension으로 올라가고 positional encoding이 더해진다.
t_j=\operatorname{InputResidualBlock}\big(\widetilde{y}_j\odot(1-\widetilde{m}_j)\big)+PE_j200M 모델의 p는 32다. 문맥이 512라면 Transformer가 처리하는 token은 512개 시점이 아니라 16개 패치가 된다. 패치가 길수록 attention sequence는 짧아지지만, 지나치게 길면 하나의 token 안에 너무 많은 문맥이 접혀 decoder-only next-patch 학습의 장점이 약해진다.
Transformer의 j번째 출력 o_j는 causal attention 때문에 현재와 과거 입력 패치만 볼 수 있다. output residual block은 o_j에서 현재 입력 패치 바로 다음의 h개 시점을 예측한다.
\widehat{y}_{pj+1:pj+h}=\operatorname{OutputResidualBlock}(o_j)한 mini-batch 안에서는 모든 patch position이 동시에 학습 신호를 낸다. 첫 패치를 본 출력은 그 다음 h개를, 두 패치를 본 출력은 다시 그 다음 h개를 맞힌다. 손실은 각 위치의 future window MSE 평균이다.
\mathcal{L}_{train}=\frac{1}{N}\sum_{j=1}^{N}\operatorname{MSE}\left(\widehat{y}_{pj+1:pj+h},y_{pj+1:pj+h}\right)decoder-only라는 이름은 별도 encoder가 없다는 뜻에 그치지 않는다. 서로 다른 수의 과거 패치를 본 각 위치가 다음 구간을 예측하도록 학습되므로, 문맥 길이가 바뀌어도 같은 causal objective를 재사용할 수 있다는 점이 핵심이다.
3.3 긴 출력 패치와 가변 문맥
200M 모델은 입력 패치 p=32, 출력 패치 h=128을 쓴다. 입력 256시점에서 미래 256시점을 예측한다고 하자. TimesFM은 먼저 257–384를 생성하고, 이를 원문맥 뒤에 붙여 385–512를 생성한다. 두 번이면 끝난다. 출력 패치도 32라면 같은 지평에 여덟 번의 자기회귀가 필요하다.
따라서 TimesFM은 horizon 전체를 항상 한 번에 내는 direct forecaster가 아니다. 더 긴 출력 패치로 자기회귀 횟수를 줄인 절충안이다. h가 너무 짧으면 반복 생성 비용과 오차 누적이 커지고, 너무 길면 월간·연간처럼 짧은 series에서 충분한 target window를 만들기 어렵다.
비중첩 패치만 사용하면 모델이 32·64·96처럼 p의 배수인 문맥만 보게 된다. TimesFM은 각 시계열에서 r\in{0,\ldots,p-1}를 무작위로 뽑아 첫 패치 앞쪽 r개 시점을 masking한다. p=32에서 r=4라면 첫 출력은 28개 시점을 본 상태로, 다음 출력은 60개, 그다음은 92개를 본 상태로 예측한다. 여러 r을 반복하면 1부터 최대 training context까지 모든 길이가 학습에 나타난다.
이는 임의 길이 일반화가 패치 Transformer에서 저절로 생긴다는 뜻이 아님을 보여 준다. 다양한 문맥 길이를 명시적으로 구성하는 masking strategy가 그 능력을 학습시킨다. 추론 시 입력 길이가 p의 배수가 아니면 뒤에 0을 붙이고 해당 위치를 mask한다.
3.4 정규화와 입력 범위
TimesFM은 RevIN 전체가 아니라 standard normalization 부분만 사용한다. 각 문맥을 첫 입력 패치의 평균과 표준편차로 scaling한다. 서로 단위가 다른 series를 한 모델에 넣기 위한 장치지만, 짧거나 거의 상수인 첫 패치에서 표준편차가 매우 작을 때의 수치 처리 세부는 논문에 없다.
논문 모델은 univariate 입력을 대상으로 한다. multivariate dataset도 각 차원의 metric을 계산해 평균 또는 중앙값으로 모을 수 있지만, 본 논문은 mean version을 사용한다. 변수 사이의 동시 상호작용을 모델링한 multivariate foundation model로 읽으면 안 된다.
3.5 17M·70M·200M 모델 구성
세 모델 모두 입력 패치 32, 출력 패치 128, attention head 16, dropout 0.2를 공유한다. 차이는 깊이와 model dimension이다.
| 크기 | Transformer 층 | Model dimension |
|---|---|---|
| 200M | 20 | 1280 |
| 70M | 10 | 1024 |
| 17M | 10 | 512 |
200M 모델은 peak learning rate 5\times10^{-4}의 cosine decay를 사용한다.
4. 사전학습 코퍼스와 데이터 혼합
4.1 381.4B 시점으로 구성된 원시 코퍼스
Table 1의 값을 합산하면 다음과 같다.
| 구분 | 시점 수 | 비중 |
|---|---|---|
| Wiki Pageviews 4종 | 374,458,301,591 | 98.2% |
| 합성 데이터 | 6,144,000,000 | 1.6% |
| Google Trends 4종 | 536,372,243 | 0.1% |
| 나머지 전부(Electricity·Traffic·Weather·Favorita·LibCity·M4) | 222,968,225 | 0.1% |
| 합계 | 381,361,642,059 | 100% |
Wiki hourly와 Wiki daily 둘만 92.9%다. 합성 데이터는 3M 계열 × 2,048 시점으로 Table 1의 6,144,000,000과 일치한다.
4.2 원시 비중과 실제 학습 노출
원시 코퍼스에서 Wiki pageviews가 차지하는 비중과 실제 학습 노출 비중은 동일하지 않다. loader는 real data 80%, synthetic data 20%를 표집하고, real data 안에서는 hourly+sub-hourly·daily·weekly·monthly 네 그룹에 같은 가중을 준다. 따라서 코퍼스 크기가 그대로 배치 노출 비율이 되지는 않는다.
논문이 명시하는 것은 그룹 사이의 균등 가중까지다. 그룹 안에서 데이터셋을 어떻게 표집하는지는 설명하지 않는다. hourly 그룹만 떼어 보면 원시 코퍼스 크기 기준 Wiki hourly가 239.1B이고, 나머지 시간 단위 데이터 전체는 약 453.4M이다. 이 기준에서는 hourly 그룹의 99.8%가 Wiki지만, 실제 노출 비중은 내부 sampler가 공개되지 않아 계산할 수 없다.
합성 데이터는 원시 코퍼스의 1.6%지만 batch의 20%를 받으므로 크기 비례 표집보다 12배 넘게 상향 가중된다. 논문은 이 20%를 택한 validation이나 sensitivity 결과를 제시하지 않는다. 원시 데이터 규모만 보고 TimesFM이 98% Wiki로 학습됐다고 단정해서도 안 되고, 반대로 그룹 균등 가중만으로 Wiki의 실제 노출이 작다고 결론 내릴 수도 없다.
4.3 합성 데이터가 담는 패턴
3백만 개의 합성 series는 길이 2,048이며 네 구성요소를 무작위로 켜고 끈 뒤 가중합해 만든다.
| 구성요소 | 생성 범위 |
|---|---|
| Piecewise linear trend | 구간 수를 2–8개에서 무작위 선택 |
ARMA(p,q) |
1\le p,q\le8, 계수 생성 후 정규화 |
| Seasonality | 주기 4부터 최대 문맥 길이의 절반 사이인 sine·cosine |
| Step function | 불연속적인 수준 변화 |
trend가 선택된 경우 절반은 additive가 아니라 multiplicative하게 적용된다. 합성 데이터 제거 절제는 이 묶음 전체의 효과를 보여 줄 뿐, ARMA·trend·seasonality 가운데 무엇이 성능을 만들었는지는 분리하지 않는다.
4.4 시간 입도별 문맥과 학습 계산량
가능한 시계열에는 최대 context 512를 쓰지만 weekly는 256, monthly 이상은 64로 제한한다. 서로 다른 입도를 같은 모델에 넣더라도 실제로 노출되는 최대 문맥 길이는 같지 않다. 따라서 “문맥 512로 사전학습했다”는 요약은 월간·분기·연간 시계열에는 맞지 않는다.
17M·70M·200M 모델은 같은 corpus에서 global batch 4,096, 1.5M iteration으로 학습된다. 논문은 TPUv5e 16 tensor core에서 최종 200M run에 2일이 걸렸다고 보고한다. 모델 선택과 trial은 그보다 더 많은 계산을 썼지만 전체 탐색 비용은 정량화하지 않는다.
5. 설계 선택과 절제
Figure 3은 모델 크기, 입력·출력 패치 길이, 합성 데이터의 네 축을 비교한다.
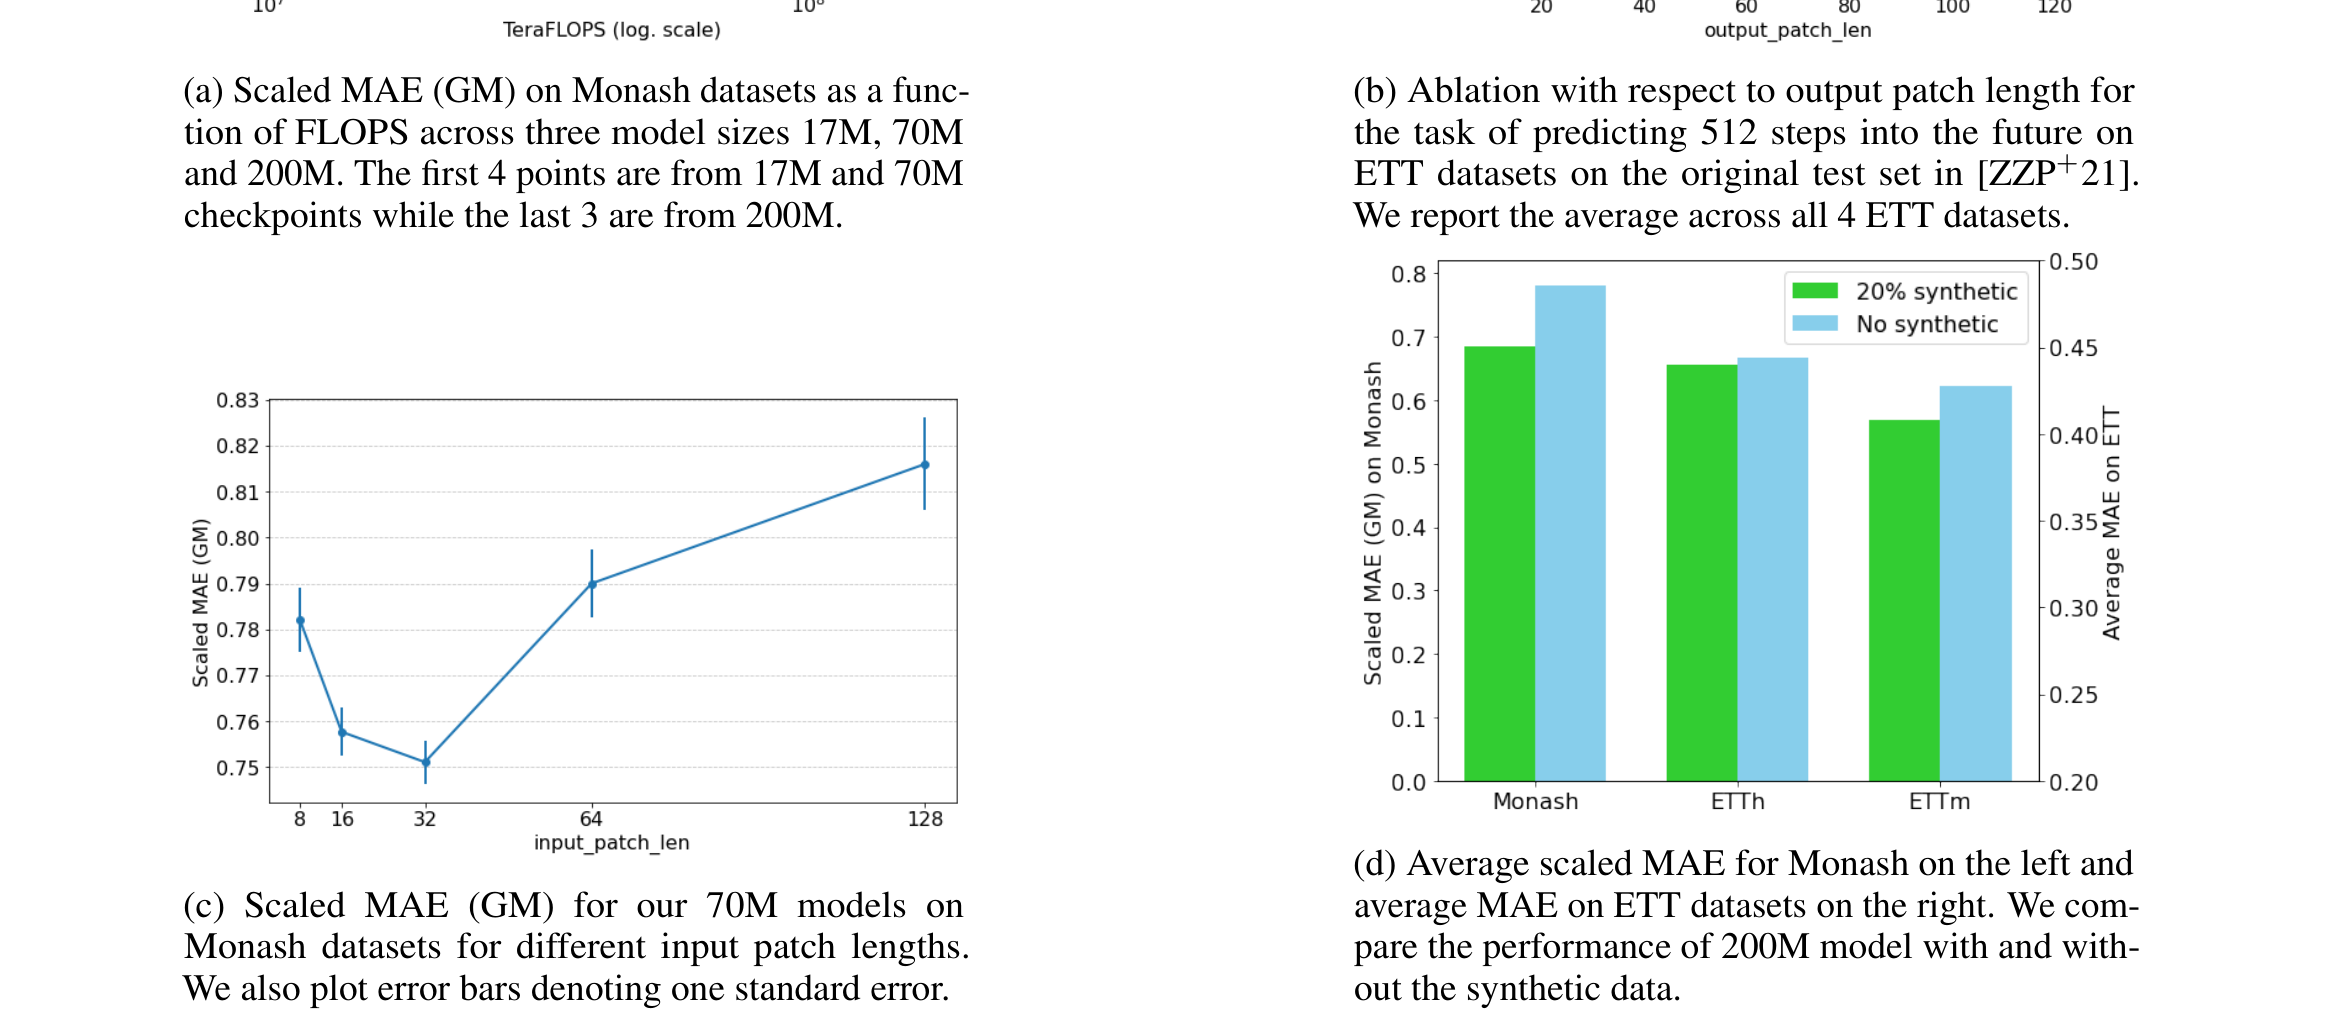
그림 3. 모델 크기·FLOPs, 출력 패치 길이, 입력 패치 길이, 합성 데이터 포함 여부에 대한 절제. 출처: Das et al. (2024), Figure 3, arXiv:2310.10688v4, CC BY 4.0. 원문 PDF의 전체 도판을 블로그용으로 캡처·축소.
| 설계 축 | 비교 | 저자 보고 관찰 | 해석 범위 |
|---|---|---|---|
| 모델 크기·FLOPs | 17M·70M·200M checkpoint | Monash scaled MAE가 FLOPs 증가에 따라 감소 | 세 크기의 preliminary scaling study |
| 출력 패치 | 8→128 | ETT 512-step 평균 MAE가 단조 감소 | ETT 네 데이터셋의 특정 장기 지평 |
| 입력 패치 | 8→128 | 16·32가 가장 낮고 32 이후 악화 | 70M·Monash 설정 |
| 합성 데이터 | 20% 포함 vs 제거 | Monash·ETTm에서 포함 모델이 우세, ETTh 차이는 작음 | 합성 데이터 혼합 전체의 효과 |
Figure 3a의 일곱 checkpoint는 17M·70M·200M에서 나온다. FLOPs가 늘수록 Monash 기하평균 scaled MAE가 감소하지만, 세 모델 크기의 preliminary study이므로 compute-optimal scaling law를 확정하지는 않는다. Figure 3b에서는 ETT 네 데이터셋의 original rolling-validation task에서 512시점을 예측하며 출력 패치를 8에서 128까지 늘릴수록 평균 MAE가 낮아진다. 논문은 정확한 점 값을 표로 제공하지 않아 개선 방향만 확인할 수 있다.
70M 모델의 입력 패치는 16과 32에서 오차가 가장 낮고 이후 악화한다. 저자 보고로 p=32는 p=16보다 학습이 거의 두 배 빠르며, p=8은 약 세 배 느리다. 합성 데이터가 없으면 Monash와 15분 입도 ETTm은 악화하지만 hourly ETTh 차이는 작다. 이 결과는 덜 대표된 입도를 보완한다는 해석과 일관되지만, 합성 비중 20%의 최적성이나 generator별 기여는 분리하지 않는다.
5.1 동조건 PatchTST(ZS)가 묻는 것
Appendix A.4는 200M PatchTST를 같은 데이터 로더와 FLOPs, 같은 Transformer stack 설정으로 사전학습한다. 입력 패치는 32, stride는 16이다. Monash에서는 TimesFM보다 약하지만 ETT에서는 TimesFM과 supervised PatchTST에 가까운 결과를 보인다. 저자들은 Monash 차이를 decoder-only 목적함수 하나로 분리하지 않는다. 512 중심의 사전학습 문맥과, 같은 FLOPs에서 PatchTST(ZS)가 더 적은 optimizer iteration을 수행한 조건도 함께 작용했을 수 있다.
6. 평가 설계와 비교 조건
6.1 Monash·Darts·ETT는 같은 평가가 아니다
| 그룹 | 평가 구성 | 해석 경계 |
|---|---|---|
| Monash | 결측 dataset을 제외한 18개 | supervised·통계 기준선과 GPT-3 llmtime 비교 |
| Darts | 8개 단일 univariate 시계열 | 표본이 적어 standard error가 큼 |
| ETT | ETTh1·2, ETTm1·2 × horizon 96·192 | context 512, 마지막 test window만 평가 |
ETT는 long-horizon baseline의 rolling evaluation 전체가 아니라 마지막 test window만 사용한다. 논문은 llmtime 평가 비용 때문에 이 protocol을 택했다고 설명한다. 따라서 세 그룹의 막대를 하나의 동질적인 benchmark suite처럼 합쳐 읽어서는 안 된다.
6.2 naive-scaled MAE와 두 집계
데이터셋마다 값의 단위가 다르므로 Monash·Darts에서는 각 모델의 MAE를 마지막 관측값 y_L을 반복하는 naive baseline의 MAE로 나눈다.
\operatorname{ScaledMAE}_{d,m}=\frac{\operatorname{MAE}_{d,m}}{\operatorname{MAE}_{d,naive}}1보다 작으면 해당 데이터셋에서 naive보다 낫고, 1보다 크면 나쁘다. 여러 데이터셋을 합칠 때 본문 Figure 2는 기하평균, 부록 Figure 4는 산술평균을 보고한다. 논문은 정규화 지표에는 기하평균이 더 견고하다는 Fleming과 Wallace(1986)를 선택 근거로 든다. 두 집계는 큰 outlier에 반응하는 정도가 달라 Monash 순위도 바꾼다.
6.3 기준선 조달과 inference-time context selection
기준선의 출처는 그룹마다 다르다. Monash 기준선은 원 논문의 보충자료에서, Darts 기준선은 llmtime 저자가 제공한 사전 계산 출력에서 가져왔다. llmtime도 Monash·Darts에서는 GPT-3 출력이지만, ETT에서는 GPT-3 접근 종료로 GPT-3.5-Turbo를 사용했다. 같은 이름의 기준선이 모든 그룹에서 같은 모델을 뜻하지는 않는다.
일부 Monash 데이터셋에서는 훈련 구간으로 만든 검증 지표를 이용해 추론 문맥 길이를 32·64·최대 길이 중에서 골랐다. 가중치를 미세조정하지 않았다는 의미의 zero-shot은 유지되지만, 완전히 무조정인 평가는 아니다. 부록 목록의 중복 때문에 이 선택을 적용한 데이터셋 수는 명확하지 않다.
7. 결과와 절제
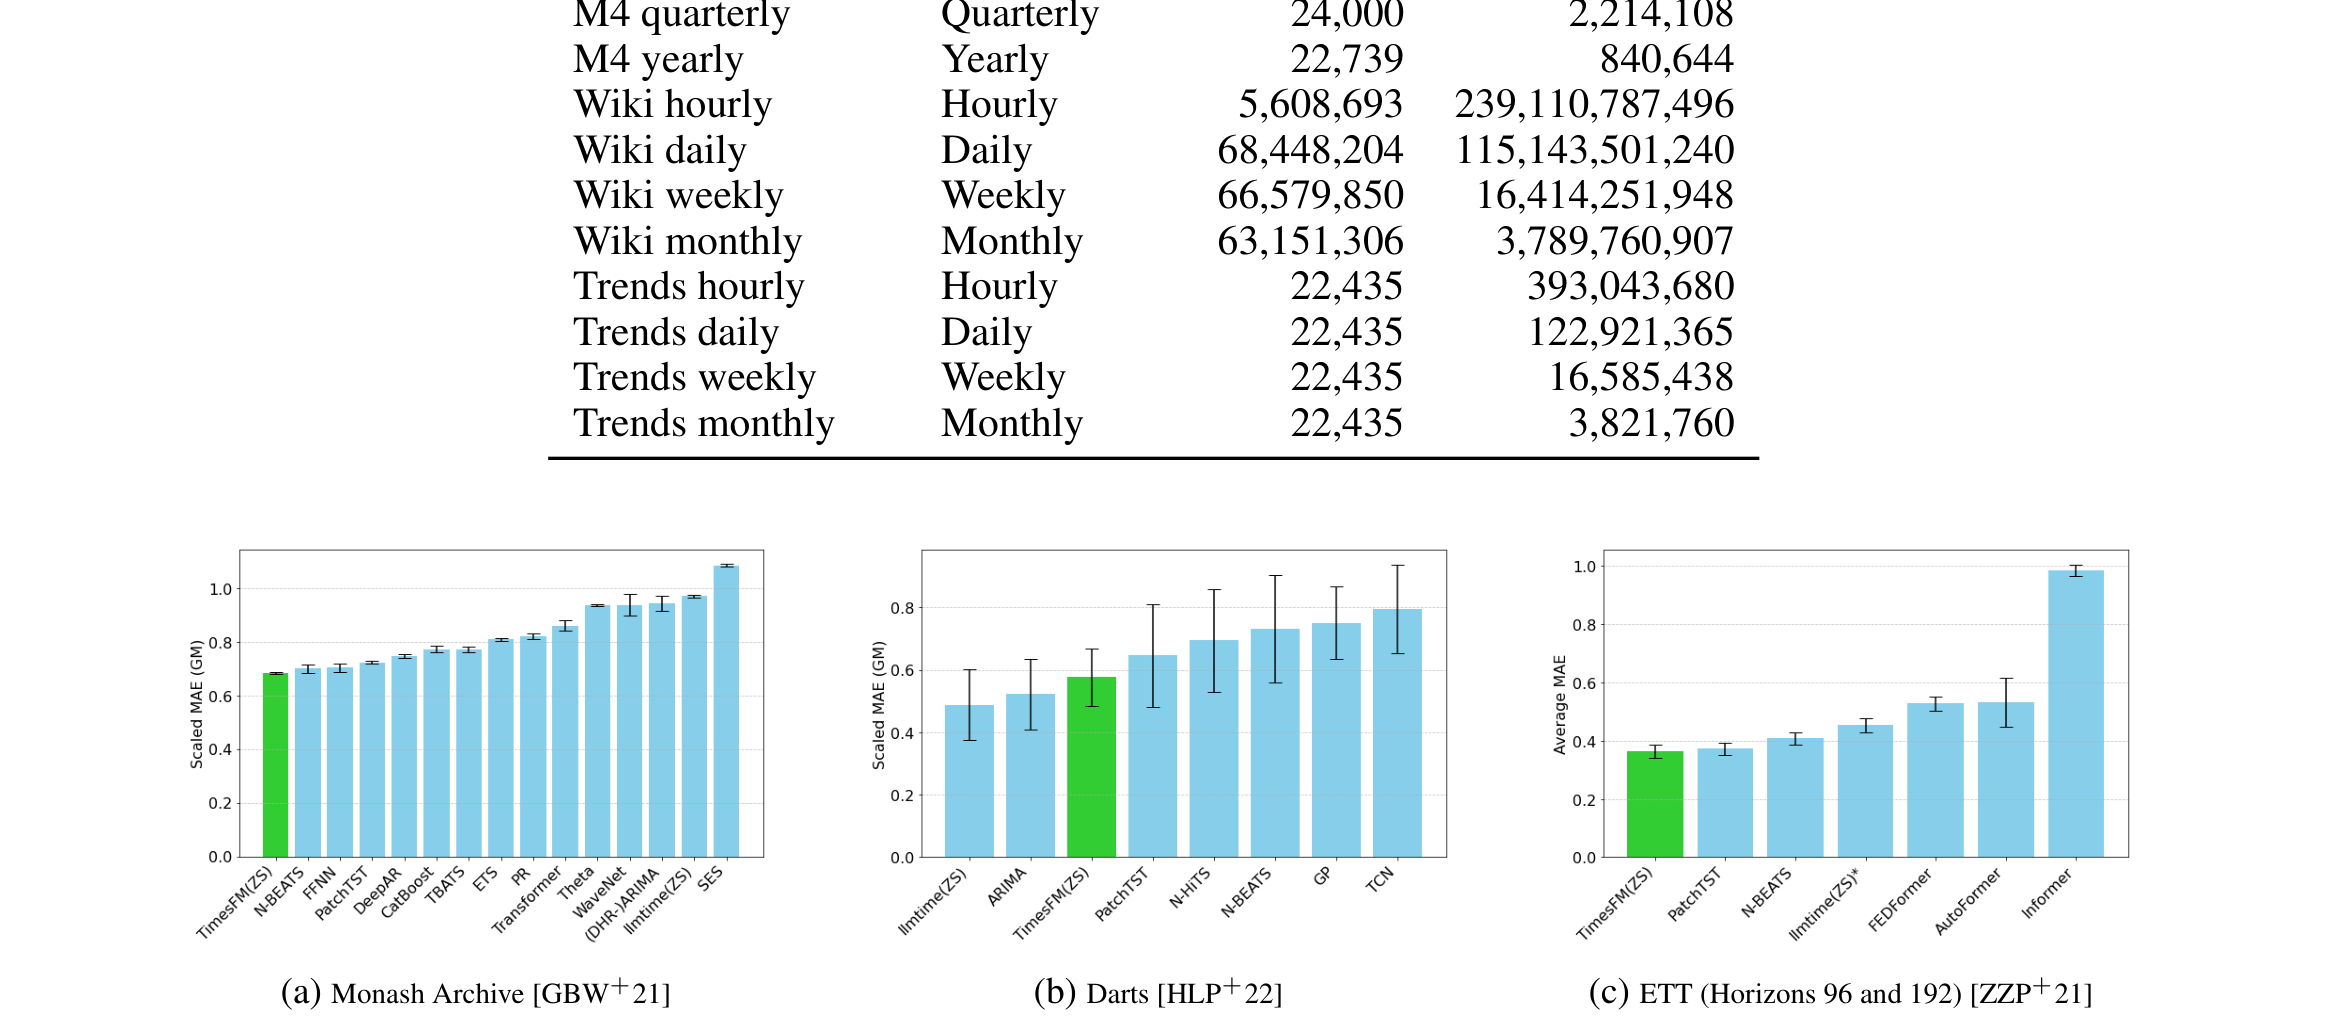
그림 2. Monash·Darts·ETT 세 그룹의 평균 성능. 낮을수록 좋다. 출처: Das et al. (2024), Figure 2, arXiv:2310.10688v4, CC BY 4.0. 원문 도판만 블로그용으로 캡처·축소.
7.1 집계 방식에 따라 달라지는 순위
Table 3·4의 산술평균과 본문 Figure 2의 기하평균을 나란히 놓으면 다음과 같다.
| 그룹 | 집계 | 1위 | TimesFM |
|---|---|---|---|
| Monash | 산술평균 | N-BEATS .7844 | .8005, 2위 |
| Monash | 기하평균 | TimesFM .6846 | .6846, 1위 |
| Darts | 산술평균 | ARIMA .6045 | .6829, 3위 |
| Darts | 기하평균 | llmtime .4882 | .5767, 3위 |
Monash에서는 1위가 집계 방식에 따라 달라지고, 본문에 실린 기하평균에서 TimesFM이 앞선다. Darts에서는 두 집계 모두 3위로 llmtime과 ARIMA보다 뒤에 있다.
논문은 기하평균 선택 근거를 밝히고 산술평균도 부록에 싣는다. Figure 4 캡션은 TimesFM이 Monash의 N-BEATS, Darts의 ARIMA와 유의한 차이가 없다고 설명하며, Darts의 표본 수가 작아 신뢰구간이 넓다는 점도 적는다. 다른 집계를 숨긴 것은 아니지만, 초록과 본문 도판의 대표 결과가 TimesFM에 유리한 기하평균에 기반한다는 점은 함께 봐야 한다.
7.2 데이터셋별 편차와 naive 기준선
Table 3·4의 26개 Monash·Darts 데이터셋을 비교하면 TimesFM이 naive보다 오차가 큰 경우는 다섯 개다.
| 그룹 | 데이터셋 | TimesFM | NAIVE | 차이 |
|---|---|---|---|---|
| Monash | cif 2016 | 773,980.44 | 386,526.37 | +100.2% |
| Monash | bitcoin | 1.3e18 | 7.77e17 | +67.3% |
| Monash | saugeenday | 24.63 | 21.50 | +14.6% |
| Monash | tourism yearly | 109,977.29 | 99,456.05 | +10.6% |
| Darts | GasRateCO2 | 2.50 | 2.29 | +9.2% |
cif 2016에서는 TimesFM의 오차가 naive의 약 두 배다. 집계 수준에서 경쟁력이 있더라도 모든 데이터셋에서 단순 기준선을 안정적으로 이긴다는 뜻은 아니다. 논문은 naive 값을 표에 싣지만 이 다섯 사례를 본문에서 별도로 논하지 않는다.
덧붙여 cif 2016은 앞서 본 문맥 길이 추론 시 조정을 받은 여섯 데이터셋 중 하나다(문맥 32로 설정). 조정을 거치고도 naive의 두 배다.
개별 데이터셋의 편차도 크다. Darts AirPassengers에서 TimesFM 62.51 대 ARIMA 24.03으로 2.6배 차이가 나고, Monash tourism yearly에서 109,977 대 N-BEATS 70,952로 1.55배다. 반대로 fred md에서는 947.12로 차순위 TBATS 1,989.97의 절반 이하이고, pedestrian counts에서도 1위다. 초록의 "comes close to"는 집계 수준의 진술이고, 개별 데이터셋의 이 편차는 드러나지 않는다.
7.3 본문 도판과 부록 표의 비교군
본문 도판과 부록의 세부 표는 비교 방법이 완전히 일치하지 않는다.
- Monash Figure 2a에는
PatchTST막대가 있지만 Table 4에는PatchTST(ZS)가 있으며 값도 대응하지 않는다. - ETT Figure 2c에는 N-BEATS가 있지만 Table 5에는 없고, 반대로 Table 5의 PatchTST(ZS)는 본문 도판에 없다.
- Darts는 본문과 부록의 여덟 방법이 일대일로 대응한다.
PatchTST(ZS)는 같은 loader와 FLOPs로 학습한 구조 절제다. Table 5의 표시값을 평균하면 PatchTST(ZS) 0.349, TimesFM 0.364, supervised PatchTST 0.373이다. 세 값이 가깝다는 저자 해석은 가능하지만, 동조건 절제가 TimesFM보다 0.015 낮으므로 TimesFM이 ETT에서 단독 최선이라고 읽을 수는 없다. 본문 막대와 부록 열의 method mapping이 완전하지 않아 대표 도판만으로 구조 우위를 판단하기도 어렵다.
7.4 10% fine-tuning은 별도의 결과다
Appendix A.3은 ETT training data 10%로 TimesFM의 input·output residual block만 미세조정하고, 같은 10% 조건의 GPT4TS와 scratch baseline을 비교한다. 다음은 네 데이터셋의 horizon 평균 MAE다.
| 데이터셋 | TimesFM(FT) | GPT4TS(FT) | PatchTST |
|---|---|---|---|
| ETTh1 | .426 | .525 | .542 |
| ETTh2 | .410 | .421 | .431 |
| ETTm1 | .388 | .441 | .466 |
| ETTm2 | .334 | .335 | .343 |
TimesFM(FT)가 네 평균에서 가장 낮다. 이 결과는 pretrained representation을 소량 데이터에 적응시킬 수 있음을 보여 주지만 zero-shot headline과는 분리해야 한다. 또한 전체 Transformer가 아니라 입출력 block을 조정한 조건이며, covariate를 포함한 fine-tuning은 평가하지 않는다.
8. 결과가 뒷받침하는 범위
8.1 논문이 밝힌 한계
- TimesFM은 point forecasting만 다루며 probabilistic forecasting은 후속 과제로 남긴다.
- 사전학습에서 외생 공변량을 쓰지 않고, fine-tuning과 공변량 활용도 충분히 탐색하지 않았다.
- hyperparameter 탐색이 제한적이고 모델의 예측 근거를 해석하는 방법도 제시하지 않는다.
- Informer 계열에서는 사전학습과 겹치는 데이터셋을 제외하고 ETT 네 종만 평가한다.
- Darts는 시계열이 8개뿐이라 신뢰구간이 넓고 순서를 확정하기 어렵다.
- Darts 데이터셋이 공개 블로그에 자주 쓰여 llmtime의 데이터 오염 가능성을 배제할 수 없다고 적는다.
8.2 zero-shot 평가와 데이터 중첩의 경계
여기서부터는 공개된 설정에서 도출한 해설자의 해석이다. Table 4의 weather·traffic hourly·traffic weekly·australian electricity demand는 Table 1의 Weather·Traffic Hourly·Electricity Hourly와 이름이 겹친다. 그러나 출처 판본과 split hash가 없어 동일 데이터인지는 논문만으로 판정할 수 없다. 이는 누수를 입증하는 근거가 아니라, held-out 선언을 독립적으로 검증할 식별 정보가 부족하다는 뜻이다.
문맥 길이 선택도 같은 경계를 만든다. 모델 가중치를 다시 학습하지 않았으므로 zero-shot이라는 표현은 유지되지만, 평가 데이터셋마다 문맥 길이를 검증 지표로 고른 이상 완전한 무조정 적용과는 다르다. 이 조건은 본문이 아니라 부록에 있다.
8.3 표집과 재현성의 경계
그룹 내부 sampler가 공개되지 않아 실제 Wiki 노출 비중과 도메인 편중을 계산할 수 없다. synthetic 20% 제거 절제는 혼합 전체의 필요성을 보여 주지만, 20%가 최적인지와 각 generator의 기여는 분리하지 않는다. 사전학습 데이터와 평가 데이터의 판본·split identifier도 없어 held-out 선언을 외부에서 그대로 재구성하기 어렵다.
9. 결론
TimesFM의 핵심 기여는 시계열 예측의 기본 단위를 데이터셋별 전용 모델에서 대규모 사전학습 모델로 옮긴 데 있다. 시계열을 패치로 바꾸고 길이 32의 입력에서 길이 128의 출력을 한 번에 생성하는 decoder-only 설계는 200M 모델 하나로 여러 도메인과 예측 지평을 다루는 구체적인 방법을 제시한다.
실험이 가장 분명하게 뒷받침하는 결론은 TimesFM이 여러 벤치마크에서 경쟁력 있는 zero-shot 기준선이라는 점이다. 이를 모든 데이터셋에서 지도학습 모델을 대체한다는 주장으로 넓히기는 어렵다. Monash 순위는 집계 방식에 따라 바뀌고 Darts에서는 두 집계 모두 3위이며, Monash·Darts 26개 데이터셋 중 5개에서는 naive 기준선보다 오차가 크다. Figure 2c의 비교군에서는 TimesFM과 지도학습 PatchTST가 선두권이지만, 부록의 동조건 PatchTST(ZS) 평균은 TimesFM보다 낮다.
따라서 이 논문의 가치는 보편적 우위를 확정한 데 있기보다, 하나의 사전학습 모델이 서로 다른 시계열로 전이될 수 있다는 연구 방향을 실험 가능한 형태로 만든 데 있다. 그룹 내부 표집 방식, inference-time context selection, 평가 데이터 중첩, 본문과 부록의 비교 방법 대응을 더 명확히 통제한 후속 평가가 TimesFM의 일반화 범위를 결정할 것이다.
References
Das, A., Kong, W., Sen, R., & Zhou, Y. (2024). A decoder-only foundation model for time-series forecasting. In Proceedings of the 41st International Conference on Machine Learning (PMLR 235, pp. 10148–10167). https://proceedings.mlr.press/v235/das24c.html
Fleming, P. J., & Wallace, J. J. (1986). How not to lie with statistics: The correct way to summarize benchmark results. Communications of the ACM, 29(3), 218–221.
Godahewa, R., Bergmeir, C., Webb, G. I., Hyndman, R. J., & Montero-Manso, P. (2021). Monash time series forecasting archive (arXiv:2105.06643). arXiv. https://arxiv.org/abs/2105.06643
Gruver, N., Finzi, M., Qiu, S., & Wilson, A. G. (2023). Large language models are zero-shot time series forecasters (arXiv:2310.07820). arXiv. https://arxiv.org/abs/2310.07820
Herzen, J., Lässig, F., Piazzetta, S. G., Neuer, T., Tafti, L., Raille, G., Van Pottelbergh, T., Pasieka, M., Skrodzki, A., Huguenin, N., et al. (2022). Darts: User-friendly modern machine learning for time series. The Journal of Machine Learning Research, 23(1), 5442–5447.
Makridakis, S., Spiliotis, E., & Assimakopoulos, V. (2022). M5 accuracy competition: Results, findings, and conclusions. International Journal of Forecasting, 38(4), 1346–1364.
Nie, Y., Nguyen, N. H., Sinthong, P., & Kalagnanam, J. (2022). A time series is worth 64 words: Long-term forecasting with transformers. International Conference on Learning Representations.
Oreshkin, B. N., Carpov, D., Chapados, N., & Bengio, Y. (2019). N-BEATS: Neural basis expansion analysis for interpretable time series forecasting. International Conference on Learning Representations.
Salinas, D., Flunkert, V., Gasthaus, J., & Januschowski, T. (2020). DeepAR: Probabilistic forecasting with autoregressive recurrent networks. International Journal of Forecasting, 36(3), 1181–1191.
Wang, J., Jiang, J., Jiang, W., Han, C., & Zhao, W. X. (2023). Towards efficient and comprehensive urban spatial-temporal prediction: A unified library and performance benchmark (arXiv:2304.14343). arXiv. https://arxiv.org/abs/2304.14343
Zhou, H., Zhang, S., Peng, J., Zhang, S., Li, J., Xiong, H., & Zhang, W. (2021). Informer: Beyond efficient transformer for long sequence time-series forecasting. In Proceedings of the AAAI Conference on Artificial Intelligence.