Locating and Editing Factual Associations in GPT
GPT의 사실 연상을 찾아 한 사실을 고치기: ROME
ROME은 subject token을 손상·복원하는 causal tracing으로 중간층 MLP를 지목하고, 그 가중치에 rank-one 업데이트를 넣어 단일 사실을 편집한다. CounterFact의 높은 편집 점수는 정의된 반사실·단일 편집 조건의 결과다.
Paper: Kevin Meng; David Bau; Alex Andonian; Yonatan Belinkov (2022). "Locating and Editing Factual Associations in GPT." NeurIPS 2022. arXiv:2202.05262. PDF
1. 상관 대신 개입을 묻는다
‘The Space Needle is located in’ 뒤에 Seattle을 내는 GPT에서 어느 뉴런이 크게 켜졌다고 해서 그 뉴런이 답의 원인인 것은 아니다. ROME 논문은 내부 상태를 직접 바꾼 뒤 예측이 회복되는지 보는 causal tracing을 쓴다. 여기서 묻는 것은 ‘어느 계산 지점을 복원하면 손상된 사실 회상이 다시 살아나는가’다. ‘사실이 어디에만 저장됐나’는 질문과 다르다.
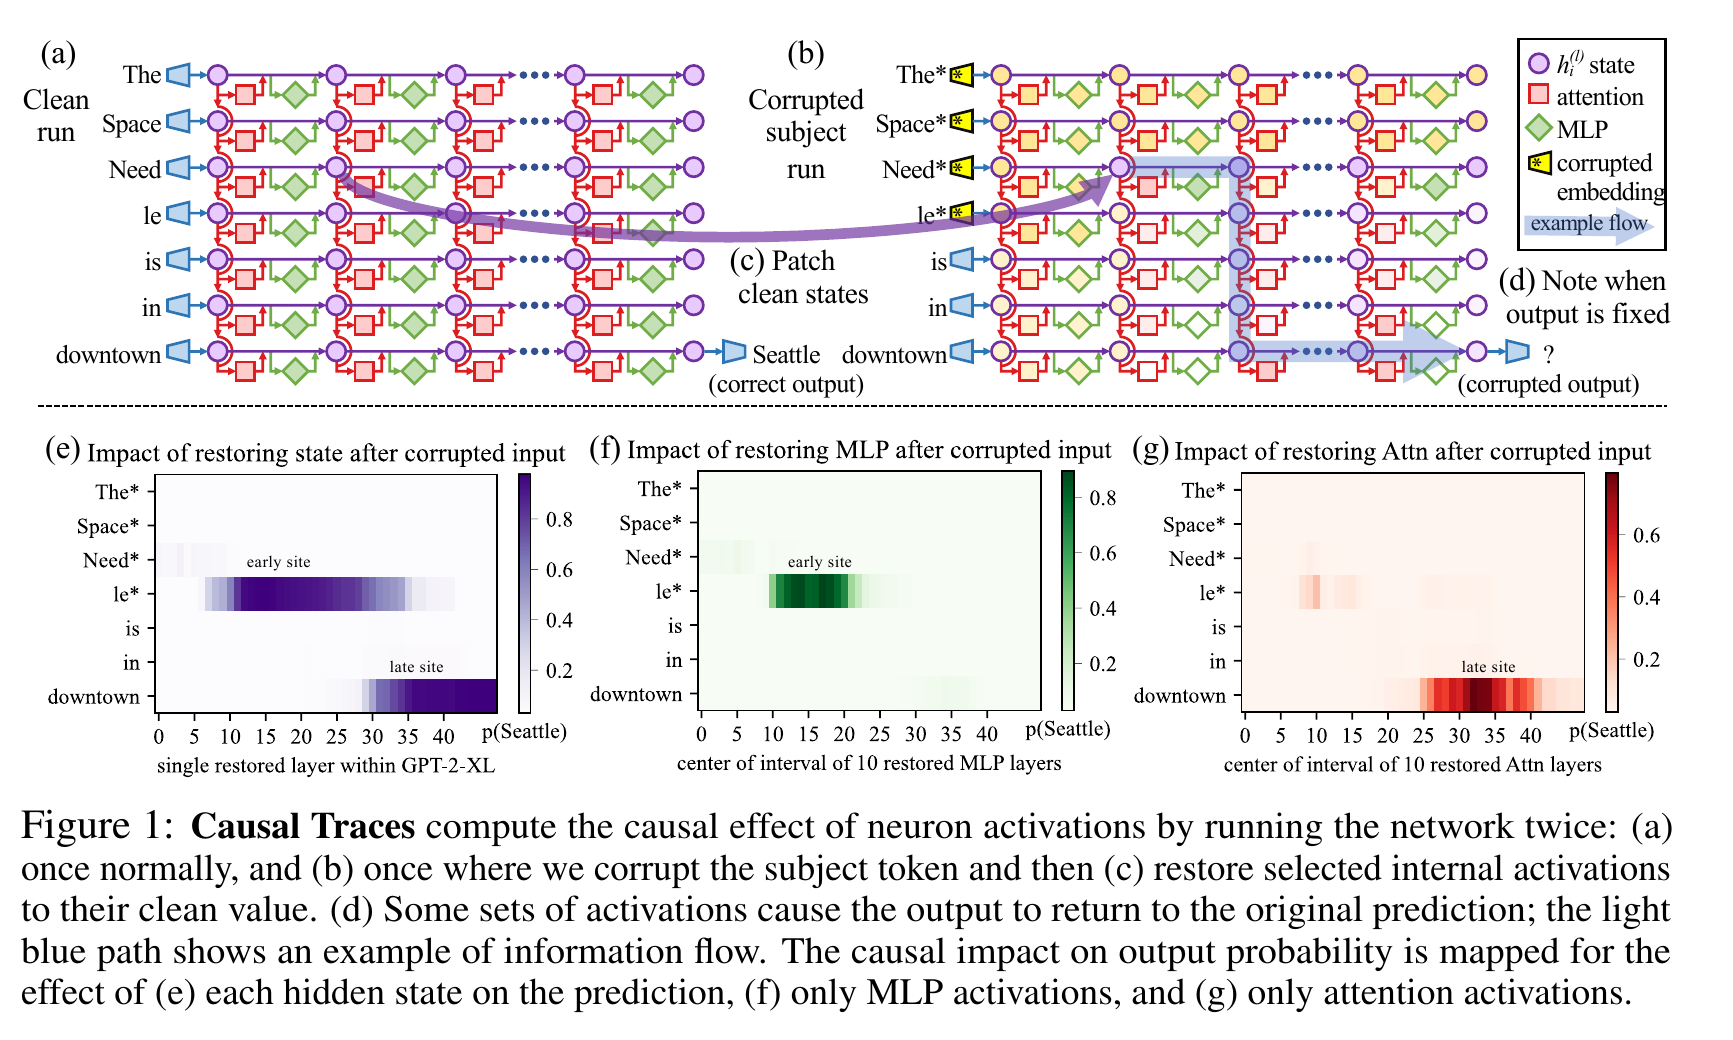
그림 1. Meng et al. (2022), NeurIPS PDF p. 2의 Figure 1을 인용했다. 정상 실행의 내부 상태를 저장하고, subject token embedding을 손상한 실행을 한 뒤, 특정 상태만 정상값으로 patch해 정답 확률 회복을 측정한다. 이 효과는 정의된 잡음 손상 개입에 대한 모델 내부 인과 효과다.
2. 발견: 중간층 MLP와 마지막 token의 역할
1,000개 사실 프롬프트에서 저자들은 마지막 subject token의 중간층에 early site, 마지막 token의 후반층에 late site를 찾는다. 개별 상태를 복원했을 때의 평균 간접 효과는 중간층에서 강했고, early site에서는 MLP 복원이 attention 복원보다 더 큰 회복을 보였다. late site에서는 반대로 attention의 역할이 크다.
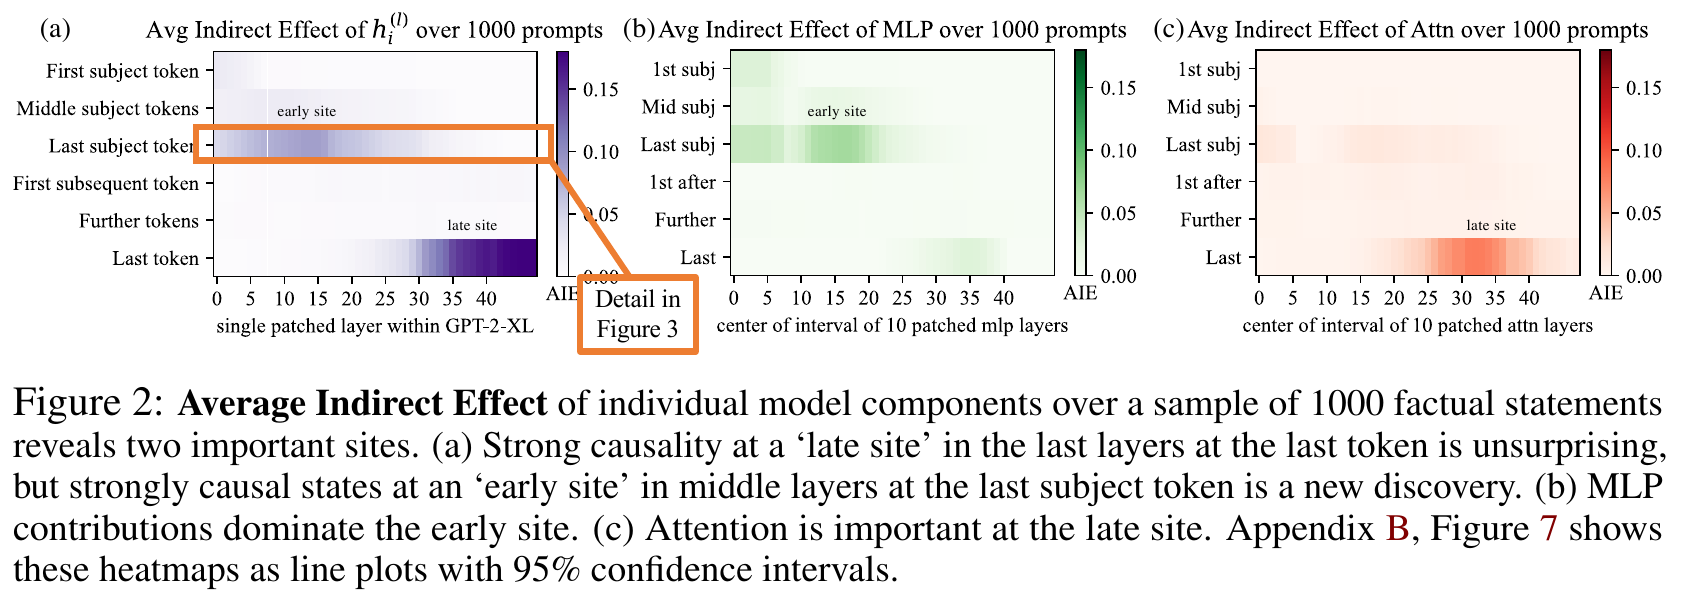
그림 2. Meng et al. (2022), NeurIPS PDF p. 3의 Figure 2를 인용했다. 왼쪽은 상태 복원 효과, 가운데는 MLP만 복원한 효과, 오른쪽은 attention만 복원한 효과를 subject·token 위치와 층별로 보인다. early site의 MLP 기여와 late site의 attention 기여는 ‘유일한 저장소’가 아니라 이 tracing 설정에서의 매개 경로를 뜻한다.
3. 편집: MLP를 연상기억처럼 갱신한다
ROME은 early site의 MLP down-projection을 key에서 value로 가는 선형 연상기억으로 본다. 새 subject–relation–object 사실을 넣을 때 전체 모델을 미세조정하지 않고, 한 key가 원하는 value로 가도록 rank-one 가중치 업데이트를 만든다. rank-one은 두 벡터의 외적으로 만든 행렬을 한 MLP 층의 가중치 행렬에 더한다는 뜻이다. 코드 한 줄이나 행렬의 한 행만 고치는 방식은 아니다. 기존 key들의 출력을 덜 바꾸도록 통계 보정을 넣고 여러 접두문에서 같은 새 object가 나오도록 목표 value를 찾는다.
예를 들어 ‘Eiffel Tower is located in Paris’를 다른 도시로 편집한다면, 한 프롬프트에서만 답을 바꾸는 것이 아니라 패러프레이즈에서도 새 답을 내고, Eiffel Tower의 다른 속성은 가능한 보존하는 것이 목표다. 평가에서는 편집 성공, 패러프레이즈 일반화, 무관 이웃 사실 보존을 나눠 본다.
4. 결과와 한계
CounterFact에서 GPT-2 XL ROME은 편집 성공 ES 100.0%, 바꿔 쓴 질문에서의 성공 PS 96.4%, 이웃 사실 보존 NS 75.4%를 보고했다. 종합 Score 89.2는 이 세 성공률의 조화평균이다. GPT-J의 Score는 91.5다. 평가 기록은 GPT-2 XL 7,500건, GPT-J 2,000건이며, 각 기록의 단일 사실 편집을 평가한 결과다. PS와 NS는 이 벤치마크가 정의한 성공률이므로 일반적인 언어 능력의 정확도로 읽으면 안 된다. fine-tuning 계열은 일반화를 높이면 specificity가 떨어지거나, 보존을 높이면 일반화가 떨어지는 절충을 보였다는 것이 비교의 핵심이다.
하지만 이 수치는 반사실 object를 한 번 주입하는 CounterFact와 단일 편집 조건의 결과다. 여러 사실을 순서대로 편집했을 때의 누적 간섭, 모델 갱신 뒤의 장기 안정성, 실제 진실성 검증은 이 논문의 범위 밖이다. subject embedding에 특정 크기의 잡음을 넣는 방식도 early site의 정확한 크기와 위치에 영향을 줄 수 있다.
5. 적용 조건
ROME은 모델이 이미 알고 있는 관계를 정밀하게 바꾸고 싶을 때의 연구 도구다. 실사용에는 편집 대상·원문 근거·패러프레이즈·이웃 사실·독립 사실성 검사를 함께 두어야 한다. causal tracing이 매개 지점을 지목한 것과 해당 가중치가 사실의 유일한 저장소라는 주장을 구분해야 한다.
편집 요청이 현실의 사실을 고치는 일인지, 모델의 오류를 정정하는 일인지도 구분해야 한다. ROME은 새 문장을 진실로 판정하는 장치가 아니며, 입력한 object가 옳다는 외부 검증을 대신하지 않는다. 따라서 knowledge editing의 품질은 모델 내부 score만으로 끝나지 않고, 편집 전후의 출처 검증과 철회·감사 기록까지 포함해 평가해야 한다.
References
Meng, K., Bau, D., Andonian, A., & Belinkov, Y. (2022). Locating and editing factual associations in GPT. Advances in Neural Information Processing Systems, 35. https://arxiv.org/abs/2202.05262