A Structural Probe for Finding Syntax in Word Representations
BERT 표현에서 문법 거리를 읽는 선형 창: Structural Probe
Structural Probe는 고정된 단어 표현에 선형 사영을 학습해 의존구문 트리의 거리와 깊이를 복원한다. BERTLarge의 높은 UUAS는 표현에 구문 정보를 읽어낼 수 있음을 보이지만 모델이 트리를 명시적으로 계산한다는 증거는 아니다.
Paper: John Hewitt; Christopher D. Manning (2019). "A Structural Probe for Finding Syntax in Word Representations." Proceedings of NAACL 2019, 4129–4138. PDF · https://doi.org/10.18653/v1/N19-1419
1. probe가 묻는 질문
언어모델의 단어 벡터에 문법 구조가 들어 있다고 말하려면, 무엇을 뜻하는지 먼저 정해야 한다. Structural Probe는 모델을 재학습하지 않는다. 고정된 단어 표현에 작은 선형 사영을 얹어, 두 단어의 거리와 문장 안에서 root까지의 깊이를 의존구문 트리와 맞추려 한다. 사영 뒤의 기하로 금본위 트리를 읽을 수 있다면, 해당 정보에 표현을 통해 접근할 수 있다는 뜻이다. 언어모델은 고정하지만 사영 자체는 PTB WSJ의 정답 구문 거리·깊이로 지도학습한다.
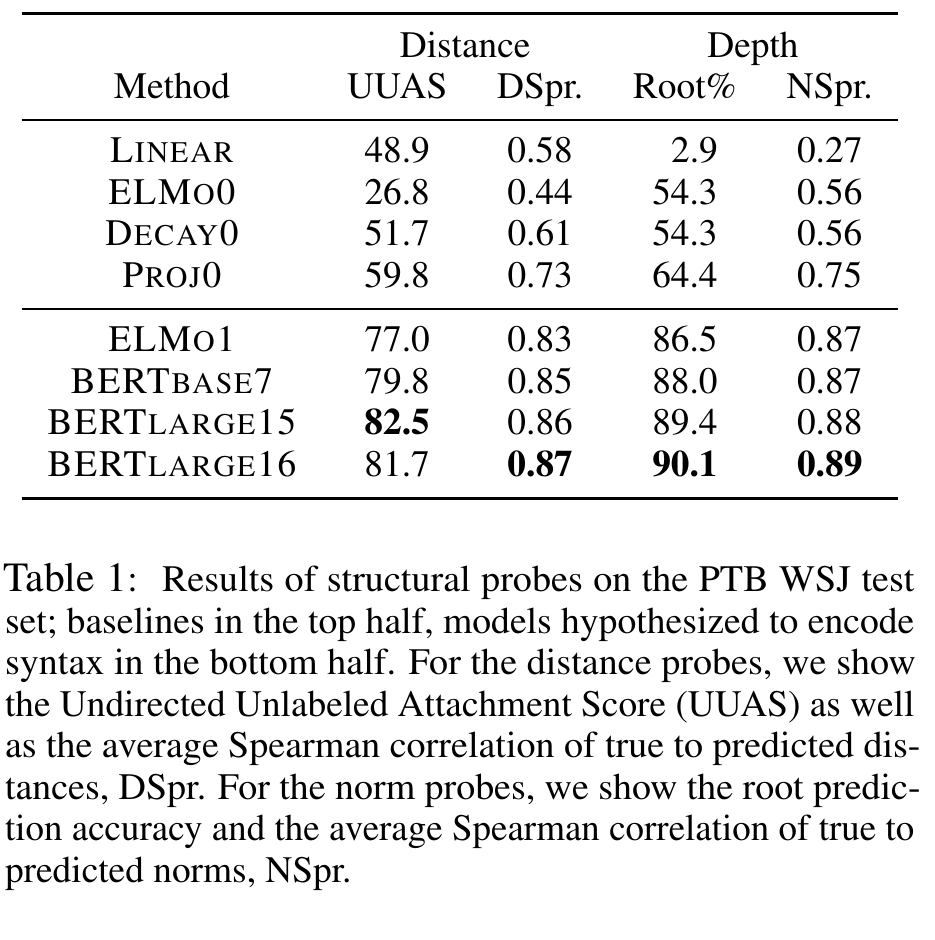
그림 1. Hewitt와 Manning (2019), ACL PDF p. 4131의 Table 1을 인용했다. PTB WSJ에서 BERTLarge15의 undirected unlabeled attachment score는 82.5, BERTLarge16의 거리·깊이 상관은 각각 0.87·0.89다. 15와 16은 서로 다른 BERT 층이며, 서로 다른 열은 서로 다른 측정값이므로 한 숫자를 ‘문법 정확도’ 전체로 읽으면 안 된다.
2. 방법: 트리를 직접 예측하지 않고 거리를 맞춘다
의존구문 트리에서는 두 단어 사이의 경로 길이와 각 단어의 root까지 깊이가 있다. probe는 단어 벡터를 더 낮은 공간으로 선형 변환한 뒤, 변환된 두 벡터의 제곱 거리가 트리 거리와 닮도록 학습한다. 별도의 probe는 사영된 벡터의 길이를 제곱한 값이 root 깊이를 반영하도록 만든다. 이렇게 예측한 거리로 최소 신장 트리를 만들고 gold tree와 비교한다.
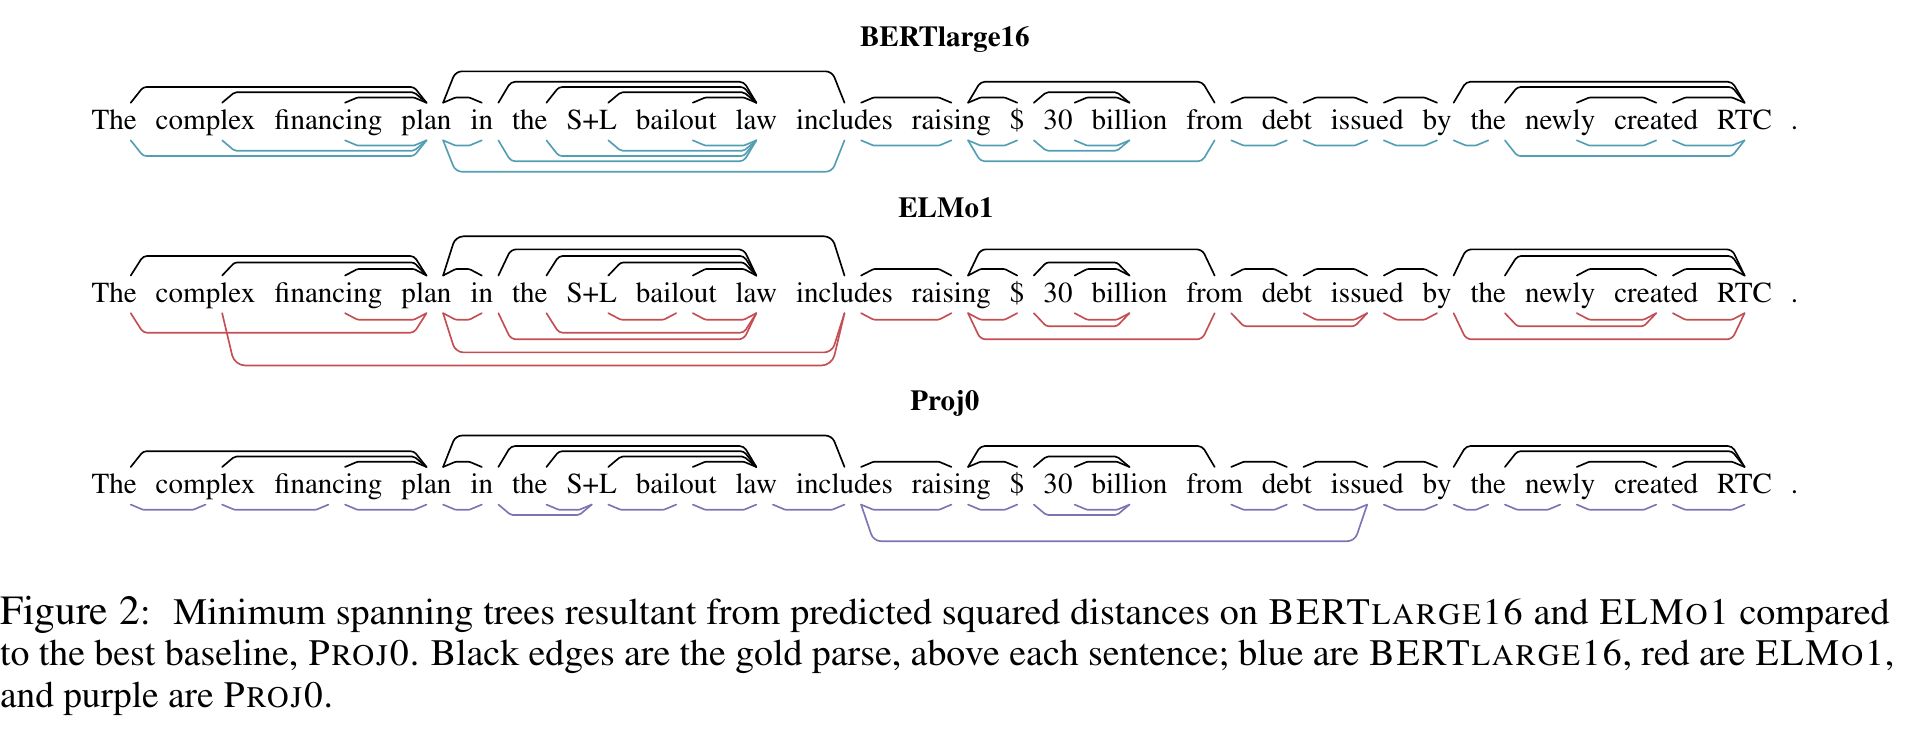
그림 2. Hewitt와 Manning (2019), ACL PDF p. 4132의 Figure 2를 인용했다. 검은 선은 gold dependency parse, 파랑은 BERTLarge16의 probe 거리, 빨강과 보라는 비교 표현에서 복원한 최소 신장 트리다. 그림은 한 문장의 정성 사례이며 전체 정확도는 Table 1과 별도로 읽어야 한다.
3. 결과: 접근 가능한 구문 신호
UUAS는 방향과 관계 이름을 제외한 정답 의존구문 간선 중 복원한 간선의 비율이다. PTB WSJ에서 BERTLarge15는 UUAS 82.5를, BERTLarge16은 거리 Spearman 0.87·root 예측 90.1%·깊이 상관 0.89를 보고한다. 무작위 표현·선형 baseline보다 크게 높고 ELMo와도 차이가 있다. 저자들이 강조하는 지점은 BERT의 특정 중간층에서 구문 거리를 읽을 수 있다는 것이다. 마지막층이 언제나 가장 좋다는 결과도 아니다.
이 결과는 language-model objective가 명시적 구문 라벨 없이도 의존구문과 정렬된 정보를 담을 수 있음을 시사한다. 그러나 probe가 선형으로 읽어낸다는 것과 모델이 다음 단어를 예측할 때 그 트리를 명시적으로 사용한다는 것은 다른 주장이다. 표현은 어휘·의미·형태·문맥 정보를 함께 담고, 선형 map도 훈련 데이터의 상관을 이용할 수 있다.
4. probe 결과를 과장하지 않는 법
probe의 용량이 너무 크면 사실상 새 parser를 학습해 표현 자체보다 probe의 힘을 측정할 위험이 있다. 이 논문은 선형·저랭크 사영으로 그 위험을 제한하려 했지만, ‘저랭크’가 모든 대안보다 충분히 약하다는 보증은 아니다. 또한 PTB English dependency structure에서의 결과이므로 다른 언어·문법 체계·토크나이저 단위까지 자동 일반화되지 않는다.
그래도 유용한 교훈은 명확하다. 표현 분석에는 직관적인 heatmap보다 무엇을 복원하는지, probe가 얼마나 복잡한지, random·context-free baseline이 무엇인지, 예측된 구조가 실제 과제 행동과 연결되는지를 함께 적어야 한다.
5. 언제 쓸까
새 언어모델 층을 비교할 때 Structural Probe는 ‘어느 층에서 문법적 거리 정보가 가장 선형적으로 읽히는가’를 보는 도구가 된다. 이를 모델의 설명으로 사용하려면 인과적 ablation이나 downstream 행동 실험을 더해야 한다. 높은 UUAS는 진단값으로 유용하다. 구문 분석기를 내장했다는 인증서는 아니다.
특히 probe가 실패했다고 해서 표현에 문법 정보가 전혀 없다고 결론 내릴 수도 없다. 정보가 비선형적으로 섞였거나, 선택한 gold formalism과 다른 방식으로 표현됐을 수 있기 때문이다. 성공과 실패 모두 ‘이 probe와 이 데이터에서 읽을 수 있는가’라는 질문에 대한 답이다. 이렇게 해석하면 representation probing과 모델 능력 평가를 구별할 수 있다.
References
Hewitt, J., & Manning, C. D. (2019). A structural probe for finding syntax in word representations. Proceedings of NAACL 2019, 4129–4138. https://doi.org/10.18653/v1/N19-1419