Quantum Machine Learning Models for Graphs
그래프의 대칭으로 양자 모델을 설계하기: Quantum Machine Learning Models for Graphs
Sauvage와 동료들은 노드 순열을 보존하는 양자 그래프 모델의 구성 요소를 정리했다. 같은 측정 결과에서 관측값을 더 읽어 그래프 구별에 필요한 회로 깊이를 낮추고, 작은 그래프에서 학습한 파라미터가 큰 그래프의 출력 집중을 줄이는 사례를 보였다.
Paper: Frédéric Sauvage; Pranav Kalidindi; Frederic Rapp; Martín Larocca (2026). "Quantum Machine Learning Models for Graphs." arXiv PDF v1 · arXiv 기록 · DOI. arXiv:2607.00698v1, 2026년 7월 1일 제출.
1. 노드 번호를 바꿔도 답은 같아야 한다
같은 그래프의 노드에 1, 2, 3 대신 3, 1, 2라는 번호를 붙여도 그래프 분류 결과는 같아야 한다. 반면 노드마다 값을 내는 과제라면 출력의 순서도 새 번호를 따라 바뀌어야 한다. 전자는 순열 불변성, 후자는 순열 등변성이다. 논문은 양자 회로를 그래프에 적용할 때 이 조건을 설계의 출발점으로 삼는다.
범위는 구체적이다. 노드가 n개인 그래프를 큐빗 n개의 상태로 인코딩하고 노드 번호 변경을 큐빗 순서 변경과 연결한다. 저자들은 이 설정에서 허용되는 인코딩·연산·측정을 한 목록으로 정리한다. 이 논문은 기존 모델과 새 모델을 같은 기준으로 조립하는 도구상자에 가깝다. 새 분류기를 하나 제안하는 데 초점을 두지는 않는다.
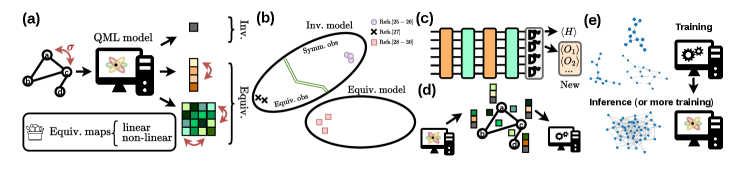
그림 1. 순열에 맞춰 변하는 연산을 골라 그래프 인코딩과 불변·등변 출력을 구성하는 도구상자. Sauvage 등 (2026)의 원논문 Figure 1을 잘라 사용; arXiv:2607.00698v1 PDF 2쪽, 인쇄면 2. 원본.
2. 방법: 순열 아래 같은 역할을 하는 연산을 묶는다
회로의 한 부분이 그래프의 노드 번호를 바꾸었을 때 같은 방식으로 변하면 등변이다. 이 조건을 아무 연산에 사후 검사하는 대신, 저자들은 임의의 선형 사상을 모든 노드 순열에 대해 평균 내는 **대칭화(twirling)**를 사용한다. 순열에 의해 서로 옮겨지는 기저 원소를 한 묶음, 즉 **궤도(orbit)**로 보면 허용되는 등변 사상은 궤도마다 하나의 합으로 표현된다(원논문 §III, Table 2).
쉬운 예가 양자 상태를 읽는 관측가능량이다. 어느 큐빗에 작용하든 같은 형태인 Zᵢ들을 더한 Σᵢ Zᵢ는 노드 번호에 영향받지 않는다. 그래프의 간선에 따라 ZᵢZⱼ를 더하는 연산도 그래프와 큐빗을 함께 재번호화하면 같은 방식으로 변한다. 논문의 목록에는 입력 그래프에서 양자 연산자로 가는 사상, 양자 상태에서 그래프 수준·노드 수준 출력으로 가는 사상이 함께 들어 있다. 알려진 QAOA 생성자도 이 목록의 특수 사례다.
이 등변 연산으로 만든 인코딩은 노드 순열에 따라 양자 상태가 대응해 변한다. 마지막에 순열 불변 관측가능량의 기댓값을 읽으면 그래프 하나당 같은 스칼라가 나오고, 등변 관측가능량의 벡터를 읽으면 노드별 출력이 번호와 함께 이동한다(원논문 §IV). 대칭성은 이런 출력의 일관성을 보장하지만, 서로 다른 그래프를 모두 구별한다는 뜻은 아니다.
3. 첫 실험: 같은 측정에서 값을 더 읽으면
첫 수치 실험은 QAOA로 서로 동형이 아닌 그래프를 구별하는 기존 설정을 확장한다. 기존 모델은 계산 기저에서 대각인 관측가능량 하나를 읽었다. 저자들은 Table 2의 목록에서 같은 기저로 측정할 수 있는 다른 불변 관측가능량도 읽는다. 회로와 측정 기저는 그대로 두고, 얻은 측정 결과를 여러 방식으로 고전 후처리하는 셈이다.
| 그래프 집합 | 노드 수 | 기존 관측값 하나: 최소 깊이 L |
호환 관측값 여러 개: 최소 깊이 L |
|---|---|---|---|
| Miyazaki | 20 | 3 | 1 |
| 3-정규 그래프 4,060개 | 16 | 4 | 1 |
| 강정규 그래프 10개 | 26 | 2 | 1 |
원논문 Table 3의 다섯 그래프 집합 모두에서, 모든 쌍을 구별하는 데 필요한 최소 QAOA 깊이는 관측값 하나일 때 2–4층, 여러 호환 관측값을 읽을 때 1층이었다. 이 결과가 말하는 “추가 비용 없음”은 같은 회로·같은 측정 기저에서 더 많은 종류의 값을 추정한다는 뜻이다. 별도의 고전 계산은 늘어난다. 또한 실험은 측정 샷 잡음 없이 기댓값을 수치 정밀도로 얻는다고 가정했다. 유한 샷에서 작은 값 차이를 구별하는 비용까지 입증한 결과나 일반적인 그래프 동형성 판정법은 아니다.
4. 둘째 실험: 작은 그래프에서 학습한 값을 옮긴다
논문의 일부 등변 생성자는 그래프가 커져도 필요한 파라미터 수가 일정하다. 이를 이용해 저자들은 8–12개 노드의 그래프에서 고전 시뮬레이션으로 회로 파라미터를 학습한 뒤, 그 값을 고정해 최대 20개 노드의 그래프에도 적용했다. 과제는 트리와, 순환 구조가 있는 Erdős–Rényi 그래프의 이진 분류다. 사용한 인코딩은 10층, 회로 파라미터 40개이며, 출력은 두 관측가능량의 기댓값이다(원논문 §IV.5, 식 45–46). 저자들은 크기 8–12의 학습 그래프 40개에서 85% 정확도를 보고한다.
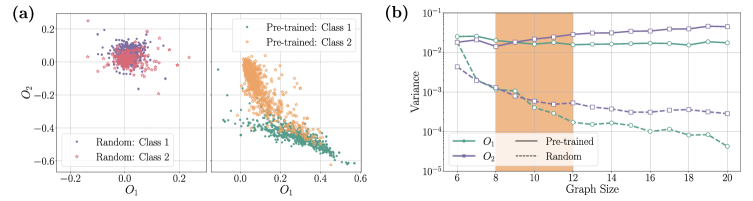
그림 2. (a) 노드 수 14–20의 그래프에서 두 관측가능량의 출력 좌표를 무작위 초기화와 사전학습 파라미터로 비교한다. (b) 노드 수 6–20에서 각 크기·클래스당 그래프 50개를 사용해 출력 기댓값의 분산을 비교한다. Sauvage 등 (2026)의 원논문 Figure 4를 잘라 사용; arXiv:2607.00698v1 PDF 13쪽, 인쇄면 13. 원본.
Figure 4에서 무작위 초기화 회로의 출력은 그래프가 커질수록 0 부근으로 모인다. 사전학습한 파라미터의 출력은 평가한 크기 안에서 더 퍼져 있고 두 클래스의 분리도 더 잘 보인다. 두 관측가능량의 출력 분산은 가장 큰 크기에서 무작위 초기화보다 100배 이상 클 수 있었다. 측정한 것은 출력 분산이며, 학습 손실의 gradient 분산이 아니다. 이 실험은 작은 그래프에서 배운 파라미터를 고정해 더 큰 입력으로 옮길 수 있다는 예시다. 저라벨 과제의 미세조정 이득이나 큰 그래프의 정확도 곡선을 보여 준 실험은 아니다.
5. 결과의 범위와 남은 질문
논문의 가장 단단한 기여는 노드 순열을 존중하는 사상들의 목록과, 그 목록으로 QAOA 같은 모델을 설명하고 확장하는 구성법이다. 두 수치 실험은 서로 다른 효용을 보인다. 하나는 측정 데이터의 재사용으로 같은 작은 그래프 집합을 더 얕은 회로에서 구별했고, 다른 하나는 작은 그래프에서 배운 파라미터가 평가된 크기에서 출력 집중을 완화했다.
논문 결과를 양자 우위로 읽어서는 안 된다. 첫 실험은 정확한 기댓값을 가정하고, 둘째는 통제된 그래프와 고전 시뮬레이션에 머문다. 저자들도 실제 장치 구현과 더 넓은 종단간 평가는 후속 과제로 남긴다. 따라서 이 논문은 “양자 모델이 고전 GNN보다 낫다”는 성능 보고서보다, 그래프 대칭을 유지하며 무엇을 인코딩하고 무엇을 측정할지 고르는 설계 지도로 읽을 때 가장 유용하다.
References
Sauvage, F., Kalidindi, P., Rapp, F., & Larocca, M. (2026). Quantum machine learning models for graphs (arXiv:2607.00698v1). arXiv. https://doi.org/10.48550/arXiv.2607.00698