Is Attention Interpretable?
Attention이 큰 토큰은 정말 중요한가: Is Attention Interpretable?
Serrano와 Smith는 학습된 텍스트 분류기의 attention 가중치를 지우고 출력을 다시 계산했다. 큰 가중치는 영향도를 어느 정도 예고했지만, 예측을 떠받치는 성분의 신뢰할 만한 순위는 아니었다.
Paper: Sofia Serrano; Noah A. Smith (2019). "Is Attention Interpretable?" Proceedings of ACL 2019, 2931–2951. 공식 PDF · DOI · ACL Anthology P19-1282 출판본.
1. 색이 진한 곳이 답의 근거일까
문서 분류기의 attention 그림에서는 어떤 단어나 문장이 더 큰 가중치를 받았는지 한눈에 보인다. 이를 곧바로 “모델이 그 부분 때문에 이 답을 냈다”로 읽으려면 한 단계가 더 필요하다. 가중치가 큰 표현을 빼면 예측이 실제로 더 크게 달라져야 한다. Serrano와 Smith는 학습이 끝난 분류기의 내부 계산을 바꿔 이 가정을 시험했다.
검증 대상은 원문 토큰의 절대적인 인과 기여가 아니다. 인코더를 거친 뒤 attention 계층으로 들어오는 문맥화된 표현들 사이의 상대적 중요도다. 예컨대 한 문장에 높은 attention이 붙어도 그 문장의 표현에는 다른 문장의 정보가 섞여 있을 수 있다. 논문은 이렇게 평가 범위를 좁힌 뒤에도 가중치의 크기로 영향도를 잘 알 수 있는지 묻는다.
2. 개입 방법: 가중치를 지우고 출력을 비교한다
모델은 각 표현에 가중치를 곱해 더한 다음 분류한다. 저자들은 선택한 표현의 attention 가중치를 0으로 만들고, 남은 가중치의 합이 1이 되도록 다시 정규화한 뒤 분류기를 재실행한다. 재정규화는 가중합 전체가 단순히 작아져 생기는 효과를 줄인다. 이 실험은 문장에서 단어를 삭제해 새 입력을 만드는 실험과 다르다.
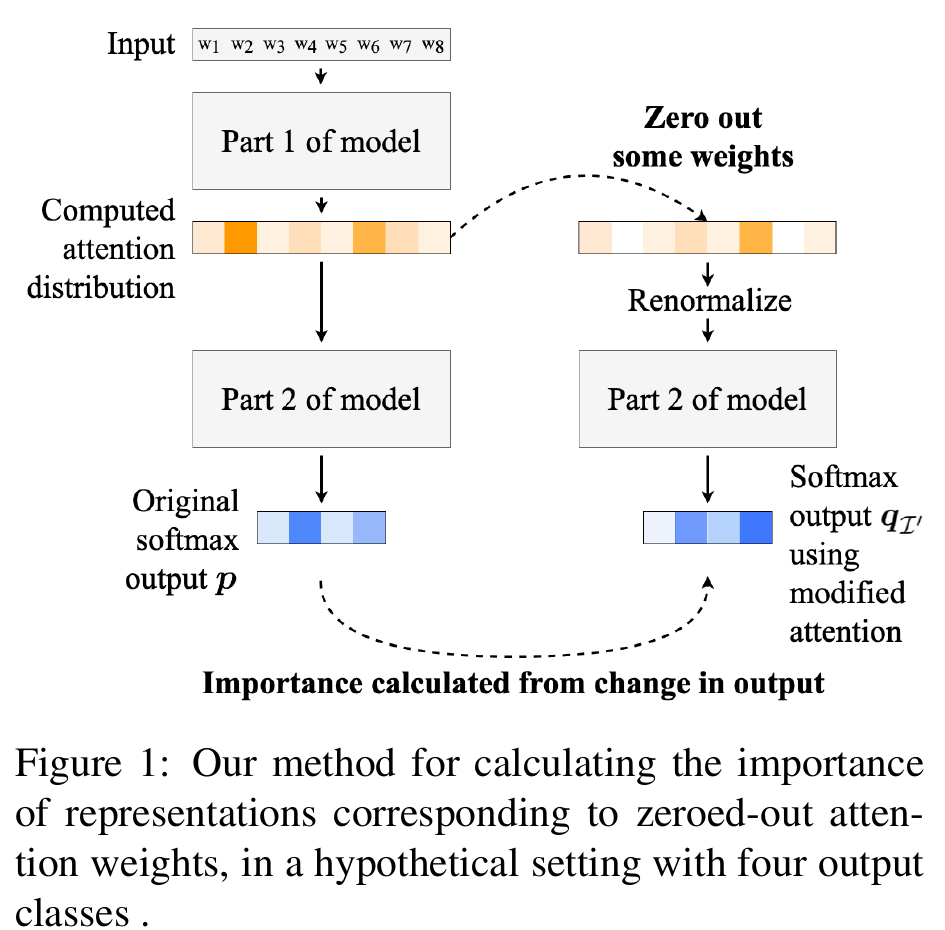
그림 1. 선택한 attention 가중치를 지운 뒤 재정규화해 분류 출력과 비교하는 절차. Serrano와 Smith (2019)의 원논문 Figure 1을 잘라 사용; ACL Anthology 출판 PDF 2쪽, 인쇄면 2932. 원본.
변화는 두 눈금으로 잰다. Jensen–Shannon(JS) divergence는 개입 전후의 클래스별 확률 분포가 얼마나 달라졌는지를 연속값으로 나타낸다. Decision flip은 확률이 가장 높은 클래스, 즉 argmax가 바뀌었는지만 본다. 출력 확률이 크게 이동해도 최고 클래스는 유지될 수 있다. 두 눈금은 서로 다른 질문에 답한다.
3. 네 데이터셋과 두 번의 시험
저자들은 Yahoo Answers 주제 분류와 IMDB·Amazon·Yelp 평점 분류를 사용했다. 모델은 문장과 단어에 두 단계로 주의를 주는 HAN, 단어 전체에 한 단계로 주의를 주는 FLAN을 비교한다. 각각의 표현 인코더는 양방향 RNN, 합성곱, 인코더 없음의 세 형태다. 실험은 이 모델들의 최종 attention 계층에 적용된다.
첫 시험은 사례마다 가장 큰 가중치의 성분과 무작위 성분을 각각 하나씩 지운다. 두 JS 값의 차이인 ΔJS = JS(원래 출력, 최고 가중치 제거 출력) − JS(원래 출력, 무작위 제거 출력)가 양수이면, 최고 가중치를 지운 쪽이 출력을 더 흔들었다는 뜻이다. 저자들은 이 값을 두 성분의 attention 차이 Δα와 나란히 그렸다.
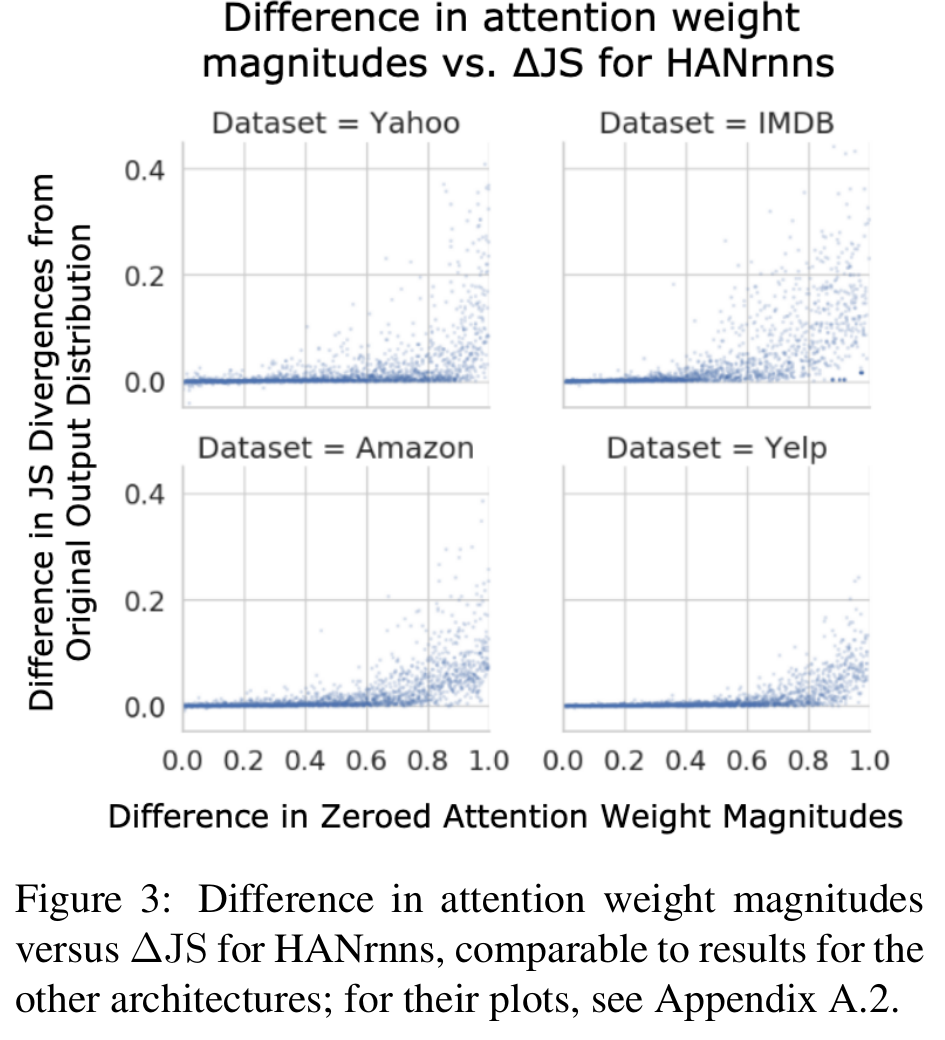
그림 2. HAN의 양방향 RNN 변형에서 가로축은 최고·무작위 성분의 가중치 차이 Δα, 세로축은 두 제거 실험의 출력 변화 차이 ΔJS다. Serrano와 Smith (2019)의 원논문 Figure 3을 잘라 사용; ACL Anthology 출판 PDF 4쪽, 인쇄면 2934. 원본.
둘째 시험은 성분을 하나씩 누적해 지우면서 처음 예측이 뒤집힐 때까지 얼마나 지워야 하는지 잰다. 지우는 순서는 attention 크기, 출력에 대한 gradient 값, gradient×attention 값이 큰 순서와 무작위 순서로 각각 정한다. gradient의 절댓값을 기준으로 삼는 것은 아니다. 더 적게 지우고 뒤집는 순서일수록 이 개입에서 중요한 성분을 앞쪽에 놓았다고 볼 수 있다.
4. 큰 가중치는 단서지만 확실한 순위는 아니다
단일 제거에서는 ΔJS가 대체로 양수였다. 큰 attention이 평균적으로 더 큰 출력 변화와 연결된다는 긍정적인 신호다. 하지만 Figure 3에는 가중치 차이가 큰데도 ΔJS가 0에 가까운 사례가 많다. HAN의 양방향 RNN 결과에서 최고 가중치와 무작위 가중치 중 어느 하나를 지워도 예측이 뒤집히지 않은 사례는 데이터셋에 따라 84.2–89.6%였다(원논문 Table 2). “높은 가중치”와 “그 성분 없이는 같은 답을 낼 수 없음”은 다른 명제다.
다중 제거는 격차를 더 선명하게 보였다. 인코더가 있는 16개 데이터셋·모델 조합 모두에서, gradient 순서가 attention 크기 순서보다 적은 제거로 결정을 뒤집은 사례가 그 반대 사례보다 최소 1.6배 많았다. 그중 10개 조합에서는 테스트 사례 절반이 넘는 곳에서 gradient 순서가 더 작은 제거 집합을 찾았다(원논문 §5). 이는 gradient가 완전한 설명이라는 뜻이 아니라, attention 크기만으로 만든 중요도 순위보다 강한 비교 기준이 있었다는 뜻이다.
인코더가 없는 모델에서는 두 순위의 차이가 줄거나 방향이 바뀌기도 했다. 양방향 RNN은 정보를 여러 위치의 표현으로 옮길 수 있어, 한 위치의 높은 attention을 원래 토큰 하나의 영향도로 되돌려 읽기 어렵다. 합성곱 인코더는 더 가까운 문맥을 섞는다. 이 구조 차이가 왜 attention 그림의 해석이 인코더에 의존하는지를 보여 준다.
5. 어디까지 결론을 옮길 수 있나
이 연구의 결론은 “attention은 아무 정보도 주지 않는다”가 아니다. 큰 가중치는 영향도를 잡음 섞인 방식으로 예고한다. 다만 학습된 분류기의 최종 attention에서, 가중치만 보고 어느 표현이 예측을 떠받쳤는지 확실하게 순위를 매길 수는 없다. 저자들의 실험은 가법 softmax attention과 텍스트 분류에 한정된다. Transformer의 multi-head self-attention까지 같은 수치로 일반화하거나, gradient를 참된 중요도로 확정하지 않는다.
따라서 attention 지도를 제시할 때는 그것을 모델 내부의 가중치 그림으로 소개하는 편이 정확하다. “이 단어 때문에 답했다”는 주장에는, 어떤 계층의 무엇을 바꾸었는지와 출력 확률 또는 결정이 어떻게 달라졌는지를 함께 보여 줘야 한다. erasure 실험은 출력 확률과 결정의 변화를 확인하는 절차다.
References
Serrano, S., & Smith, N. A. (2019). Is attention interpretable? In Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics (pp. 2931–2951). Association for Computational Linguistics. https://doi.org/10.18653/v1/P19-1282